VisCo: 利用大语言模型作为内在编码器进行视觉令牌压缩
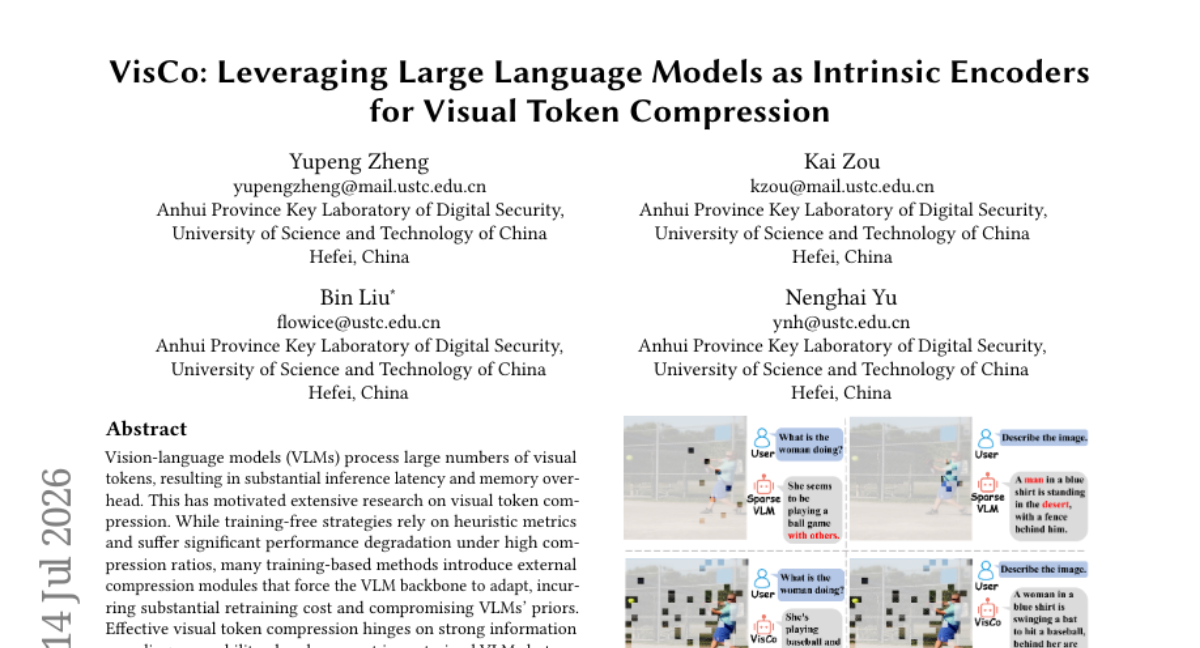
视觉-语言模型(VLMs) 处理大量视觉令牌,导致显著的推理延迟和内存开销,这推动了视觉令牌压缩的研究。无训练策略依赖启发式度量,在高压缩比下性能显著下降;而许多基于训练的方法引入外部压缩模块,迫使 VLM 骨干网络适应,带来了大量重训练成本并损害了 VLMs 的先前知识。 有效的视觉令牌压缩依赖于强大的信息编码能力,而预训练 VLMs 已具备此能力,但现有方法并未充分利用。受此启发,我们提出 VisCo,一个训练高效的自压缩框架,将预训练 VLM 本身重用为内在压缩器。VisCo 是一种参数共享的自编码器,使用少量记忆令牌压缩视觉信息,并将层次化信息从编码传递到解码。 实验表明,VisCo 在所有评估的压缩比下均优于先前方法,在更激进压缩下增益更大,甚至在极端单令牌设置下仍保持稳定。此外,当与原始视觉令牌结合时,学到的记忆令牌甚至能提升基础模型,表明 VisCo 捕获了超越压缩的互补表示。
论文精读
TL;DR VisCo 让 VLM 充当自编码器,复用自身预训练能力压缩视觉 token,无需引入外部模块,训练高效,高压下性能显著超越现有方法,极端单 token 仍稳定,甚至能提升基座模型。
问题
背景
视觉语言模型 (VLM) 将图像分割为大量视觉 token,导致推理延迟与显存开销巨大。当前领域聚焦于如何在保持性能的同时大幅压缩视觉 token 数量。
现有方法局限
- 训练无关策略 (training‑free) 依赖注意力权重或 CLS token 相似度等启发式度量,在高压缩比 (如保留 ≤10% token) 下关键信息容易丢失,性能退化严重。
- 训练相关方法 通常引入外部压缩模块 (如轻量 resampler / Q‑Former 变体),迫使 VLM 骨干适配,不仅需要大量重训练 (数万步微调),而且破坏预训练 VLM 的强先验,导致泛化能力下降,部署灵活性差。
为什么这个问题困难且重要
有效压缩的核心在于强信息编码能力 — 将高维视觉特征浓缩到极少 token 而不丢失关键语义。预训练 VLM 本身已具备这种能力,其内部表示蕴含丰富的视觉‑语言对齐知识,但已有方法并未充分利用,反而引入外部结构或启发式规则,增加计算‑精度权衡。技术挑战在于:如何在几乎不破坏 VLM 原有表示的前提下,实现高压缩比且低恢复误差的信息压缩。业界对此高度关注,因为更少的视觉 token 直接带来更低的推理成本与更快的响应速度,对大规模服务与边缘设备部署至关重要。
行业类比
这类似 LLM 推理中通过 KV cache 压缩或权重量化来降低内存与计算负担,目标是“少即是多”,且尽量避免重训模型本身,VisCo 将该思想延伸到 VLM 的早期视觉阶段。
核心洞察
- **重用预训练 VLM 作为内在压缩器,将压缩成本从“外部适配”转移至“内部复用”**。现有训练方法需要引入独立的压缩模块(如 Q-Former、Perceiver),迫使 VLM 主干预适应新组件,带来大量重训练开销并可能损害原有先验知识。VisCo 直接将 VLM 自身视为参数共享的自编码器,通过少量记忆 token 压缩视觉信息,并将编码器层次化特征传递给解码器,在几乎不增加额外参数的前提下实现高效压缩。这种设计不仅大幅降低了训练成本,还避免了外部模块对 VLM 表征空间的扭曲,使得压缩过程更贴合原始模型的感知方式。
- **记忆 token 既压缩信息又捕获互补表示,突破“压缩-保真”的零和思维**。传统视觉 token 压缩常常以性能损失为代价,尤其在单 token 等极端设置下表现急剧退化。VisCo 的实验表明,其学习的记忆 token 在极端压缩下仍保持稳定,并且当这些 token 与原始视觉 token 组合时,甚至能提升基础模型性能。这说明记忆 token 不仅仅是对输入信息的精简重述,而是提取了具有泛化价值的互补特征,为视觉 token 压缩赋予了超越信息保留的全新功能,启发了如何利用压缩过程增强模型表征能力的工程路径。
方法
输入与动机
VLMs 在处理海量视觉令牌时面临推理延迟与内存瓶颈,现有压缩方法或依赖启发式度量(训练自由但高压缩比下退化严重),或引入外部压缩模块迫使 VLM 重训练、破坏预训练先验。VisCo 将预训练 VLM 自身复用为内在编码器,仅需少量可学习的记忆令牌即可完成高效压缩。
核心架构:参数共享自动编码器
- 编码阶段:输入原始视觉令牌 X,与一组可学习的
memory tokens(数量远少于 X)通过交叉注意力交互,将视觉信息压缩至这些记忆令牌中;同时从 VLM 各层提取层次化特征(如中间层的激活)作为编码的辅助信息。 - 解码阶段:仅使用压缩后的记忆令牌,通过参数共享的同一 VLM 骨干(作为解码器)重建原始视觉令牌或层次特征。解码过程利用自注意力及从编码传递过来的层次信息,逐步恢复细节。
- 训练目标:最小化重建损失(如 L2 或余弦相似度),强制记忆令牌保留关键视觉语义;训练时仅更新记忆令牌及极少量轻量适配器,冻结 VLM 其余参数,极大降低训练成本。
推理部署
压缩后的记忆令牌可直接替代原始大量视觉令牌喂入下游任务,或与原始令牌拼接形成增强表示——实验表明拼接能提升基础模型性能,说明记忆令牌学到了互补信息。
与同类方法的差异
VisCo 无需引入独立压缩网络,直接利用 VLM 已有的强大表示能力进行自压缩,避免重训练带来的先验丧失和计算开销;区别于启发式剪枝/合并的刚性策略,记忆令牌通过可学习方式自适应提取信息,在极端单令牌压缩下仍保持稳定。
实验
实验设计
VisCo 将自身作为内在压缩器嵌入预训练 VLM(如 LLaVA),冻结原 VLM 主干,仅训练少量记忆 token 与轻量解码器,以极小训练成本评估多个压缩比下的性能。对比基线包括:
- 训练无关策略:基于注意力分数或 CLS token 的剪枝,完全依赖启发式指标。
- 训练型外部压缩模块:如 TokenLearner、Perceiver 等,需引入额外参数并迫使 VLM 适配。 实验覆盖图像描述(MS-COCO Captions)和视觉问答(VQAv2、GQA、OK-VQA),压缩比从常规到极端(单 token),并测试记忆 token 与原始 token 结合的增益。
关键发现
- VisCo 在所有压缩比下均超越先前方法,且在高压缩比下优势更显著,即使压缩至单 token 仍保持稳定,而训练无关方法在此设置下几乎失效。
- 学习到的记忆 token 并非简单降维,当与原始视觉 token 共同输入时,可提升基础模型性能,表明其捕获了互补表示,超越压缩本身。
- 自编码器中层次信息从编码到解码的传输,是保持语义的关键,避免了启发式方法的信息丢失。
与基线的深度对比
训练无关方法(如注意力剪枝)在高压缩比时因丢弃大量 token 导致关键语义缺失,而 VisCo 通过参数共享的自编码器学习压缩而非丢弃,保留了结构化信息。相比外部压缩模块,VisCo 直接复用 VLM 自身的强信息编码能力,无需让 VLM 去适应一个全新的压缩范式,因此不破坏原模型的先验分布,也避免了大规模重训。这种"内在压缩"思路在训练效率与性能上均展现出优势,尤其适合实际部署中低成本适配不同压缩需求的场景。
行业影响
落地场景
VisCo 适用于需要高效 视觉-语言模型(VLM) 推理的场景:
- 电商搜索与商品描述生成
- 视频平台内容理解与审核
- 移动端/边缘设备的多模态交互
- 大规模图像/视频离线分析
商业价值
- 降本:将视觉 token 从数百压缩至个位数,直接降低 GPU 计算与内存消耗,尤其在高并发服务中大幅削减成本。
- 增质:压缩后记忆 token 与原始 token 结合可提升模型表现,带来业务指标增益。
- 提效:复用 VLM 本体,训练开销小,能快速跟随 VLM 升级迭代。
与现有工作流的接口
VisCo 作为参数共享自编码器,可即插即用:
- 推理时在视觉编码器后插入 token 压缩步骤,输出少量记忆 token 送入 LLM 解码器。
- 无需修改 VLM 原始参数,可与 LoRA、量化等技术叠加。
- 基于 PyTorch,可集成到 Hugging Face Transformers、vLLM 等框架中,作为预处理模块。
具体落地用例
电商以图搜图:用户上传图片搜索商品,传统 VLM 处理上千 visual token 导致高延迟。使用 VisCo 压缩至 1~16 个 token,在毫秒内完成特征提取,同时生成精准商品标题与属性描述,提升搜索体验与转化率。搭配原始 token 还能捕捉材质纹理等细节。
视频平台智能审核:每日海量视频上传,需快速生成安全、场景等多维标签。VisCo 压缩关键帧 token 后批量处理,成本降低数倍,极端单 token 模式下仍可保证初筛准确,随 VLM 升级而快速部署,无需重新训练压缩模块。
局限
- **训练与推理效率**:VisCo 虽以训练高效著称,但其自压缩过程仍需 VLM 编码器对全部原始视觉 token 进行前向计算,才能生成压缩后的记忆 token。推理时,这一初始编码步骤的计算量和内存占用并未减少,真正的收益仅体现在后续的注意力或解码阶段。当输入分辨率极高或处理长视频序列时,原始 token 数量本身就成为瓶颈,导致端到端推理延迟改善有限。对于追求极致低延迟或资源受限的边缘部署场景,该方法的压缩优势可能被前期编码开销抵消。
- **架构与先验依赖**:VisCo 的设计强依赖预训练 VLM 的编码质量与模型架构。自压缩机制假设 VLM 内部已具备良好的视觉信息编码能力,若基础 VLM 本身对细节表征不足,或采用非 Transformer 架构(如 CNN-based 视觉骨干),框架可能失效或需要大量适配工作。论文主要在大规模 VLM 上验证,对不同 VLM 家族(如纯视觉编码器、早期融合多模态模型)的泛化性尚不明确,迁移至新模型时可能需重新训练记忆 token,弱化了“即插即用”的便利性。
- **压缩表示的可解释性与下游任务适应性**:记忆 token 通过自编码器压缩视觉特征,其学习到的表示缺乏对空间结构或细粒度纹理的显式约束。极端单 token 压缩虽能保持高层语义稳定,但必然丢弃位置敏感信息,可能导致在密集预测任务(如检测、分割)中性能下降。论文中未见在视觉定位、像素级任务上的系统评估,仅靠 VQA 等全局任务难以反映压缩表示对低层信息的保留程度。此外,压缩后的 token 如何与原始 patch 对齐,以及是否可解释,仍是未解决的问题。