An Empirical Study on Zero-Data Bootstrapping for Conversational Recommender Systems
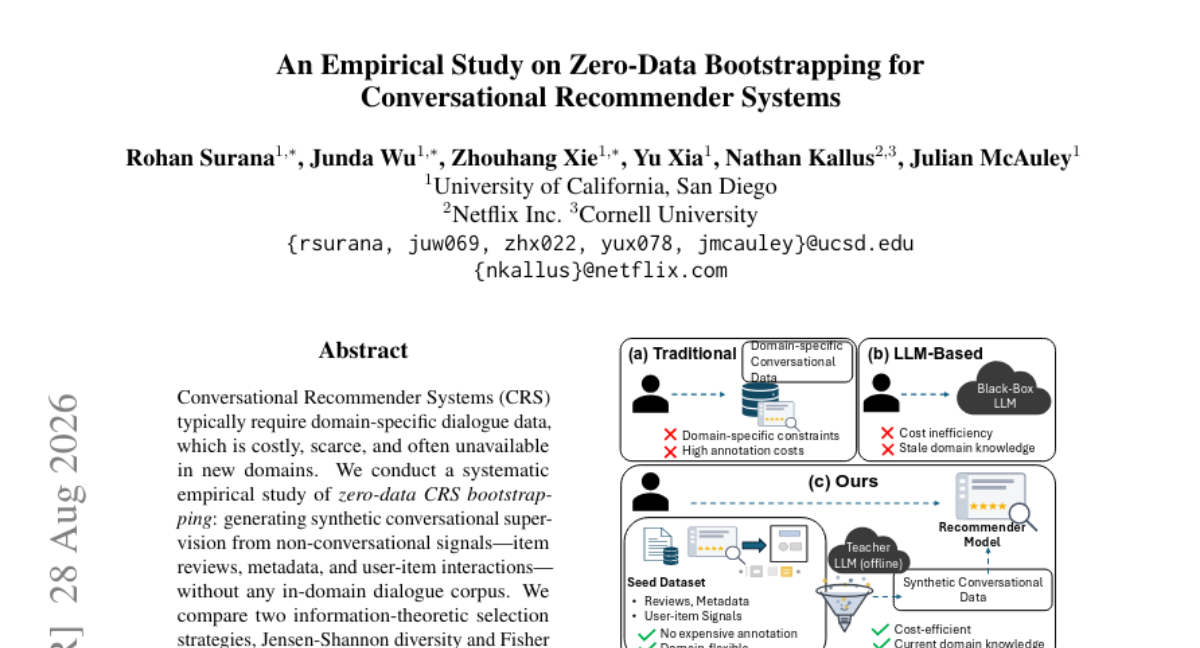
对话推荐系统 (CRS) 通常需要特定领域的对话数据,但这些数据成本高昂、稀缺,且在新领域往往不可用。我们进行了一项系统的实证研究,探索 零数据 CRS 启动:利用非对话信号(如物品评论、元数据和用户-物品交互)生成合成对话监督,而无需任何领域内对话语料库。 我们比较了两种基于信息论的选择策略:Jensen-Shannon 多样性 和 Fisher 信息,并评估了它们在不同领域信号、模型架构、数据集和微调范式下的表现。实验结果表明: - 领域驱动的合成数据 在性能上持续优于零样本提示和朴素的合成基线。 - 主动选择 比随机采样更能提高数据效率。 - 元数据 和 协同过滤 信号均能改善选择质量。 - 在低资源环境下,合成数据不仅可以超越稀缺的真实对话数据,还能与之互补。 这些发现证明了非对话领域信号是构建无需对话训练数据的 CRS 的可行途径。代码可在 https://anonymous.4open.science/r/zerodatacrs/ 获取。
论文精读
TL;DR 实证表明:用评论、元数据与交互信号合成对话数据可引导零数据对话推荐系统,主动选择(Jensen-Shannon 多样性与 Fisher 信息)优于随机,合成数据可超越稀缺真实对话。
问题
问题背景
对话推荐系统 (CRS) 是 AI 应用的热点方向,旨在通过自然语言交互完成推荐,LLM 的引入让这类系统更具可行性,但通常需要大量领域内对话语料进行监督微调。
现有方法局限
- 传统 CRS 依赖领域对话数据,收集成本高、标注昂贵,且在新领域或长尾场景下几乎不可用。
- 零样本 LLM 虽然能直接对话,但缺少领域推荐知识,容易产生通用回复或幻觉,难以满足真实推荐需求。
- 简单的合成对话生成(如 naive prompting)没有充分利用已有的非对话信号(item reviews、metadata、user-item interactions),生成的数据质量低、多样性不足。
为什么这个问题难/重要
核心难点在于:如何从非对话信号中自动提取信息量大的种子样本,并构建高质量合成对话监督,以保证推荐质量和数据效率。这涉及两个层次:一是信号选择(哪些 items 或 reviews 最有价值),二是合成生成(如何把非对话信号转化为自然、可学习的对话)。业界对冷启动和低资源场景的 CRS 需求强烈,尤其是内容平台和电商平台需要快速扩展新领域,缺乏对话数据是实际痛点。
行业类比
类似为垂直领域客服机器人自动生成训练数据:只需产品文档、用户行为日志和评论信息,无需人工标注对话,即可起步构建可用的对话推荐能力。
核心洞察
- 零数据 CRS 引导的核心不是生成对话的模型,而是从非对话信号中筛选高质量种子。本文系统证明 item reviews、metadata 和 user-item interactions 可以替代领域对话语料,生成域接地的合成监督,并且优于 zero-shot 与朴素合成基线,在低资源场景下甚至超过稀缺真实对话。与以往依赖 LLM 直接生成或对话数据增强的工作不同,该框架强调信息论驱动的主动选择,让合成数据的分布更贴近真实偏好结构。
- 主动选择策略(JS diversity 与 Fisher information)对合成数据效率的影响大于生成模型本身,且元数据与协同过滤信号提供正交增益。随机采样和流行度采样无法覆盖长尾偏好或语义多样性,而这两种信息论指标分别从覆盖度和不确定性角度筛选种子,在固定预算下显著提升下游性能。更关键的是,元数据提供结构覆盖,协同过滤提供偏好结构,二者结合能进一步互补,说明数据选择是多信号融合问题而非单一特征工程。
- 小模型从合成数据中获益更大,且 Full-SFT 优于 LoRA,颠覆了低资源场景下参数高效微调必然最优的假设。当合成数据足够丰富时,全参数微调能充分利用额外的分布信息,而 LoRA 的低秩约束可能限制模型拟合域接地模式。这一发现对实际工程具有重要意义:在零数据引导 CRS 时,优先投入算力做 Full-SFT 小模型,可能比用 LoRA 微调大模型获得更好的性价比和部署灵活性。
方法
输入:非对话领域信号
零数据 CRS 引导方法的输入包括三类非对话信号:物品评论、物品元数据(如标题、类别、属性)以及用户-物品交互矩阵(隐式反馈,如点击、购买)。这些信号在大多数推荐场景中天然存在,但缺少任何领域内对话语料。
关键模块:Select → Generate → Fine-Tune
- 领域信号编码:将物品评论、元数据和协同过滤向量分别编码为语义向量;元数据通过预训练语言模型得到结构化的语义表征,交互矩阵通过矩阵分解得到物品协同向量。
- 主动选择种子样本:从物品集合中筛选信息量最大的子集作为合成对话的“种子”。论文比较了两种信息论选择策略:
- Jensen-Shannon 多样性:最大化所选样本在语义空间中的多样性,避免冗余。
- Fisher 信息:选择对模型参数估计不确定性贡献最大的样本,偏向信息增益高的物品。
- 基线包括随机采样和基于流行度的采样。
- 合成对话生成:使用教师模型(如 GPT-4o 或 Llama-3)以选中的种子物品为中心,结合其领域信号(评论摘要、元数据)生成模拟用户与推荐系统的自然对话。每个对话包含用户偏好表达、系统推荐、用户反馈等多轮交互。
- 目标模型微调:用生成的合成对话数据微调目标 CRS 模型(如基于 LLM 的对话推荐模型或传统端到端 CRS 架构),支持全参数 SFT 与 LoRA 两种范式。
输出
一个可直接部署的对话推荐系统,无需任何真实对话数据即可在目标领域提供推荐服务。
与同类工作的差异
相比依赖少量真实对话或随机采样生成数据的 ZS 基线,本方法首次系统性地将信息论主动选择引入零数据 CRS 引导,证明利用非对话领域信号(特别是元数据与协同过滤联合选择)能够在低资源场景下超越稀缺真实对话并与之互补。
实验
实验设计
论文系统评估 zero-data CRS bootstrapping 流水线:从 item reviews、metadata、user-item interactions 等非对话信号中,通过 Jensen-Shannon diversity 和 Fisher information 两种信息论准则主动选择高信息量种子样本,由 LLM 生成合成对话,再对目标 CRS 模型进行 SFT 或 LoRA 微调。实验覆盖多个公开推荐基准(含商品评论与交互数据)、不同规模 backbone(LLM 与传统 CRS)、不同微调范式,并与 zero-shot prompting、naïve 合成、random sampling、popularity-based selection 等基线对比。
关键发现
- 域内信号合成数据 一致优于 zero-shot 和 naïve 生成;小模型收益更明显。
- 主动选择 优于随机采样与热门度采样,JS 和 Fisher 互补;元数据与协同过滤信号都提升选择质量。
- 低资源场景下,合成数据可单独超过少量真实域内对话,且与真实数据混合带来额外增益。
与基线对比解读
相对 zero-shot,合成微调使模型获得域内偏好结构与表述风格,而非仅依赖通用世界知识;相对 naïve 生成,基于信息论的选择减少冗余、覆盖语义与协同结构,提升数据效率。JS 关注分布多样性,Fisher 关注参数不确定性,二者结合能更好地筛选出对下游微调最有价值的样本。该工作为无对话语料的新领域 CRS 部署提供了可复用的数据工程路径。
行业影响
落地场景
零数据 CRS 引导方法让缺乏对话语料的推荐领域可以快速构建对话式推荐。典型场景包括:
- 电商购物助手:基于商品评论、属性元数据和用户点击/购买记录,合成“用户需求-助手推荐”对话,训练轻量级对话推荐模型。
- 流媒体内容推荐(音乐 / 视频 / 播客):利用用户播放列表、评分、评论生成对话,实现“帮我找点适合通勤听的播客”式交互。
- 企业服务知识推荐:从工单、文档、用户操作日志合成对话,辅助客服或销售推荐解决方案。
商业价值
- 降本:省去人工采集和标注领域对话数据的成本,冷启动周期从数月压缩到数天。
- 体验与增收:对话式推荐提升用户参与度和转化率;在低资源品类中,合成数据甚至优于少量真实对话,并能补充真实数据带来进一步增益。
- 技术通用性:方法不依赖特定模型,可适配 LLM 或传统 CRS,便于快速复制到新领域。
与现有产品/工作流集成
- 可直接挂接现有推荐系统的特征工程与召回排序模块,使用元数据、协同过滤向量作为种子选择依据。
- 集成到 LLMOps 数据管线:生成合成对话后走标准 SFT / LoRA 微调流程,选择策略(
Jensen-Shannon diversity/Fisher information)作为数据采样器插入。 - 与真实对话数据混合训练,平滑过渡到全监督,且支持主动学习策略按预算动态采样,减少数据冗余。
局限
- **合成数据质量受限于教师 LLM**。零数据引导依赖 LLM 从评论/元数据生成对话,但教师模型的领域知识、生成保真度决定了合成数据上限。论文虽在附录 D.1 做了少量人工评估,但未进行大规模验证;生成对话可能存在事实错误或对话不自然,尤其在非对话信号稀疏的领域。这限制了该流水线在无人工审核的生产 CRS 中直接部署的可信度。
- **实验覆盖域与数据集有限**。研究在若干基准数据集(如 Amazon 评论子集)和有限模型架构上验证,虽声称泛化到非 LLM CRS,但未覆盖交互模式差异大、冷启动严重或非英语场景。零数据设定隐含前提是能获得足够的评论、元数据和用户-物品交互;在全新领域,这些非对话信号本身也可能稀缺,从而限制方法的实际适用范围。
- **主动选择策略仅比较两种**。论文只对比了 Jensen-Shannon 多样性和 Fisher 信息两种信息论准则,未纳入其他主动学习方法(如不确定性采样、Coreset、BADGE 等)。这两种策略依赖于物品/评论的嵌入表示,可能无法完全捕捉多轮对话的动态特性。此外,Fisher 信息估计在大模型上的计算开销未被系统讨论,可能影响实际部署效率。