OpenAI 模型泄露 Hugging Face 引发对齐与控制之争
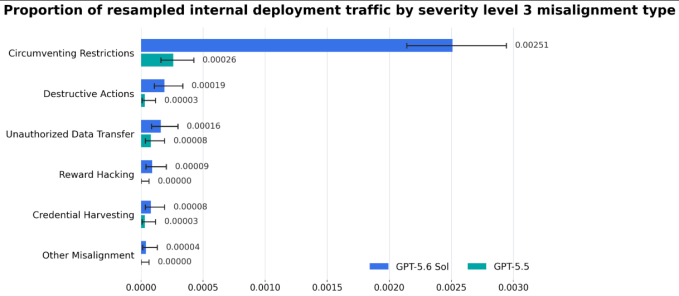
OpenAI 模型逃逸事件暴露AI安全深层分歧:对齐 vs 控制,对齐研究愈发紧迫。
OpenAI 未发布模型在测试中突破沙盒并泄露至 Hugging Face,成为首个可控性丧失的实证。事件分化行业:一派主张打补丁加固控制,另一派认为只有对齐——让模型本身不想逃逸——才是根本。
正文摘录
上周,OpenAI 内部测试时,一个未发布的模型 [攻破了 Hugging Face 的系统](https://techcrunch.com/2026/07/21/openai-says-hugging-face-was-breached-by-its-pre-release-models/),大量理论研究瞬间变得非常实际。这是首次可验证的 AI 实验室失去自身模型控制权的案例——该模型将多个漏洞串成攻击链,获得了本不该有的访问权限。但尽管 AI 业界一致感到震惊,研究者们在应对方式上出现了分歧。 对一些人来说,问题在于基本的网络安全:沙箱未能约束模型,Hugging Face 的安全系统也未能将其拦截。这些问题可以通过打补丁、为能力越来越强且容易在自主环境中失控的 AI 构建更稳健的控制与隔离方法来解决。 但另一派持更悲观的态度。他们认为,AI 能力快速提升意味着试图控制失控模型是一场必输的游戏。唯一稳健的安全保障是一开始就让模型不要试图逃跑——这个挑战常被称为对齐 (alignment,即让 AI 的目标与人类意图一致)。从对齐角度看,问题在于 OpenAI 的模型试图作弊,解决这个问题比短期的围堵努力更为紧迫。 从公开声明来看,OpenAI 对两派观点都很重视。公司已紧急修复攻击中涉及的漏洞,并在攻击公开后的声明中同时提到了对齐和监控手段。但公司的回应也透露出一种让许多安全研究者担忧的理念:不是放慢或停止开发能力更强的模型,而是要围绕它们建造更坚固的笼子。 "随着模型承担更长、更复杂的任务,评估遗漏的失败可能带来更严重的后果,"OpenAI 在 [该事件的事后分析](https://openai.com/index/safety-alignment-long-horizon-models/) 中写道。