联合国联合 Google 推出数据平台,让全球统计对 AI 可直接调用
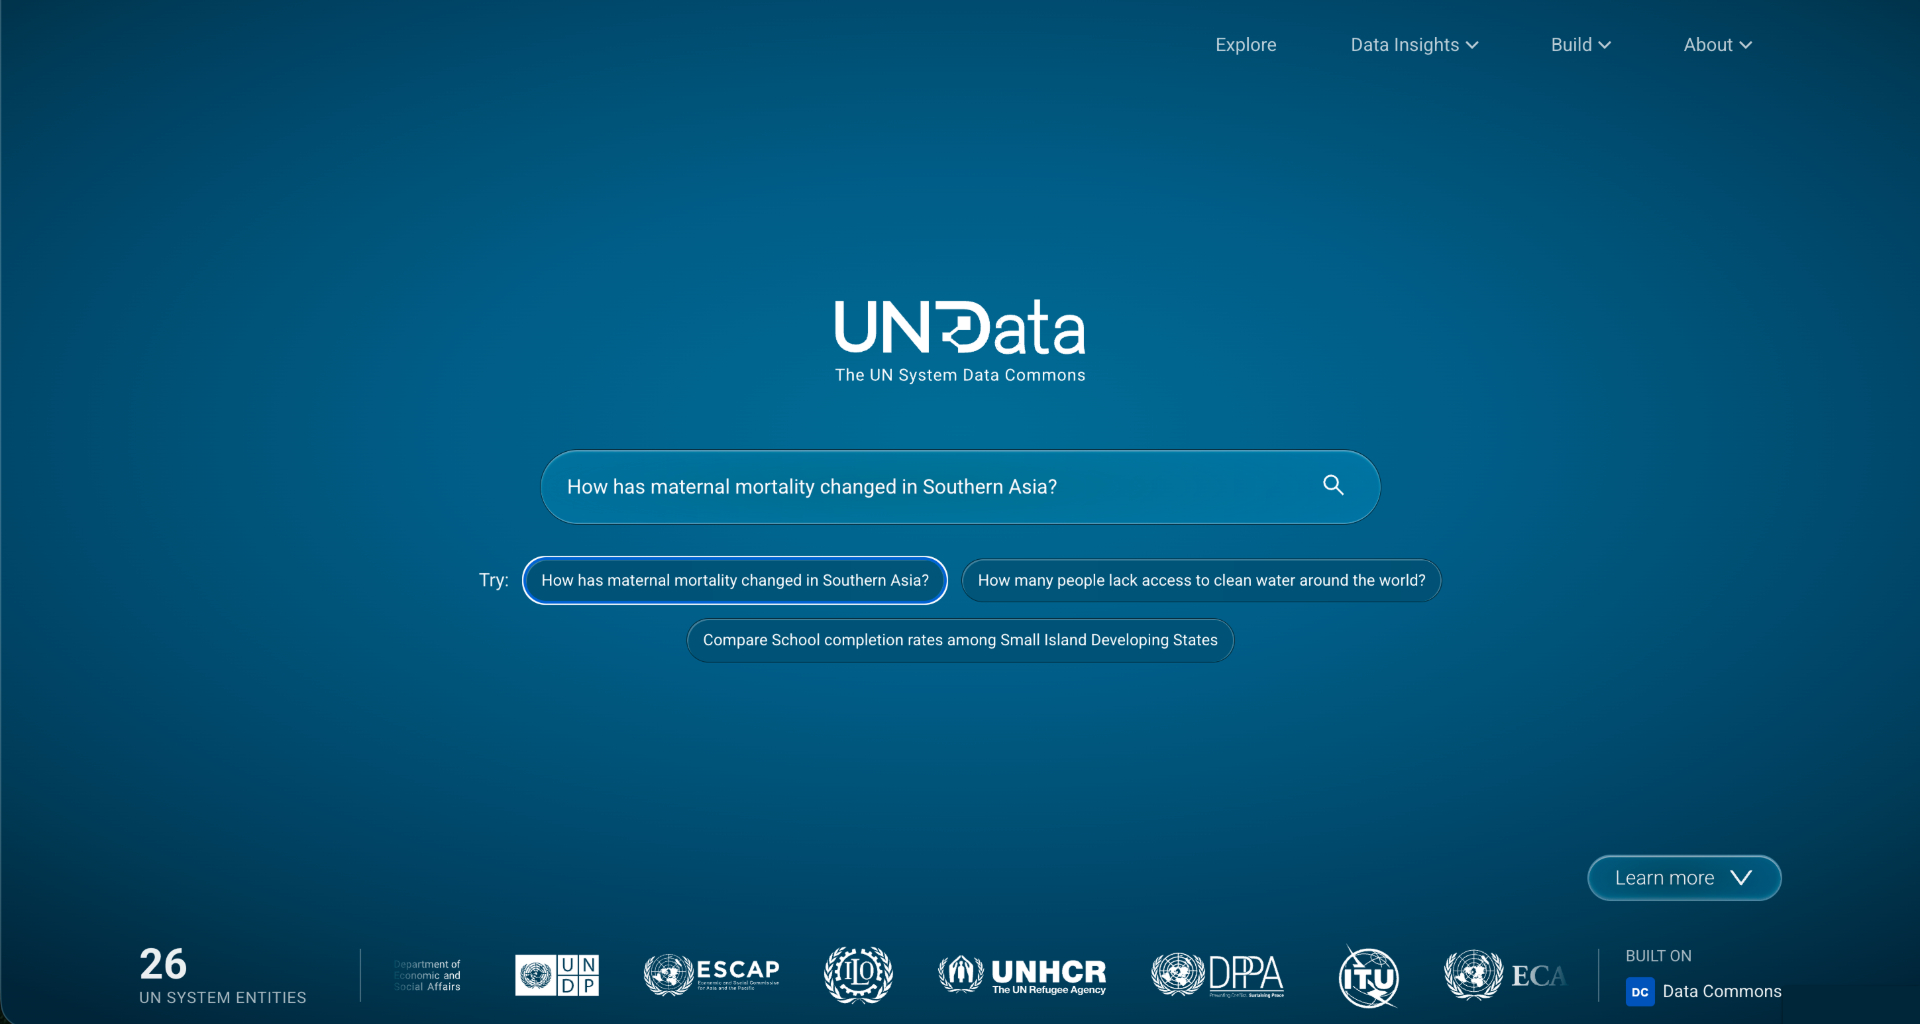
联合国借 Google 开源平台整理全球统计并接入 MCP,让 AI 直接取用权威数据;此前 UNICEF 实测大模型答这类问题准确率仅 21%。
联合国宣布与 Google 合作,把旗下各机构的全球统计数据搬上新平台 UN System Data Commons,用户可用自然语言提问查数据,AI 也能通过 MCP(模型上下文协议,一种让 AI 直接连接外部数据源的标准)直接读取。平台取代旧的 UNData 门户,已有近 20 个 UN 机构数据上线,目标是 2027 年前覆盖全系统 80% 的统计数据集。
正文摘录
联合国联手 Google,让其全球数据为 AI 智能体做好准备 联合国周四宣布,正在与 Google 合作,使其庞大的全球统计数据集合更容易被 AI 系统访问和使用。 这套名为 [UN System Data Commons](https://data.un.org/) 的新系统构建在 Google 的开源平台 [Data Commons](https://datacommons.org/) 之上,让用户可以用自然语言查询联合国各机构的统计数据。它取代了现有的 [UNData 门户](https://data.un.org/legacy/)——在旧门户上,用户基本只能通过更传统的数据库界面浏览和检索统计数字。新平台还支持 Model Context Protocol(MCP,模型上下文协议),这一标准允许 AI 系统直接连接外部数据源。 用户越来越倾向于用 AI 工具找答案,但许多系统仍难以可靠地呈现权威数据。UNICEF 对六款大语言模型做了一项基准测试,覆盖超过 13.3 万条针对全球发展指标问题的回答,平均准确率仅为 21.2%,该机构首席统计师 João Pedro Azevedo 在线上简报会上告诉记者。 Azevedo 告诉 TechCrunch,测试覆盖 OpenAI 的 GPT-4o 和 GPT-4o-mini、Anthropic 的 Claude Sonnet 4.5 和 Haiku 4.5,以及 Google 的 Gemini 2.5 Flash 和 Gemini 2.0 Flash。 Azevedo 说,大约五分之三的回答根本没有给出可用的数字,原因常常是模型在答案里含糊其辞。然而,当同样的问题在大约两天后用相同版本的模型再跑一遍时,两次都给出数字的模型里,只有大约一半给出了完全相同的数字。