新版 Claude 与 Gemini Carbon 内测细节流出,推理与编程能力提升
两条未发布模型的内部反馈流出:Claude 更擅长追问问题本质,Gemini Carbon 编程更强,可据以判断下一代模型的改进方向。
内部试用者称,新版 Claude 在推理和直觉上更强,被要求修一个 bug 时会识别出导致该 bug 的整类问题并询问是否一并修复,也更少给出套路化建议。Google 方面,Gemini 4 系列以 Argon、Barium、Carbon 为代号测试,Carbon 在编程任务上强于 Argon。
正文摘录
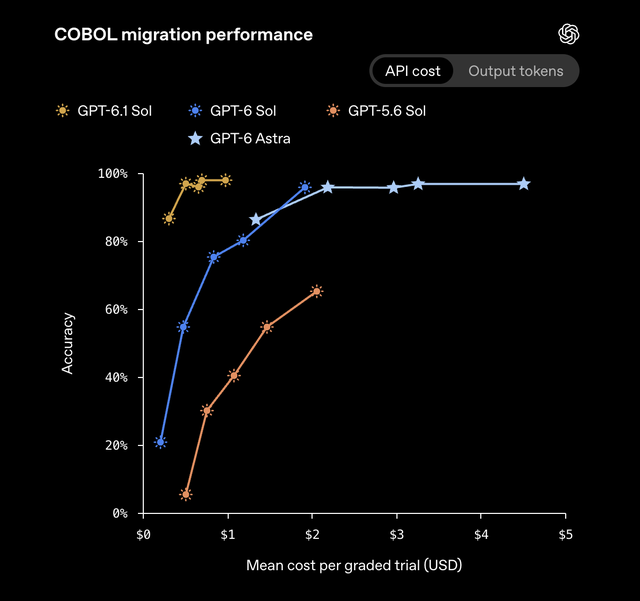
Claude 新款被评价为“重大飞跃”,修复一个 bug 时能“治本”,识别背后更大的问题一并处理。 Gemini 要发的是 Argon 升级款 Carbon,员工内测反馈“能打 Opus 5.5”。 根据内测用户的说法,新版 Claude 在推理和直觉方面更好,特别擅长判断一个人的潜在意图和目标。 例如,一个人可能会要求模型修复一个单一的 bug,而模型可能会去识别导致该 bug 的根本类问题,并询问是否应该修复整个类问题,这位使用过该模型的人表示。 新版 Claude 在跳出思维定式方面也表现得更好,而不是重复常见的常识性建议或解决方案。 如果用户询问关于如何投资股票的建议,它不会建议老套地查看市盈率高低,而是会提出自己创造性的算法来预测未来的股票表现。 Carbon 在编程任务上优于 Argon,在需要视觉理解的任务上继续表现更好,如分析视频或测试前端页面功能(得益于用了 YouTube 数据训练)。 Carbon 在谷歌内部编程平台 Jetski 上向员工开放了数日,体验过的员工认为“感觉与 Opus 5.5 相当”,但还需要更多测试。 Google 测试了一系列 Gemini 4 模型,代号分别为 Argon、Barium 和 Carbon。 在 Carbon 内测的表现泄露后,谷歌员工 Vedant Misra 发帖回应“你听说过递归自我改进(RSI)吗”。 那么之前很多人怀疑 6.1 Sol 其实是 Terra 改个名字发出去,看来猜错了。原来 6.1 Sol 只是单纯地与 5.6 Sol 相比升级不大啊。 很多人看到要出 6.1 Terra 的消息时,反应都是,感觉 OpenAI 已经自暴自弃了,破罐破摔了。 因为他们打算把 ChatGPT 的 Chat/Work 和 Codex 模式合并在一起,那么就需要一个更便宜的模型给免费用户用。