中国电信开源 Xing4.0-29B-A4B,4-bit 量化后单张 3090 可跑
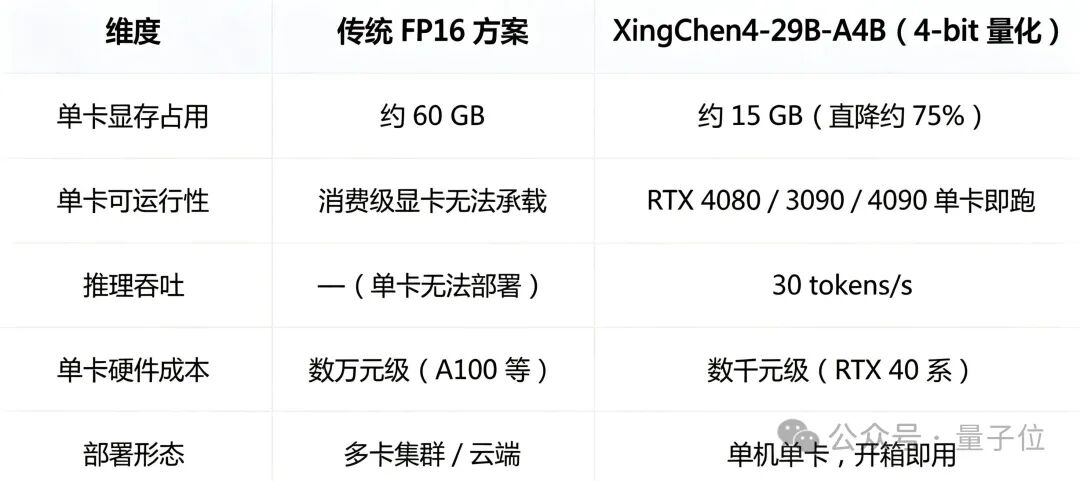
又一个小而能干的开源模型:290 亿参数只激活 40 亿,全部在华为昇腾上训练,量化后消费级显卡就能跑,重点补强写代码和跑长流程任务的能力。
中国电信 AI 开源 Xing4.0-29B-A4B,一款全栈国产的轻量级代码智能体模型。它用 MoE 架构(混合专家,每次推理只调用部分参数),总参数 290 亿、激活约 40 亿,4-bit 量化后单张 RTX 3090 即可运行,瞄准数据不能出域、算力有限的企业本地部署场景。
正文摘录
这个夏天,大厂们集体加注 AI 办公。卷 Agent 能力,卷工作入口,卷企业工作流,Coding 之后,办公成了 Agent 的下一个必争之地。 原因现实得很扎心。他们数据不能出域,模型最好就地部署,手头算力又不算富裕。可偏偏,长文档要读,复杂业务要办,该干的活一样不少。 中国电信 AI 这次最新开源的 Xing4.0-29B-A4B,瞄准的就是这批需求。 而且,这次带来的还是一款全栈国产化的轻量级代码智能体大模型。从国产芯片、国产训练框架,到模型训练和推理部署,整条技术链路都做了系统适配。 为了尽可能实现本地部署,Xing4.0-29B-A4B 采用 MoE 架构,290 亿的总参数,每次推理只激活约 40 亿参数,经过 4-bit 量化后,一张 RTX 3090 就能运行。 比如,处理重要文档时,模型可以直接在本地完成内容理解、指标提取和信息整理,数据全程不用离开企业环境。 再比如,一份 200 页的投标文件交过来,模型能在本地用约 20 分钟,完成技术、商务、价格三个方面的初评,并逐条给出评分依据。 Xing4.0-29B-A4B 完全基于华为昇腾 910C 算力训练,并采用国产的 MindSpore/MindFormers 训练框架与开发套件,真正实现了国芯训国模。 在推理部署端,它还完成了昇腾的适配验证。可以说,从训练到落地,国产算力这条路也已经走通。 目前,模型已经在 GitHub、Hugging Face、Gitee、魔搭、魔乐等平台开源上线,并同步支持 API 调用。 值得一提的是,截止发稿,Xing4.0-29B-A4B 现在已经冲进 HuggingFace 模型趋势榜单,位居第四。 一份文档读完了,可能还要提取信息、调用工具、核对结果,最后整理成一份能交出去的材料。 要满足这些要求,既要继续压低部署和运行成本,也得把干活的能力练扎实。