Generalist AI 发布机器人基础模型 GEN-1.5,支持单次示范学习新任务
通用机器人模型 GEN-1.5 实现单次演示学习新任务,无需微调,能力源自大规模预训练,是机器人领域走向通用化的关键一步。
GEN-1.5 是机器人基础模型,通过大规模物理数据预训练,看一眼 3-12 秒的示范就能学会新动作,无需重新训练。它还能拼接不同演示、将模拟器经验迁移到现实,这些能力是在预训练中自然涌现的,类似 GPT-3 的上下文学习,被称作物理版 Prompt Engineering。
正文摘录
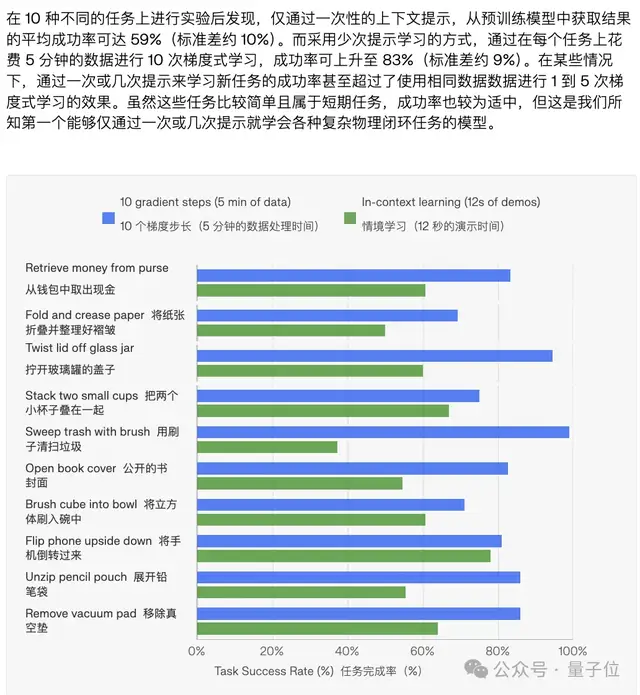
哪怕是从没学过的新活,只要给机器人看一段 3-12 秒的动作示范,人家下一秒直接大干特干!!! 这,就是 Generalist AI 刚刚发布的机器人基础模型——GEN-1.5。 一个主打 One-shot Learning 的机器人模型,通过大规模物理数据预训练,能让机器人只看几秒示范,就快速学会新任务。 此外,这模型还能把两段不同的教学演示拼起来学,模拟器里看一遍,转头到了真实世界,也能直接上手。 甚至吧,这些能力根本没人手把手教过,而是在大规模 Physical Data 预训练过程中模型自己「悟」出来的。。。 物理版 Prompt Engineering 来了:机器人看 3 秒演示就能学会!不知道大家还记不记得。 GPT-3 当年真正把人《看愣》的能力之一,就是 In-Context Learning。 给模型一个或者几个例子,它不用重新训练,光看上下文,就能临时 get 到一个新任务要怎么做。 底子还是那套底子,继续猛吃真实世界里的物理交互数据,但这回一个很关键的新本事冒出来了: 人类先演示 3-12 秒,整个过程中没有梯度更新,也没有任何微调,GEN-1.5 看完这段 Physical Prompt,转头自己就能上手。 而且吧,GEN-1.5 最神的一点还在于,在 GEN-1.5 的世界观里,不同演示教学甚至还能「拼起来用」。。 重新定位、调整抓法、切换姿势,甚至中途出了错之后怎么继续往下做,都可能由模型自己补出来: 脚本策略跑出来的动作、强化学习 Agent 做出的演示、人类在模拟器里遥控机器人完成的操作,都能被塞进它的上下文里,当成 Physical Prompt。 下面这个例子就很直观,GEN-1.5 先看左边模拟器里的虚拟演示,随后直接去右边真实世界 1:1 复现。 不知道大家有没有一样的感觉,就 GEN-1.5 这东西,真的很像现在我们用大模型的方式。