紫东太初开源 9B 多模态模型 ZDTaichu5.0-9B,兼顾空间具身与通用能力
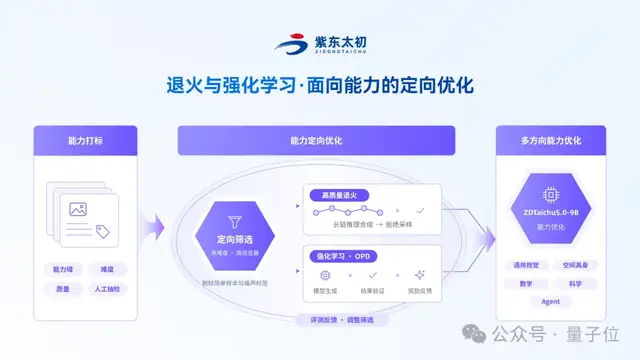
紫东太初开源 9B 多模态模型 ZDTaichu5.0-9B,在空间具身任务上表现突出,同时保留图文、数学与代码等通用能力。
紫东太初开源了通用多模态大模型 ZDTaichu5.0-9B,参数约 9B。此前多模态模型看图理解不错,但进入真实物理环境后,空间理解和行动规划常跟不上;有些模型为补空间能力又牺牲通用能力。该模型试图同时守住两条线。
正文摘录
紫东太初最新开源的通用多模态大模型 ZDTaichu5.0-9B,直接把 10B 以下通用模型空间具身的天花板又往上顶了一大截。 过去的多模态模型,已经能把一张图片理解得头头是道,但一旦走进真实物理世界,空间理解与行动能力往往就跟不上;而一些模型为了补足空间能力,又不得不以牺牲通用能力为代价。 视频链接:https://mp.weixin.qq.com/s/aBak5FZaC6nhGpwkeL8hAg 如果让人来做,应当是个非常简单的过程:拉开抽屉→放进去→再关闭。但具身不一样,一连串的动作背后都是相当细致的空间判断。 每一步都要承接住上一步带来的变化,动作才能看起来顺,这对模型能力的考验是极为苛刻的,而 ZDTaichu5.0-9B 已经能完成复杂的空间理解和高层任务规划。 与此同时,对于这个只有 9B 大小的模型,其图文理解、文字识别、数学推理和代码能力也依旧稳居第一梯队。 这个空间感知任务对于机器人来说,是后续执行任务的大前提。指错了,后面的抓取动作再准确,执行的也是另一个任务。 视频链接:https://mp.weixin.qq.com/s/aBak5FZaC6nhGpwkeL8hAg 画面中,台面挤满杯子、收纳容器和各种杂物,干扰项较多。模型得同时读懂银色这个关键属性、盒子这个对象,以及从左到右第二个这层空间排列关系。 从对比演示中看,ZDTaichu5.0-9B 给出的归一化坐标(237,226)最为精准,落在目标标注区域内。 视频链接:https://mp.weixin.qq.com/s/aBak5FZaC6nhGpwkeL8hAg 输入的是同一房间的三个视角。模型需要设想自己移动到绿框窗帘所在的位置,面向蓝框沙发,再判断红框柜子相对自己的方位。