任少卿以通讯作者身份发表自动驾驶世界模型论文 MM-Future
自动驾驶世界模型从「预测未来」走向「预演多种未来再选路」,蔚来给出了把场景与动作双向耦合的工程方案与基准结果。
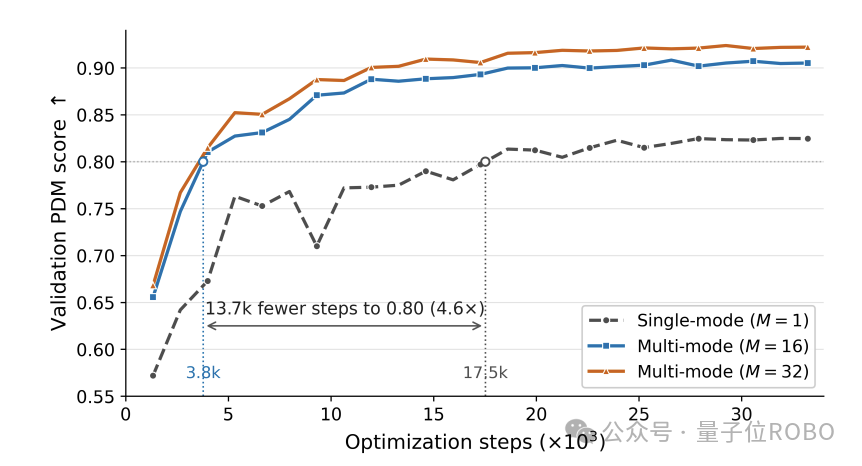
蔚来团队发布论文 MM-Future,提出多模式世界—动作联合模型:一次生成多组「场景—动作」假设,让轨迹和对应的未来场景共同演化,再从中筛选最安全的方案。在 NAVSIM 基准上取得 94.0 PDMS。
正文摘录
最近,任少卿指导发布论文《MM-Future: Multi-Mode Joint World–Action Modeling for Autonomous Driving》,提出一种新的多模式世界—动作联合模型。 公开学术记录中,他的代表性研究主要集中在 2014—2016 年,包括 Faster R-CNN、ResNet 等一系列计算机视觉经典工作。 这一次,他重新以通讯作者身份出现在自动驾驶论文中。论文第一机构为 NIO,多位作者来自蔚来,研究方向也直接指向世界模型和规划。 这篇论文要解决的核心问题很明确:同一个驾驶场景下,系统需要处理的不只是一条轨迹,也不只是一个确定的未来。 团队的思路是:让模型一次生成多组场景—动作假设,车辆轨迹与对应的未来场景共同演化,最后再从中选择。 简单来说,自动驾驶不仅能看清周围环境,还能预演多种可能的未来,最终选择最安全的路径执行。 World–Action Model 则进一步增加了未来场景建模,让规划不仅依据当前环境,也参考动作可能带来的后果。 一类是 级联式方案。例如先生成几条候选轨迹,再分别预测每条轨迹对应的未来场景;或者先预测未来场景,再基于场景完成规划。这种方式可以生成多个候选结果。 但这种方法的问题也很明确:信息按 单向传递,后生成的变量无法回头修正前面的决策。 假如模型已经先确定自车向前通过路口,随后才预测到对向车辆没有减速,这个未来结果很难重新参与前面的动作生成过程。 车辆动作变化,预测环境随之调整;环境一旦变化,也会反过来影响车辆轨迹。现有这类方法通常只生成一组场景—动作结果。 论文指出了其中的空白:级联式模型可以覆盖多种驾驶结果,但场景和动作之间缺乏双向交互;联合模型具备双向交互能力,但通常只生成单组结果。 MM-Future 给出的方案是:一次生成多组场景—动作假设,每一组内部的场景和动作继续共同演化。