MIT 团队让 GPT-6 Astra 直接改写 Qwen 权重,数学得分升至 48.1%
大模型开始直接读写神经网络权重本身:不改训练流程、只动极少量参数就能大幅提升数学成绩,为模型的递归自我改进提供了新路径。
MIT CSAIL 让 GPT-6 Astra 直接读取 Qwen3.5-0.8B 的原始权重,定位导致推理循环的问题参数,只改约 0.016% 的参数,就把 MATH-500 成绩从 7.9% 提到 48.1%,全程没有重新训练、也没用梯度下降。团队把这种能力称为权重空间编程(Weight-Space Programming)。
正文摘录
 如果把一个训练好的神经网络摊开,只给大模型看一串权重数字,它能看出这个模型学会了什么吗?甚至能直接修改其中一小部分参数,让模型变得更聪明? 这听起来有些不可思议。MIT CSAIL 团队最新公布的一组实验,却让这个设想有了初步的现实依据。 团队让 GPT-6 Astra 直接检查 Qwen3.5-0.8B 的内部权重,找到了导致模型反复陷入推理循环的关键问题。随后 Astra 只修改了约 0.016% 的参数,就将模型在 MATH-500 上的成绩从 7.9% 提升至 48.1% ,指令遵循能力也提升了近两倍。整个过程没有重新训练模型,也没有使用梯度下降。 更有意思的是,Astra 还尝试从零编写神经网络权重。在没有训练数据、梯度和训练过程的情况下,它生成的游戏策略网络,甚至超过了经过 1 亿步 PPO 训练的模型。 团队将这种新能力称为 Weight-Space Programming(权重空间编程) 。 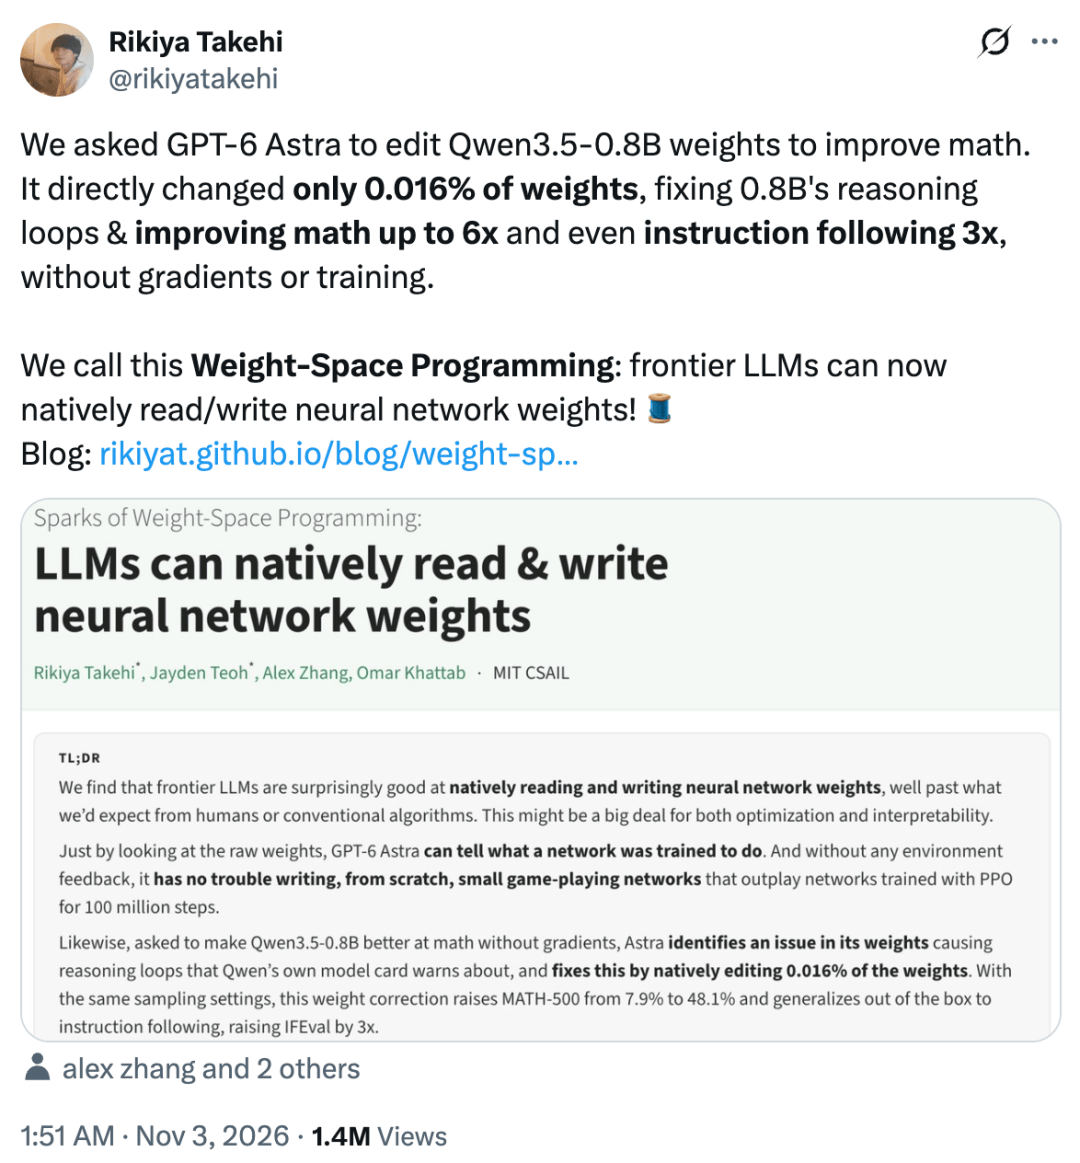 这意味着,大模型开始尝试直接理解神经网络内部的参数结构,找到问题所在,再动手修改模型本身。 从 AI 帮助人类训练模型,到 AI 开始直接参与模型权重的优化,这条路线可能为模型研发和递归自我改进(RSI,指模型改进自身或下一代模型的能力)打开新的空间。