LeCun 团队用数学证明 next-token 预测效率低于 JEPA 路线
论文用数学论证了逐 token 续写不如直接对齐同一场景的不同描述,为世界模型路线提供了可操作的训练配方。
Yann LeCun 团队的新论文把「柏拉图表征假说」(不同模态训练的模型会收敛到同一套现实表征)从经验猜想变成可证明的定理,并给出充分条件:让模型同时学习同一场景的不同描述(「好视图」),而非同一句话的遮盖版本。在 Flickr30k 与 Recap-DataComp 上,1.09 亿参数的 JEPA 模型对齐效果超过 720 亿参数的语言模型,样本效率提升约 42 倍。
正文摘录
 编辑|Neo、泽南 人工智能先驱 Yann LeCun 一直主张「生成式 AI 是一条死胡同,世界模型才是真的未来」。 他认为自回归生成有数学上的硬伤,文本承载不了人类的大部分知识,真正的推理也不是基于优化的推断,衡量智能的标准应该是学习新任务的速度,以及零样本应对全新环境的能力。 基于这种观点,LeCun 寻求的替代路线是世界模型 + JEPA,一套目标驱动型架构。最近他提交的一篇论文向着这个方向前进了一大步, 它从数学上论证了「next-token 预测路线效率低下」,还给出了自己的方法,用一个 1.09 亿参数的模型打败了 720 亿的 LLM。 一个只看图片的模型,与一个文本大模型,会不会在内部形成相似的「概念地图」? 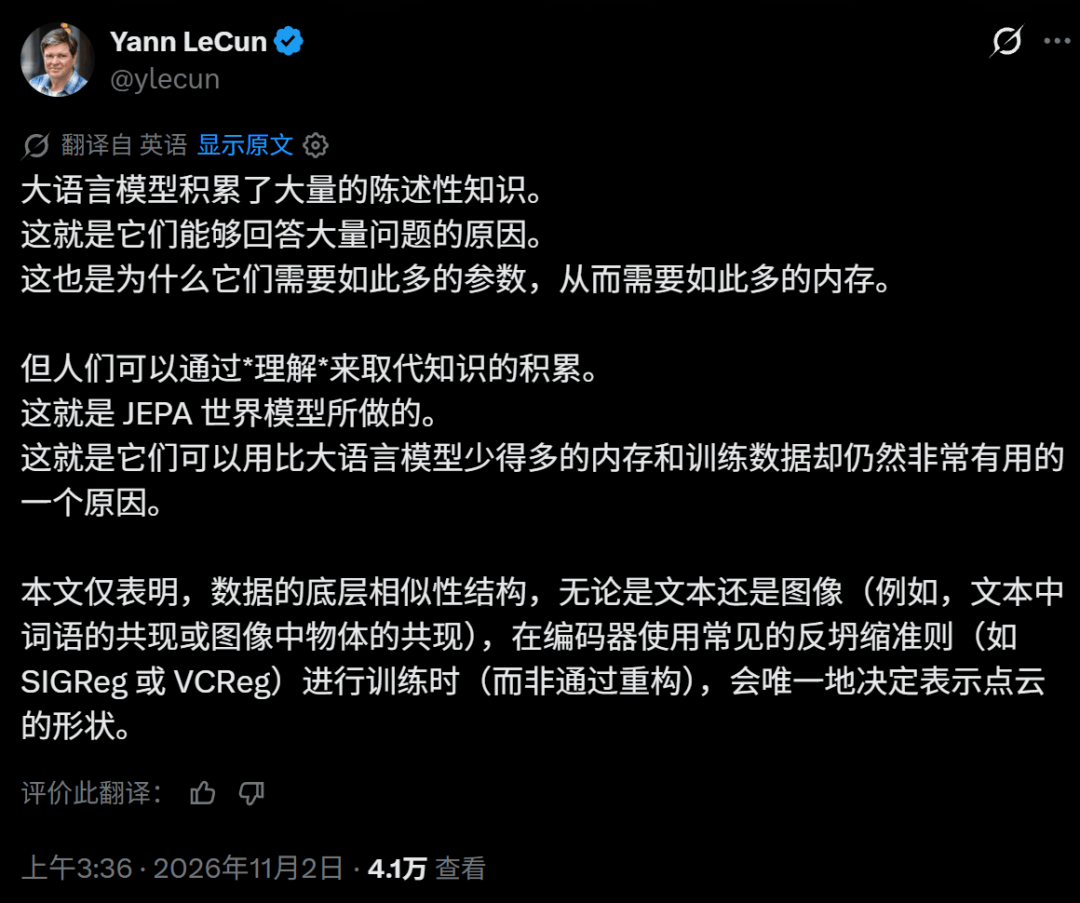 柏拉图表征假说(Platonic Representation Hypothesis, PRH) 由 Huh 等人在 ICML 2024 论文中提出,指在不同模态(视觉、语言)上分别训练的模型,随着规模增大其内部表征会越来越相似, 最终收敛到同一个对现实的共享统计模型 。这就如同柏拉图洞穴里不同的人看到了同一个「理念世界」。但它只有经验曲线和一个理想化对比学习器的直觉论证,既没有证明也没有配方,行业能做的只有继续堆规模。 这篇论文做的事就是把它变成定理,并给出了可操作的充分条件。