Databricks Feature Store 实现亚秒级特征新鲜度
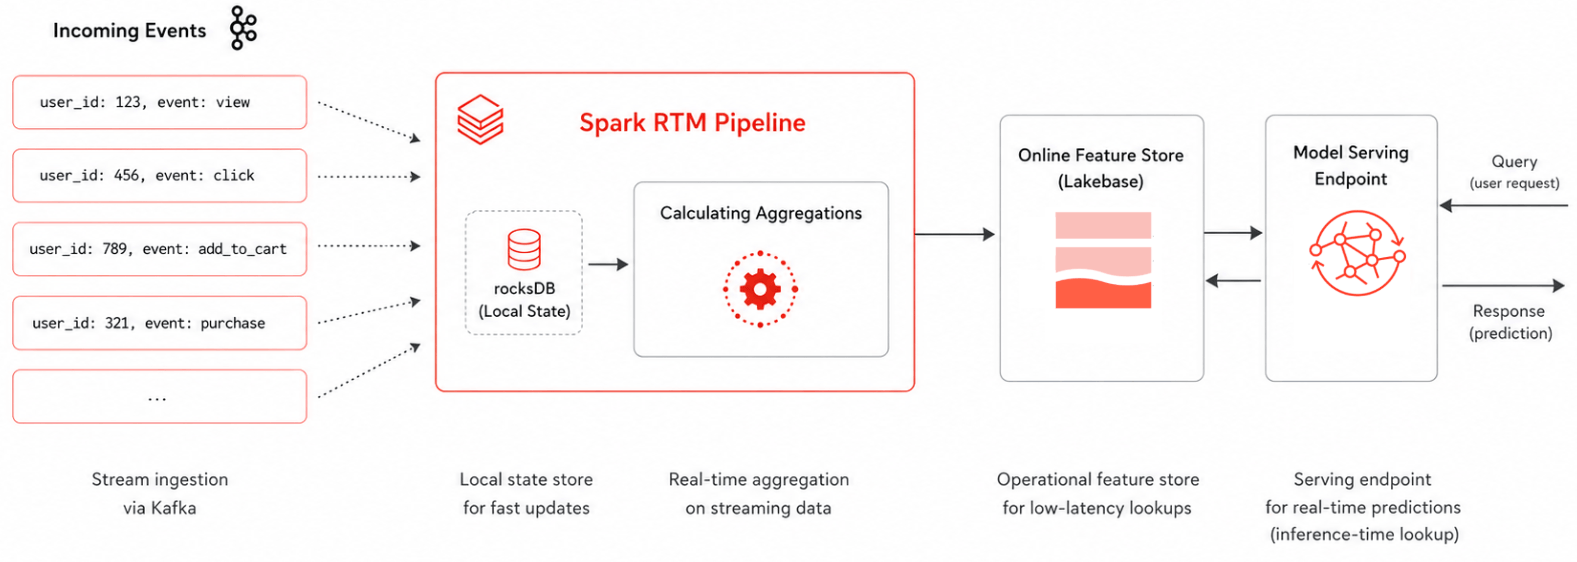
Databricks Feature Store 通过流批一体设计,让特征从事件产生到上线服务只需 200 毫秒(p99),解决实时 ML 的延迟瓶颈。
机器学习模型依赖实时信号,例如欺诈检测需要在毫秒内判断交易。Databricks 的 Feature Store 将同一特征定义同时用于批量离线计算与流式在线计算,从 Kafka 事件到达至特征可用,p99 延迟仅 200 毫秒。无需自建复杂流处理基础设施。
正文摘录
Databricks Feature Store 如何提供亚秒级新鲜度的特征服务 作者:Ian Ackerman、Nick Joung 和 Abhay Bothra 机器学习模型的效果取决于它们接收到的信号。一个欺诈检测用例必须在用户点击购买后的毫秒级时间内决定是否允许该笔交易。做出正确判断,取决于能否看到几秒前刚发生的可疑交易。将用户过去 30 天的平均交易额与过去 10 分钟的总交易金额结合起来,就能凸显潜在的欺诈行为。长期聚合为用户建立了一个基线画像,用来判断什么是正常行为;而最新数据则有助于在异常行为发生的当下立刻将其暴露。个性化推荐也面临同样的压力:最新鲜的信号才能捕捉用户当前的意图并驱动用户参与度。 Spark 管道是在 Lakehouse 中批量处理数据、生成历史基线特征的主流方式。按固定调度运行这些批处理任务虽然成熟可靠,但会引入数分钟到数小时的延迟。对于用户的基线信号来说,这种延迟是简化基础设施所付出的可接受代价。当模型需要新鲜信号时,这套基础设施就撑不住了:在现有的特征存储平台中,把延迟降到秒级甚至毫秒级是不可能的。为了获得新鲜特征的价值,数据科学家不得不实现复杂的、面向流式处理的专用逻辑来处理这些聚合,并自行搭建托管基础设施。 Databricks Feature Store 让你可以一次定义特征、处处使用:同一个定义既能驱动离线的规模化批处理流程,也能驱动在线的高新鲜度特征管道。该框架免去了基础设施负担,统一编排了 Spark Real-Time Mode (RTM) 用于持续流处理、Lakebase 用于面向流的在线存储、以及 Model Serving 用于规模化检索。特征一旦定义完成,就可以在毫秒级内被服务:从事件到达 Kafka 到在线特征存储中可用,端到端 p99 延迟为 200ms。