Databricks 用 MLflow Prompt Registry 让文档抽取改进可量化
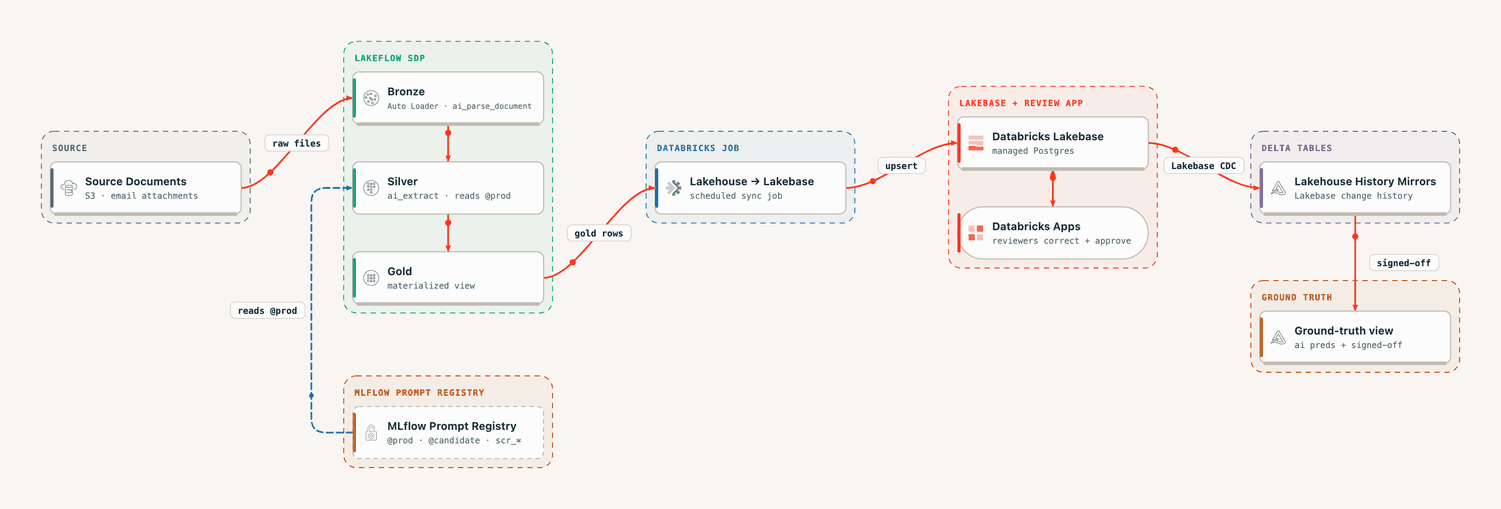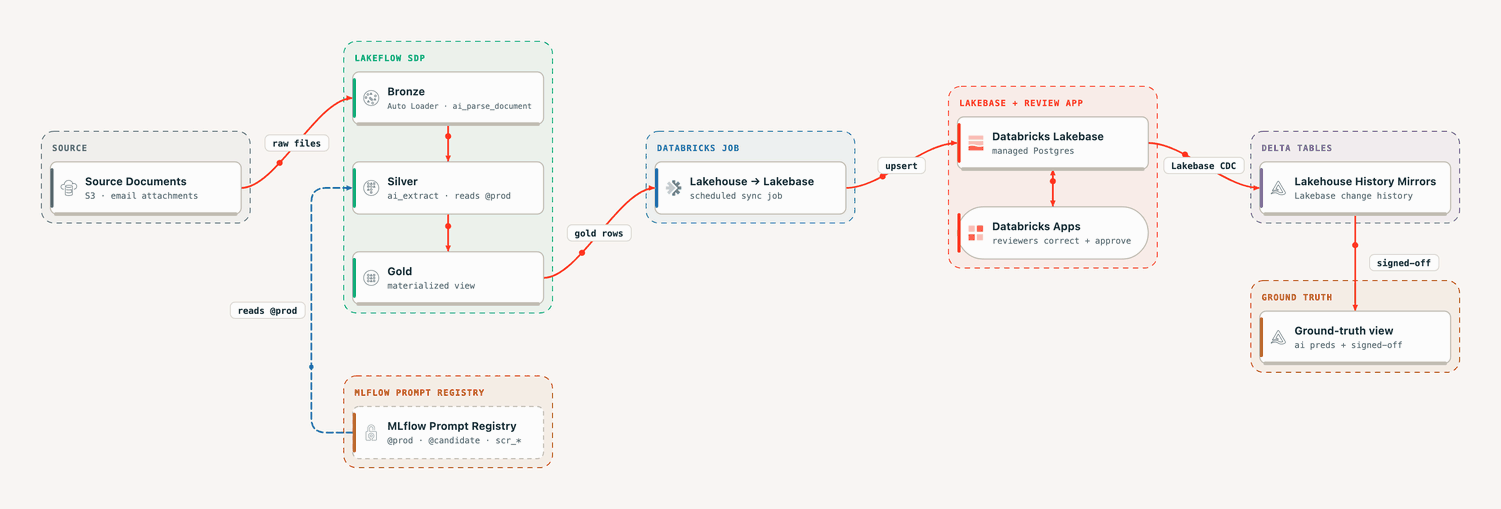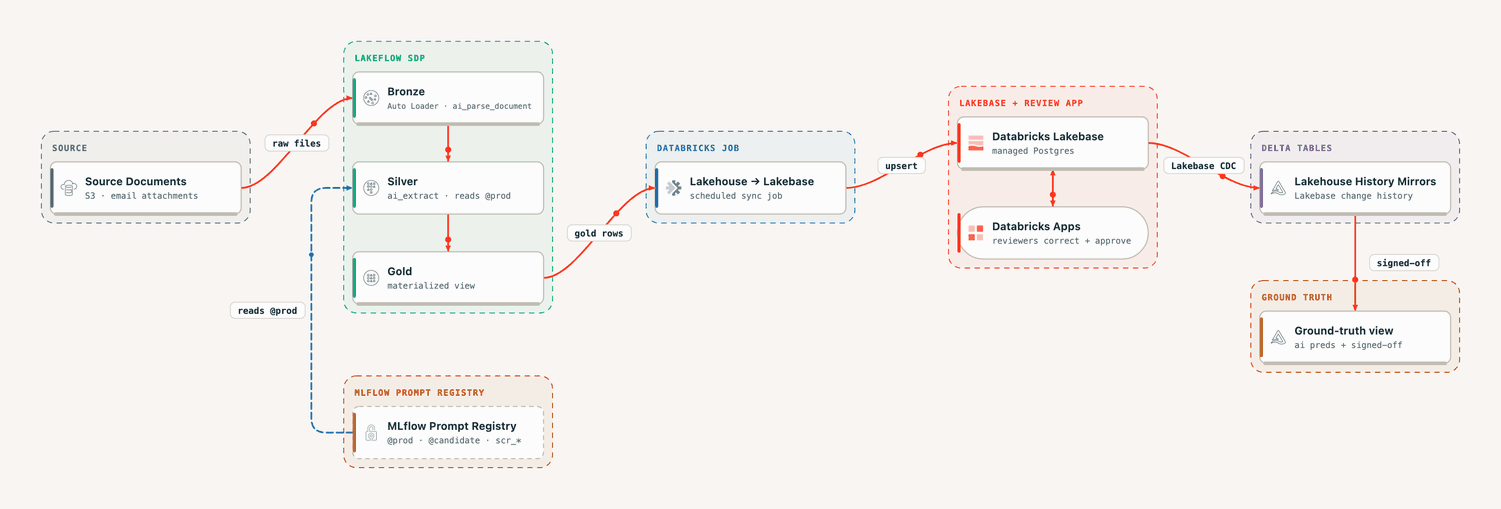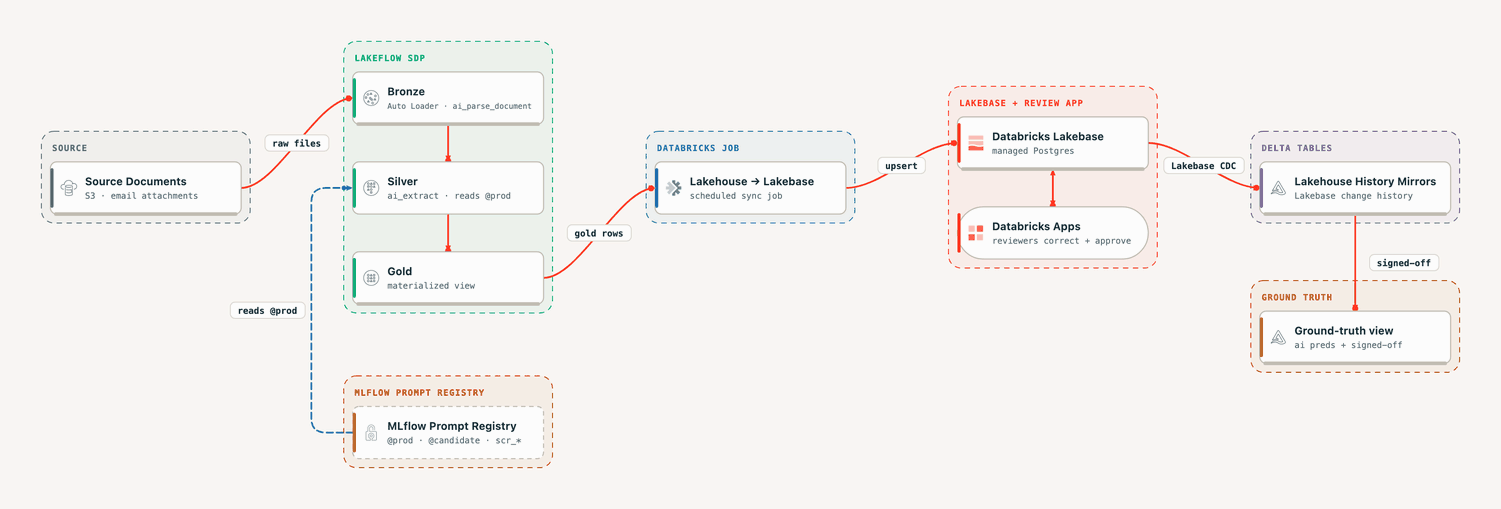
讲的是如何把文档抽取的调参从「点状修补」变成有评测数据支撑的可版本化流程,以及 Genie Code 能自动跑这个循环。
文档抽取常见做法是发现字段出错就改 prompt 或 schema、重跑一遍,但当字段和版式变多,这种做法会失效:修好一个字段可能让别处退化,或只是 LLM 运行的正常波动。Databricks 团队在从数十种 PDF 版式中抽取约 40 个结构化字段的项目里,把人工审核结果做成可复用的评测集,并把 prompt 与 schema 从流水线代码中抽出来做版本管理,让每次改动都有整体效果的证据。
正文摘录
从点式修补到可度量的收益:用 aiextract 与 MLflow Prompt Registry 提升文档抽取准确率 如何提升 aiextract 的准确率、对 prompt 与 schema 做版本管理、评估结果,以及 Genie Code 如何为你自动化这些工作 作者:Kristen Drexinger 与 Seshendranath Balla 文档抽取往往从一个简单的循环开始:发现某个字段抽错了,调整 prompt 或 schema,重跑这份文档,然后看结果。 当字段和文档格式成倍增加时,这种做法就变得不可靠。一次改动可能修好了某个字段,却在别处引入回归;可能对某种版式有效,换一种就失效;也可能只是看起来更好——其实那只是 LLM 多次运行之间的正常波动。 我们在最近一个项目里就遇到了这种情况:从合作伙伴提交的订单文档中抽取约 40 个结构化字段,涉及数十种 PDF 版式。抽取出的值在进入下游之前会由审核人员修正并批准,这为我们提供了经人工审核的 ground truth 用于评估。 难点不在于让 aiextract 返回这些字段,而在于在不使整个系统退化的前提下提升抽取质量。 例如,revision 字段有时会返回 ORIGINAL 这类状态词,而不是版本号或空值。对 schema 做一个小改动,就把该字段的错误减少了约一半。但把所有字段加在一起统计,抽取错误总数反而上升了 9%。 教训很清楚:改善单个字段,并不等于改善整个抽取系统。 这条 pipeline 其实已经具备了系统化评估改动所需的大部分组件。文档落入对象存储,经 Auto Loader 流入 Lakeflow SDP pipeline。