Databricks 支持在 SQL 中调用开源决策模型
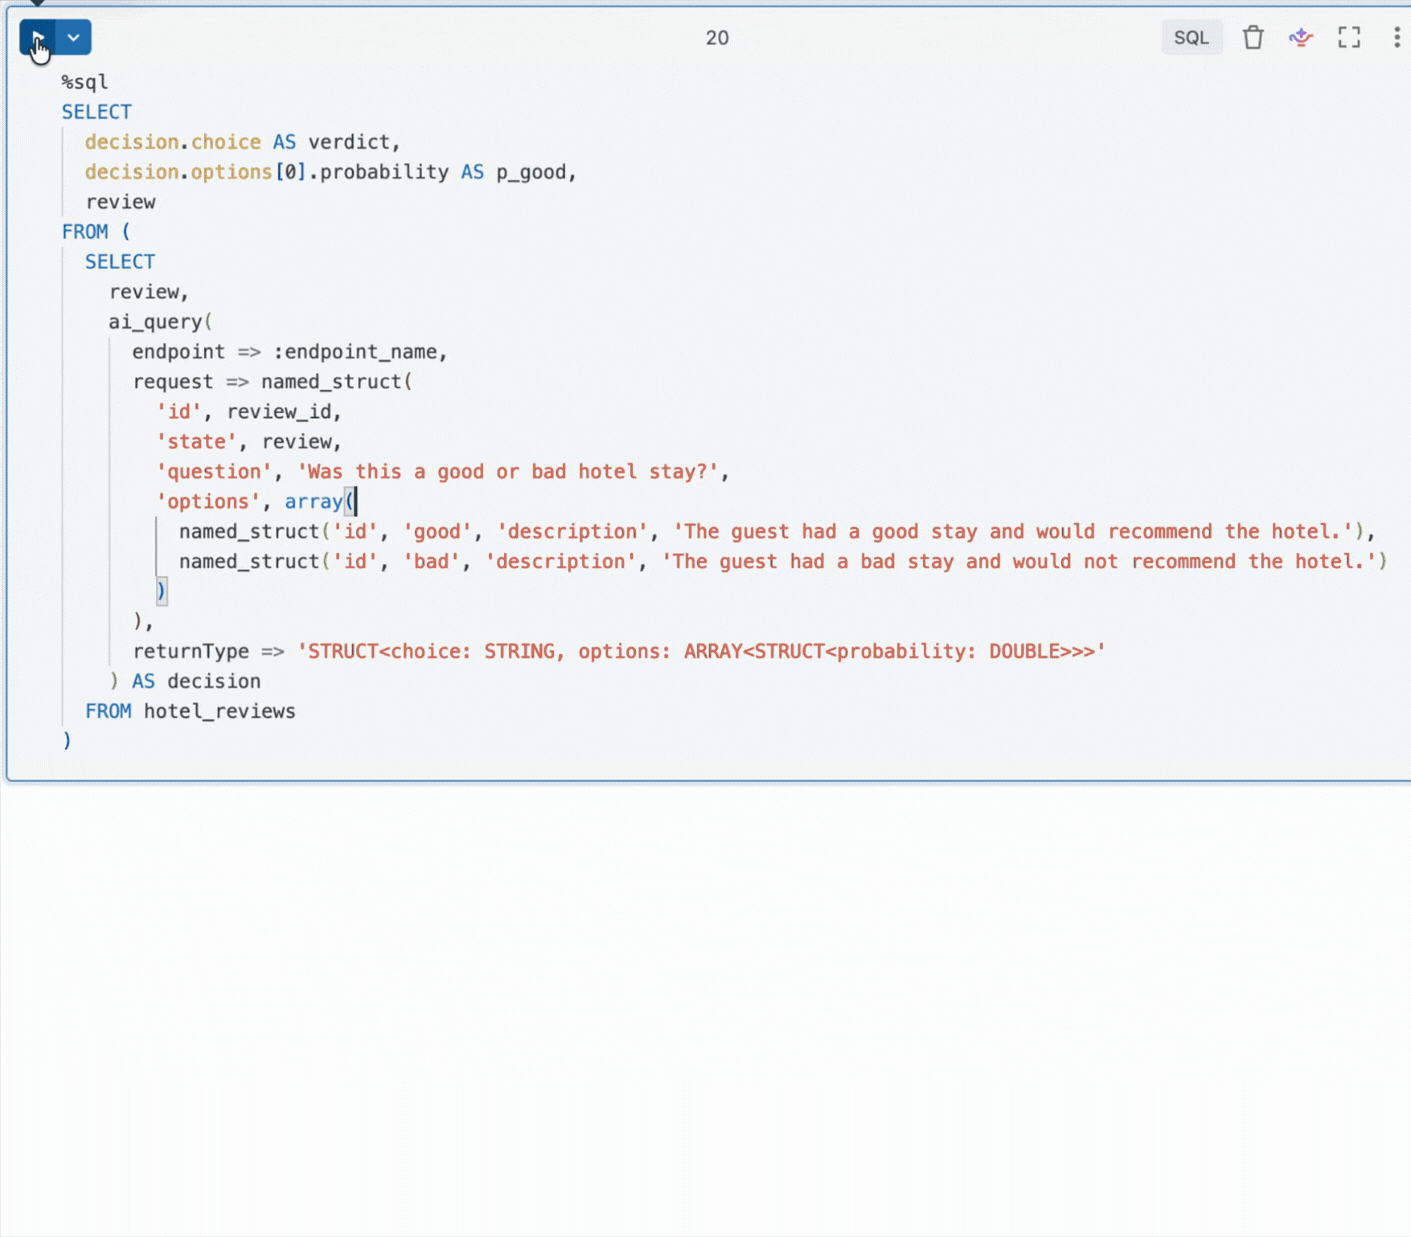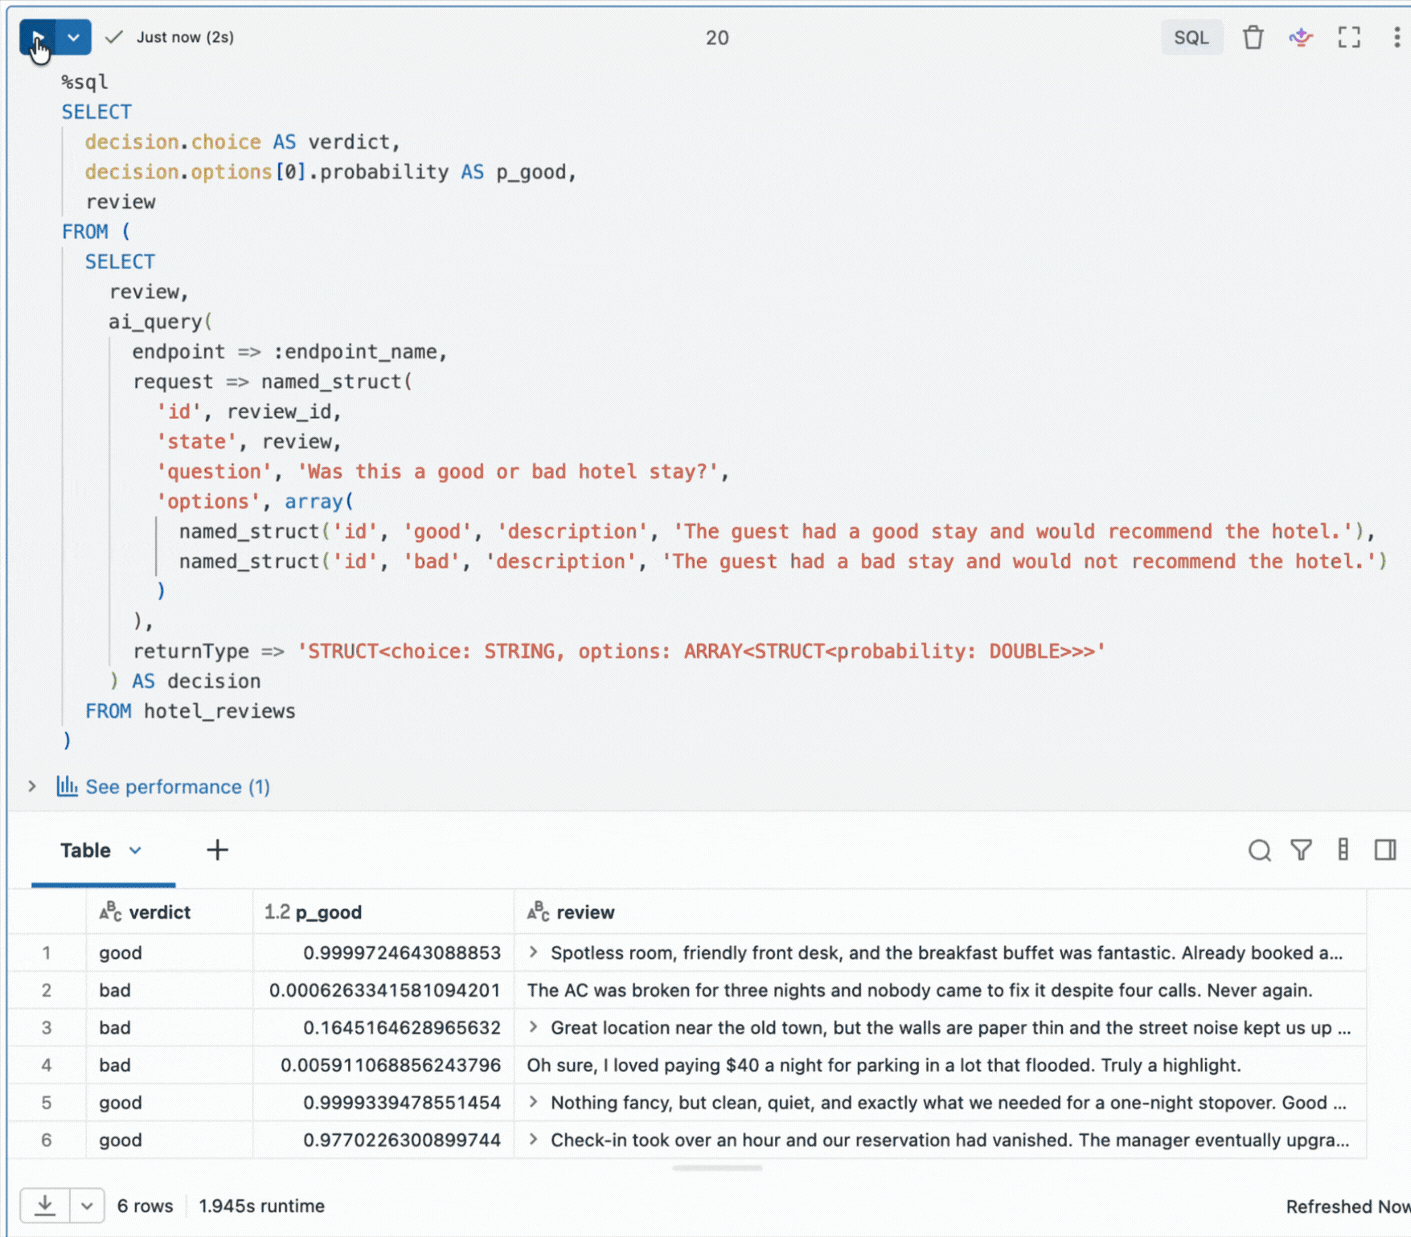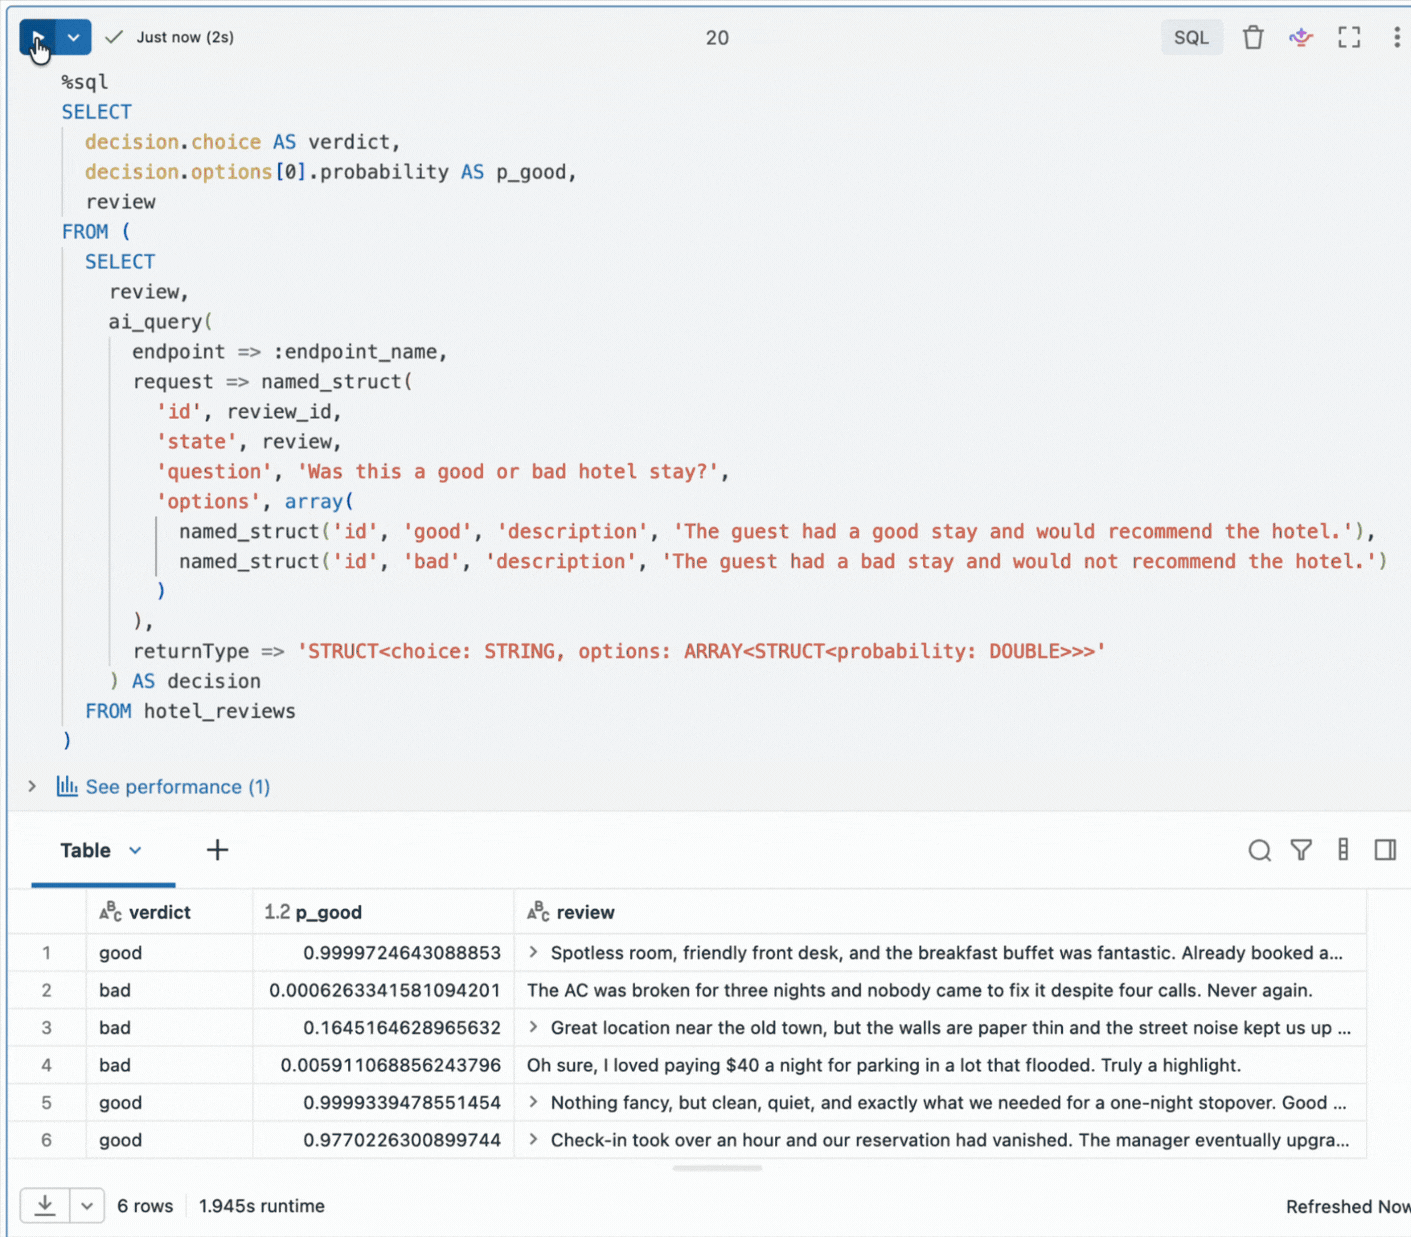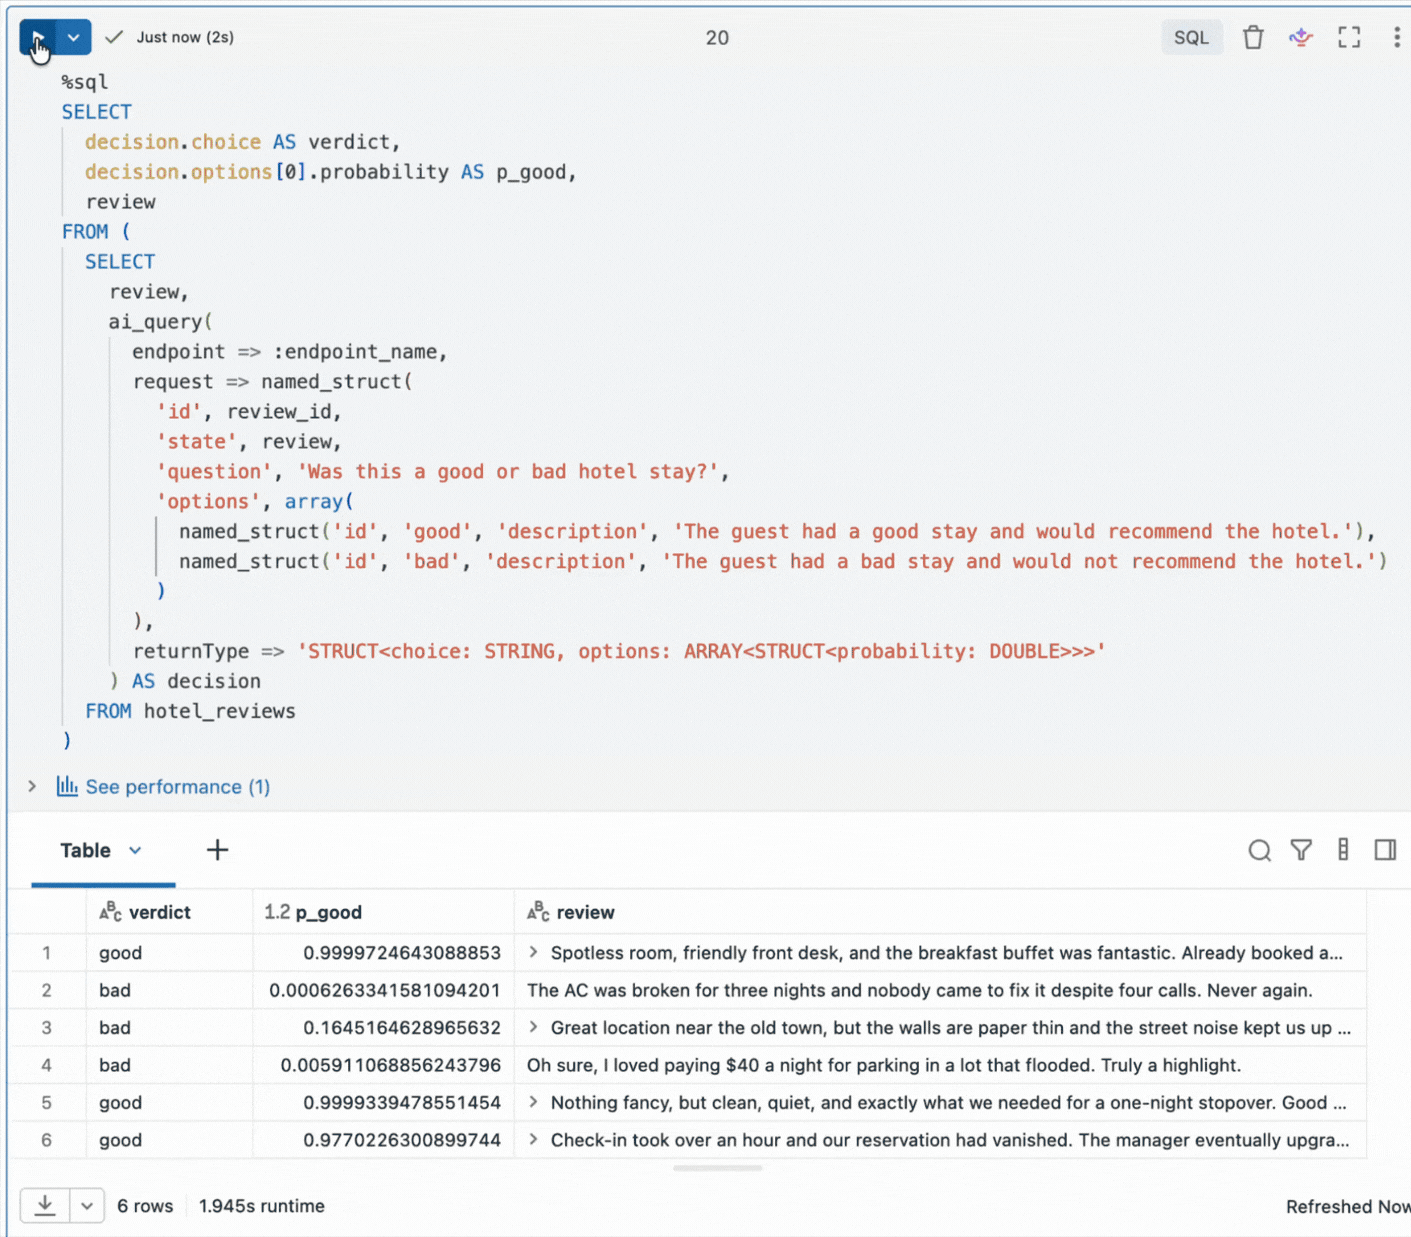
决策模型能从固定选项里给出校准过的判断,Databricks 让它们直接跑在受治理的数据上,一条 SQL 就能调用。
Databricks 演示了如何在 SQL 里直接调用开源决策模型(一类从固定选项中输出经过校准判断的基础模型):用 AI Runtime 提供免运维的 serverless GPU 部署与托管端点,再通过 aiquery 把酒店评论分成好评或差评。整个流程打包成可导入的 Notebook,模型返回的是结构化列,不只是聊天式文本。
正文摘录
使用 serverless GPU 与 aiquery,把结构化决策直接作用于受治理的数据。 作者:Cyrus Cowley、Tejas Sundaresan、Hanlin Tang、Anshul Gupta 和 Julia Powell 就在这个周末,诸如 Jev 这类 "System One" 决策模型相继发布。它们属于一类正在快速壮大的基础模型:能够从一组离散选项中给出校准良好(well-calibrated,即输出的概率与真实正确率相匹配)的决策。这类模型通常极快、也极便宜,因此可以在大规模数据上承载很广泛的应用。潜在用例从分析客服对话记录,到在你的数据上大规模地执行复杂决策,不一而足。 开源社区也没闲着,陆续发布了这些决策模型的开源权重版本,从 Smelf-open-jev,到 Laya,再到 Kev。但这类模型的威力只有在能触达海量数据时才会真正释放。今天,我们很高兴分享:如何在 Databricks 上部署开源权重决策模型,并让它们直接运行在你的受治理数据上。你甚至可以通过 aiquery,直接从 SQL 控制台或 Lakeflow 中的生产作业访问这些模型。此外,像 AI Runtime 这样的产品还能让你对这些模型做定制或后训练(post-train),使其贴合你所在企业的具体语境。 在这篇文章中,我们将演示如何直接在 Databricks 中使用这样一个模型 —— SemIf-OpenJev —— 把酒店评论分类为好评或差评。 我们已把整个工作流打包成一个可直接导入的 Databricks Notebook。 该 notebook 使用 Databricks AI Runtime 来提供 serverless、按需的 GPU 算力,你无需自行搭建或管理 GPU 基础设施。