UC Berkeley等提出DADP,实现机器人策略零样本跨域控制
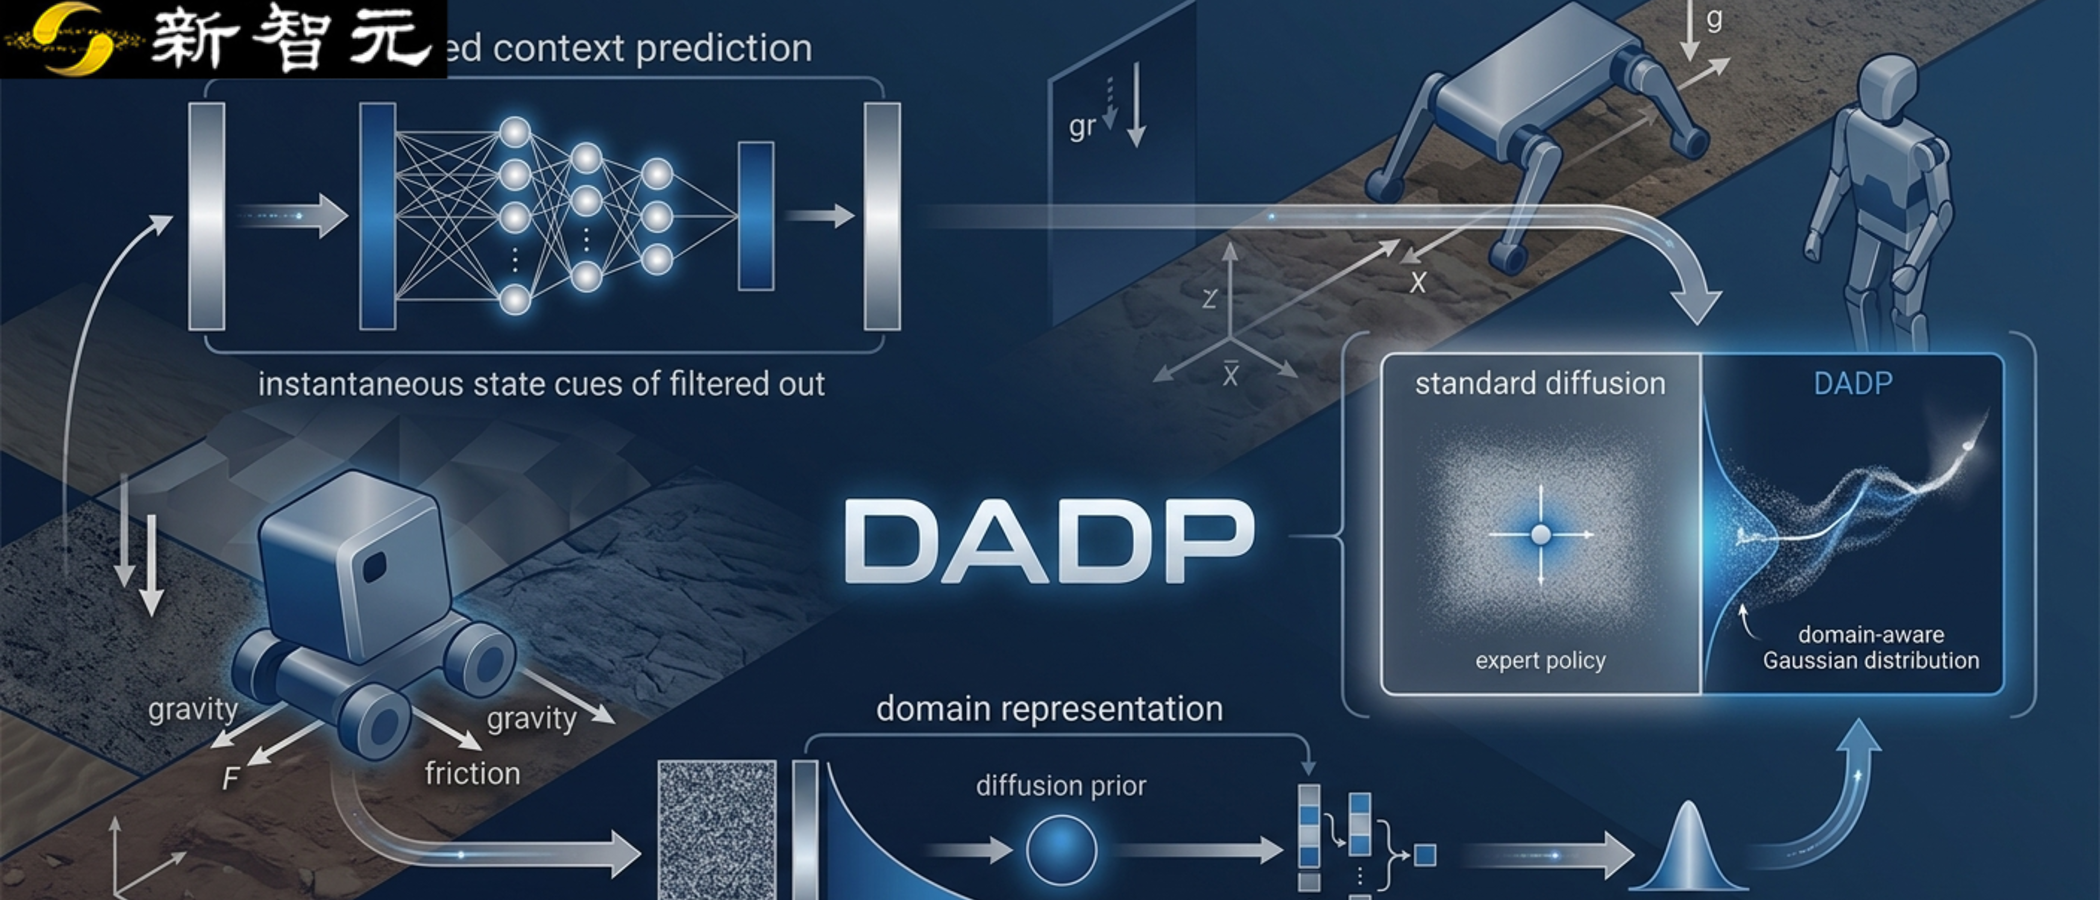
DADP通过域感知扩散注入让机器人策略在不同动力学环境下零样本泛化。
机器人策略在换地面或改身体参数后常失效。DADP先学静态域表征(通过拉远上下文过滤瞬时信息),再让扩散去噪过程从带域偏置的混合高斯开始,实现零样本跨域控制。在MuJoCo和Adroit任务上表现领先。
正文摘录
 新智元报道  扩散策略正在成为机器人控制中的热门路线。它可以把动作生成看成一个逐步去噪的过程,从噪声中一步步恢复出可执行的动作序列。 问题在于,真实机器人世界从来不是一个固定剧场:地面摩擦会变,身体参数会变,质量和阻尼会变,甚至同一个任务也会因为动力学不同而需要完全不同的动作模态。 UC Berkeley、北京大学、CMU、清华大学联合提出的 DADP(Domain-Adaptive Diffusion Policy)不是为每个动力学条件单独训练一个策略,而是训练一个能够感知当前域、并在生成动作时主动利用这个域信息的统一策略。  论文链接: https://arxiv.org/abs/2602.04037 实验结果显示,DADP 在 MuJoCo 和 Adroit 的零样本跨域控制任务中取得强表现,OOD 场景优势尤其明显。  图1:论文中给出的跨域 MuJoCo 总览结果,DADP 在 Seen、Unseen、OOD 三类设置上整体表现最强。