清华 AIR 与伯克利提出连续时间具身世界模型 ODEWorld
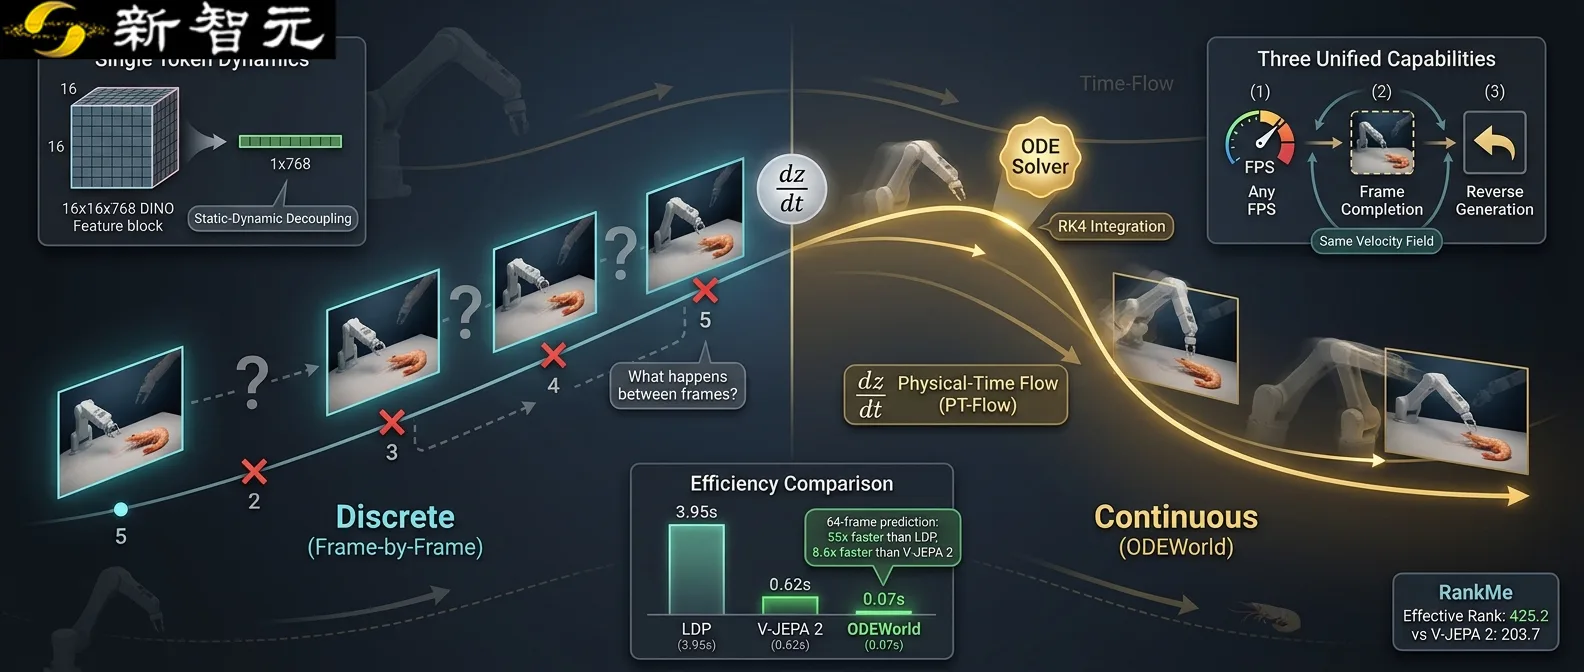
ODEWorld 用常微分方程建模机器人世界状态,将离散帧预测统一为连续时间轨迹,提升高频控制与动作合成能力。
清华大学智能产业研究院与 UC Berkeley BAIR 提出 ODEWorld,全球首个连续时间具身世界模型。它不依赖离散帧,而是学习状态随时间连续变化的轨迹,让机器人能在任意时刻查询状态,解决夹取发生在两帧之间的动作难题。
正文摘录
 新智元报道  让机器人把一只虾夹起来,再放进锅里。 真正困难的,可能不是认出虾,也不是找到锅,而是把握夹爪闭合的那个瞬间:早一点,夹爪会落空;晚一点,虾可能已经被推走。夹住之后,机械臂还要连续调整力度、方向和速度。整个过程没有暂停键,也不会等摄像头拍完「下一帧」再继续。 但许多视觉世界模型认识时间的方式,恰恰来自这些被摄像头截取的画面。它们看到第1帧、第2帧、第3帧,并学习如何从一张图跳到下一张图。至于两帧之间发生了什么、换一种帧率后该如何预测,甚至某个关键瞬间缺失后如何还原,模型通常没有一条可以直接查询的连续轨迹。 问题也由此变得具体: 如果机器人对世界的理解只存在于一格格画面里,它要怎样抓住发生在两帧之间的那一瞬间? 来自清华大学智能产业研究院(AIR)与 UC Berkeley BAIR 的研究团队提出了 ODEWorld——全球首个连续时间具身世界模型。它不再只问「下一帧是什么」,而是直接学习世界在每个时刻朝什么方向、以多快的速度变化,并由此还原一条随真实物理时间连续演化的潜空间轨迹。  论文链接:https://arxiv.org/abs/2607.27924 项目主页:https://dstate.github.io/odeworldwebsite/ 这项工作的关键,并不是单独增加了一项「补帧」功能。