星尘智能发布 SmoothRL,解决异步推理下的机器人在线强化学习难题
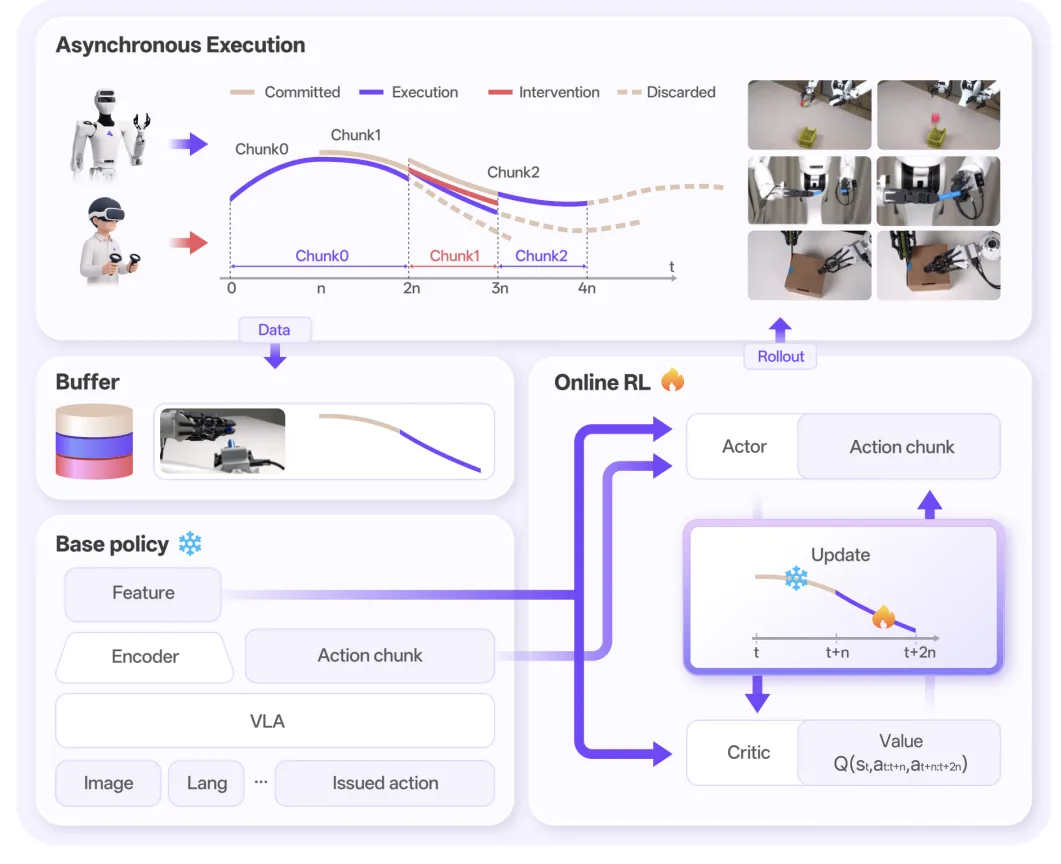
机器人异步推理成为常态后,在线强化学习需要对账。SmoothRL 只从真实执行的动作中学习,让机器人在部署中持续变准。
真实机器人不能停下来等模型。星尘智能推出 SmoothRL,一套适配异步推理的在线强化学习框架。它把模型生成的动作段按执行状态分成已提交、执行和丢弃三部分,只对机器人真正执行的部分做学习,避免“没做过却记功或背锅”。在真实投掷、开箱和给笔戴帽任务中,成功率分别从 39% 提到 94%、30% 提到 90%、8% 提到 83%。
正文摘录
机器人没有“暂停键”。 当前的 VLA、World-Action Model 往往一次生成未来一段时间的动作序列,也就是 action chunk。模型越来越大,推理时间越来越长,但机器人不能每隔几百毫秒就停下来等模型推理下一段动作。尤其在投掷这类高动态任务里,一次停顿就可能让已经积累的速度掉下去,导致整个任务失败。 真实部署里更常见的方式是 异步推理 :机器人继续执行手头的动作,模型在后台同时计算下一段。简单说, 手上做 A,模型已经在算 B。 但这给在线强化学习带来一个新问题:模型一次生成一段动作序列(action chunk),真正被物理世界使用的往往只有其中一部分。模型“计划过”的动作,和机器人“真正做过”的动作,不再完全相同。 近日,星尘智能(Astribot) 基座模型团队发布能异步执行的在线强化学习框架 SmoothRL(Online Reinforcement Learning During Asynchronous Execution) ,解决的是 大模型异步推理成为真实部署常态后,与之适配的 online RL 到底该从哪些动作里学习。 SmoothRL 首次将这类异步 online RL 放到真实高动态投掷任务中验证,进一步证明在线学习不仅能用于高精度修正,也能适配连续加速、精确释放、不能停顿的动态操作。  异步执行之后,RL 为什么会“对错账”? 传统在线 RL 默认一种更规整的节奏:模型先算出动作,机器人执行,再根据结果更新策略。模型生成什么,机器人就执行什么。