Anthropic 发布官方指南:优化 Claude Code 的 token 开销
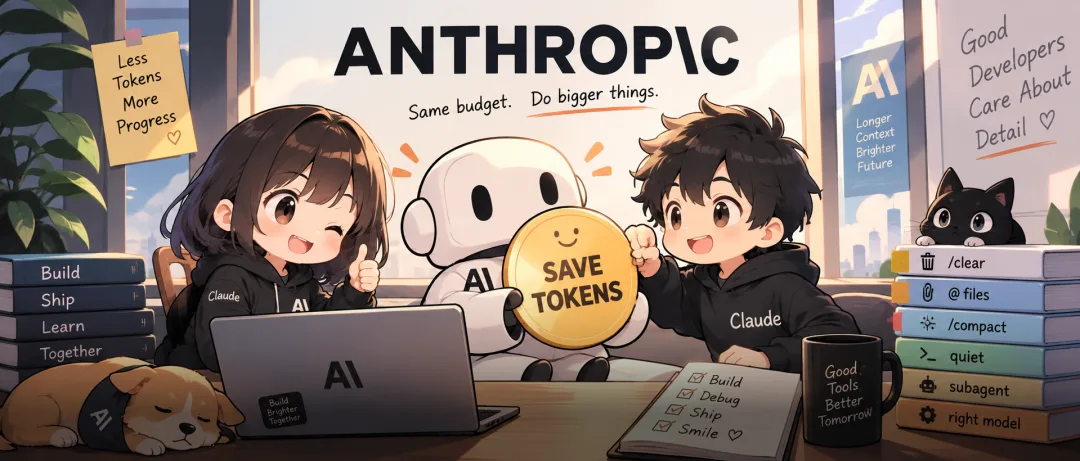
Anthropic 官方手把手教开发者省 token 钱,核心是管好上下文、用好缓存。
Anthropic 官方发教程,教开发者在 Claude Code 上省钱:任务完成就用 /clear 清理会话,开头锁定模型和推理强度(控制思考量),用 @ 引用文件,压缩对话等。关键是大模型按 token 计费,输出比输入贵 5 倍,而提示缓存(重复内容享 0.1 倍价格)可省下大量成本。
正文摘录
 新智元报道  就在刚刚,Anthropic发了一篇博客。 核心信息就是: 各位,别再烧冤枉token了,我们都看不下去了!  为此,官方详细列举了六条省钱心法,先贴为敬: 1. 任务做完就/clear。 修完一个bug就清掉当前对话,别让上一个任务读过的文件和命令输出拖进下一个任务里,白白占着上下文。 2. 开局就定好模型和推理强度(effort level)。 中途切换的话,之前积累的提示缓存会全部失效,整段对话历史要按全价重新计算一遍。 3. 用@引用文件,别手打路径。 用@直接把文件附到消息里,Claude不用再花一次工具调用去读。如果你只打文件名,Claude可能先搜一圈再打开好几个文件试探,这些操作全部会进入对话历史,之后每一轮都带着。 4. 给输出多的命令加静默参数(quiet flag)。 在CLAUDE.md里写一句类似–reporter=dot的配置,让测试输出只打印几行摘要,不是几百行详情。输出越短,占的上下文越少。 5. /compact在休息前做。 对话还在缓存里的时候压缩,成本只有正常的十分之一。等你回来缓存过期了再压,就得按全价重新读一遍再压缩。 6. 大输出任务扔给子Agent。