JarvisHub发布:面向长程多模态创作的开放式Agent工作台
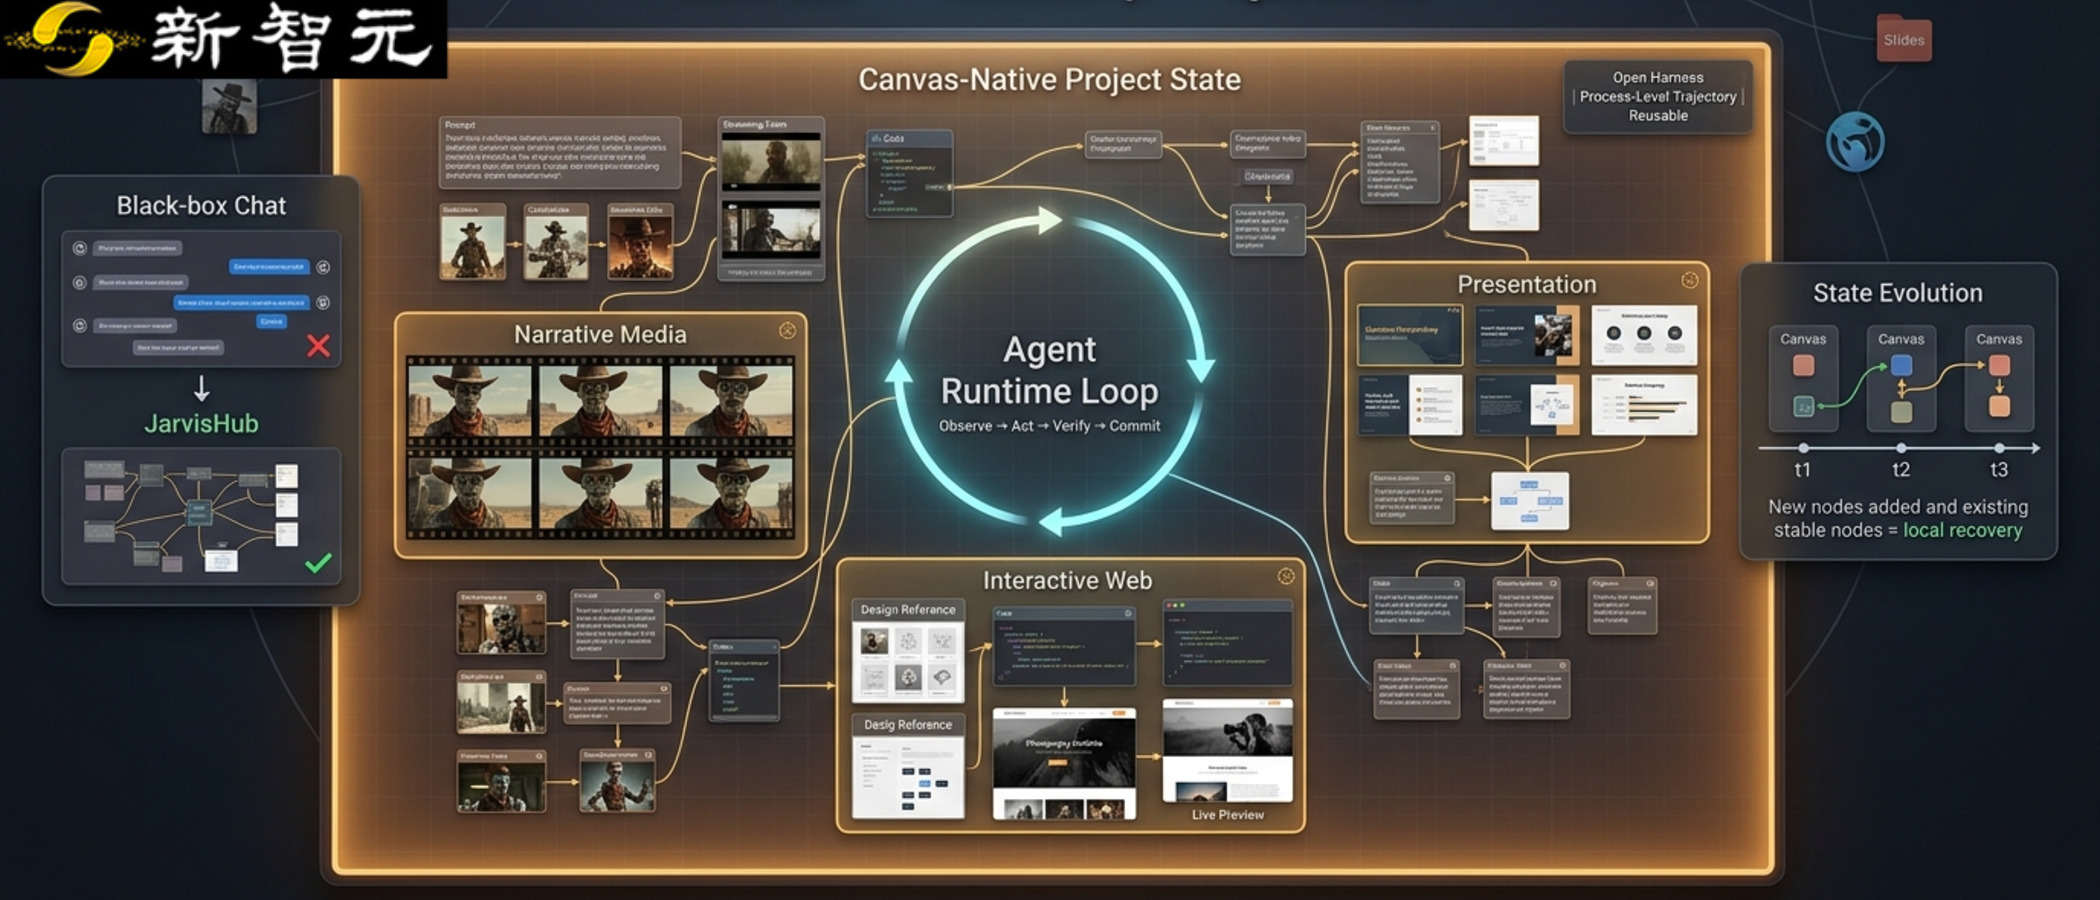
JarvisHub是一种让AI Agent在共享画布上持久协作完成复杂多媒体项目的系统,解决了多模态创作碎片化问题。
现有AI工具只能生成单个素材,无法在多轮创作中维持项目状态。JarvisHub通过Canvas-Native设计(以画布为核心的项目状态表示),让Agent在共享画布上持续读写、检查与修改,支持图片、视频、网页、PPT等多模态交付物的长程协作。
正文摘录
 新智元报道  近几年,多模态生成模型进步很快。一句指令就能生成图片、视频、音频、网页、UI、分镜,甚至整套演示文稿。只看成品,创作门槛似乎已经大幅降低。 真正的创作却很少是「一句话换一个结果」。一支短片要经历故事梗概、角色设定、镜头规划、参考图、候选画面、视频片段、配音和音乐等环节;一个网站离不开视觉参考、页面结构、交互逻辑、代码实现、预览检查和多轮修改;一套 PPT 也要兼顾内容筛选、叙事组织、版式设计、图示生成与跨页风格统一。 这些中间材料不是可以随手丢弃的副产品。它们共同构成持续变化的项目状态:哪些素材已经采用,哪些版本被否决,某张图来自哪组参考,某个镜头是否完成,以及用户刚提出的反馈会影响哪个局部。Agent 要继续推进项目,就必须读懂并维护这套状态。 现有系统的三点局限 1、Prompt-to-Output 工具: 擅长快速产出单个素材,但中间尝试、失败版本和依赖关系往往被隐藏或丢弃。到了下一轮,创作者常常只能重新交代上下文。 2、聊天式 Agent: 能够连续对话和调用工具,但主要上下文仍是一条线性的聊天记录。素材一多,空间布局、版本分支和引用关系便很难在对话中说清楚。 3、节点式工作流: 执行步骤清晰可见,却通常需要人工预先搭建固定流程。节点描述的是「怎样运行」,未必能承载一个供 Agent 持续读取、修改和扩展的创作项目。