智在无界发布Being-H0.8,加入触觉的隐式世界动作模型
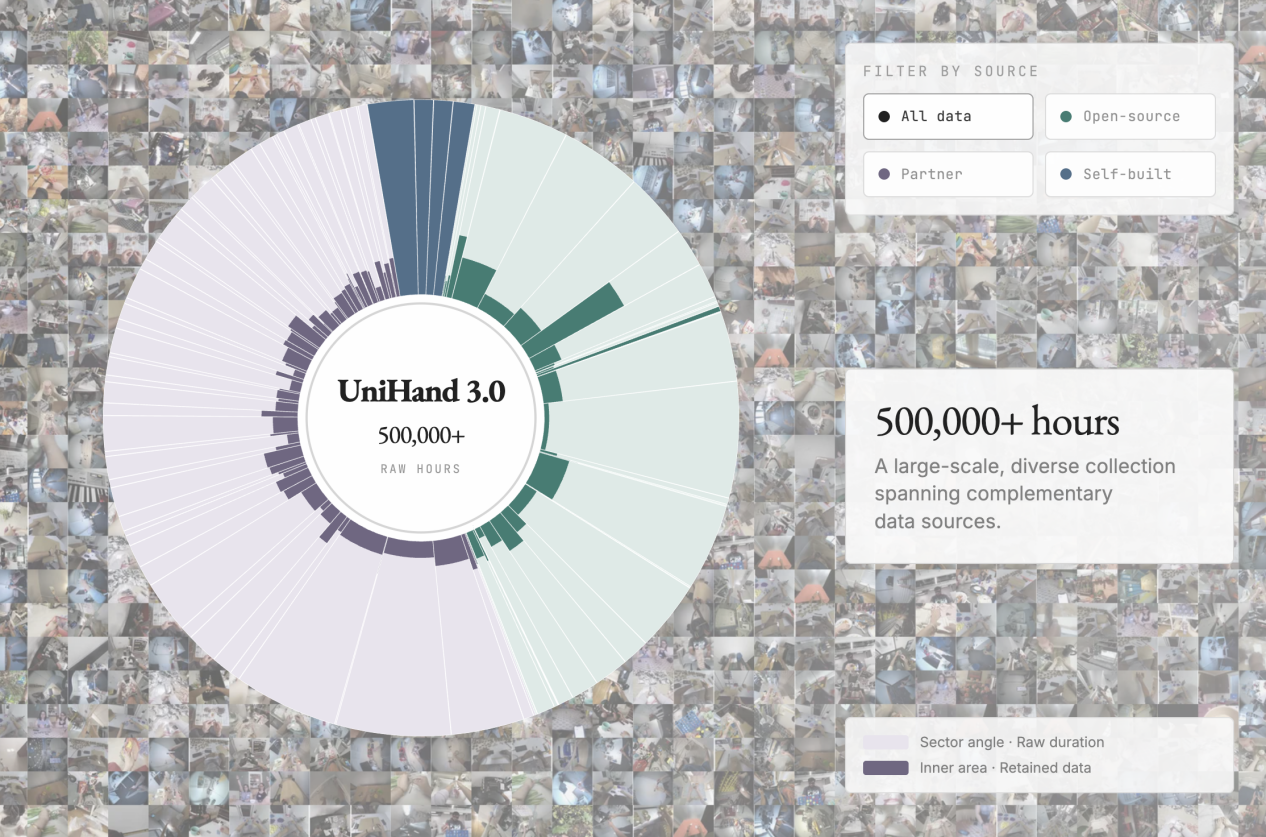
全球首个隐式触觉世界动作模型,用50万小时视频训练,让机器人理解接触与变化。
模型首次将触觉融入预训练,用超50万小时人类视频训练,让机器人不仅看到、碰到,还能预测交互后世界的变化,并通过自研TactoHand系统低成本为海量视频添加触觉标签。
正文摘录
汇聚超 50 万小时人类视频,构建国内最大具身基础模型预训练数据集 7月28日,通用具身基础模型公司智在无界 BeingBeyond 正式发布 Being-H0.8—— 全球首个隐式触觉世界动作模型。 Being-H0.8 首次将触觉模态引入大规模模型预训练,并将视觉、触觉、动作以及未来状态变化统一到同一隐空间(latent space) 。这使机器人不仅能够理解“看到了什么、做了什么、接触到了什么”,还能够进一步理解“世界因此发生了怎样的变化”,从而形成对物理交互过程更加完整的认知与预测能力。 智在无界是业内 率先提出以大规模人类视频数据来训练通用具身基础模型框架的团 队。历经 Being-H0 到 Being-H0.8 的持续迭代,智在无界已汇聚了 超过 500,000 小时的第一人称视频原始数据,并与数十家数据合作伙伴建立合作。 但数据规模只是起点。真正决定模型能力的,是数据能否准确、有效地描述动作、接触与交互。 围绕这一目标,智在无界已完成从 数据管线、模型预训练、后训练、评测到端侧部署的全栈基础设施建设。 这套体系能够推动规模化数据持续沉淀、模型能力持续进化,并让机器人不断走向开放、复杂的真实物理世界。 在此基础上,智在无界打造了高质量人类交互数据库 UniHand 3.0。该数据库覆盖自然物体交互、长时程任务、丰富手部动作及多样化场景,为具身基础模型提供规模化、高质量的人类交互经验。  UniHand 3.0 不仅是目前国内规模最大的人类视频数据集,也标志着全球范围内首次有团队针对如此大规模的人类视频数据应用,系统分享数据来源等关键信息,为人类视频数据在具身智能领域的规模化使用提供了更具参考价值的实践路径。