国产超算灵晟纯CPU运行DeepSeek 671B模型,吞吐接近80卡GPU集群
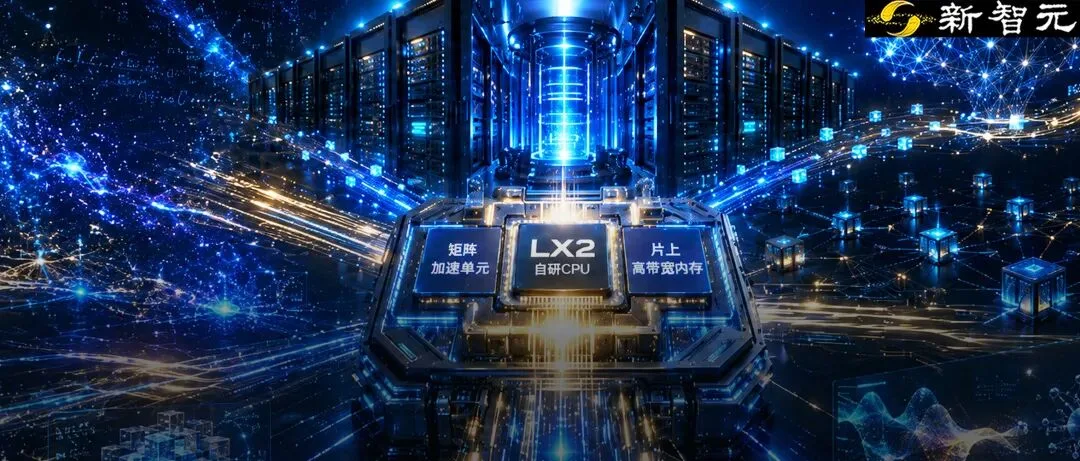
国产超算用纯CPU跑出接近GPU集群的推理吞吐,说明软硬协同能让算力基础设施变身AI产能。
清程极智与国产超算“灵晟”合作,用16个节点纯CPU运行DeepSeek-V3/R1-671B模型,在2048批处理大小时输出吞吐与80张主流GPU集群相当。关键在于灵晟的LX2 CPU集成高带宽片上内存和低时延网络,配合清程极智的算子优化、混合并行及多Token预测技术,实现软硬协同加速。这标志着国产超算正从科学计算扩展为高效的大模型Token生产基础设施。
正文摘录
 新智元报道  在 “灵晟” 国产超算登顶最新一期全球超级计算机 TOP500 榜单后,清程极智与 “灵晟” 联合完成纯 CPU MoE 模型分布式推理方案: 16 节点即可流畅运行 DeepSeek-V3/R1-671B 模型,在 batchsize=2048 时,输出吞吐量与 80 张主流 GPU 集群相当。 这不仅是一次 HPC 与 AI 融合的技术突破,也提供了一个观察国产算力如何从基础设施转化为 Token 生产能力的新样本:当算力、模型与推理软件被系统级协同优化,超算不再只服务于传统科学计算,也可以成为持续生产大模型 Token 的 “工厂”。   架构革新: “灵晟” 筑就 AI 大模型推理新基石 为何要在超算上跑 AI?产业需求揭示了两大核心动因: 一是 方法融合,科学计算物理模型与数据驱动的 AI 深度结合,催生颠覆性科研成果;二是 效能提升,超算平台通过错峰运行 AI 任务,最大化利用算力资源。 以此为视角审视 “灵晟”,其最大的亮点在于架构层面的原生超智融合。