AI21 提出 Agent 架构决策框架:先做可验证性判断
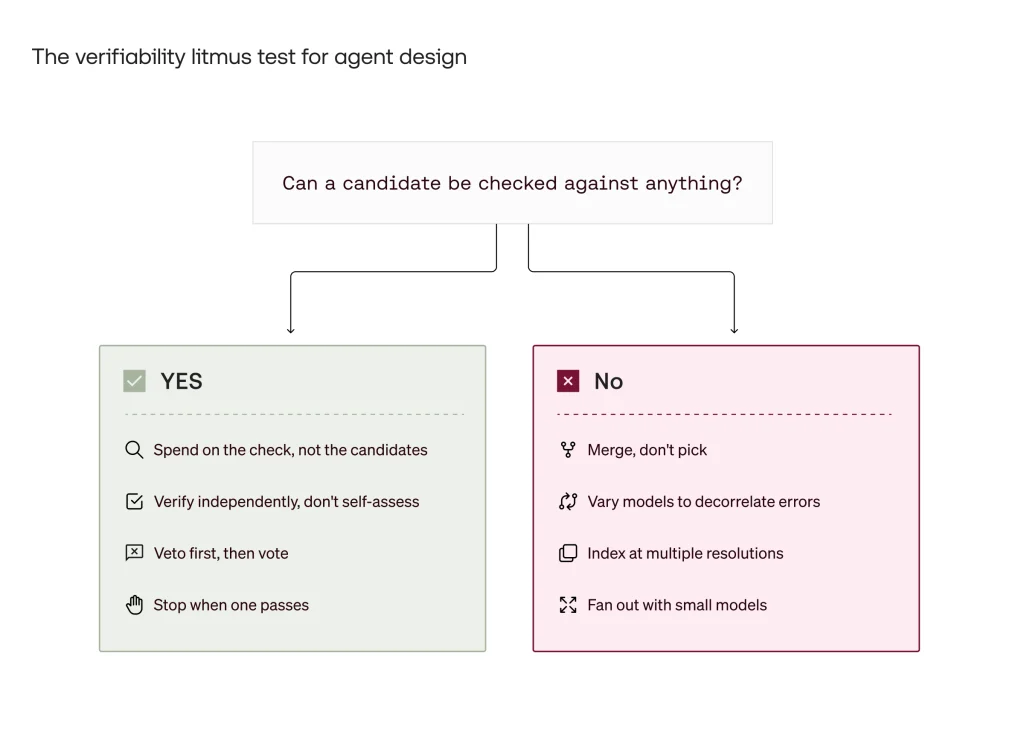
AI21 提出用任务是否可验证来判断 Agent 该优化哪里:可验证就做验证筛选,不可验证就靠多样性聚合,别急着堆算力。
在给 Agent 追加算力之前,先问一句:它能不能验证自己的结果对不对?有些任务天然可验证——任务本身给出了检查候选答案的条件;有些则不然。AI21 认为,这个属性决定了预算该投向哪里:可验证时投入验证与筛选,不可验证时投入多样性与聚合。
正文摘录
In Brief 在给你的智能体投入更多算力之前,先问这个问题:你的智能体能够验证自己的结果吗(也就是说,它能识别出自己何时得到了正确答案吗)?对某些任务而言,可验证性非常直接;任务本身就会给出条件,让你用来检查候选答案并做出停止决策。对另一些任务,则不那么清晰。在这篇文章里,我们会讨论为什么这单一属性 —— 可验证性 —— 应当决定你接下来把预算投在哪里:当完成结果可被检查时,投在验证上;当不可被检查时,投在多样性与聚合上。 反对优先扩展算力的理由 就如何改进一个智能体去调研大多数工程师,多数人会回答:扩展它。更多尝试、更长更强的上下文、更强的模型。这假设当前架构已经正确 —— 只是动力不足。大多数时候,扩展有效。但这是昂贵的方式。 在超过一年的智能体优化研究中,我们一次又一次地看到为什么这个假设(架构正确、动力不足)是错的。破绽在于发现架构中的低效:对可变的任务施加统一的预算,生成信号和 rollout 却又把它们丢弃,本该用一个开源模型就能做好的地方却跑了一个前沿模型。每一个这样的时刻都表明:在扩展之前,还有进一步优化智能体架构的空间。 有一个简单的试金石:一个候选答案能否被拿来对照某个东西检查? 这是任务的一个属性,它会给你的架构分叉。如果可以,就把钱投在验证和选择上。如果不可以,就把钱投在多样性和聚合上。 然后是第二个问题,关于你的 pipeline 而非任务本身:它是否已经在利用可得的那项检查?这个问题我们用一次 oracle 实验来回答。 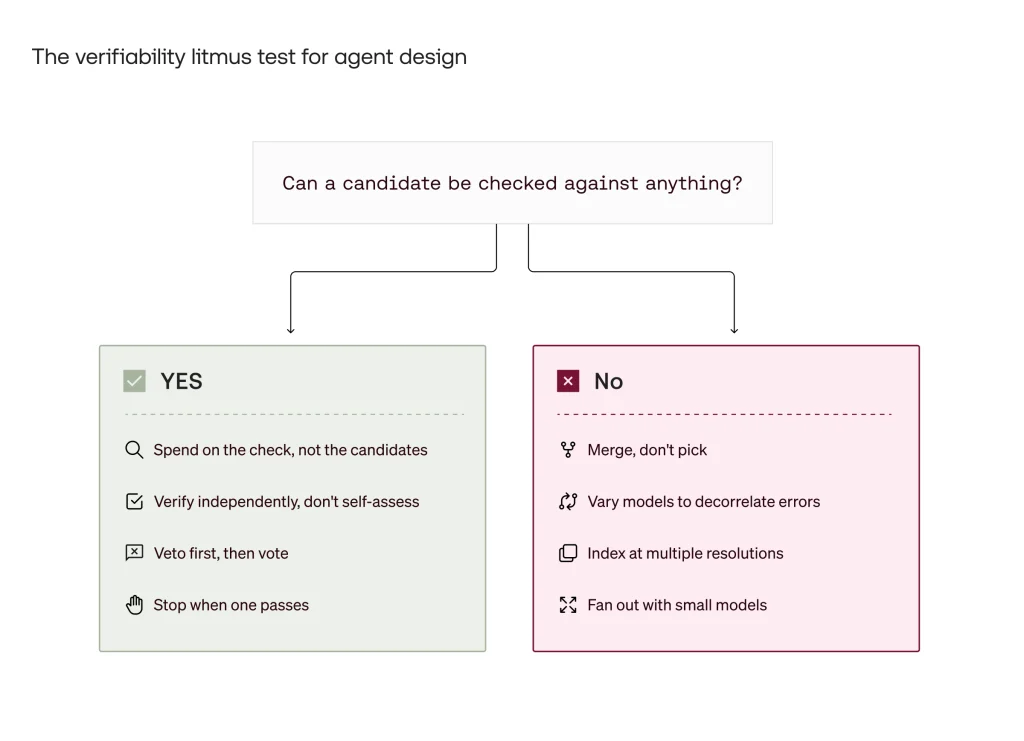 Figure 1. 智能体架构的决策框架。主导性问题是:候选答案能否被验证 —— 这是任务的属性,而非模型的属性。可验证的任务倾向于投资验证与选择;