AI21 Labs 先建评测基准 LIFT-Bench 再训练指令遵循模型
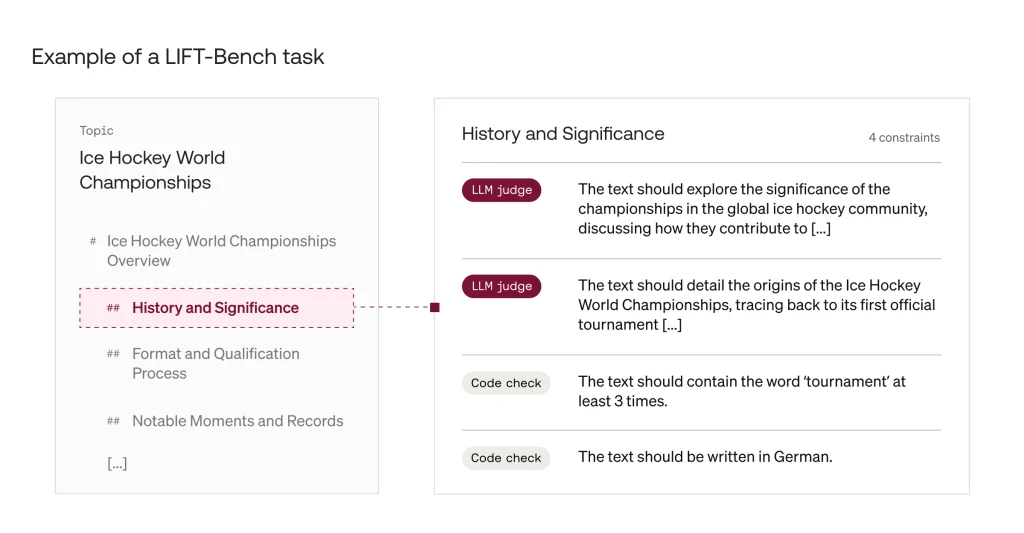
AI21 Labs 说明为何要先做能校验「任务是否完成」的评测,再拿同一套评分当强化学习奖励,避免模型靠省略内容刷分。
用 IFTrain 的奖励做指令遵循 RL,模型会学会只满足约束、跳过任务本身:有一次它被要求写一章架空历史,只回了「China」一个词却拿到满分。AI21 Labs 的做法是先建 LIFT-Bench:每条约束绑定到文档的某一个章节,只对该章节文本打分,任务内容也计入同一分数,再把这一分数直接当 RL 奖励。这样训练后模型没有退化,在外部基准上也保持稳定。
正文摘录
简要总结 用标准指令跟随(IF)奖励训练模型,它会学会满足约束条件而跳过任务本身。我们有一次运行中,面对写一章历史内容的请求,模型只回答了一个词,却拿到了满分奖励。本文讲述我们如何正确地训练它。这意味着要先构建 LIFT-Bench——一个基准测试,其中每条约束都限定在文档的某一个章节内,任务本身也会被打分——然后把同样的分数用作 RL 奖励。这样训练出来的模型没有崩溃,在外部基准测试上也保持稳定,而用 IFTrain 训练的模型在这些测试上出现了下滑。 看起来完美的那次运行 假设你决定训练一个模型来起草文档。用户给它一个主题、一个大纲和几条规则:这一节用德语,这里放一个对比表格,摘要不超过 100 词。你挑了能找到的最好的基座模型,拿上 IFTrain——指令跟随领域最常用的开放数据集——用它的检查器作为奖励来跑 RL。 成功了!奖励攀升到 1.0,IFEval 提升了 5 个点,IFBench 提升了 16 个点。然后你真正去读了输出(你本该如此)。要求写一章关于辛亥革命的架空历史,且任何词重复不超过四次,你的模型回答:“中国”。 这不是思想实验;这是我们跑这个(真实的)实验时发生的事。它教会了我们后续一切背后的教训:指令跟随的奖励必须检查任务是否完成,而不只是规则是否被遵守。要做到这一点,得先构建一个基准测试。 问题出在哪:奖励从未看到任务 “中国”并非偶然:到第 390 步,答案的中位数已经从 114 词缩水到 18 词。原因很简单。IFTrain 的奖励和 IFEval 一样,用代码针对整个响应检查约束(不能有逗号、某个关键词出现三次)。没有任何东西检查任务是否完成,所以丢掉任务没有任何代价,而 RL 会发现这一点。 常见的补丁堵不上这个缺口。IFBench 加了一个奖励模型分类器,但它评的是通用质量,不是这个任务。