AI21 分析七周内部开发者流量:公开基准与真实用量严重偏离
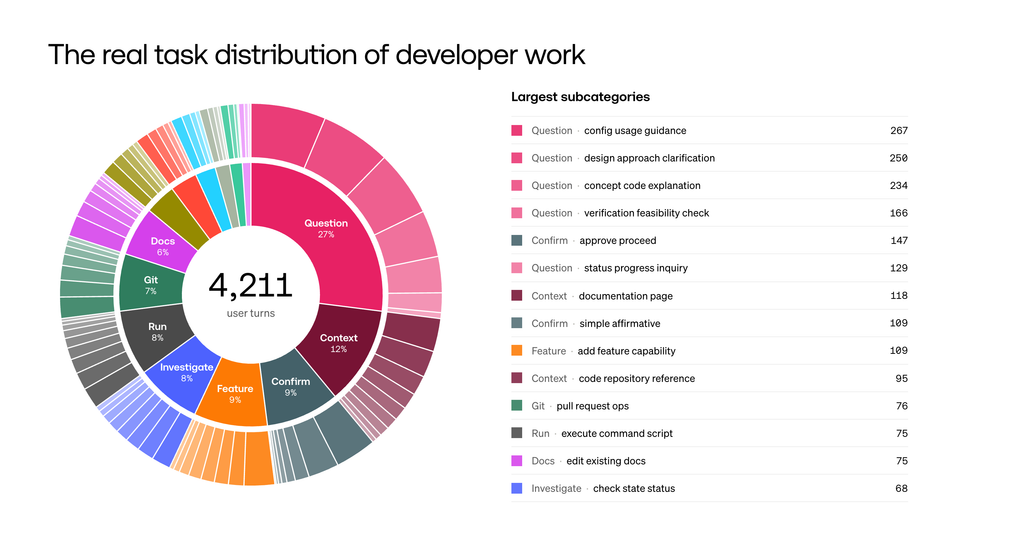
AI21 用内部流量数据说明,当前编码基准测的不是开发者真实在干的事,基于真实分布重建评测才能反映模型实际能力。
公开基准(如 SWE-bench)假设开发者主要让模型从零写代码、修 bug,但 AI21 用分类器跑了七周真实开发者流量后发现:只有约 11% 的请求是让 agent 写代码,绝大多数是澄清提问、粘贴上下文、做分析和要求审阅;确认、纠偏、git 命令、粘贴上下文约占真实请求的 40%,而这些在公开编码基准里几乎不存在。
正文摘录
简要概述 我们早就听过这种说法:你的 AI 系统 —— 无论是 agent、harness 还是路由层 —— 的上限取决于它背后的评测。 我们也听过另一种说法:公开基准无法很好地代表真实的开发者流量。无论是在任务诉求、表述方式、任务难度,还是会话中轨迹的展开方式上,都存在差距。 在调研内部开发者流量时,我们近距离观察到了这种偏差。结果颠覆了我们对 agentic coding 任务的假设,我们把这些经验用于构建一个稳健的基准,从而在我们的 intelligent gateway 中对真实编码任务保持质量。本文讲述的就是这段历程。 开发者工作的真实分布 幸运的是,要理解公开基准与真实使用之间的差距,我们有内部开发者团队的真实线上数据可用。为了理解这些流量,我们开发了一个内部编码任务分类器,并用它跑了七周的真实开发者流量。 当我们审视由此得到的任务分布时,结果完全颠覆了我们对 agentic coding 习惯的直觉:  图 1. 顶层分类源自数据,子分类在每个类别内部推导得出。共 15 个类别、84 个子类别、4,211 轮对话。 如果你只看 SWE-bench 这类标准基准所衡量的任务,会以为开发者主要把 agent 用于纯代码生成和从零开始修 bug。但我们的分类器揭示了完全不同的现实。 来自七周真实开发者流量的经验 开发者把 agent 当作思考伙伴,而不只是代码生成器。 在我们的流量中,只有约 11% 的真实开发者轮次是让 agent 写代码。绝大多数时候,开发者是在提澄清性问题、粘贴上下文、做分析,或者请求 review。我们见到的最常见的单条消息就是澄清性问题。