Hyper-Extract

智能知识提取CLI工具,利用LLM将非结构化文本转换为结构化的知识图谱、超图或时空图。支持一键提取、增量进化,内置80+领域模板(金融、法律、医疗等),可本地部署(vLLM)保障数据隐私。亮点在于多结构支持和零代码配置,比同类GraphRAG/LightRAG更灵活。
README
智能知识提取 CLI
一键将文档转化为结构化知识。




"Stop reading. Start understanding."
"告别文档焦虑,让信息一目了然"
Hyper-Extract 是一个由大语言模型(LLM)驱动的智能知识提取与演化框架。它极大简化了将高度非结构化的文本转化为持久、可预测、强类型的知识摘要(Knowledge Abstracts) 的过程。它能轻松地将信息提取到多种格式中——从简单的集合(Collections,如列表/集合) 和Pydantic 模型(Pydantic Models),到复杂的知识图谱(Knowledge Graphs)、超图(Hypergraphs),甚至时空图谱(Spatio-Temporal Graphs)。
✨ 核心特性
| 🔷 8 种知识结构 | 从简单列表到高级图谱、超图和时空图谱 |
| 🧠 10+ 提取引擎 | GraphRAG、LightRAG、Hyper-RAG、KG-Gen 等——开箱即用 |
| 📝 80+ YAML 模板 | 零代码提取,覆盖金融、法律、医疗、中医、工业和通用领域 |
| 🔄 增量演化 | 可随时输入新文档,扩展和精炼已有知识库 |
🎯 你能用它做什么?
📄 研究人员 —— 将论文转化为知识图谱输入一篇 20 页的学术论文,即可获得包含关键概念、作者和引文关系的交互式图谱。
he parse paper.pdf -t general/academic_graph -o ./paper_kb/
he show ./paper_kb/
自动从非结构化报告中识别公司、高管、财务指标及其关系。
he parse earnings.md -t finance/earnings_graph -o ./finance_kb/
he search ./finance_kb/ "What are the key risk factors?"
通过 vLLM 在本地运行 Qwen3.5-9B + bge-m3。数据不会离开您的机器。
from hyperextract import create_client
llm, emb = create_client(
    llm="vllm:Qwen3.5-9B@http://localhost:8000/v1",
    embedder="vllm:bge-m3@http://localhost:8001/v1",
    api_key="dummy",
)
🚀 支持的平台与模型
Hyper-Extract 依赖 LLM 的结构化输出能力(json_schema 或函数调用 Function Calling)。
| 平台 | 已验证模型 |
|---|---|
| OpenAI | gpt-4o、gpt-4o-mini、gpt-5 |
| 阿里云百炼 | qwen-plus、qwen-turbo、deepseek-r1 |
| 本地 vLLM | Qwen3.5-9B (GPTQ-Marlin) |
嵌入模型(语义搜索)可配合任何兼容 OpenAI 的端点:text-embedding-3-small、text-embedding-v4(百炼)、bge-m3(本地 vLLM)。
📖 完整指南:Provider 系统与本地模型支持
⚡ 30 秒快速开始
# 安装
uv tool install hyperextract

# 配置 API 密钥
he config init -k YOUR_OPENAI_API_KEY

# 从文档中提取知识
he parse examples/en/tesla.md -t general/biography_graph -o ./output/ -l en

# 查询
he search ./output/ "What are Tesla's major achievements?"

# 可视化
he show ./output/
uv pip install hyperextract
from hyperextract import Template

ka = Template.create("general/biography_graph")

with open("examples/en/tesla.md") as f:
    result = ka.parse(f.read())

result.show()
🔗 更多示例: examples/en
📈 为什么选择 Hyper-Extract?
| 特性 | GraphRAG | LightRAG | KG-Gen | ATOM | Hyper-Extract |
|---|---|---|---|---|---|
| 知识图谱 | ✅ | ✅ | ✅ | ✅ | ✅ |
| 时间图谱 | ✅ | ❌ | ❌ | ✅ | ✅ |
| 空间图谱 | ❌ | ❌ | ❌ | ❌ | ✅ |
| 超图 | ❌ | ❌ | ❌ | ❌ | ✅ |
| 领域模板 | ❌ | ❌ | ❌ | ❌ | ✅ |
| 交互式 CLI | ✅ | ❌ | ❌ | ❌ | ✅ |
| 多语言 | ✅ | ❌ | ❌ | ❌ | ✅ |
🧩 支持的知识结构
从简单到复杂——为您的数据选择合适结构:
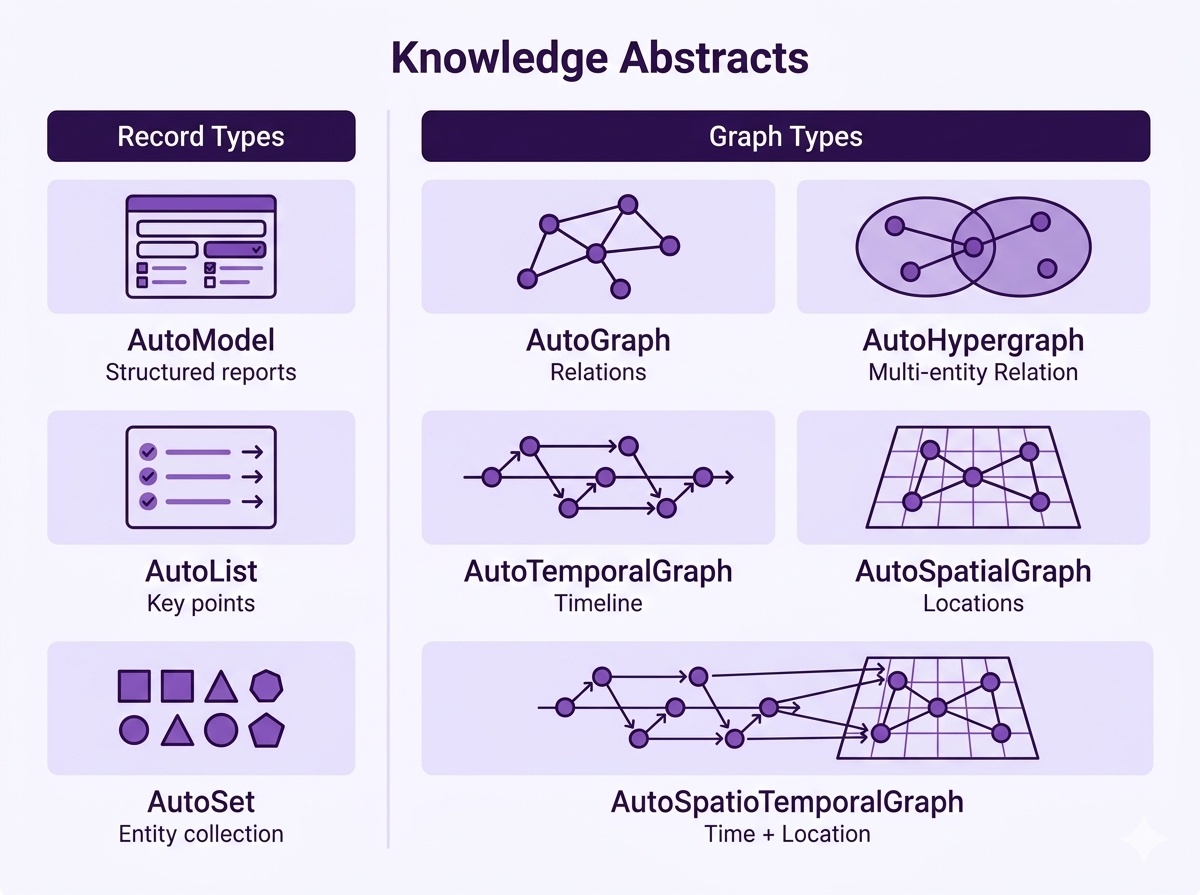
示例——自动图谱可视化:
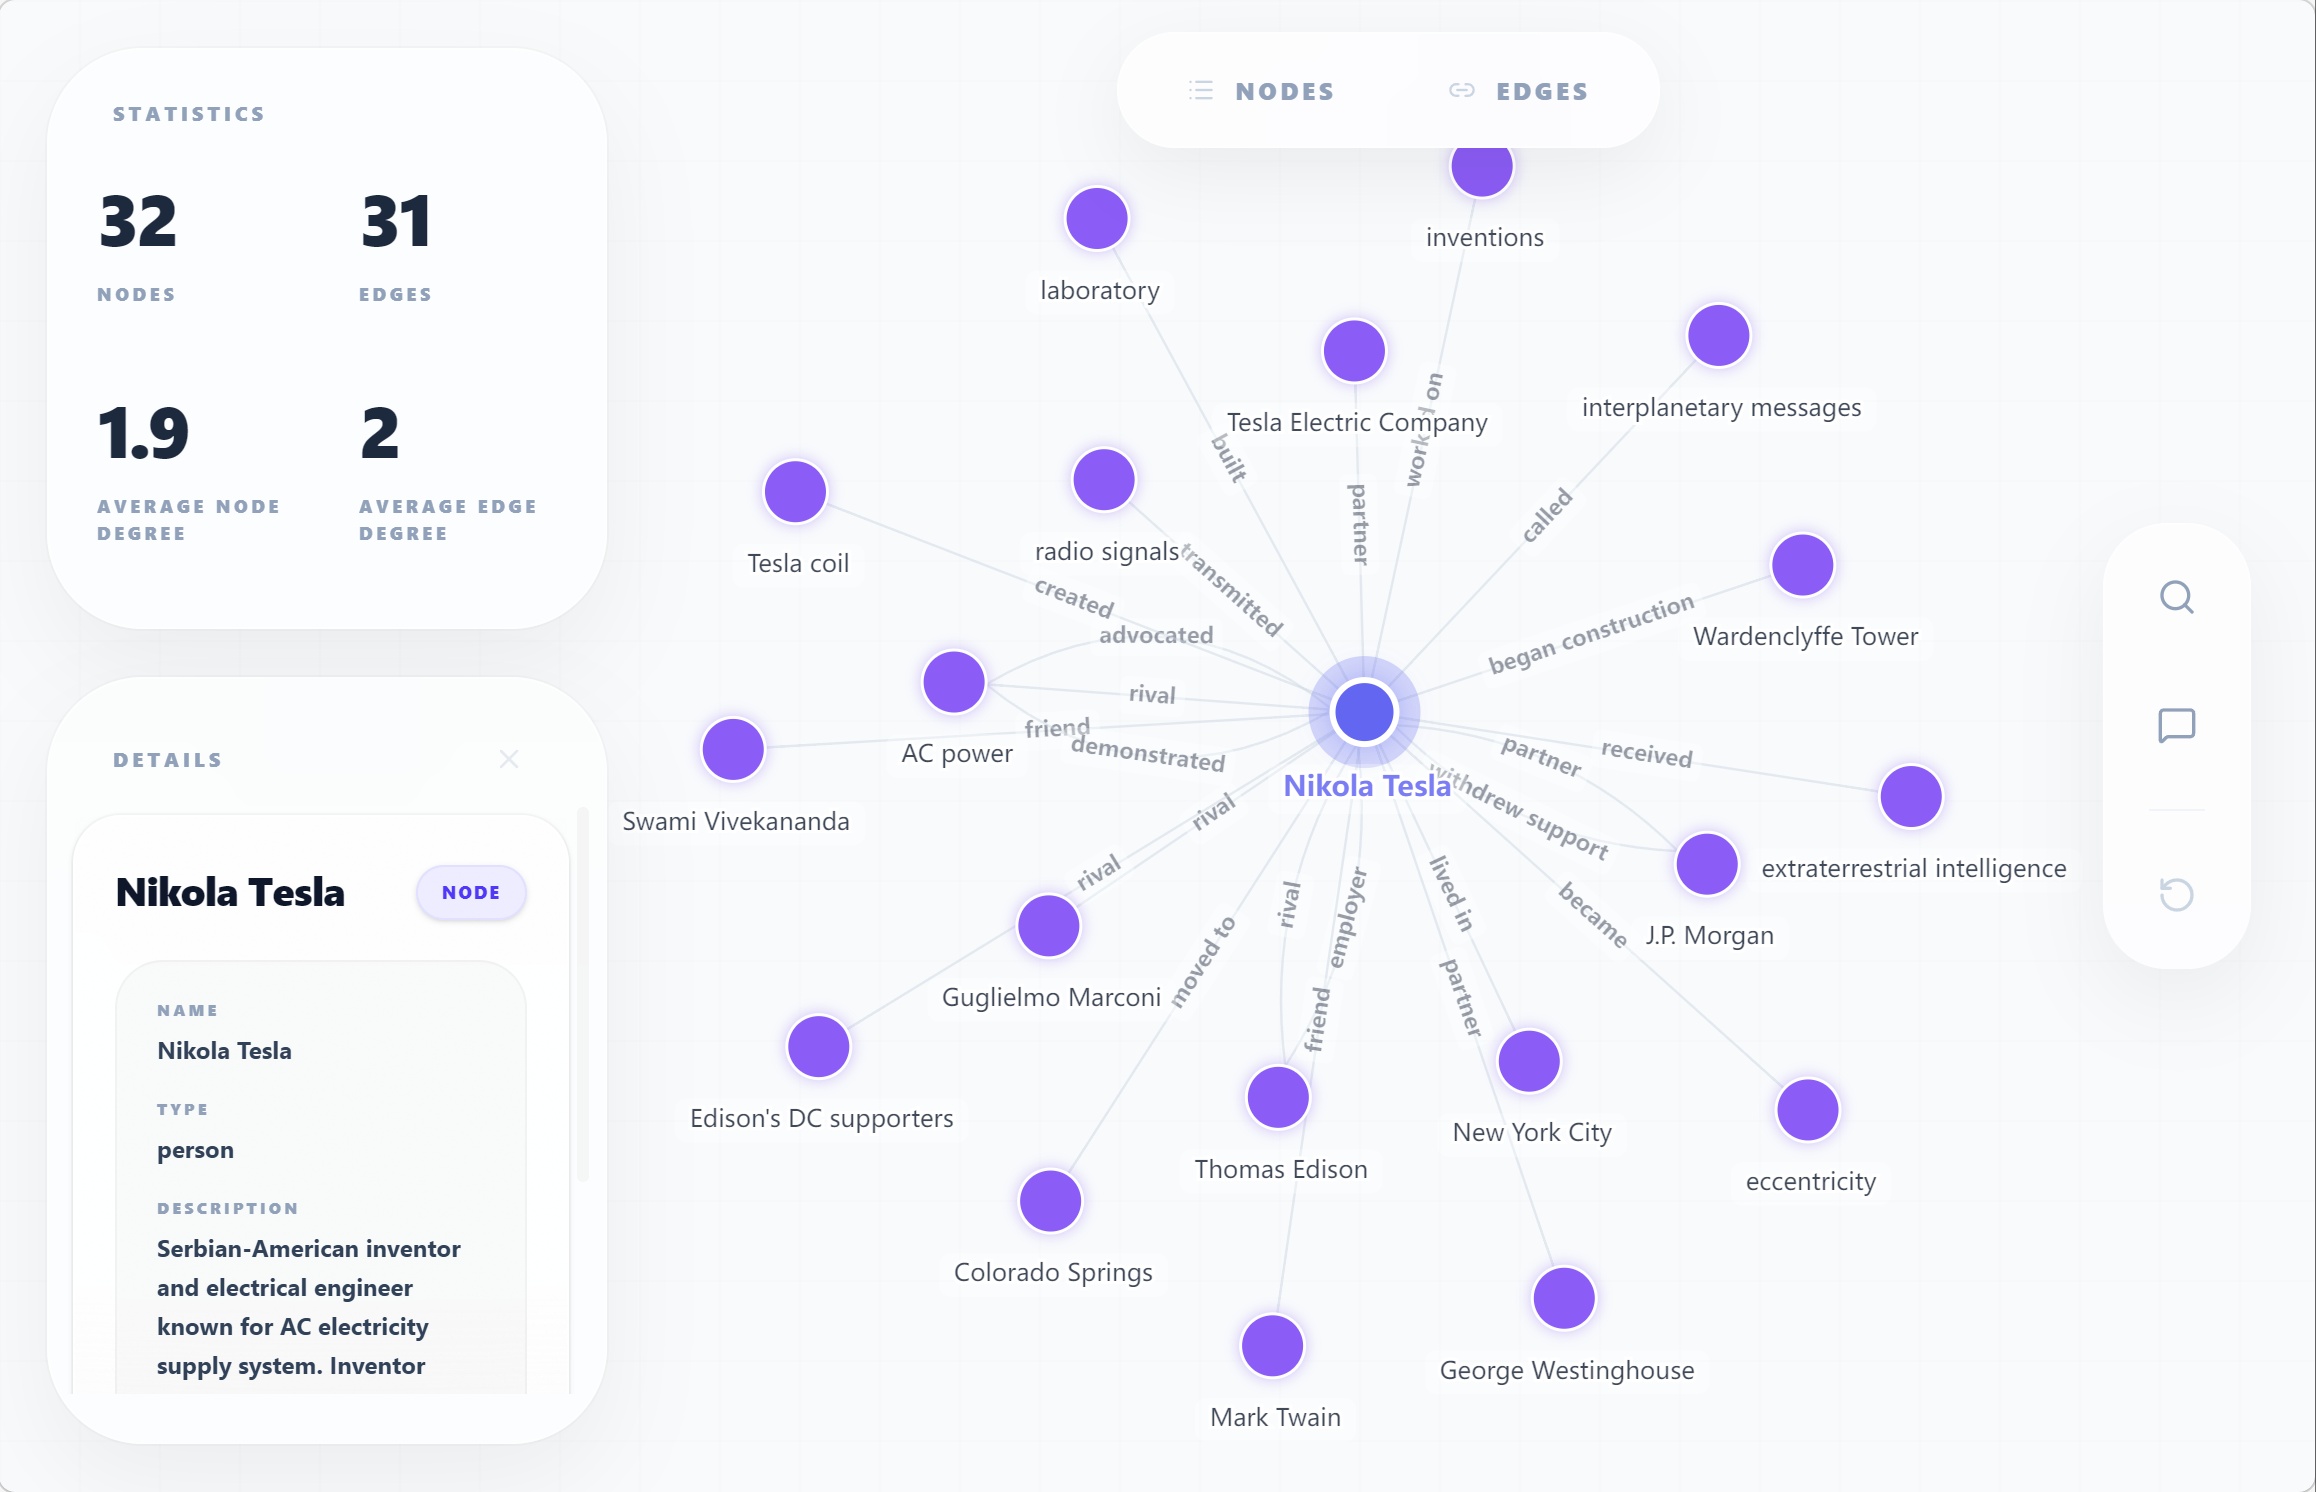 📋 架构与模板详解
Hyper-Extract 采用三层架构:
- 自动类型(Auto-Types)——8 种强类型数据结构(模型、列表、集合、图、超图、时间图、空间图、时空图)
- 方法(Methods)——提取算法:KG-Gen、GraphRAG、LightRAG、Hyper-RAG、Cog-RAG 等
- 模板(Templates)——覆盖 6 个领域的 80+ 预设,零代码配置。
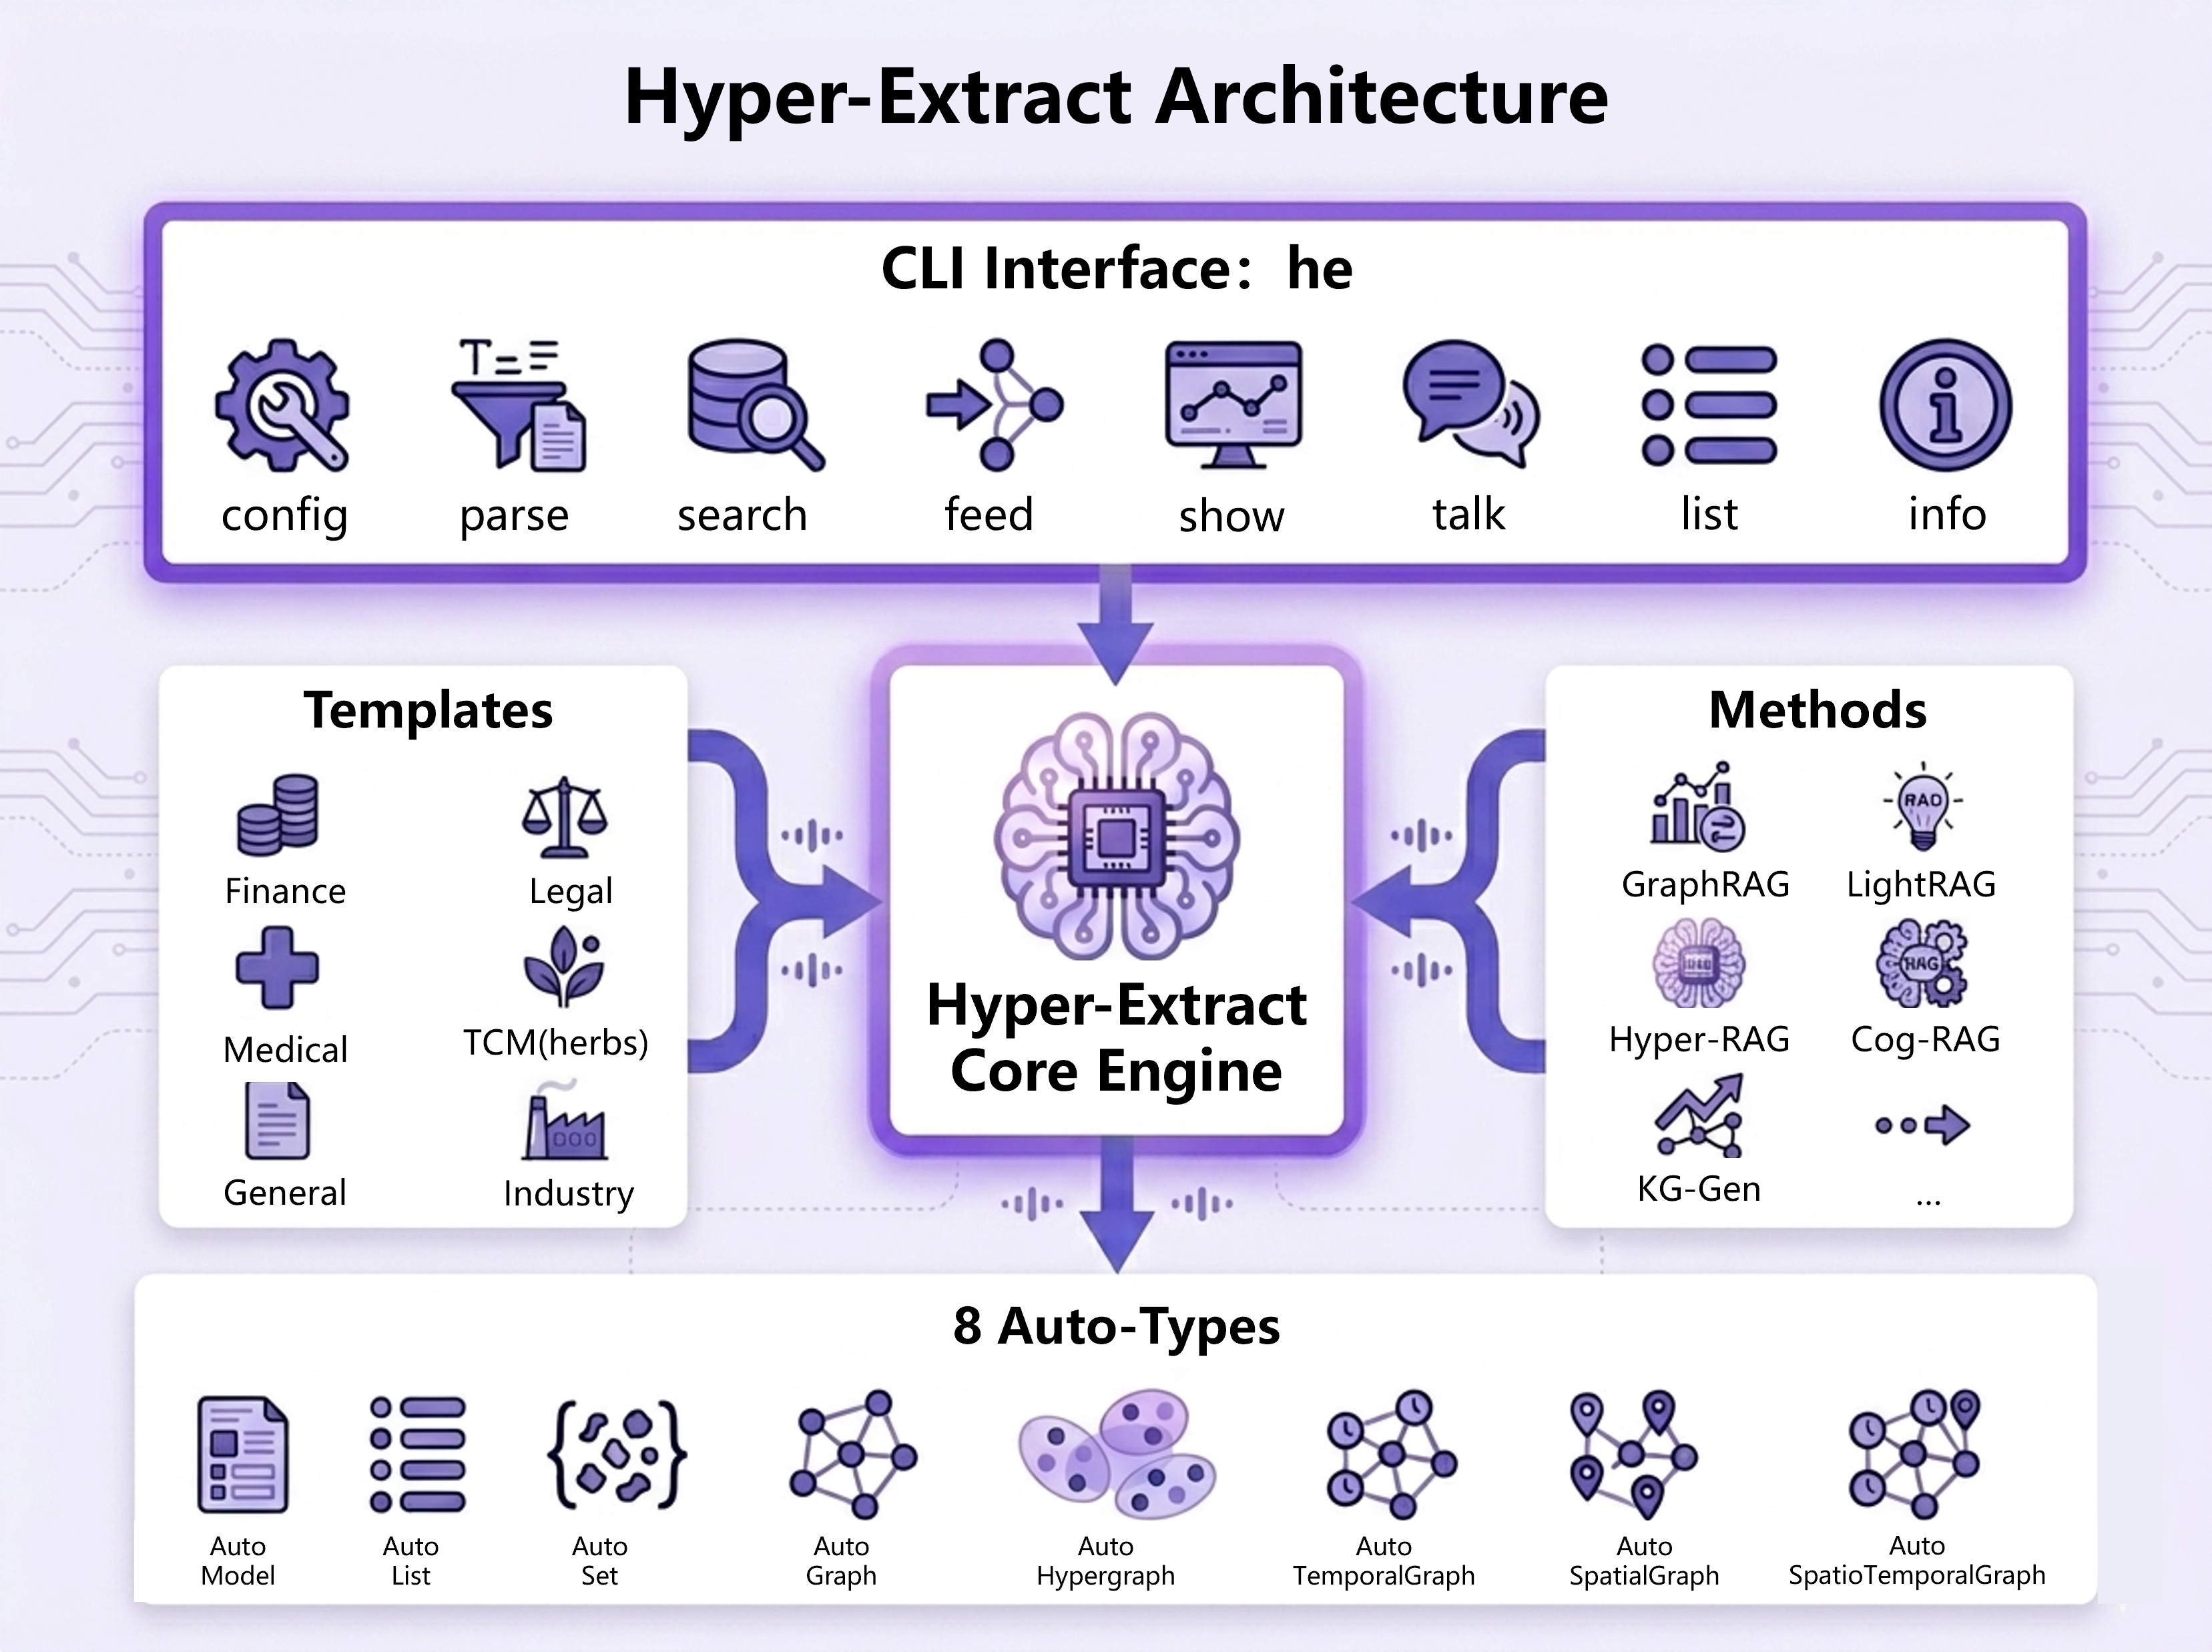
模板示例(图类型):
language: en
name: Knowledge Graph
type: graph
tags: [general]
description: 'Extract entities and their relationships.'
output:
  entities:
    fields:
    - name: name
      type: str
    - name: type
      type: str
    - name: description
      type: str
  relations:
    fields:
    - name: source
      type: str
    - name: target
      type: str
    - name: type
      type: str
identifiers:
  entity_id: name
  relation_id: '{source}|{type}|{target}'
📚 文档与资源
| 资源 | 链接 |
|---|---|
| 完整文档 | yifanfeng97.github.io/Hyper-Extract |
| CLI 指南 | 命令行界面 |
| Provider 系统 | 模型兼容性与本地部署 |
| 模板库 | 80+ 预设 |
| 示例 | 可用代码 |
🤝 贡献与许可
欢迎贡献!请提交 Issues 和 PRs。
采用 Apache-2.0 许可证。
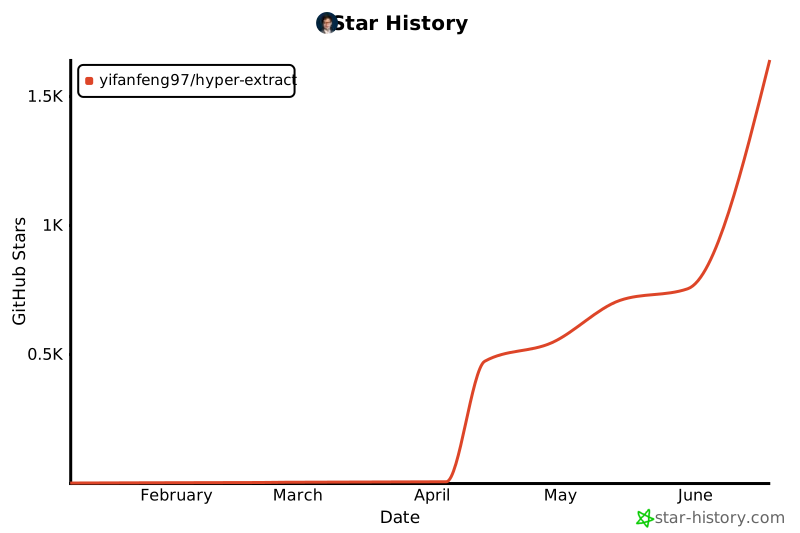
⭐ Star 历史