karukan

基于 GPT-2 和 llama.cpp 的神经网络日语输入法系统,支持 Linux/macOS 平台。亮点在于实时上下文感知的假名-汉字转换、用户行为学习及候选重写功能,相比传统规则引擎能提供更自然准确的转换候选。适合对日文输入或神经网络 IME 实现感兴趣的研究者。
README
Karukan
面向 Linux・macOS 的日语输入系统 — 基于神经网络的假名汉字转换引擎
项目结构
| crate(包) | 说明 |
|---|---|
| karukan-fcitx5 | Linux 版 IME 前端 — fcitx5 插件 + C FFI |
| karukan-macos | macOS 版 IME 前端 — Swift / InputMethodKit |
| karukan-im | 共享的 IME 引擎 — 状态机、罗马字转换、karukan-imserver(面向 macOS 的 JSON-RPC 服务器) |
| karukan-engine | 核心库 — 罗马字→平假名转换 + 基于 llama.cpp 的神经假名汉字转换 |
| karukan-cli | CLI 工具与服务器 — 词典构建、Sudachi 词典生成、词典查看器、AJIMEE-Bench、HTTP 服务器 |
特点
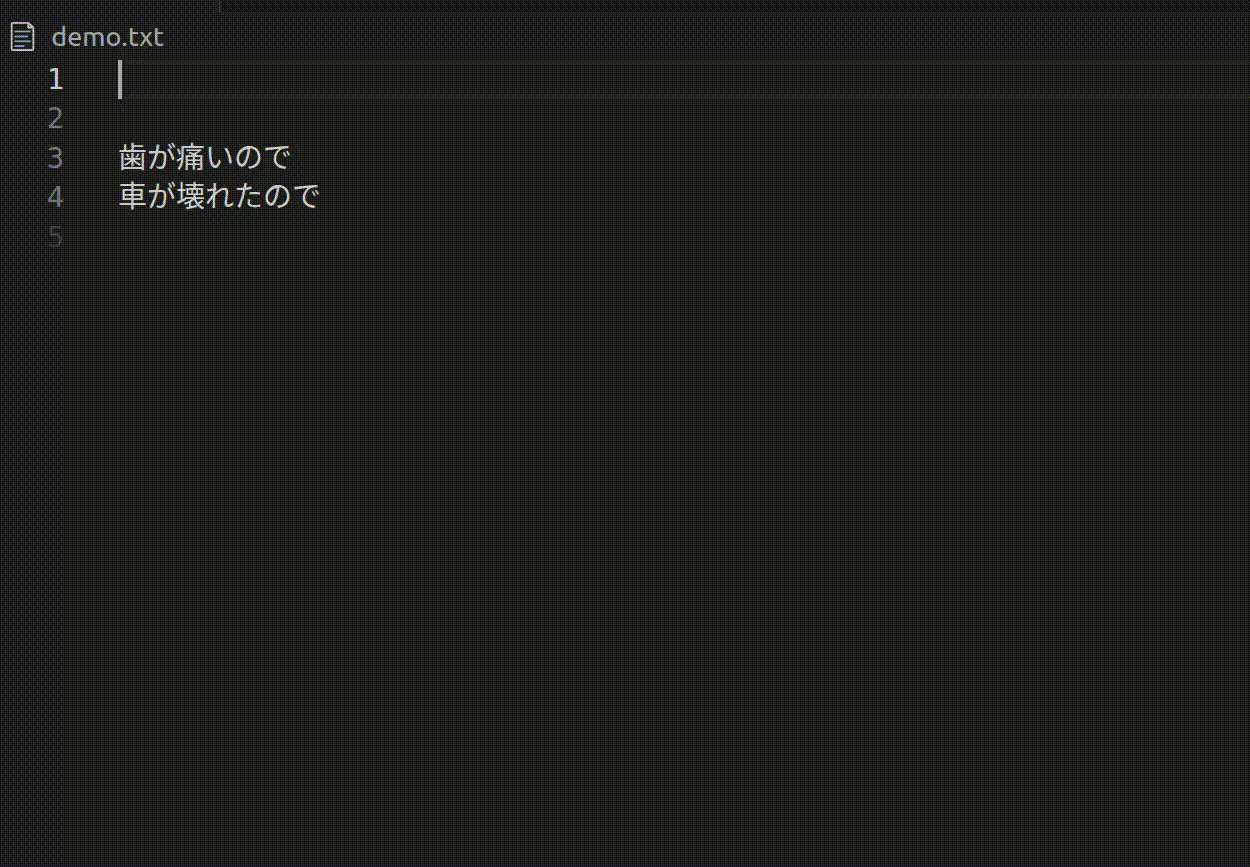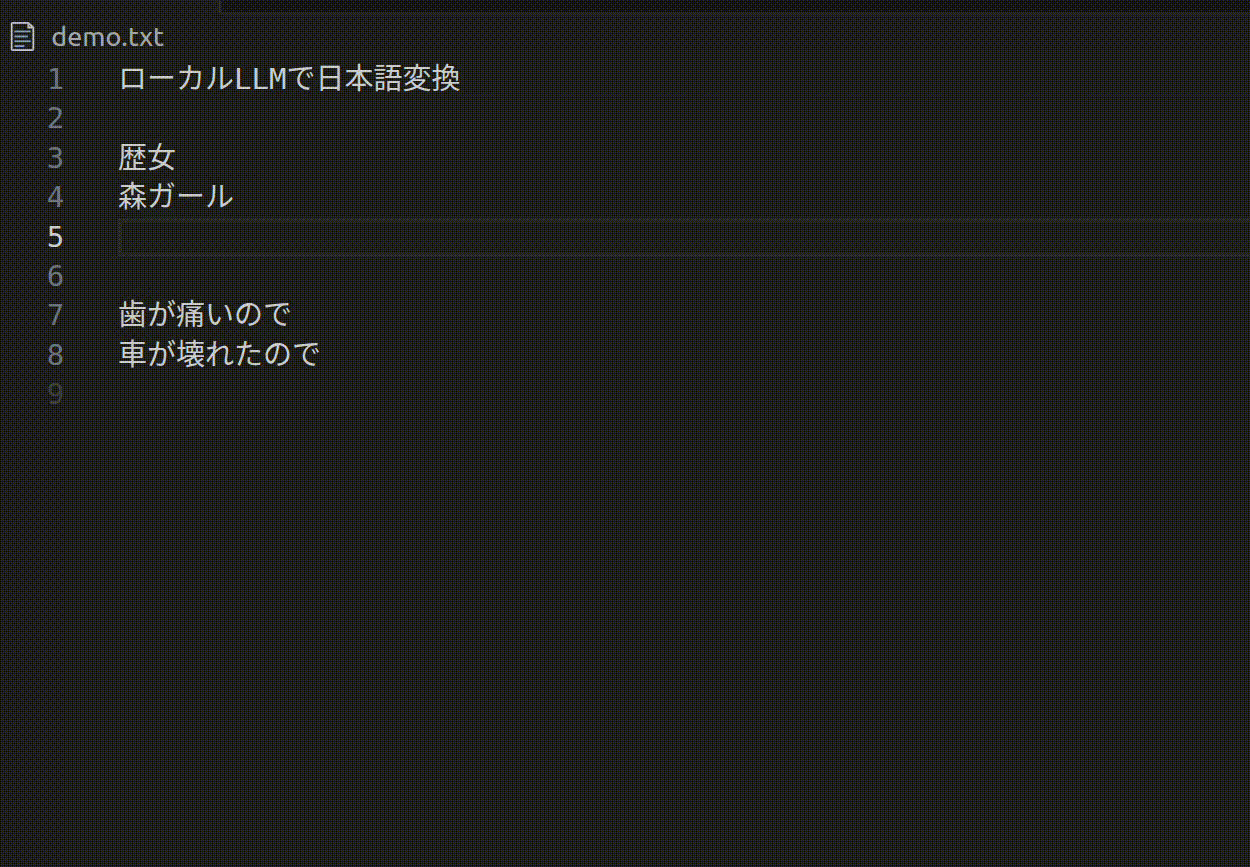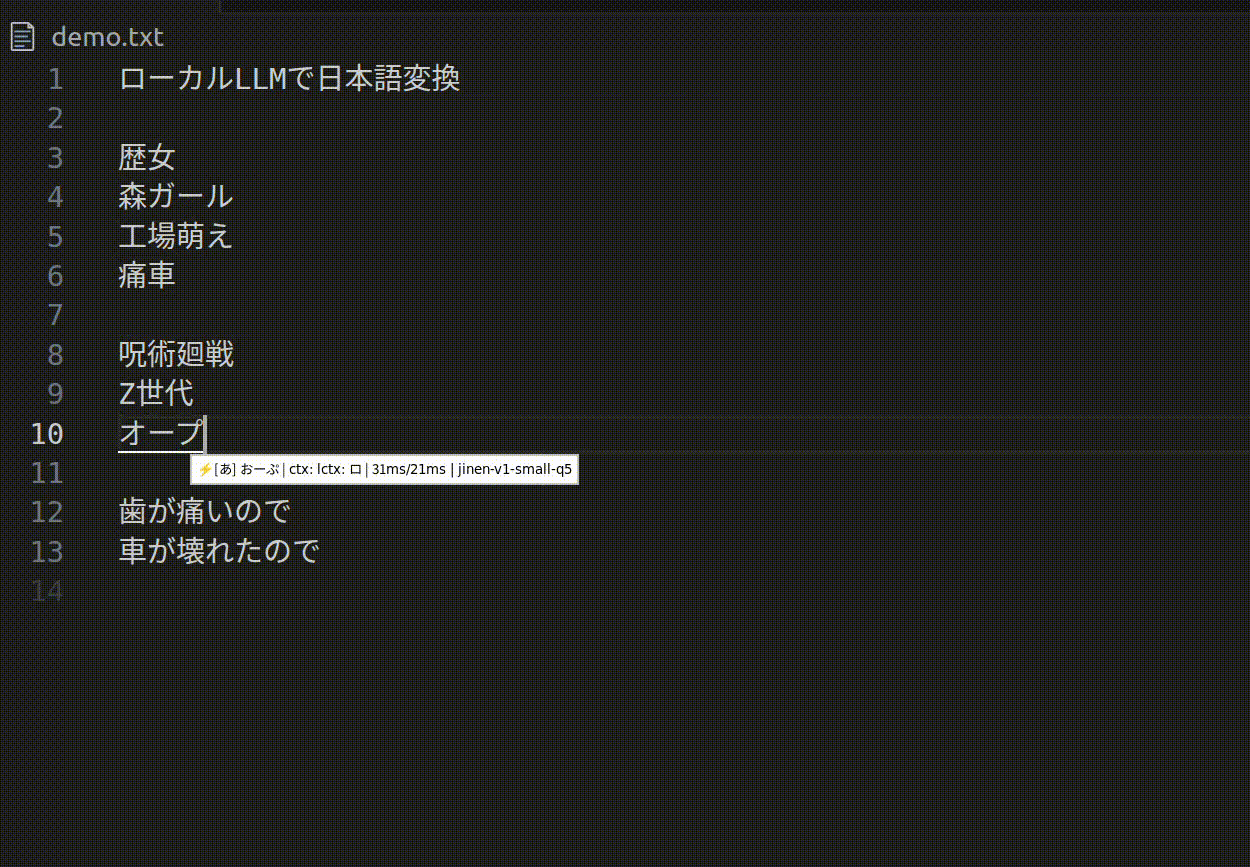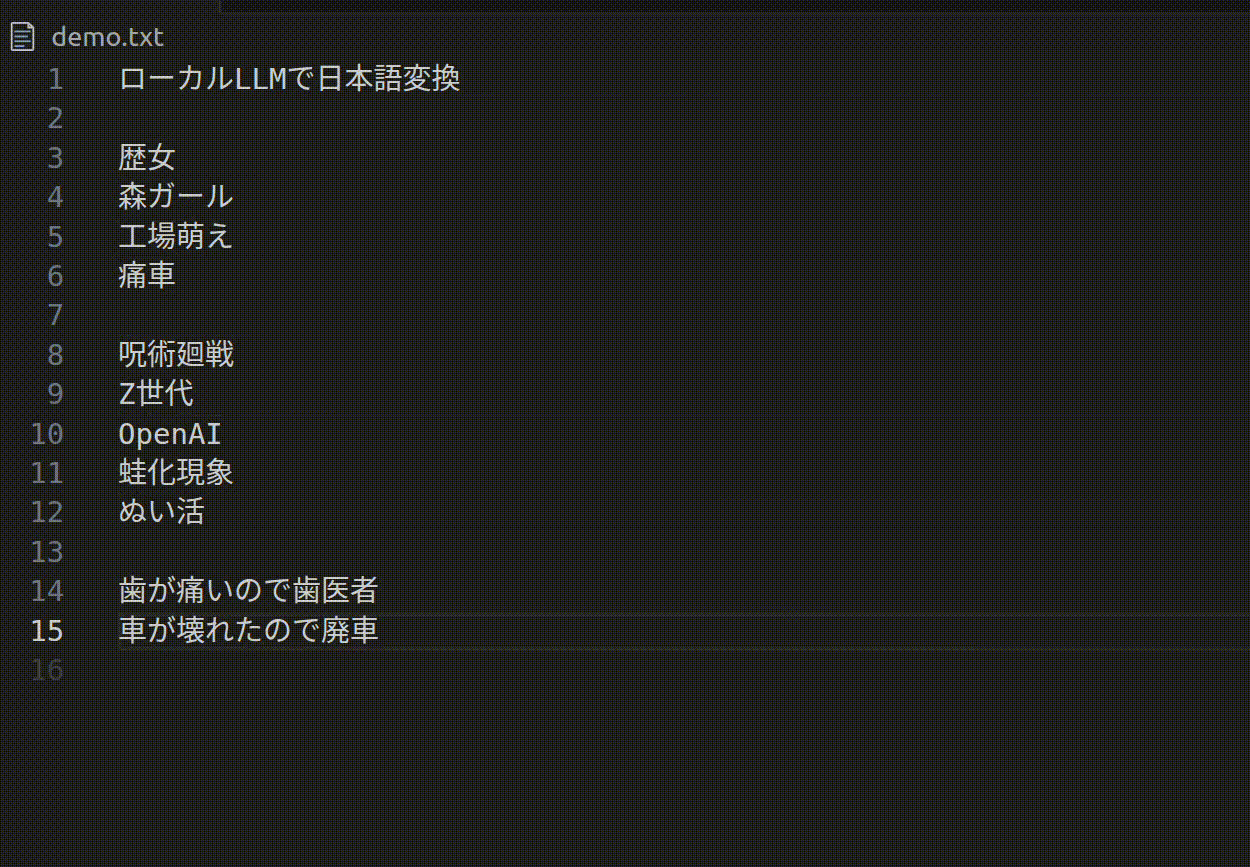
- 神经假名汉字转换:基于 GPT-2 的模型在 llama.cpp 上进行推理,实现高级日语转换
- 实时转换:一边输入一边实时显示转换结果。无需按空格键即可推进转换(通过
Ctrl+Shift+L开启/关闭) - 上下文感知:考虑周围文本的日语转换
- 转换学习:记忆用户选择的转换结果,并在后续转换中优先显示。也支持预测转换(前缀匹配),在输入过程中也能提示学习过的候选
- 系统词典:使用 SudachiDict 的词典数据构建系统词典
- 候选重写器(从 Mozc 移植):半角片假名、英文字母大小写・全角半角、符号相关候选、数字的各种表记(汉字数字・大写数字・罗马数字・圈圈数字・16/8/2 进制)自动生成。各候选附带源自 Mozc 的注释(如“半角片假名”“十六进制”等)
- 表情符号输入:支持假名读音(
ぴえん→ 🥺、きんにく→ 💪)和 Slack 风格的:trigger查询(:smile→ 😄、:halo→ 😇)
注意: 首次启动时会从 Hugging Face 下载模型,因此第一次转换需要较长时间。从第二次开始将使用已下载的模型。
安装
- Linux (fcitx5):请参考 karukan-fcitx5 的 README
- macOS:请参考 karukan-macos 的 README
许可证
采用 MIT 或 Apache-2.0 的双许可证。
karukan-engine/data/ 目录下包含派生自 Mozc(Google 制作的日语输入系统)的数据,这些部分基于 BSD 3-Clause License 发布。各派生文件的来源及 Mozc 的版权声明请参阅 THIRD_PARTY_LICENSES。