supertonic

轻量级多语言TTS引擎,基于ONNX Runtime实现设备端推理,支持31种语言,可在CPU、浏览器和边缘设备上运行。相比ElevenLabs、OpenAI等云服务,在金融缩写、电话号码等复杂文本朗读上表现更优,且模型仅99M参数,延迟和内存占用均极低。适合需要离线、低延迟、高隐私的TTS场景,提供Python/JS/C++/Rust等多语言SDK和浏览器示例。
README
Supertonic — 闪电般快速、设备端、精准的TTS


 -Demo-lightgrey)
-Models-lightgrey)
Supertonic 是一个闪电般快速、运行在设备端的文本转语音(TTS)系统,专为本地推理设计,开销极小。基于 ONNX Runtime,它完全在你的设备上运行——无需云端、无需 API 调用、无隐私顾虑。
📰 更新动态
- 2026.04.29 - 🎉 Supertonic 3 发布,支持 31 种语言,阅读准确性提升,重复/跳过失败减少,并提供了兼容 v2 的公共 ONNX 资源。演示 | 模型
- 2026.01.22 - Voice Builder 现已上线!将你的声音转换为可部署、边缘原生的 TTS,并拥有永久所有权。
- 2026.01.06 - 🎉 Supertonic 2 发布,支持 5 种语言。v2 代码路径保留在
release/supertonic-2分支上。 - 2025.12.10 - 添加了
supertonicPyPI 包!通过pip install supertonic安装。详情请访问 supertonic-py 文档 - 2025.12.10 - 新增 6 种语音风格(M3、M4、M5、F3、F4、F5)。详情见 Voices
- 2025.12.08 - 通过 OnnxSlim 优化的 ONNX 模型现已在 Hugging Face Models 上提供
- 2025.11.24 - 添加了 Flutter SDK 支持,兼容 macOS
快速开始
安装 Python SDK 并立即生成语音。首次运行时,Supertonic 会自动从 Hugging Face 下载模型资源。
pip install supertonic
Python
from supertonic import TTS

# 首次运行会自动从 Hugging Face 下载模型。
tts = TTS(auto_download=True)

style = tts.get_voice_style(voice_name="M1")

text = "A gentle breeze moved through the open window while everyone listened to the story."
wav, duration = tts.synthesize(text, voice_style=style, lang="en")

tts.save_audio(wav, "output.wav")
print(f"Generated {duration:.2f}s of audio")
开始使用
首先,克隆仓库:
git clone https://github.com/supertone-inc/supertonic.git
cd supertonic
先决条件
在运行示例之前,下载 ONNX 模型和预设语音,并将其放置在 assets 目录中:
注意: Hugging Face 仓库使用 Git LFS。请确保在克隆或拉取大型模型文件之前已安装并初始化 Git LFS。
- macOS:
brew install git-lfs && git lfs install- 通用:参见
https://git-lfs.com获取安装程序
git lfs install
git clone https://huggingface.co/Supertone/supertonic-3 assets
某些语言的示例需要原生运行时:
- Go:安装 ONNX Runtime C 库。在 macOS 上,
brew install onnxruntime即可;Go 示例会自动检测 Homebrew 路径。 - Java:使用 JDK,而不仅仅是 JRE。在 macOS 上,
brew install openjdk@17即可。 - C#:目标为 .NET 9,并允许主版本向前滚动,因此 .NET 9 或更新版本的运行时可以运行。
然后运行 Python 示例:
cd py
uv sync
uv run example_onnx.py
这将使用默认预设语音生成 outputs/output.wav。
其他运行时示例
在其他语言和平台上运行 SupertonicNode.js 示例 (详情)
cd nodejs
npm install
npm start
浏览器示例 (详情)
cd web
npm install
npm run dev
Java 示例 (详情)
cd java
mvn clean install
mvn exec:java
C++ 示例 (详情)
cd cpp
mkdir build && cd build
cmake .. && cmake --build . --config Release
./example_onnx
C# 示例 (详情)
cd csharp
dotnet restore
dotnet run
Go 示例 (详情)
cd go
go mod download
go run example_onnx.go helper.go
Swift 示例 (详情)
cd swift
swift build -c release
.build/release/example_onnx
Rust 示例 (详情)
cd rust
cargo build --release
./target/release/example_onnx
iOS 示例 (详情)
cd ios/ExampleiOSApp
xcodegen generate
open ExampleiOSApp.xcodeproj
在 Xcode 中:Targets → ExampleiOSApp → Signing:选择你的 Team,然后选择你的 iPhone 作为运行目标并构建。
技术细节
- 运行时:ONNX Runtime 用于跨平台推理
- 浏览器支持:onnxruntime-web 用于客户端推理
- 批处理:支持批量推理以提高吞吐量
- 音频输出:输出 16 位 WAV 文件
性能亮点
Supertonic 3 专为实用的设备端推理而设计:体积紧凑,可在本地运行,同时与许多更大的开源 TTS 系统保持竞争力。
阅读准确性
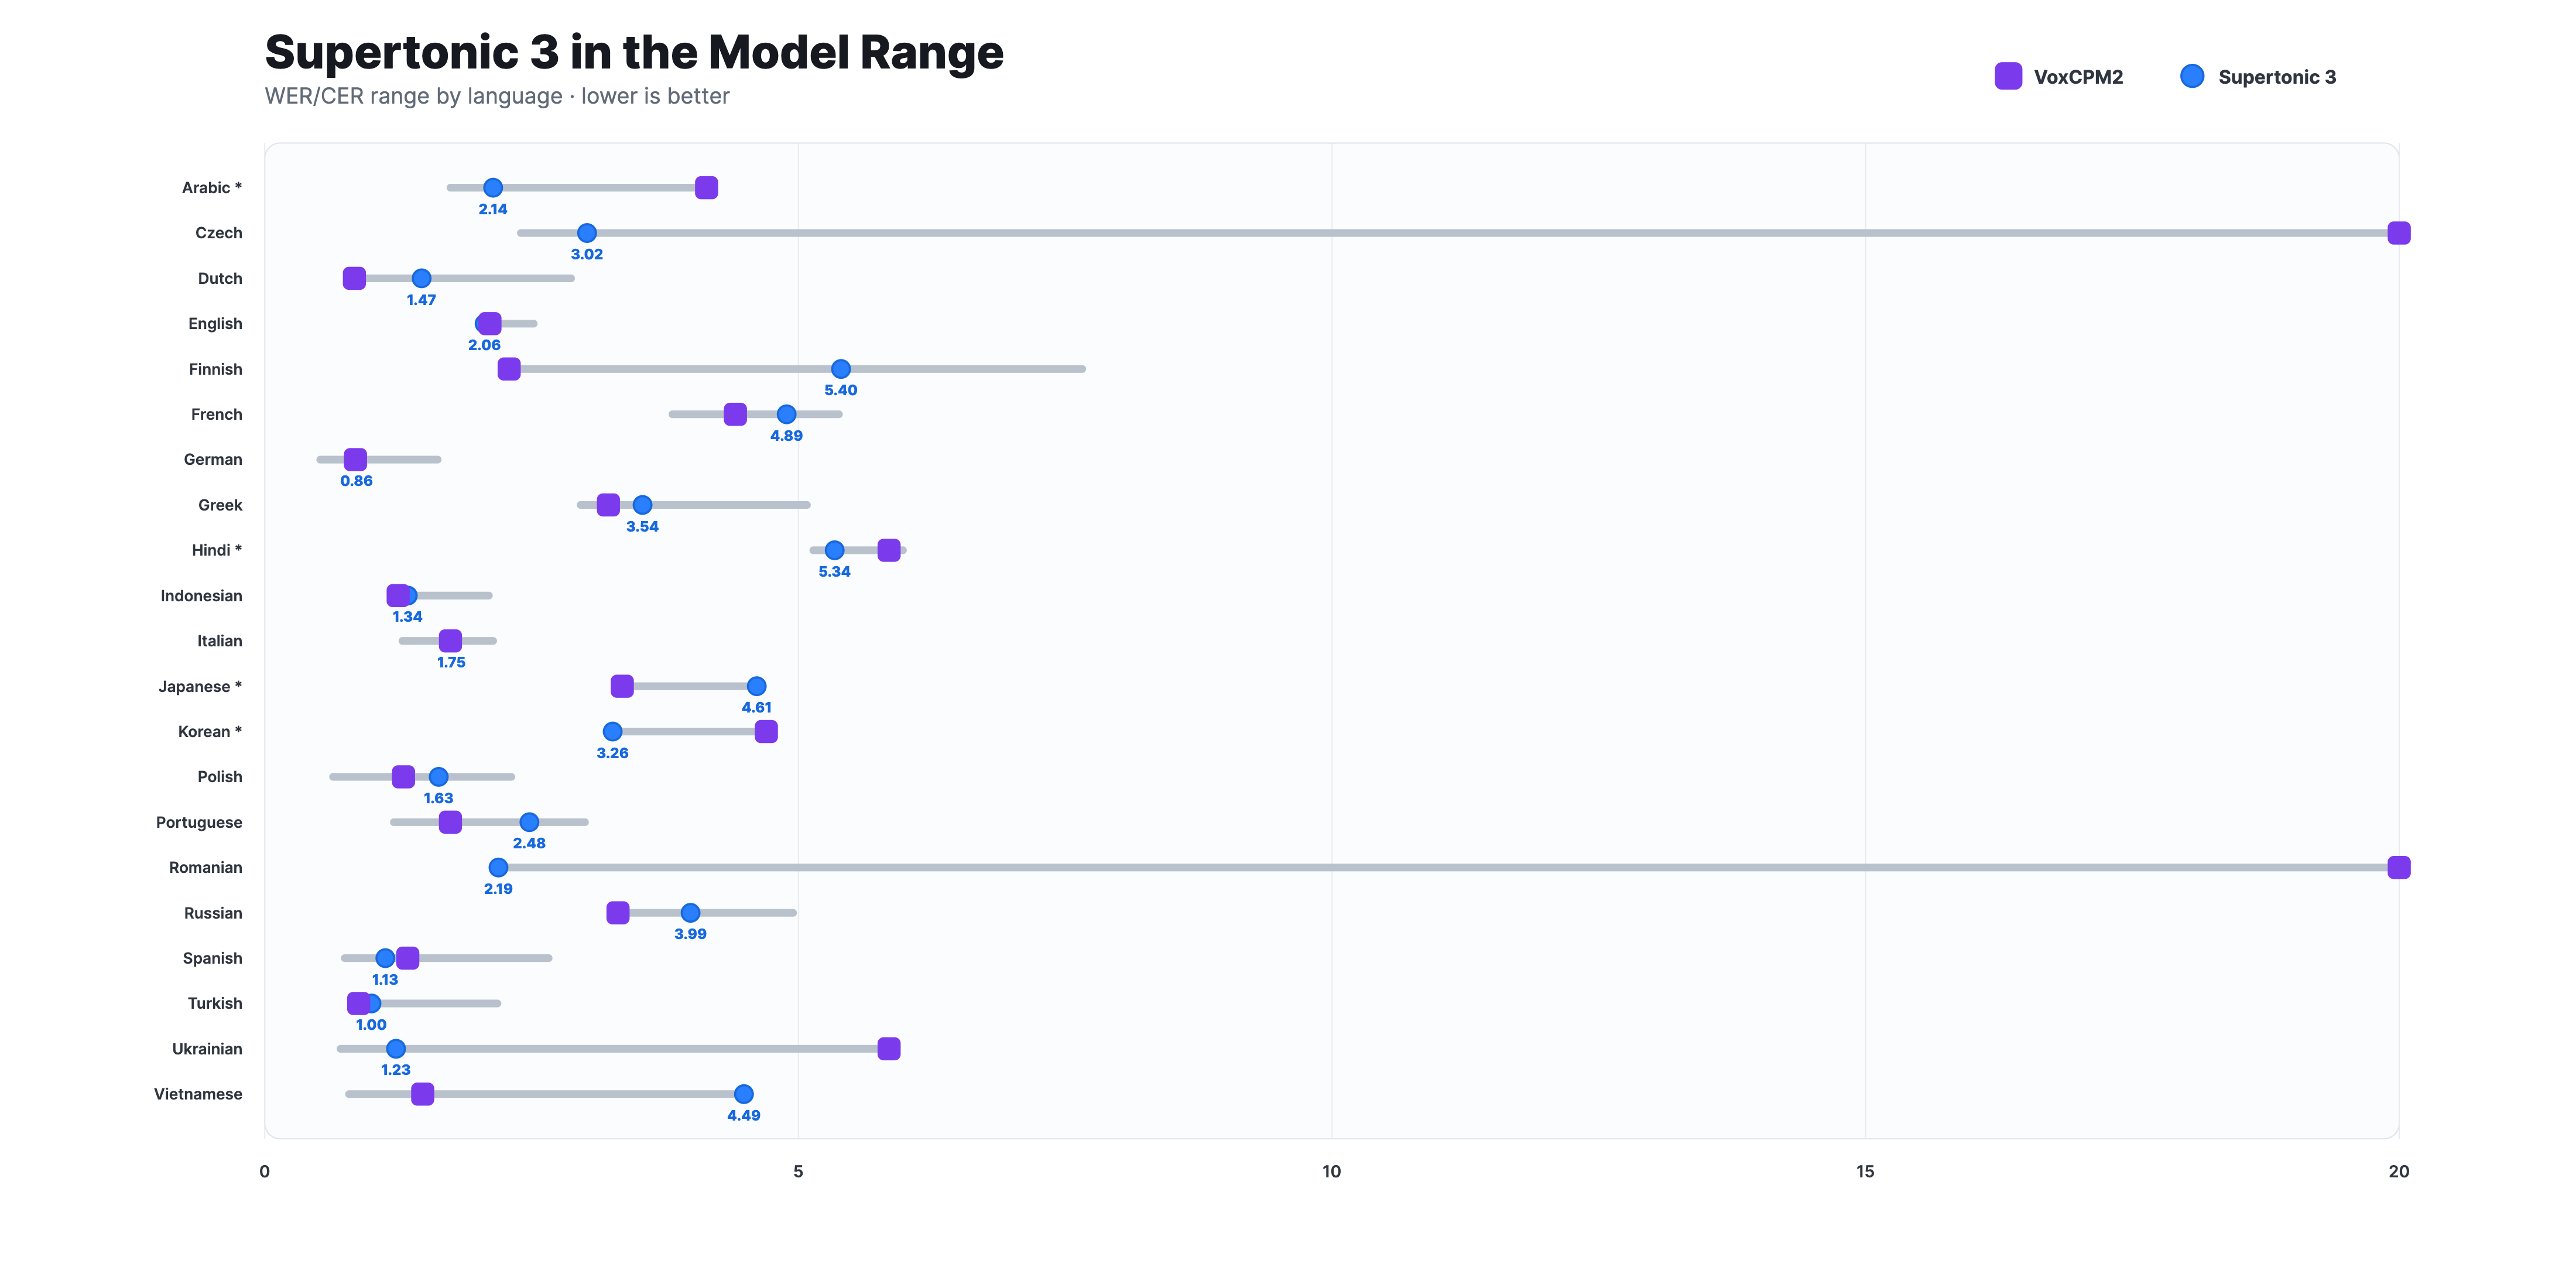
在所测量的语言中,Supertonic 3 在与更大的开源 TTS 模型(如 VoxCPM2)的 WER/CER 范围内保持竞争力,同时保留了轻量级的设备端部署路径。带星号的语言使用 CER;其他语言使用 WER。
Supertonic 2 到 Supertonic 3
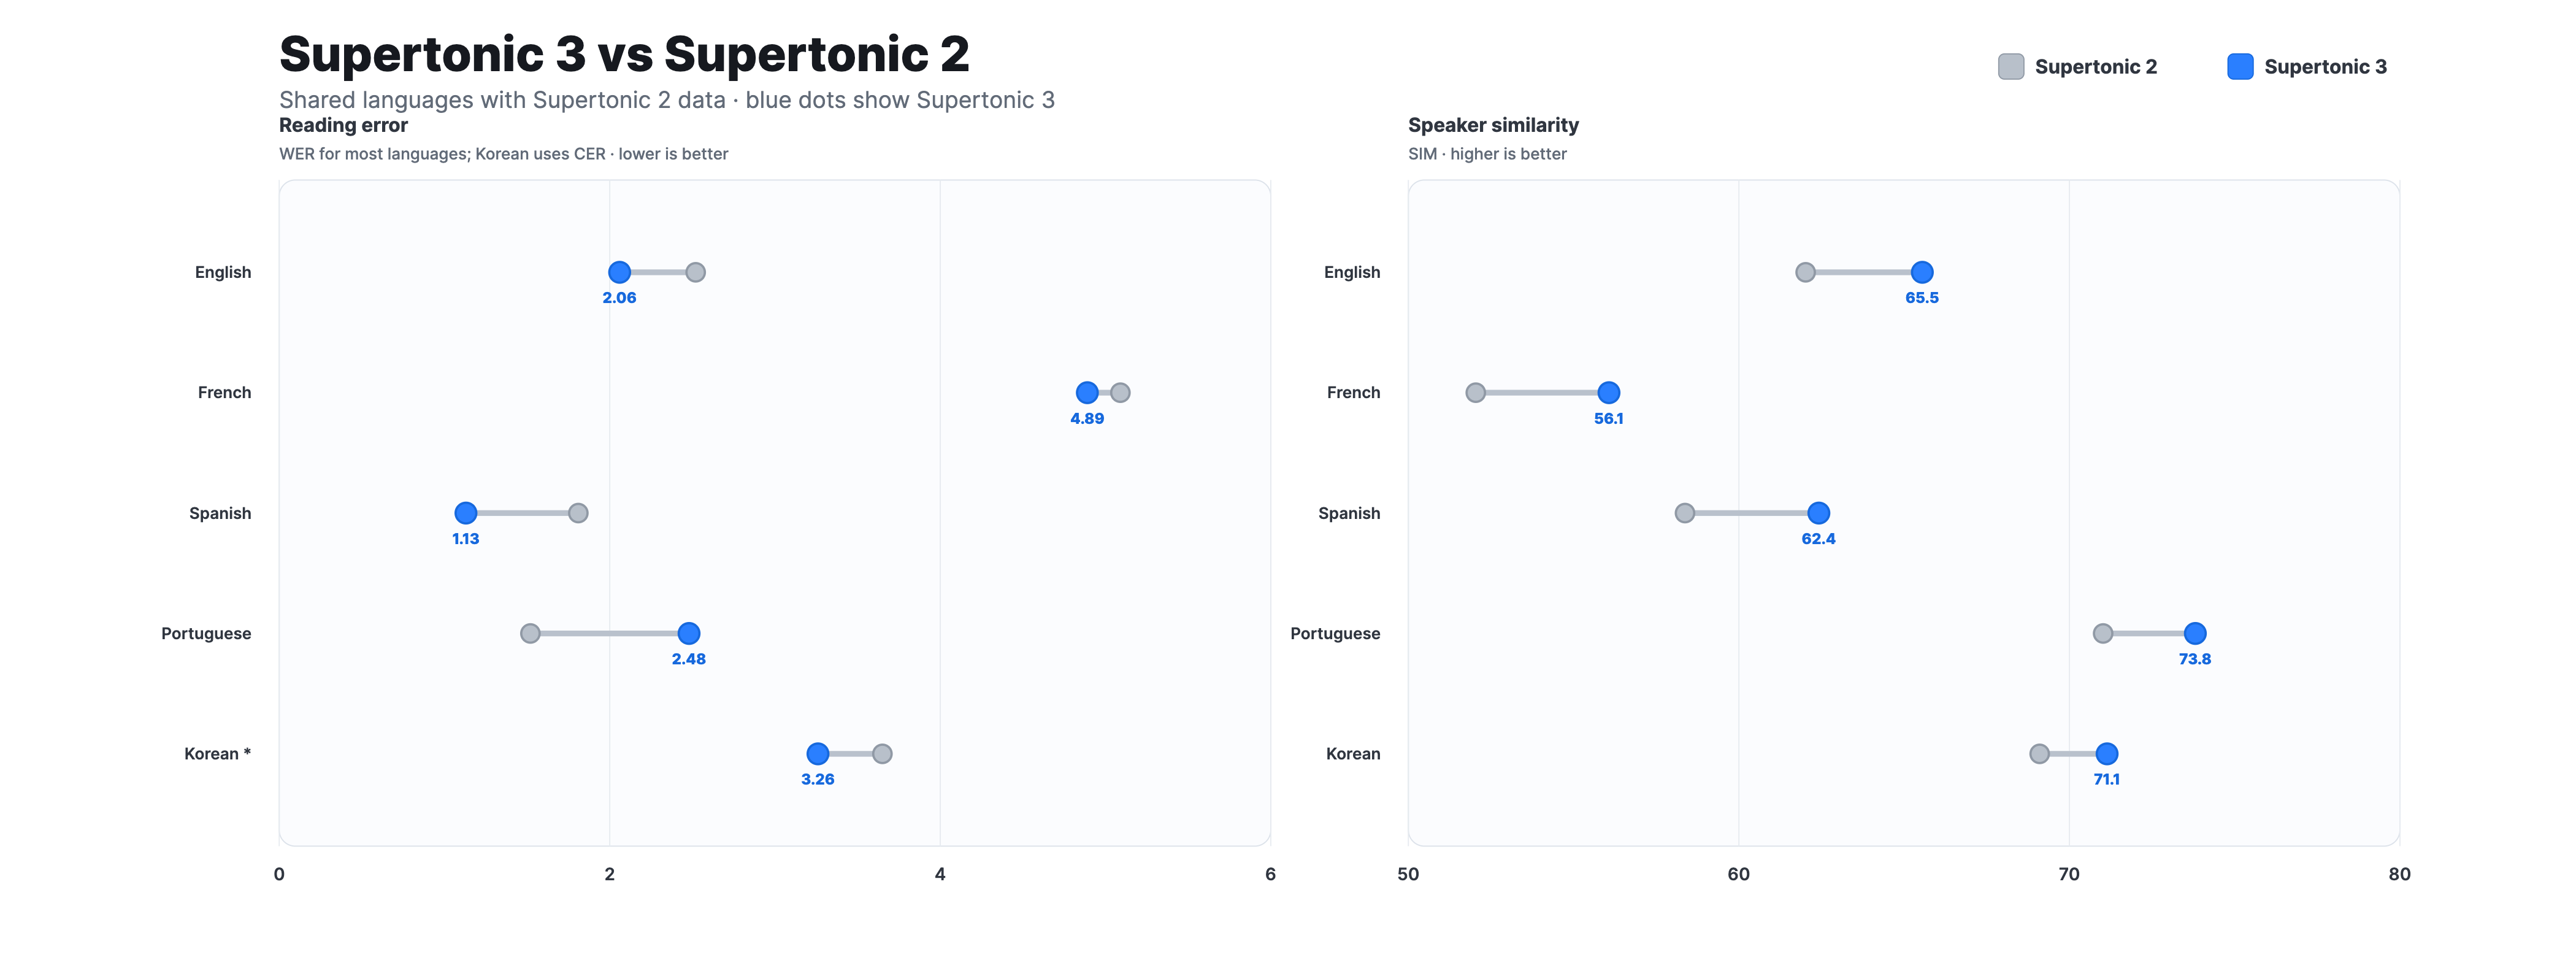
与 Supertonic 2 相比,Supertonic 3 减少了重复和跳过失败,提高了共享语言集上的说话人相似度,并将语言覆盖范围从 5 种扩展到 31 种语言。它保持了与 v2 兼容的公共 ONNX 接口,因此现有集成可以通过相同的推理合约迁移到 v3。
运行时占用
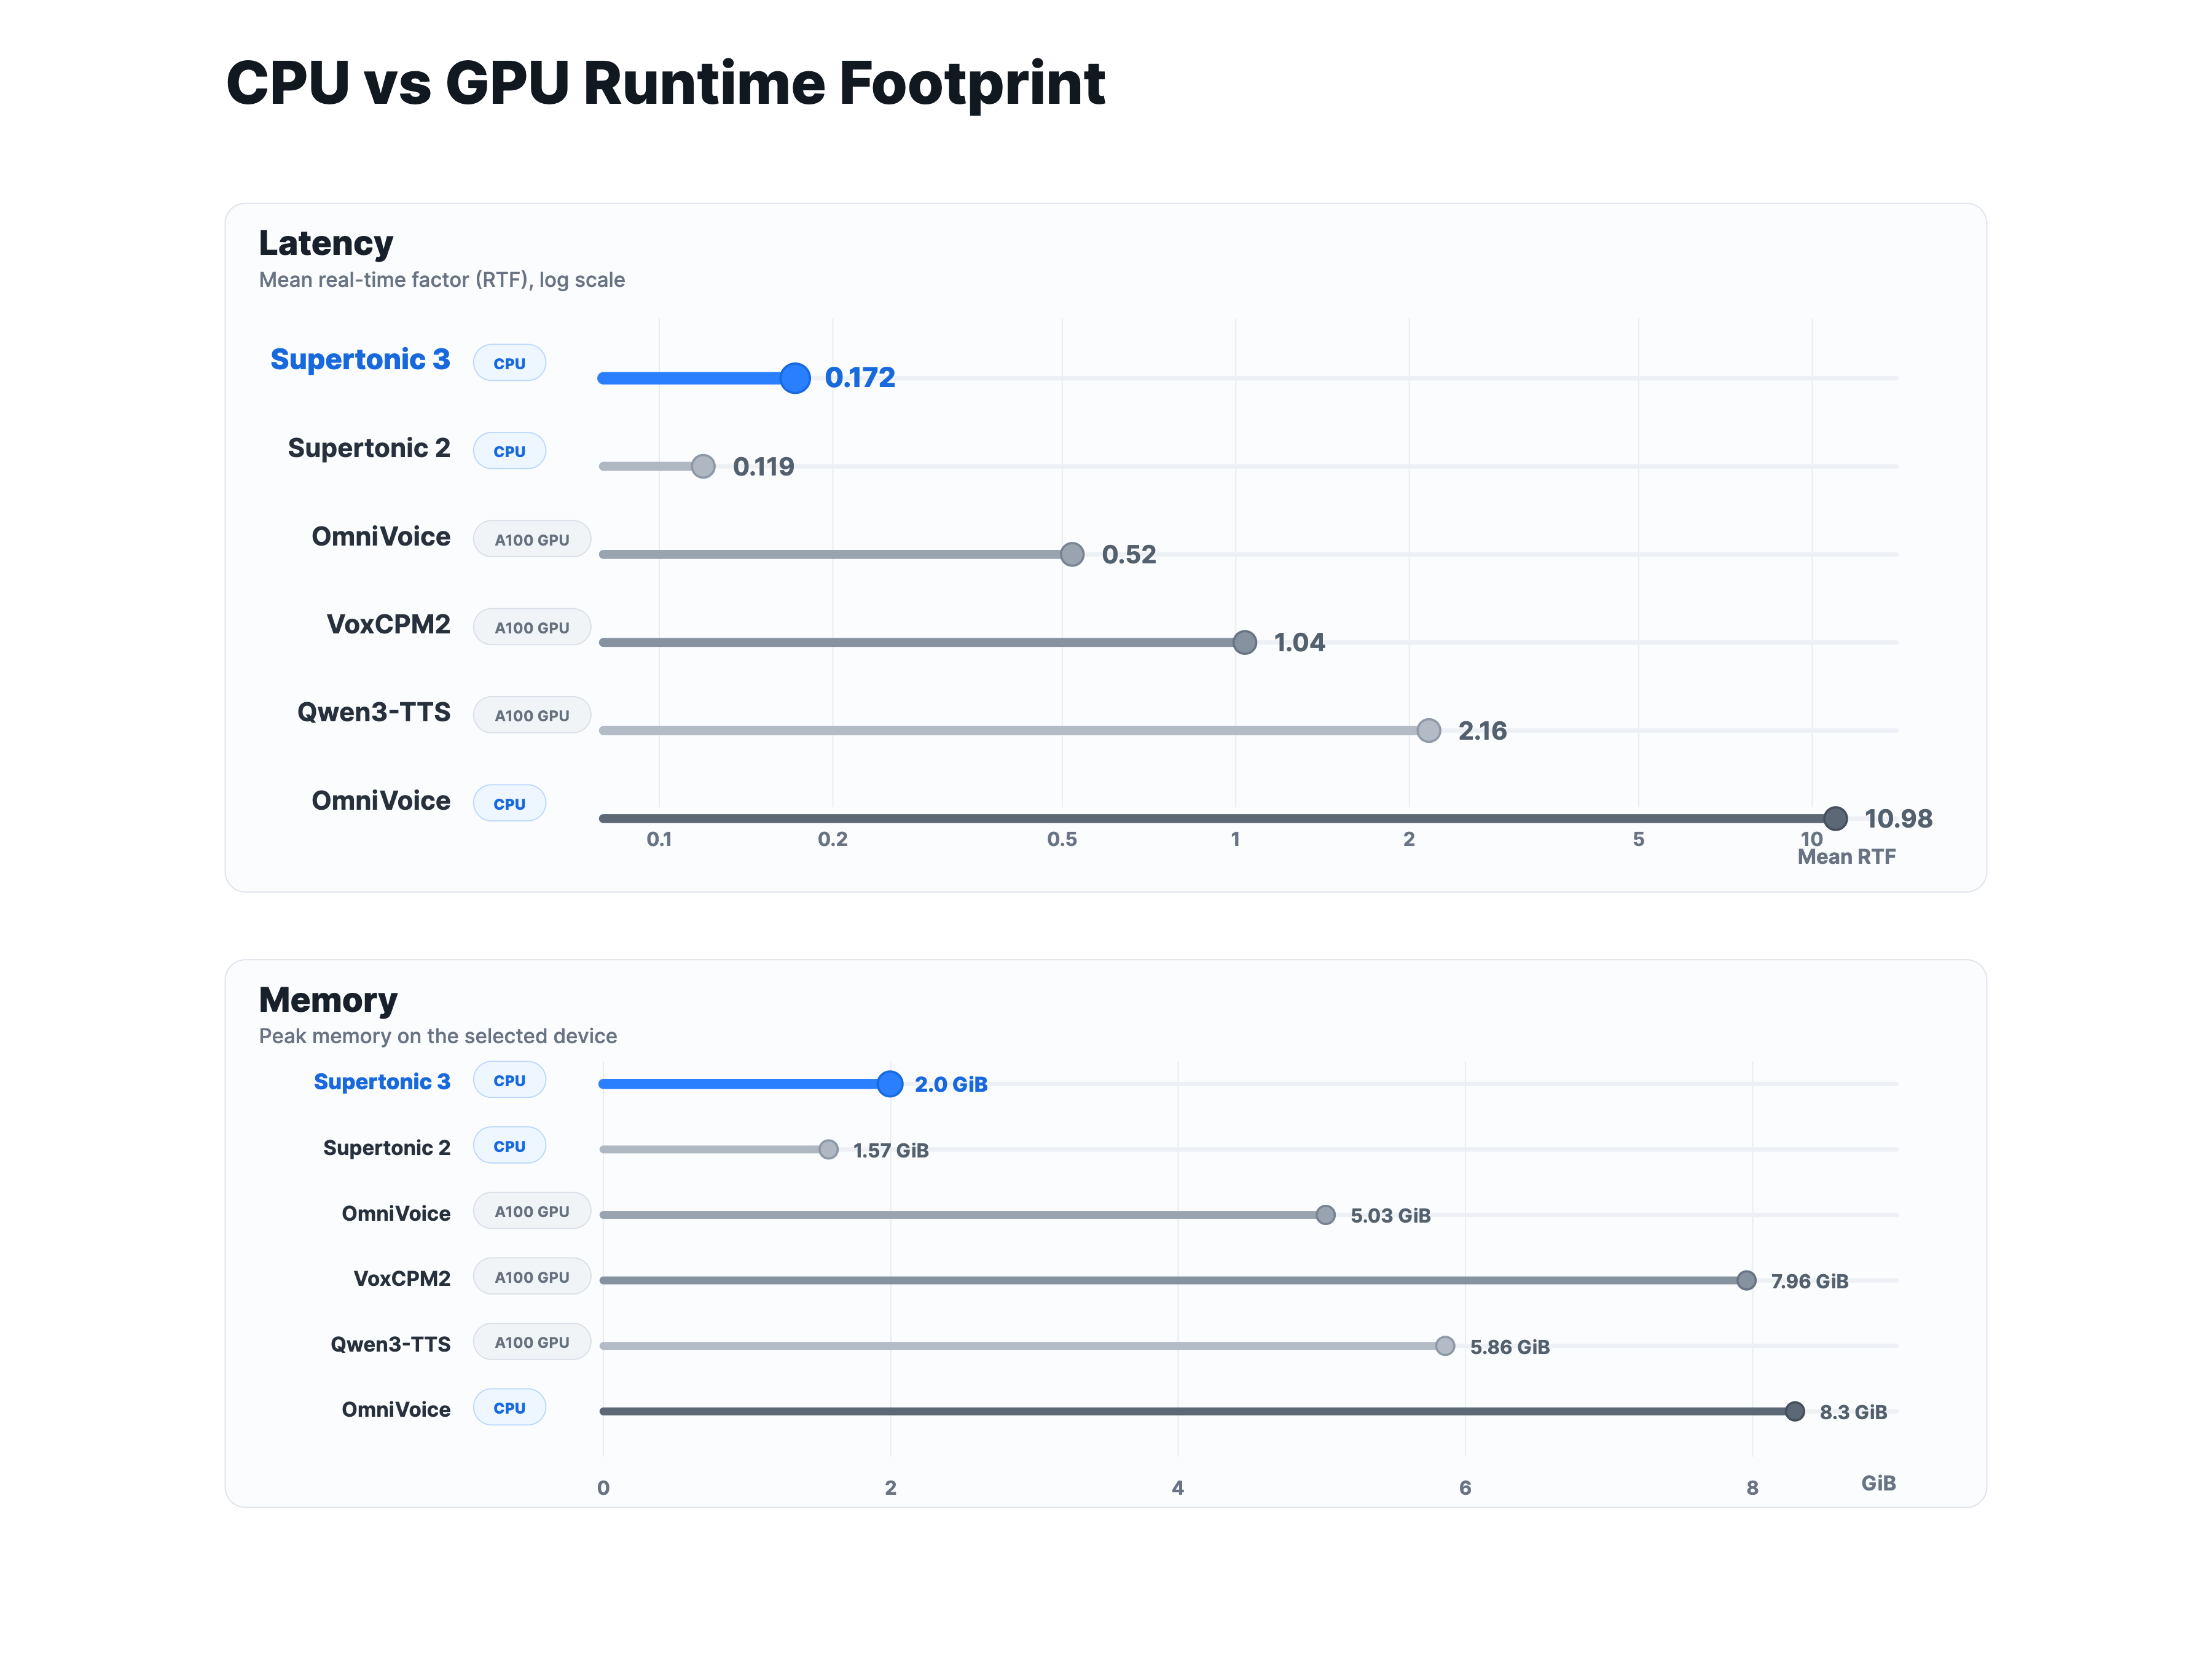
Supertonic 3 在 CPU 上运行快速,即使与在 A100 GPU 上测量的更大基线相比也是如此,并且内存使用量大幅减少。开放权重的固定语音设置不需要 GPU,这使得本地、浏览器和边缘部署更加容易。
模型大小
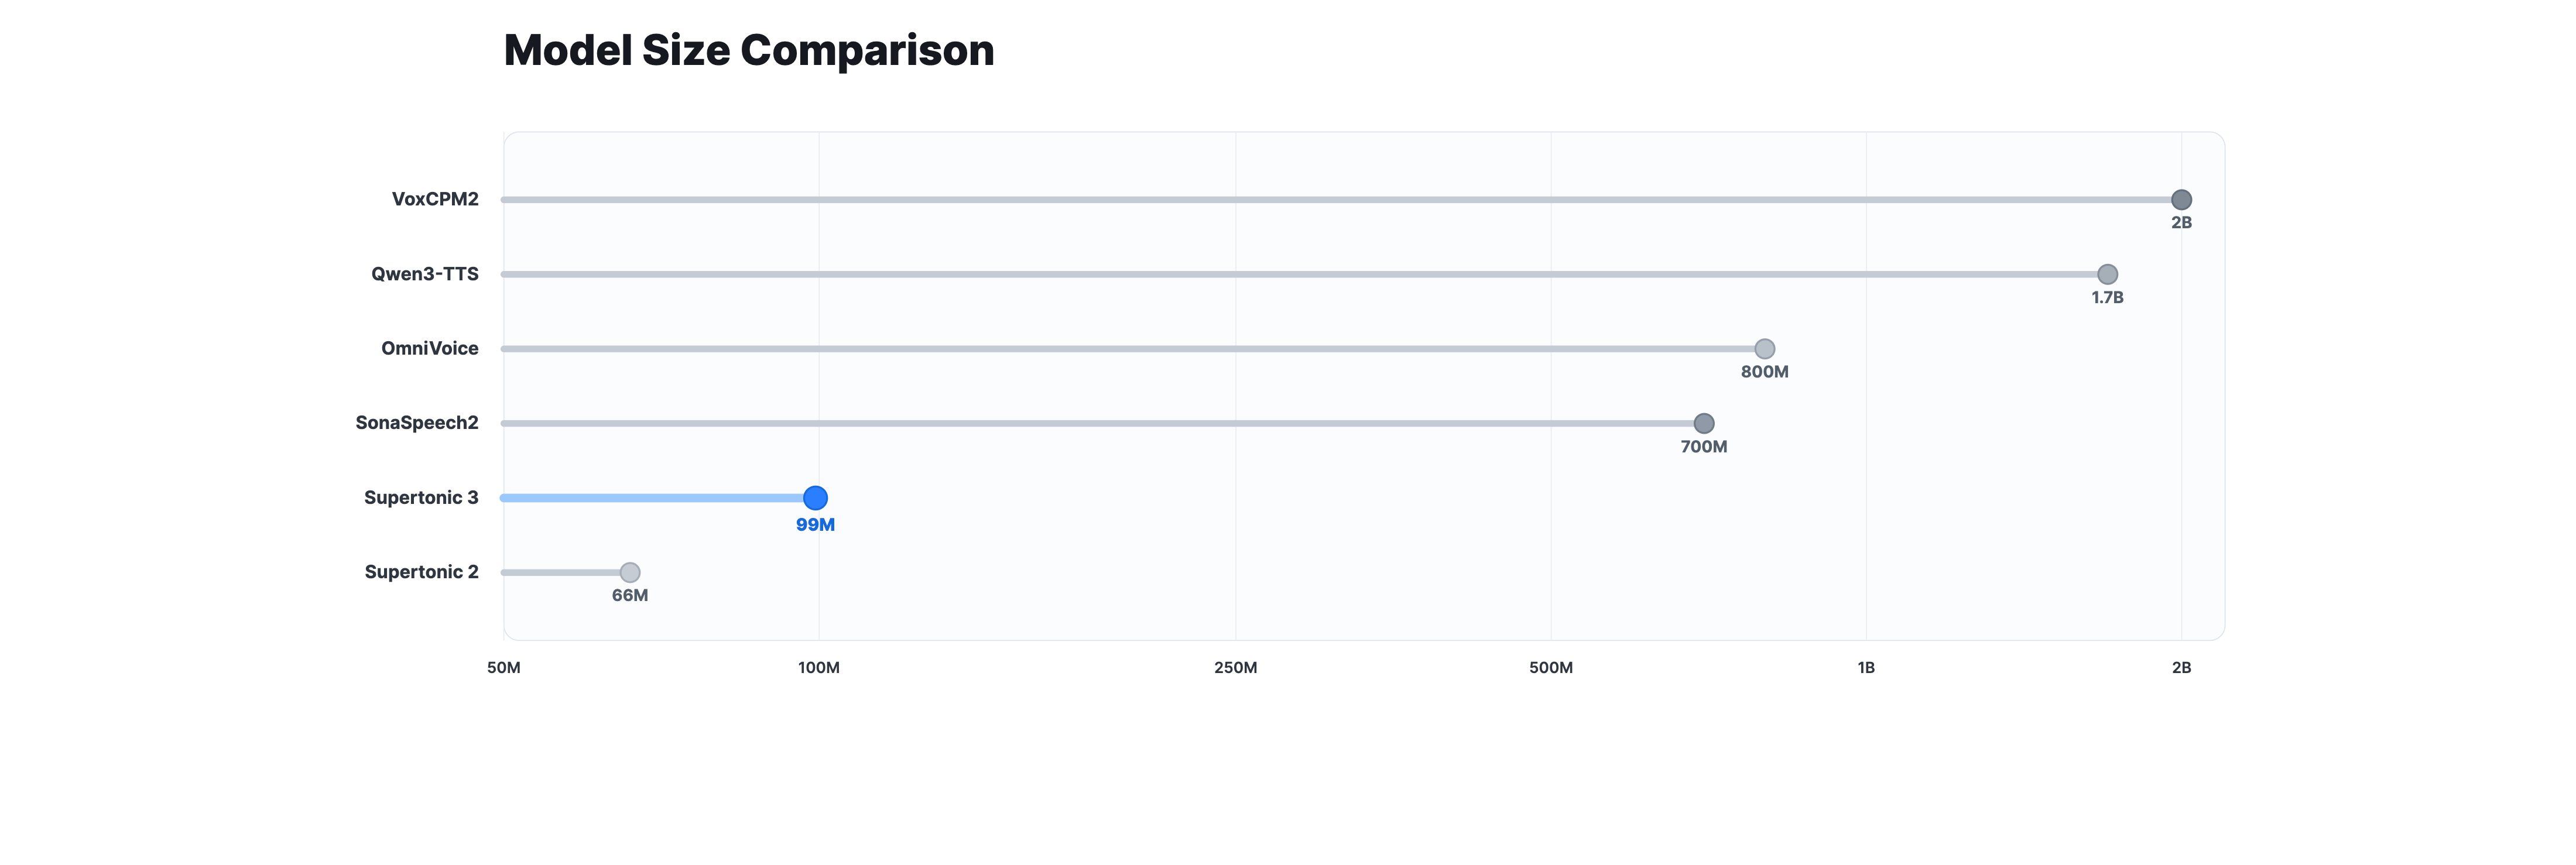
公共 ONNX 资源约 99M 参数,Supertonic 3 远小于 0.7B 到 2B 级别的开源 TTS 系统。更小的模型大小在下载大小、启动时间和设备端推理方面具有实际优势。
演示
立即尝试:在浏览器中体验 Supertonic,请访问我们的 交互式演示,或从 Hugging Face Hub 开始使用预训练模型
Raspberry Pi
观看 Supertonic 在 Raspberry Pi 上运行,展示设备端实时文本转语音合成:
https://github.com/user-attachments/assets/ea66f6d6-7bc5-4308-8a88-1ce3e07400d2
电子阅读器
在飞行模式下体验 Supertonic 在 Onyx Boox Go 6 电子阅读器上的表现,平均 RTF 达到 0.3×,零网络依赖:
https://github.com/user-attachments/assets/64980e58-ad91-423a-9623-78c2ffc13680
Chrome 扩展
在不到一秒内将任何网页转换为音频,提供闪电般快速、设备端的文本转语音,零网络依赖——免费、私密、轻松:
https://github.com/user-attachments/assets/cc8a45fc-5c3e-4b2c-8439-a14c3d00d91c
为什么选择 Supertonic?
- 极速:针对低延迟、设备端语音生成进行优化,适用于桌面、浏览器和边缘部署
- 轻量级:紧凑的 ONNX 资源,专为高效本地执行设计
- 设备端能力:完全隐私,零网络依赖
- 精准阅读:阅读稳定性提升,重复和跳过失败更少
- 表达标签:支持简单的表达标签,如
<laugh>、<breath>和<sigh> - 灵活部署:现成的示例涵盖 Python、JavaScript、浏览器、移动端和原生运行时
语言支持
Supertonic 3 支持 31 种语言:
| 代码 | 语言 | 代码 | 语言 | 代码 | 语言 | 代码 | 语言 |
|---|---|---|---|---|---|---|---|
en |
英语 | ko |
韩语 | ja |
日语 | ar |
阿拉伯语 |
bg |
保加利亚语 | cs |
捷克语 | da |
丹麦语 | de |
德语 |
el |
希腊语 | es |
西班牙语 | et |
爱沙尼亚语 | fi |
芬兰语 |
fr |
法语 | hi |
印地语 | hr |
克罗地亚语 | hu |
匈牙利语 |
id |
印尼语 | it |
意大利语 | lt |
立陶宛语 | lv |
拉脱维亚语 |
nl |
荷兰语 | pl |
波兰语 | pt |
葡萄牙语 | ro |
罗马尼亚语 |
ru |
俄语 | sk |
斯洛伐克语 | sl |
斯洛文尼亚语 | sv |
瑞典语 |
tr |
土耳其语 | uk |
乌克兰语 | vi |
越南语 |
我们在多个生态系统中提供现成的 TTS 推理示例:
| 语言/平台 | 路径 | 描述 |
|---|---|---|
| Python | py/ |
ONNX Runtime 推理 |
| Node.js | nodejs/ |
服务端 JavaScript |
| 浏览器 | web/ |
WebGPU/WASM 推理 |
| Java | java/ |
跨平台 JVM |
| C++ | cpp/ |
高性能 C++ |
| C# | csharp/ |
.NET 生态系统 |
| Go | go/ |
Go 实现 |
| Swift | swift/ |
macOS 应用程序 |
| iOS | ios/ |
原生 iOS 应用 |
| Rust | rust/ |
内存安全系统 |
| Flutter | flutter/ |
跨平台应用 |
有关详细的使用说明,请参阅每个语言目录中的 README.md。
自然文本处理
Supertonic 专为处理复杂、真实的文本输入而设计,这些输入包含自然散文、标点、缩写和专有名词。
🎧 更轻松地查看音频样本:请访问我们的 交互式演示 以更好地查看所有音频示例
测试用例概览:
| 范畴 | 主要挑战 | Supertonic | ElevenLabs | OpenAI | Gemini | Microsoft |
|---|---|---|---|---|---|---|
| 金融表达 | 小数金额、缩略量级(M、K)、货币符号、货币代码 | ✅ | ❌ | ❌ | ❌ | ❌ |
| 电话号码 | 区号、连字符、分机号(ext.) | ✅ | ❌ | ❌ | ❌ | ❌ |
| 技术单位 | 带单位的小数、缩略技术符号 | ✅ | ❌ | ❌ | ❌ | ❌ |
文本:
"The startup secured $5.2M in venture capital, a huge leap from their initial $450K seed round."
挑战:
- 货币中的小数点($5.2M 应读作 "five point two million")
- 缩略量级单位(M 代表 million,K 代表 thousand)
- 货币符号($)需要正确发音为 "dollars"
音频样本:
| 系统 | 结果 | 音频样本 |
|---|---|---|
| Supertonic | ✅ | 🎧 播放音频 |
| ElevenLabs Flash v2.5 | ❌ | 🎧 播放音频 |
| OpenAI TTS-1 | ❌ | 🎧 播放音频 |
| Gemini 2.5 Flash TTS | ❌ | 🎧 播放音频 |
| VibeVoice Realtime 0.5B | ❌ | 🎧 播放音频 |
文本:
"You can reach the hotel front desk at (212) 555-0142 ext. 402 anytime."
挑战:
- 括号中的区号,应作为单独数字读出
- 带连字符的电话号码(555-0142)
- 缩略的分机号表示法(ext.)
- 分机号(402)
音频样本:
| 系统 | 结果 | 音频样本 |
|---|---|---|
| Supertonic | ✅ | 🎧 播放音频 |
| ElevenLabs Flash v2.5 | ❌ | 🎧 播放音频 |
| OpenAI TTS-1 | ❌ | 🎧 播放音频 |
| Gemini 2.5 Flash TTS | ❌ | 🎧 播放音频 |
| VibeVoice Realtime 0.5B | ❌ | 🎧 播放音频 |
文本:
"Our drone battery lasts 2.3h when flying at 30kph with full camera payload."
挑战:
- 带缩写的十进制时长(2.3h = two point three hours)
- 带缩写的速度单位(30kph = thirty kilometers per hour)
- 技术缩写(h 代表 hours,kph 代表 kilometers per hour)
- 技术/工程语境要求正确发音
音频样本:
| 系统 | 结果 | 音频样本 |
|---|---|---|
| Supertonic | ✅ | 🎧 播放音频 |
| ElevenLabs Flash v2.5 | ❌ | 🎧 播放音频 |
| OpenAI TTS-1 | ❌ | 🎧 播放音频 |
| Gemini 2.5 Flash TTS | ❌ | 🎧 播放音频 |
| VibeVoice Realtime 0.5B | ❌ | 🎧 播放音频 |
注意: 这些样本展示了每个系统在无需预处理或音标注释的情况下,如何处理复杂表达式的文本归一化和发音。
使用 Supertonic 构建的项目
| 项目 | 描述 | 链接 |
|---|---|---|
| TLDRL | 免费的设备端 TTS 扩展,用于朗读任意网页 | Chrome |
| Read Aloud | 开源 TTS 浏览器扩展 | Chrome · Edge · GitHub |
| PageEcho | iOS 电子书阅读器应用 | App Store |
| VoiceChat | 浏览器中的设备端语音到语音 LLM 聊天机器人 | 演示 · GitHub |
| OmniAvatar | 通过照片+语音生成说话头像视频 | 演示 |
| CopiloTTS | 基于 ONNX Runtime 的 Kotlin 多平台 TTS SDK | GitHub |
| Voice Mixer | 基于 PyQt5 的语音风格混合与修改工具 | GitHub |
| Supertonic MNN | 基于 MNN 的轻量级库(fp32/fp16/int8) | GitHub · PyPI |
| Transformers.js | Hugging Face 的 JS 库,支持 Supertonic | GitHub PR · 演示 |
| Pinokio | 适用于 Mac、Windows 和 Linux 的一键本地主机云 | Pinokio · GitHub |
引用
以下论文描述了 Supertonic 中使用的核心技术。如果你在你的研究中使用本系统,或发现这些技术有用,请考虑引用相关论文:
SupertonicTTS:主要架构
这篇论文介绍了 SupertonicTTS 的整体架构,包括语音自编码器、基于 flow-matching 的文本到隐空间模块,以及高效的设计选择。
@article{kim2025supertonic,
  title={SupertonicTTS: Towards Highly Efficient and Streamlined Text-to-Speech System},
  author={Kim, Hyeongju and Yang, Jinhyeok and Yu, Yechan and Ji, Seunghun and Morton, Jacob and Bous, Frederik and Byun, Joon and Lee, Juheon},
  journal={arXiv preprint arXiv:2503.23108},
  year={2025},
  url={https://arxiv.org/abs/2503.23108}
}
Length-Aware RoPE:文本-语音对齐
这篇论文提出了长度感知旋转位置嵌入(LARoPE),改进了交叉注意力机制中的文本-语音对齐。
@article{kim2025larope,
  title={Length-Aware Rotary Position Embedding for Text-Speech Alignment},
  author={Kim, Hyeongju and Lee, Juheon and Yang, Jinhyeok and Morton, Jacob},
  journal={arXiv preprint arXiv:2509.11084},
  year={2025},
  url={https://arxiv.org/abs/2509.11084}
}
Self-Purifying Flow Matching:带噪声标签的训练
这篇论文描述了自净化技术,用于在噪声或不可靠标签下稳健地训练 flow matching 模型。
@article{kim2025spfm,
  title={Training Flow Matching Models with Reliable Labels via Self-Purification},
  author={Kim, Hyeongju and Yu, Yechan and Yi, June Young and Lee, Juheon},
  journal={arXiv preprint arXiv:2509.19091},
  year={2025},
  url={https://arxiv.org/abs/2509.19091}
}
许可证
本项目的示例代码采用 MIT 许可证发布。详情请参见 LICENSE。
附带的模型采用 OpenRAIL-M 许可证发布。详情请参见 LICENSE 文件。
该模型使用 PyTorch 训练,PyTorch 采用 BSD 3-Clause 许可证,但未随本项目重新分发。详情请参见 LICENSE。
Copyright (c) 2026 Supertone Inc.