machine-learning-for-trading

《Machine Learning for Algorithmic Trading》第二版的配套代码,包含150多个Notebook,系统讲解从线性回归到深度强化学习在量化交易中的应用。覆盖数据工程、特征工程、模型训练到策略回测全流程,并复现了多篇顶级期刊研究。亮点是内容全面且实践性强,适用于金融从业者快速上手ML驱动的交易策略。
README
ML for Trading - 2nd Edition
这本书旨在以实用且全面的方式展示机器学习(ML)如何为算法交易策略带来价值。它涵盖了从线性回归到深度强化学习的广泛 ML 技术,并演示了如何构建、回测和评估由模型预测驱动的交易策略。
全书分为四个部分,共 23 章及一个附录,篇幅 超过 800 页:
- 数据来源、金融特征工程和投资组合管理的重要方面,
- 基于监督和无监督 ML 算法的多空策略的设计与评估,
- 如何从金融文本数据(如 SEC 文件、财报电话会议记录或金融新闻)中提取可交易信号,
- 使用深度学习模型(如 CNN 和 RNN)处理市场和另类数据,利用生成对抗网络生成合成数据,以及使用深度强化学习训练交易智能体。
本仓库包含 超过 150 个笔记本,将书中讨论的概念、算法和用例付诸实践。它们提供了大量示例,展示了:
- 如何处理并从市场、基本面及另类文本和图像数据中提取信号,
- 如何训练和调优预测不同资产类别和投资期限收益的模型,包括如何复现近期发表的研究,
- 如何设计、回测和评估交易策略。
我们强烈建议在阅读本书的同时翻阅这些笔记本;它们通常处于已执行状态,并且常常包含因篇幅限制而未收录的额外信息。
除了本仓库中的信息,本书的网站还包含章节摘要和其他信息。
加入 ML4T 社区!
为了方便读者就本书内容和代码示例以及他们自己策略开发和行业动态提出问题,我们举办了一个在线平台。
请加入我们的社区,与同样对利用 ML 进行交易策略感兴趣的交易者联系,分享经验,互相学习!
第二版的新变化是什么?
首先,这本书演示了如何从多样化的数据源中提取信号,并使用广泛的监督、无监督和强化学习算法为不同资产类别设计交易策略。它还提供了相关的数学和统计知识,以促进算法调优或结果解释。此外,它涵盖了金融背景知识,帮助你处理市场和基本面数据、提取信息特征并管理交易策略的表现。
从实践角度来看,第二版旨在为你提供开发基于 ML 的交易策略所需的概念理解和工具。为此,它将 ML 视为过程中一个关键元素而非孤立练习,引入了端到端的 ML for Trading 工作流,涵盖数据来源、特征工程、模型优化到策略设计和回测。
更具体地说,ML4T 工作流从为定义明确的投资范围产生想法开始,收集相关数据,提取信息特征。它还包括设计、调优和评估适合预测任务的 ML 模型。最后,它需要开发交易策略来执行模型的预测信号,并使用回测引擎在历史数据上模拟和评估其表现。一旦你决定在真实市场中执行算法策略,你会发现反复迭代这个工作流以吸收新信息和不断变化的环境。
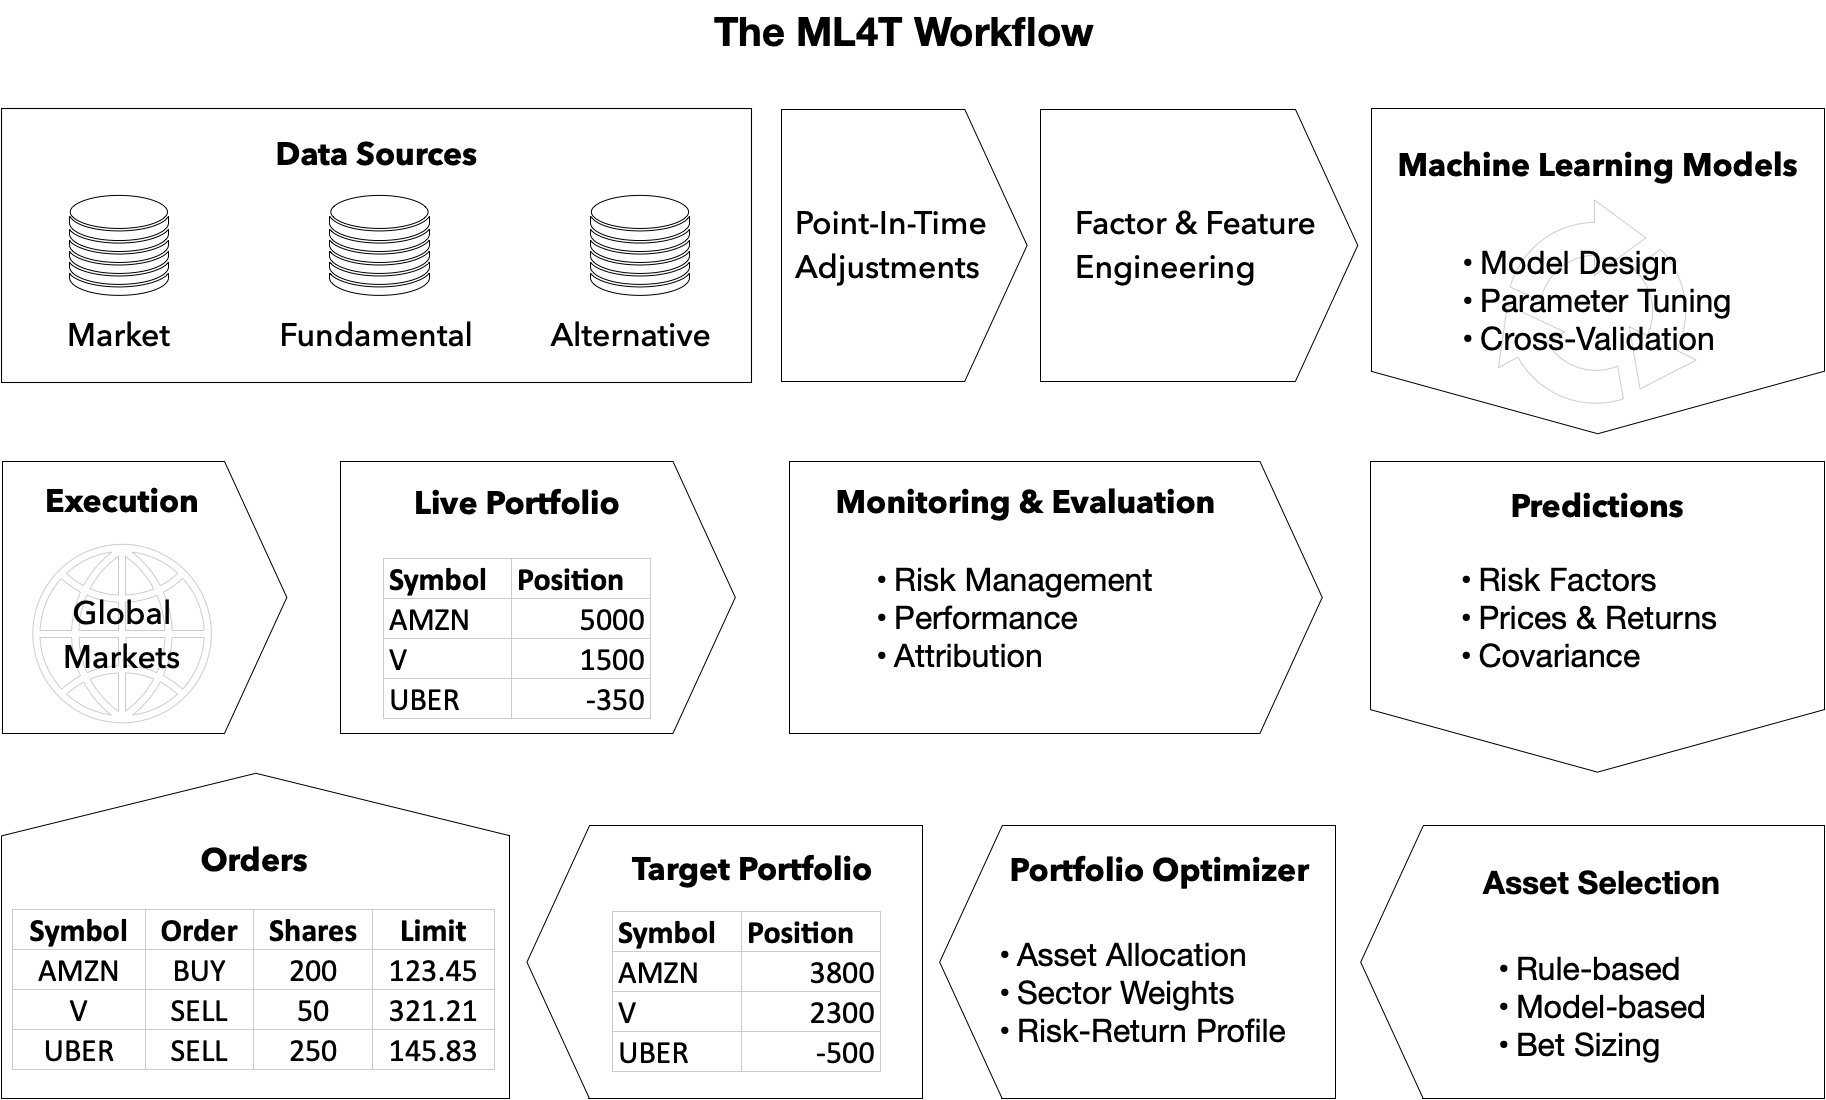
第二版对 ML4T 工作流的强调体现在新增的策略回测章节、一个新的附录(描述了超过 100 个不同的 alpha 因子),以及许多新的实际应用。我们为了清晰和可读性,还重写了大部分现有内容。
交易应用现在使用了更广泛的数据源,不仅限于日频美国股票价格,还包括国际股票和 ETF。它还演示了如何使用 ML 进行基于分钟级股票数据的日内策略。此外,它扩展了另类数据源的覆盖范围,包括用于情感分析和收益预测的 SEC 文件,以及用于土地利用分类的卫星图像。
第二版的另一个创新是复现了近期发表在顶级期刊上的几个交易应用:
- 第 18 章 演示了如何根据 Sezer 和 Ozbahoglu(2018)的方法,将卷积神经网络应用于转换为图像格式的时间序列,以进行收益预测。
- 第 20 章 展示了如何根据 Shihao Gu、Bryan T. Kelly 和 Dacheng Xiu(2019)的 Autoencoder Asset Pricing Models,使用自编码器提取基于股票特征的风险因子进行资产定价。
- 第 21 章 展示了如何根据 Jinsung Yoon、Daniel Jarrett 和 Mihaela van der Schaar(2019)的 Time-series Generative Adversarial Networks,使用生成对抗网络创建合成训练数据。
所有应用现在都使用了写作时可用的最新软件版本,例如 pandas 1.0 和 TensorFlow 2.2。还有一个定制版的 Zipline,使得在设计交易策略时易于包含机器学习模型预测。
安装、数据源和错误报告
代码示例依赖于来自数据科学和金融领域的大量 Python 库。
不必一次性尝试安装所有库,因为这会增加遇到版本冲突的可能性。相反,我们建议你随着学习进度安装特定章节所需的库。
2022 年 3 月更新:
zipline-reloaded、pyfolio-reloaded、alphalens-reloaded和empyrical-reloaded现在在conda-forge频道可用。ml4t频道只包含过时的版本,并将很快删除。
2021 年 4 月更新:随着 Zipline 的更新,不再需要使用 Docker。安装说明现在提到了特定操作系统的环境文件,应该能简化你运行笔记本的过程。
2021 年 2 月更新:代码示例 2.0 版本将 Docker 镜像提供的 conda 环境更新为 Python 3.8、Pandas 1.2 和 TensorFlow 1.2 等;Zipline 回测环境现在使用 Python 3.6。
- 安装目录包含设置和使用 Docker 镜像运行笔记本的详细说明。它还包含了设置各种
conda环境并在你的机器上直接安装笔记本所用包的配置文件(如果你喜欢,并且根据你的系统,愿意付出额外努力)。 - 要下载和预处理本书使用的许多数据源,请参见 data 目录中各个笔记本旁边的 README 文件中的说明。
如果你在安装环境、下载数据或运行代码时遇到任何困难,请在本仓库中提出 GitHub issue(此处)。使用 GitHub issues 的方法已在此描述。
更新:你可以在此处下载本书中使用的 algoseek 数据。预处理说明见第 2 章,基于梯度提升模型的日内示例见第 12 章。
更新:figures 目录包含本书中使用图表的彩色版本。
大纲与章节摘要
这本书分为四个部分,分别解决在获取和处理市场、基本面及另类数据、开发交易背景下各种预测任务的 ML 解决方案,以及设计和评估依赖 ML 模型生成的预测信号的交易策略时所面临的不同挑战。
每个章节的目录都包含一个 README,其中提供了内容、代码示例和额外资源的更多信息。
- 06 机器学习过程
- 07 线性模型:从风险因子到收益预测
- 08 ML4T 工作流:从模型到策略回测
- 09 时间序列模型:波动率预测与统计套利
- 10 贝叶斯 ML:动态夏普比率与配对交易
- 11 随机森林:日本股票的多空策略
- 12 提升你的交易策略
- 13 数据驱动的风险因子与无监督学习资产配置
- 17 交易深度学习
- 18 金融时间序列和卫星图像的 CNN
- 19 多变量时间序列和情感分析的 RNN
- 20 条件风险因子和资产定价的自编码器
- 21 合成时间序列数据的生成对抗网络
- 22 深度强化学习:构建交易智能体
- 23 结论与下一步
- 24 附录 - Alpha 因子库
第一部分:从数据到策略开发
第一部分提供了开发由机器学习驱动的交易策略的框架。它聚焦于本书中讨论的为 ML 算法和策略提供动力的数据,概述了如何设计和评估适合 ML 模型的特征,以及如何在执行交易策略的同时管理和衡量投资组合的表现。
01 机器学习交易:从想法到执行
本章探讨了导致 ML 成为投资行业竞争优势来源的行业趋势。我们还将研究 ML 如何融入投资过程以实现算法交易策略。
更具体地说,它涵盖以下主题:
- ML 在投资行业中兴起的关键趋势
- 利用 ML 的交易策略的设计与执行
- ML 在交易中的流行用例
02 市场与基本面数据:来源与技术
本章展示了如何处理市场和基本面数据,并描述了它们所反映环境的关键方面。例如,熟悉各种订单类型和交易基础设施不仅对数据解释很重要,而且对正确设计回测模拟也很重要。我们还演示了如何使用 Python 访问和操作交易及财务报表数据。
实际示例演示了如何使用来自 NASDAQ tick 数据的交易数据和具有丰富属性的 Algoseek 分钟级数据(捕捉供需动态),我们稍后将用这些数据构建基于 ML 的日内策略。我们还涵盖了各种数据提供商的 API 以及如何从 SEC 获取财务报表信息。
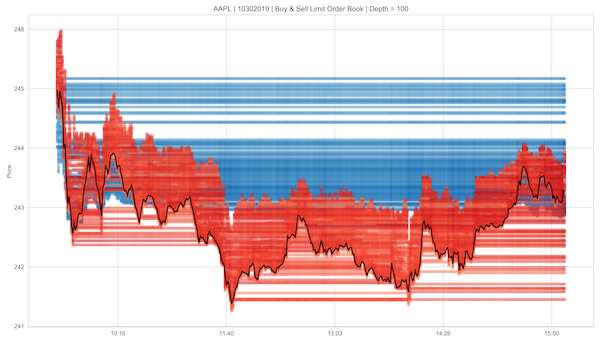
- 市场数据如何反映交易环境的结构
- 处理分钟频率的日内交易和报价数据
- 使用 NASDAQ ITCH 从 tick 数据重建限价订单簿
- 使用各种类型的 bar 汇总 tick 数据
- 处理以 XBRL 编码的电子文件
- 解析和组合市场与基本面数据以创建市盈率序列
- 如何使用 Python 访问各种市场与基本面数据源
03 金融另类数据:类别与用例
本章概述了另类数据的类别和用例,描述了评估数量激增的来源和提供者的标准,并总结了当前市场格局。
它还演示了如何通过抓取网站来创建另类数据集,例如收集财报电话会议记录,以便在本书第三部分与自然语言处理(NLP)和情感分析算法一起使用。
更具体地说,本章涵盖:
- 在另类数据革命中出现了哪些新的信号源
- 个人、企业和传感器如何生成多样化的另类数据
- 另类数据的重要类别和提供者
- 评估新兴的另类数据供应如何用于交易
- 在 Python 中处理另类数据,例如通过互联网抓取
04 金融特征工程:如何研究 Alpha 因子
如果你已经熟悉 ML,你就知道特征工程是成功预测的关键因素。在交易领域,这一点同样重要,学术和行业研究人员数十年来一直在研究是什么驱动资产市场和价格,以及哪些特征有助于解释或预测价格变动。
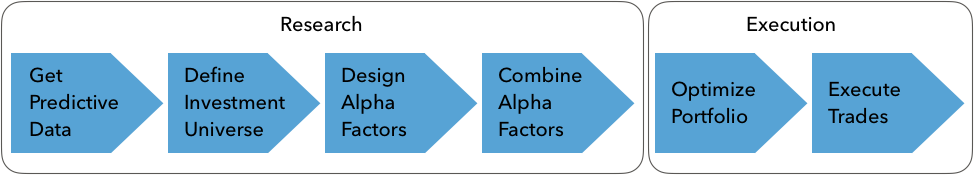
本章概述了这项研究的主要收获,作为你自己寻找 alpha 因子的起点。它还介绍了计算和测试 alpha 因子的基本工具,重点介绍了 NumPy、pandas 和 TA-Lib 库如何促进数据操作,并介绍了流行的平滑技术(如小波和卡尔曼滤波器)如何帮助减少数据噪声。阅读后,你将了解:
- 因子的类别有哪些,它们为何有效,以及如何衡量它们,
- 使用 NumPy、pandas 和 TA-Lib 创建 alpha 因子,
- 如何使用小波和卡尔曼滤波器去噪数据,
- 使用 Zipline 测试单个和多个 alpha 因子,
- 如何使用 Alphalens 评估预测性能。
05 投资组合优化与绩效评估
Alpha 因子产生信号,算法策略将这些信号转化为交易,进而产生多头和空头头寸。由此产生的投资组合的收益和风险决定了该策略是否满足投资目标。
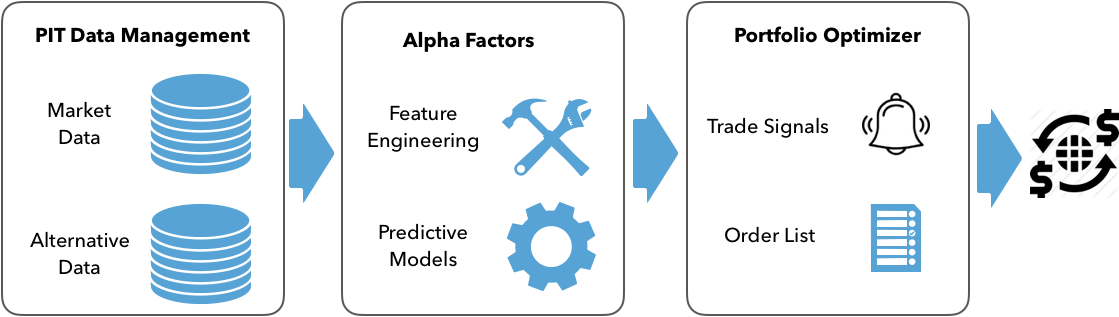
有几种优化投资组合的方法。其中包括应用机器学习来学习资产之间的层级关系,并在设计投资组合的风险状况时将它们视为互补品或替代品。本章涵盖:
- 如何衡量投资组合风险和收益
- 使用均值方差优化及其替代方案管理投资组合权重
- 使用机器学习优化投资组合背景下的资产配置
- 使用 Zipline 模拟交易并基于 alpha 因子创建投资组合
- 如何使用 pyfolio 评估投资组合绩效
第二部分:机器学习交易:基础
第二部分介绍了基本的监督和无监督学习算法,并说明了它们在交易策略中的应用。它还介绍了 Quantopian 平台,该平台允许你利用和组合本书中开发的数据和 ML 技术,在实时市场中执行算法策略。
06 机器学习过程
本章开启了第二部分,该部分说明了你如何使用一系列监督和无监督 ML 模型进行交易。在演示使用各种 Python 库的相关应用之前,我们将解释每个模型的假设和用例。
许多这些模型及其应用有几个共同方面。本章涵盖这些共同方面,以便我们能够在后续章节中专注于特定模型的使用。它通过概述如何将制定、训练、调优和评估 ML 模型的预测性能作为系统化工作流来奠定基础。内容包括:
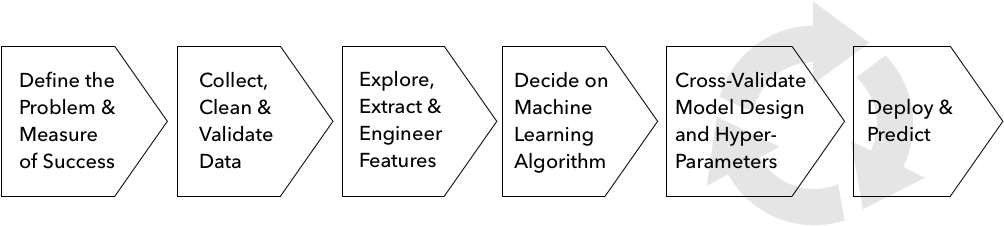
- 监督和无监督学习如何从数据中工作
- 训练和评估用于回归和分类任务的监督学习模型
- 偏差-方差权衡如何影响预测性能
- 如何诊断和解决由过拟合引起的预测误差
- 使用交叉验证优化超参数,重点关注时间序列数据
- 为什么金融数据在测试样本外时需要额外关注
07 线性模型:从风险因子到收益预测
线性模型是回归和分类背景下推理和预测的标准工具。许多广泛使用的资产定价模型依赖于线性回归。Ridge 和 Lasso 回归等正则化模型通过限制过拟合风险,通常能产生更好的预测。典型的回归应用识别驱动资产收益的风险因子,以管理风险或预测收益。另一方面,分类问题包括方向性价格预测。
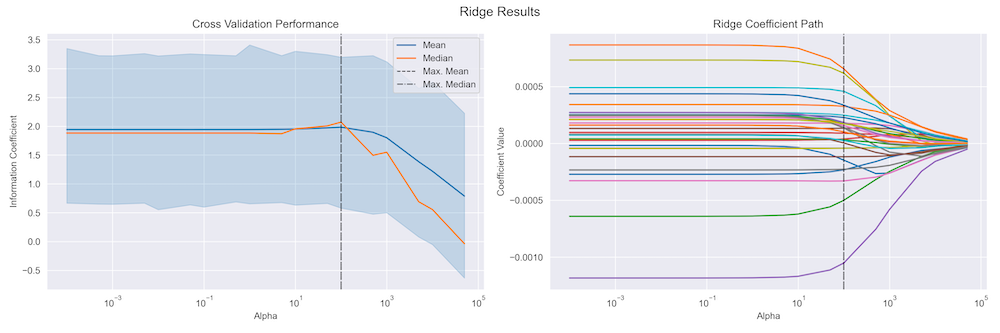
第 07 章涵盖以下主题:
- 线性回归如何工作,它做出了哪些假设
- 训练和诊断线性回归模型
- 使用线性回归预测股票收益
- 使用正则化提高预测性能
- 逻辑回归如何工作
- 将回归问题转化为分类问题
08 ML4T 工作流:从模型到策略回测
本章提供了设计、模拟和评估由 ML 算法驱动的交易策略的端到端视角。 我们将详细演示如何使用 Python 库 backtrader 和 Zipline 在历史市场背景下回测 ML 驱动的策略。 ML4T 工作流最终旨在从历史数据中收集证据,帮助决定是否将候选策略部署到实时市场中并承担财务风险。策略的真实模拟需要忠实地再现证券市场如何运作以及交易如何执行。此外,需要关注几个方法论方面,以避免导致错误投资决策的偏见结果和虚假发现。
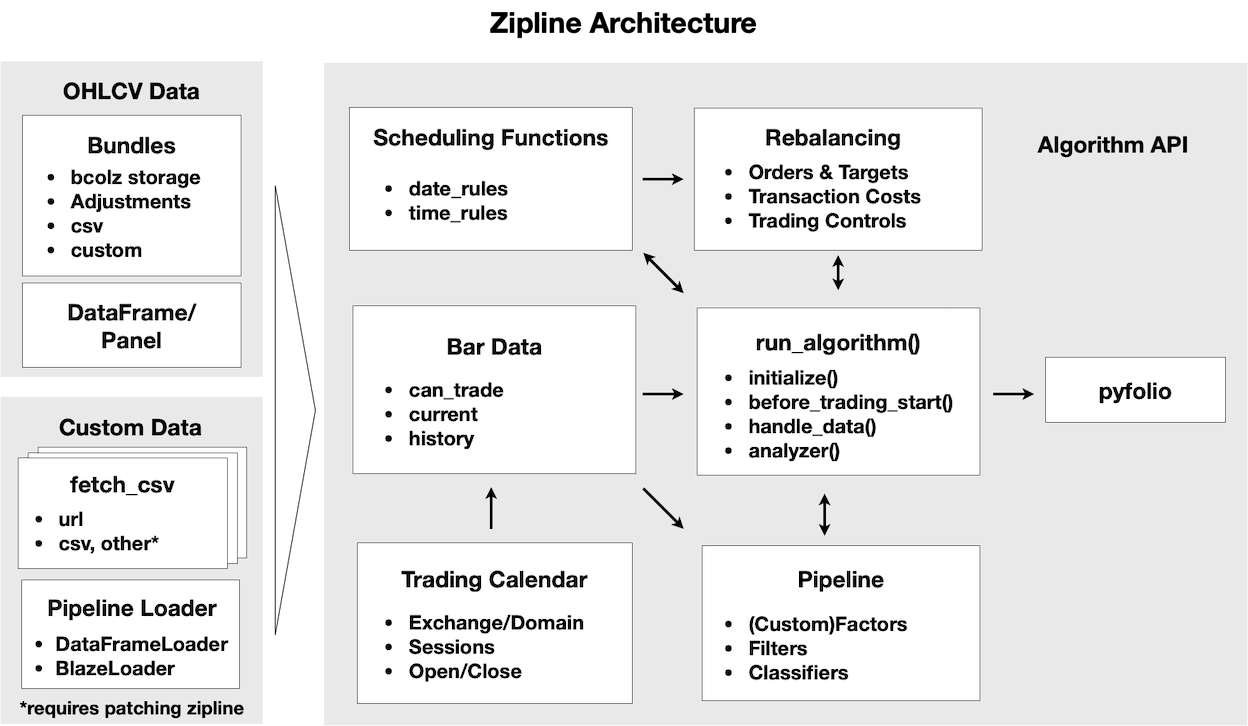
更具体地说,完成本章后,你将能够:
- 规划并实现端到端策略回测
- 理解并避免执行回测时的关键陷阱
- 讨论向量化与事件驱动回测引擎的优缺点
- 识别和评估事件驱动回测器的关键组件
- 使用分钟和每日频率的数据源设计并执行 ML4T 工作流,ML 模型可以单独训练或作为回测的一部分
- 使用 Zipline 和 backtrader 设计和评估你自己的策略
09 时间序列模型:波动率预测与统计套利
本章专注于从时间序列的历史中提取信号以预测同一时间序列未来值的模型。 由于交易固有的时间维度,时间序列模型被广泛使用。它介绍了诊断时间序列特征(如平稳性)和提取捕捉潜在有用模式的特征的工具。它还介绍了单变量和多变量时间序列模型,用于预测宏观数据和波动率模式。 最后,它解释了协整如何识别时间序列之间的共同趋势,并展示了如何基于这一关键概念开发配对交易策略。
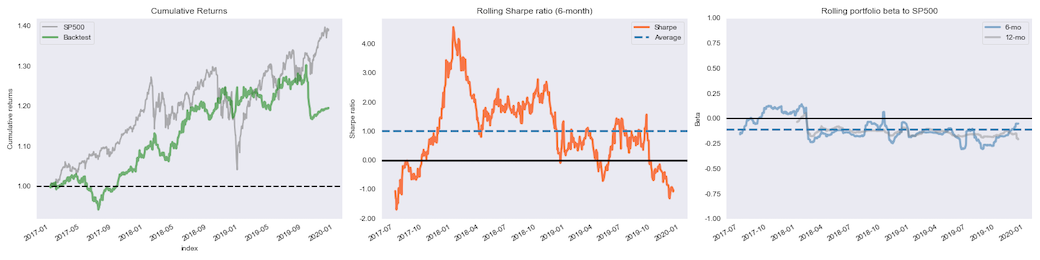
特别是,它涵盖:
- 如何使用时间序列分析来准备和指导建模过程
- 估计和诊断单变量自回归和移动平均模型
- 构建自回归条件异方差(ARCH)模型以预测波动率
- 如何构建多变量向量自回归模型
- 使用协整开发配对交易策略
10 贝叶斯 ML:动态夏普比率与配对交易
贝叶斯统计允许我们量化未来事件的不确定性,并以原则性的方式随着新信息的到来更新估计。这种动态方法很好地适应了金融市场不断演变的性质。 ML 的贝叶斯方法使我们能够对统计指标、参数估计和预测的不确定性获得新的见解。其应用范围从更细粒度的风险管理到结合市场环境变化的预测模型的动态更新。
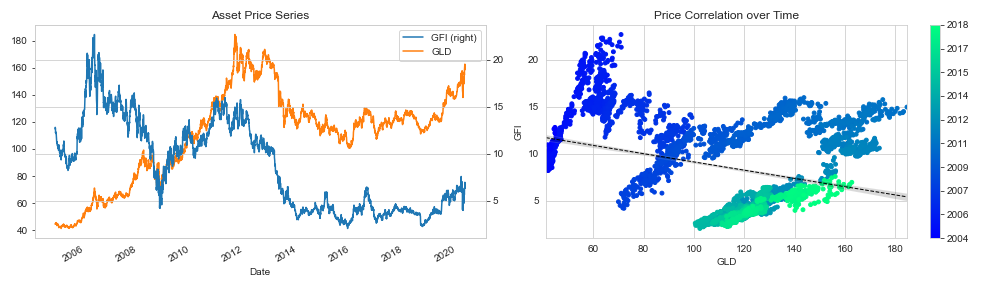
更具体地说,本章涵盖:
- 贝叶斯统计如何应用于机器学习
- 使用 PyMC3 进行概率编程
- 使用 PyMC3 定义和训练机器学习模型
- 如何运行最先进的采样方法进行近似推理
- 贝叶斯 ML 应用:计算动态夏普比率、动态配对交易对冲比率和估计随机波动率
11 随机森林:日本股票的多空策略
本章将决策树和随机森林应用于交易。决策树从数据中学习规则,这些规则编码非线性输入输出关系。我们展示了如何训练决策树来预测回归和分类问题,可视化和解释模型学到的规则,以及调整模型的超参数以优化偏差-方差权衡并防止过拟合。
本章第二部分引入了集成模型,这些模型以随机方式组合多个决策树以产生一个误差更低的单一预测。最后,它基于随机森林模型生成的交易信号,提出了日本股票的多空策略。
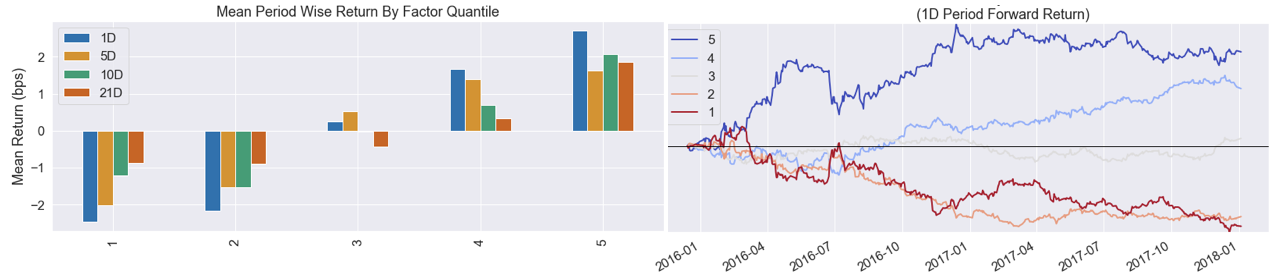
简而言之,本章涵盖:
- 使用决策树进行回归和分类
- 从决策树中获取见解并可视化从数据中学到的规则
- 理解为什么集成模型往往能产生更优的结果
- 使用 bootstrap aggregating 解决决策树的过拟合挑战
- 训练、调优和解释随机森林
- 使用随机森林设计和评估一个盈利的交易策略
12 提升你的交易策略
梯度提升是另一种基于树的集成算法,通常能产生比随机森林更好的结果。关键区别在于,提升根据模型累积的误差修改用于训练每棵树的数据。随机森林使用随机数据子集独立训练许多树,而提升则是顺序进行并重新加权数据。 本章展示了最先进的库如何实现令人印象深刻的性能,并将提升应用于日频和高频数据,以回测日内交易策略。
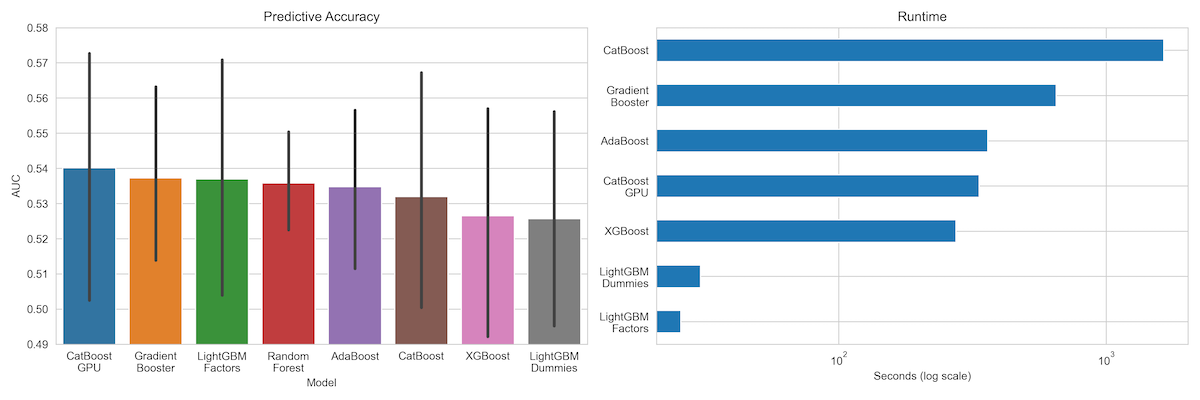
更具体地说,我们将涵盖以下主题:
- 提升与 bagging 有何不同,以及梯度提升如何从自适应提升演变而来,
- 使用 scikit-learn 设计和调优自适应与梯度提升模型,
- 使用最先进的实现 XGBoost、LightGBM 和 CatBoost 在大型数据集上构建、优化和评估梯度提升模型,
- 使用 SHAP 值解释和从梯度提升模型中获取见解,
- 使用高频数据结合提升来设计日内策略。
13 数据驱动的风险因子与无监督学习资产配置
降维和聚类是无监督学习的主要任务:
- 降维在最小化信息损失的同时,将现有特征转换为新的、更小的集合。存在广泛的算法,它们通过衡量信息损失的方式、是否应用线性或非线性变换、或对新特征集施加的约束来区分。
- 聚类算法识别并对相似观测值或特征进行分组,而不是识别新特征。算法在如何定义观测值的相似性及其对结果组的假设上有所不同。
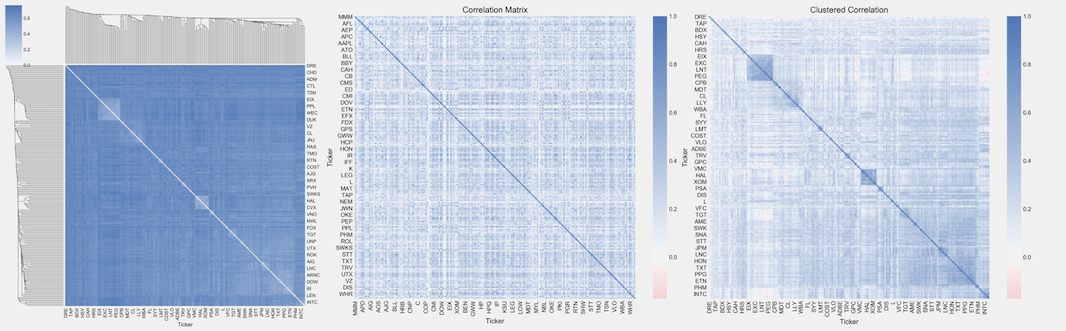
更具体地说,本章涵盖:
- 主成分分析和独立成分分析(PCA 和 ICA)如何进行线性降维
- 使用 PCA 从资产收益中识别数据驱动的风险因子和特征投资组合
- 使用流形学习有效可视化非线性高维数据
- 使用 T-SNE 和 UMAP 探索高维图像数据
- k 均值、层次和基于密度的聚类算法如何工作
- 使用凝聚聚类通过层次风险平价构建稳健的投资组合
第三部分:交易中的自然语言处理
文本数据内容丰富,但格式非结构化,因此需要更多预处理,以便机器学习算法能够提取潜在的信号。关键挑战在于将文本转换为算法可用的数值格式,同时表达内容的语义。
接下来的三章涵盖了捕捉人类易于理解的语言细微差别的几种技术,以便机器学习算法也能解释它们。
14 文本数据交易:情感分析
文本数据内容非常丰富,但高度非结构化,因此需要更多预处理才能让 ML 算法提取相关信息。关键挑战在于将文本转换为数值格式而不丢失其含义。 本章展示了如何通过创建文档-词项矩阵来将文档表示为词频向量,该矩阵又作为文本分类和情感分析的输入。它还介绍了朴素贝叶斯算法,并将其性能与线性和基于树的模型进行了比较。
特别是,本章涵盖:
- 基本的 NLP 工作流是什么样的
- 如何使用 spaCy 和 TextBlob 构建多语言特征提取流水线
- 执行 NLP 任务,如词性标注或命名实体识别
- 使用文档-词项矩阵将词元转换为数字
- 使用朴素贝叶斯模型对新闻进行分类
- 如何使用不同的 ML 算法进行情感分析
15 主题建模:总结金融新闻
本章使用无监督学习对潜在主题进行建模,并从文档中提取隐藏的主题。这些主题可以对大量金融报告语料库产生详细的见解。 主题模型自动化了复杂、可解释的文本特征创建,这些特征反过来可以帮助从大量的文本集合中提取交易信号。它们加快了文档审查速度,实现了相似文档的聚类,并生成了对预测建模有用的注释。 应用包括识别公司披露、财报电话会议记录或合同中的关键主题,以及基于情感分析或相关资产收益的注释。
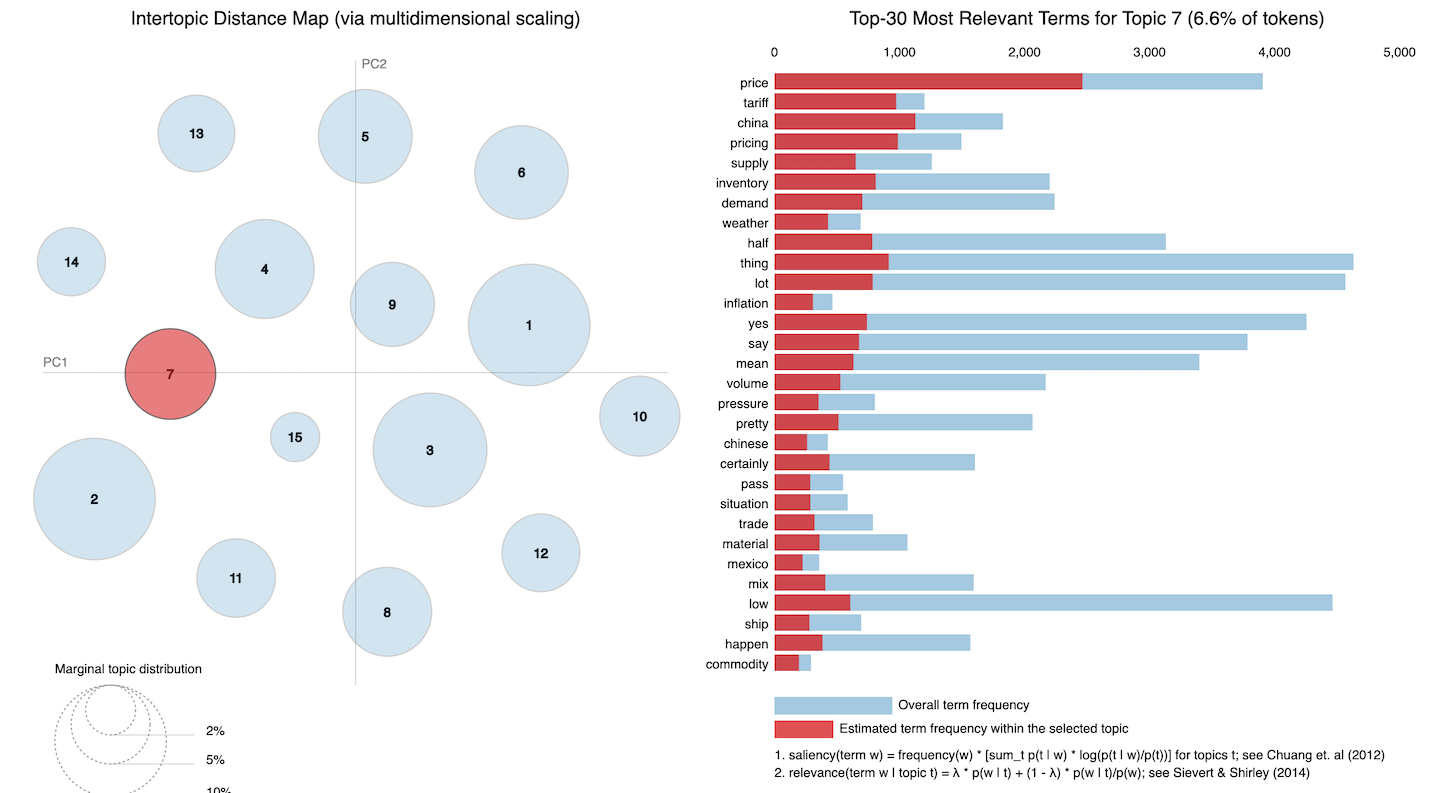
更具体地说,它涵盖:
- 主题建模如何演变,它实现了什么,以及为什么重要
- 使用潜在语义索引降低 DTM 的维度
- 使用概率潜在语义分析(pLSA)提取主题
- 潜在狄利克雷分配(LDA)如何改进 pLSA 成为最流行的主题模型
- 可视化和评估主题建模结果
- 使用 scikit-learn 和 gensim 运行 LDA
- 如何将主题建模应用于财报电话会议和金融新闻文章的集合
16 财报电话会议和 SEC 文件的词嵌入
本章使用神经网络来学习单个语义单元(如词或段落)的向量表示。这些向量是密集的,有几百个实数值条目,而词袋模型的向量是高维稀疏的。因此,这些向量将每个语义单元嵌入或定位到一个连续的向量空间中。
嵌入是通过训练一个模型将标记与上下文关联起来的结果,其好处是相似的用法意味着相似的向量。因此,它们通过相对位置编码了词语关系等语义方面。它们是强大的特征,我们将在后续章节中与深度学习模型一起使用。
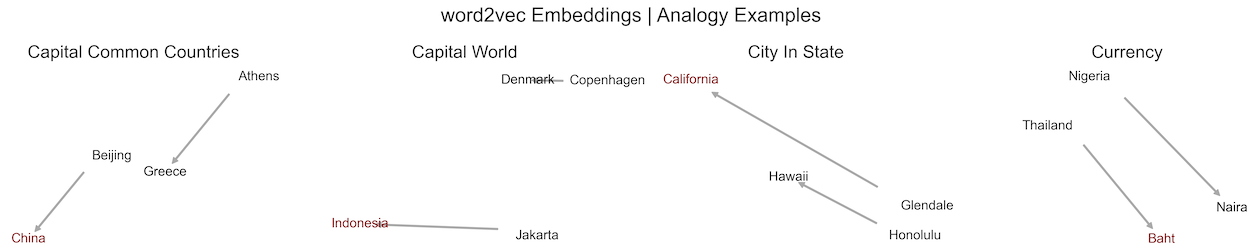
更具体地说,在本章中,我们将涵盖:
- 什么是词嵌入,以及它们如何捕获语义信息
- 如何获取和使用预训练的词向量
- 哪些网络架构在训练 word2vec 模型时最有效