Kronos

金融K线(OHLCV)基础模型,首次开源针对K线序列的decoder-only Transformer,将行情数据量化为离散token后预训练。支持从45+交易所获取数据,提供多种规模预训练权重和微调脚本,可用于预测、回测等量化任务。亮点在于专为金融高噪声场景设计的tokenizer和预训练框架,已入选AAAI 2026。注意:项目为研究演示,非生产级量化系统。
README
Kronos:金融市场语言的基础模型



 Deutsch |
Español |
Français |
日本語 |
한국어 |
Português |
Русский |
中文
Kronos 是首个开源的基础模型,专为金融 K 线(K-line)数据设计, 基于来自 45 个以上全球交易所的数据训练而成。
📰 新闻
- 🚩 [2025.11.10] Kronos 被 AAAI 2026 接收。
- 🚩 [2025.08.17] 我们发布了微调脚本!请查看它们,将 Kronos 适应到你自己的任务中。
- 🚩 [2025.08.02] 我们的论文现已在 arXiv 上发布!
📜 引言
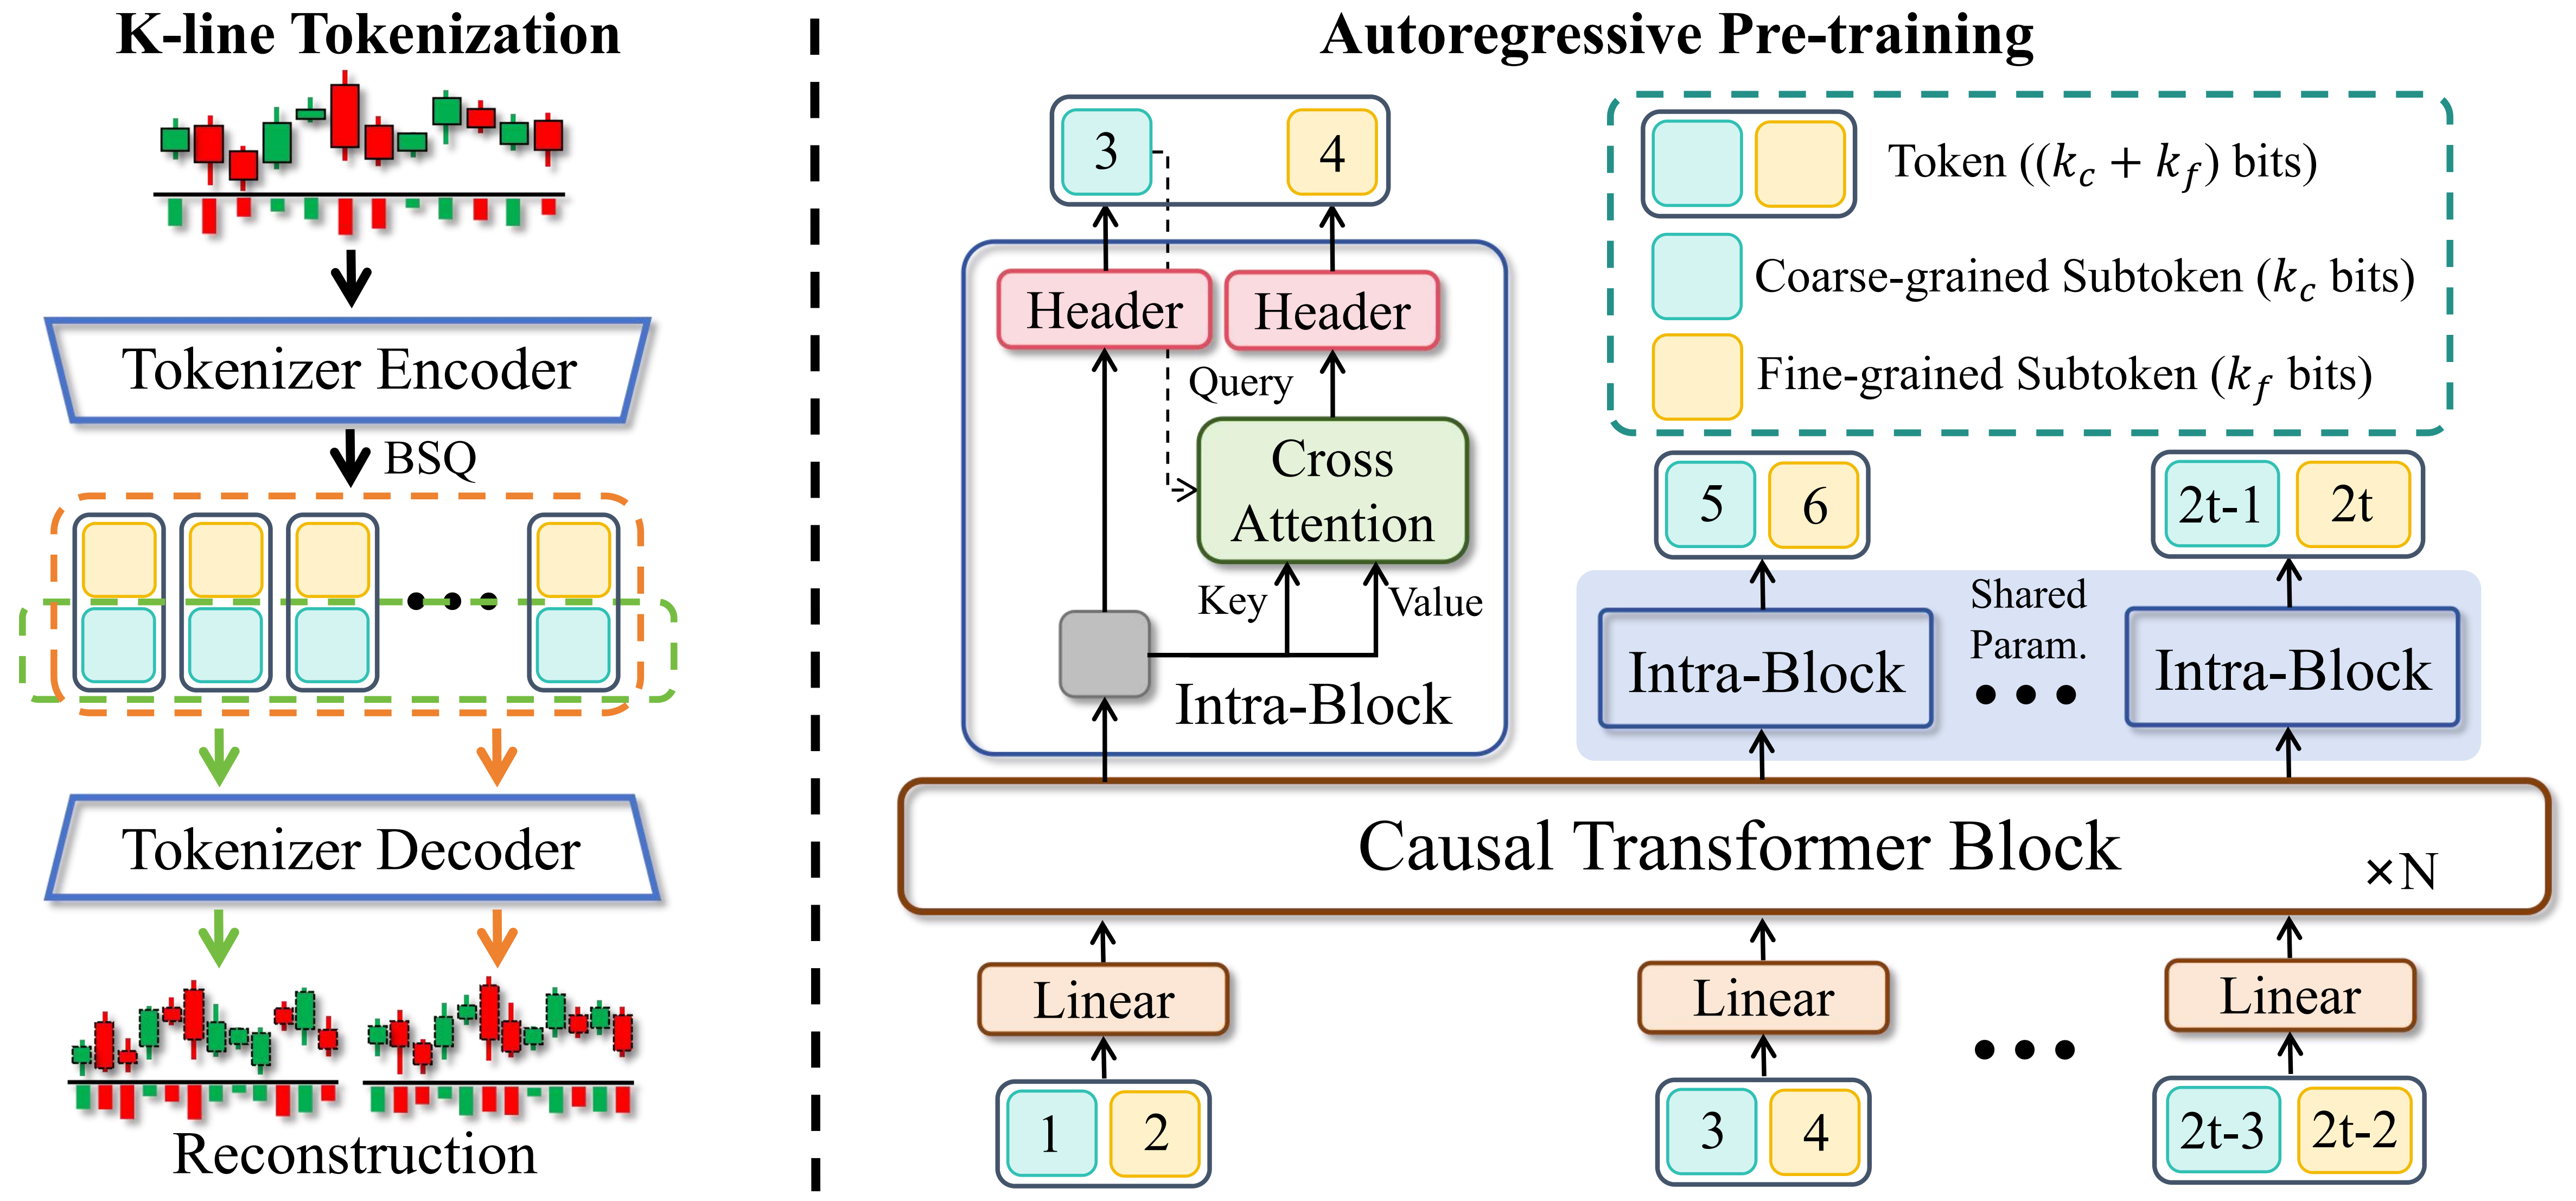
Kronos 是一系列仅解码器(decoder-only)的基础模型,专门为金融市场的“语言”——K 线序列——进行预训练。与通用的时间序列基础模型(TSFM)不同,Kronos 旨在处理金融数据独特的高噪声特性。它采用了一种新颖的两阶段框架:
- 一个专门的 tokenizer 首先将连续的多维 K 线数据(OHLCV)量化为层次化离散 tokens。
- 然后,一个大型自回归 Transformer 对这些 tokens 进行预训练,使其能够作为统一模型服务于多种量化任务。
✨ 在线演示
我们搭建了一个在线演示,直观展示 Kronos 的预测结果。该网页展示了 BTC/USDT 交易对在未来 24 小时的预测。
👉 访问在线演示
📦 模型动物园
我们发布了一系列具有不同容量的预训练模型,以满足不同的计算和应用需求。所有模型均可直接从 Hugging Face Hub 获取。
| 模型 | Tokenizer | 上下文长度 | 参数量 | 开源 |
|---|---|---|---|---|
| Kronos-mini | Kronos-Tokenizer-2k | 2048 | 4.1M | ✅ NeoQuasar/Kronos-mini |
| Kronos-small | Kronos-Tokenizer-base | 512 | 24.7M | ✅ NeoQuasar/Kronos-small |
| Kronos-base | Kronos-Tokenizer-base | 512 | 102.3M | ✅ NeoQuasar/Kronos-base |
| Kronos-large | Kronos-Tokenizer-base | 512 | 499.2M | ❌ |
🚀 快速开始
安装
- 安装 Python 3.10+,然后安装依赖:
pip install -r requirements.txt
📈 进行预测
使用 KronosPredictor 类可以轻松地用 Kronos 进行预测。它处理数据预处理、归一化、预测和逆归一化,让你只需几行代码就能从原始数据得到预测结果。
重要提示:Kronos-small 和 Kronos-base 的 max_context 为 512。这是模型能处理的最大序列长度。为了获得最佳性能,建议你的输入数据长度(即 lookback)不超过此限制。KronosPredictor 会自动处理较长上下文的截断。
以下是进行首次预测的分步指南。
1. 加载 Tokenizer 和模型
首先,从 Hugging Face Hub 加载预训练的 Kronos 模型及其对应的 tokenizer。
from model import Kronos, KronosTokenizer, KronosPredictor

# 从 Hugging Face Hub 加载
tokenizer = KronosTokenizer.from_pretrained("NeoQuasar/Kronos-Tokenizer-base")
model = Kronos.from_pretrained("NeoQuasar/Kronos-small")
2. 实例化预测器
创建 KronosPredictor 的实例,传入模型、tokenizer 和目标设备。
# 初始化预测器
predictor = KronosPredictor(model, tokenizer, max_context=512)
3. 准备输入数据
predict 方法需要三个主要输入:
df:包含历史 K 线数据的 pandas DataFrame。必须包含列['open', 'high', 'low', 'close']。volume(成交量)和amount(成交额)是可选的。x_timestamp:对应df中历史数据的 pandas Series 时间戳。y_timestamp:待预测的未来时段的 pandas Series 时间戳。
import pandas as pd

# 加载你的数据
df = pd.read_csv("./data/XSHG_5min_600977.csv")
df['timestamps'] = pd.to_datetime(df['timestamps'])

# 定义上下文窗口和预测长度
lookback = 400
pred_len = 120

# 准备预测器输入
x_df = df.loc[:lookback-1, ['open', 'high', 'low', 'close', 'volume', 'amount']]
x_timestamp = df.loc[:lookback-1, 'timestamps']
y_timestamp = df.loc[lookback:lookback+pred_len-1, 'timestamps']
4. 生成预测
调用 predict 方法生成预测。你可以使用 T、top_p 和 sample_count 等参数控制采样过程,实现概率预测。
# 生成预测
pred_df = predictor.predict(
    df=x_df,
    x_timestamp=x_timestamp,
    y_timestamp=y_timestamp,
    pred_len=pred_len,
    T=1.0,          # 采样温度
    top_p=0.9,      # Nucleus 采样概率
    sample_count=1  # 生成并取平均的预测路径数量
)

print("预测数据头部:")
print(pred_df.head())
predict 方法返回一个 pandas DataFrame,包含 open、high、low、close、volume 和 amount 的预测值,索引为你提供的 y_timestamp。
为了高效处理多个时间序列,Kronos 提供了 predict_batch 方法,能够同时对多个数据集进行并行预测。当需要一次性预测多个资产或多个时间段时,这特别有用。
# 准备多个数据集进行批量预测
df_list = [df1, df2, df3]  # DataFrame 列表
x_timestamp_list = [x_ts1, x_ts2, x_ts3]  # 历史时间戳列表
y_timestamp_list = [y_ts1, y_ts2, y_ts3]  # 未来时间戳列表

# 生成批量预测
pred_df_list = predictor.predict_batch(
    df_list=df_list,
    x_timestamp_list=x_timestamp_list,
    y_timestamp_list=y_timestamp_list,
    pred_len=pred_len,
    T=1.0,
    top_p=0.9,
    sample_count=1,
    verbose=True
)

# pred_df_list 包含与输入顺序一致的预测结果
for i, pred_df in enumerate(pred_df_list):
    print(f"序列 {i} 的预测结果:")
    print(pred_df.head())
批量预测的重要要求:
- 所有序列必须具有相同的历史长度(lookback 窗口)
- 所有序列必须具有相同的预测长度(
pred_len) - 每个 DataFrame 必须包含所需列:
['open', 'high', 'low', 'close'] volume和amount列是可选的,如果缺失则填充为 0
predict_batch 方法利用 GPU 并行性实现高效处理,并自动为每个序列独立进行归一化和逆归一化。
5. 示例与可视化
有关完整的可运行脚本,包括数据加载、预测和绘图,请参阅 examples/prediction_example.py。
运行此脚本将生成一个图表,将真实数据与模型预测进行比较,如下图所示:
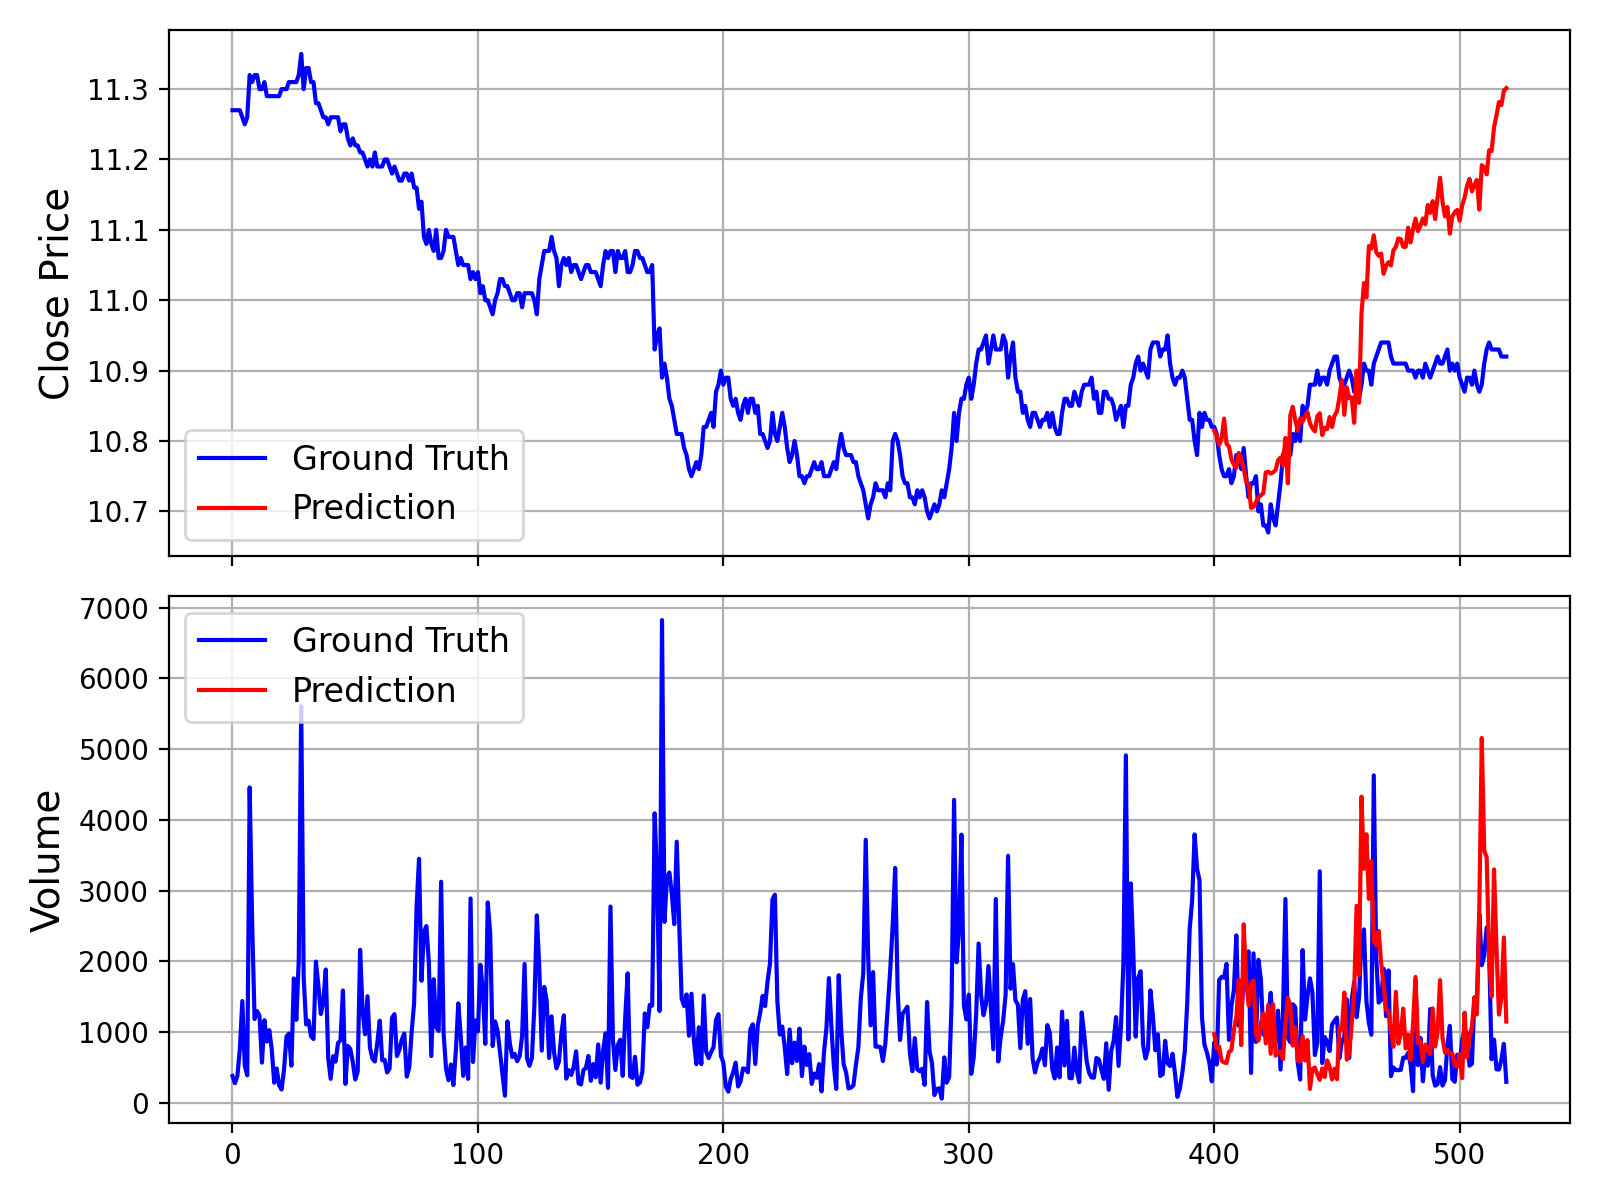
此外,我们还提供了一个在没有成交量(Volume)和成交额(Amount)数据的情况下进行预测的脚本,可在 examples/prediction_wo_vol_example.py 中找到。
🔧 在自己的数据上微调(A 股市场示例)
我们提供了一个完整的流程,用于在自己的数据集上微调 Kronos。作为示例,我们演示如何使用 Qlib 准备中国 A 股市场的数据并进行简单的回测。
免责声明: 此流程旨在作为演示,说明微调过程。它是一个简化的示例,并非生产级的量化交易系统。一个稳健的量化策略需要更复杂的技术,例如投资组合优化和风险因子中性化,才能获得稳定的 alpha(超额收益)。
微调过程分为四个主要步骤:
- 配置:设置路径和超参数。
- 数据准备:使用 Qlib 处理并拆分数据。
- 模型微调:微调 Tokenizer 和 Predictor 模型。
- 回测:评估微调后模型的性能。
前提条件
- 首先,确保已安装
requirements.txt中的所有依赖。 - 此流程依赖于
qlib。请安装它:pip install pyqlib - 你需要准备 Qlib 数据。请遵循 官方 Qlib 指南 下载并设置本地数据。示例脚本假设你使用的是日频数据。
第一步:配置你的实验
所有关于数据、训练和模型路径的设置都集中在 finetune/config.py 中。在运行任何脚本之前,请根据你的环境修改以下路径:
qlib_data_path:本地 Qlib 数据目录的路径。dataset_path:保存训练/验证/测试 pickle 文件的目录。save_path:保存模型检查点的基础目录。backtest_result_path:保存回测结果的目录。pretrained_tokenizer_path和pretrained_predictor_path:要从中开始的预训练模型的路径(可以是本地路径或 Hugging Face 模型名称)。
你也可以根据具体任务调整其他参数,如 instrument、train_time_range、epochs 和 batch_size。如果你不使用 Comet.ml,请将 use_comet 设置为 False。
第二步:准备数据集
运行数据预处理脚本。该脚本将从你的 Qlib 目录加载原始市场数据,进行处理,拆分为训练集、验证集和测试集,并保存为 pickle 文件。
python finetune/qlib_data_preprocess.py
运行后,你将在配置中 dataset_path 指定的目录中找到 train_data.pkl、val_data.pkl 和 test_data.pkl。
第三步:运行微调
微调过程包括两个阶段:先微调 tokenizer,然后微调 predictor。两个训练脚本都设计为使用 torchrun 进行多 GPU 训练。
3.1 微调 Tokenizer
此步骤使 tokenizer 适应你特定领域的数据分布。
# 将 NUM_GPUS 替换为你希望使用的 GPU 数量(例如 2)
torchrun --standalone --nproc_per_node=NUM_GPUS finetune/train_tokenizer.py
最佳的 tokenizer 检查点将保存在 config.py 中配置的路径下(基于 save_path 和 tokenizer_save_folder_name)。
3.2 微调 Predictor
此步骤微调主 Kronos 模型以进行预测任务。
# 将 NUM_GPUS 替换为你希望使用的 GPU 数量(例如 2)
torchrun --standalone --nproc_per_node=NUM_GPUS finetune/train_predictor.py
最佳的 predictor 检查点将保存在 config.py 中配置的路径下。
第四步:通过回测进行评估
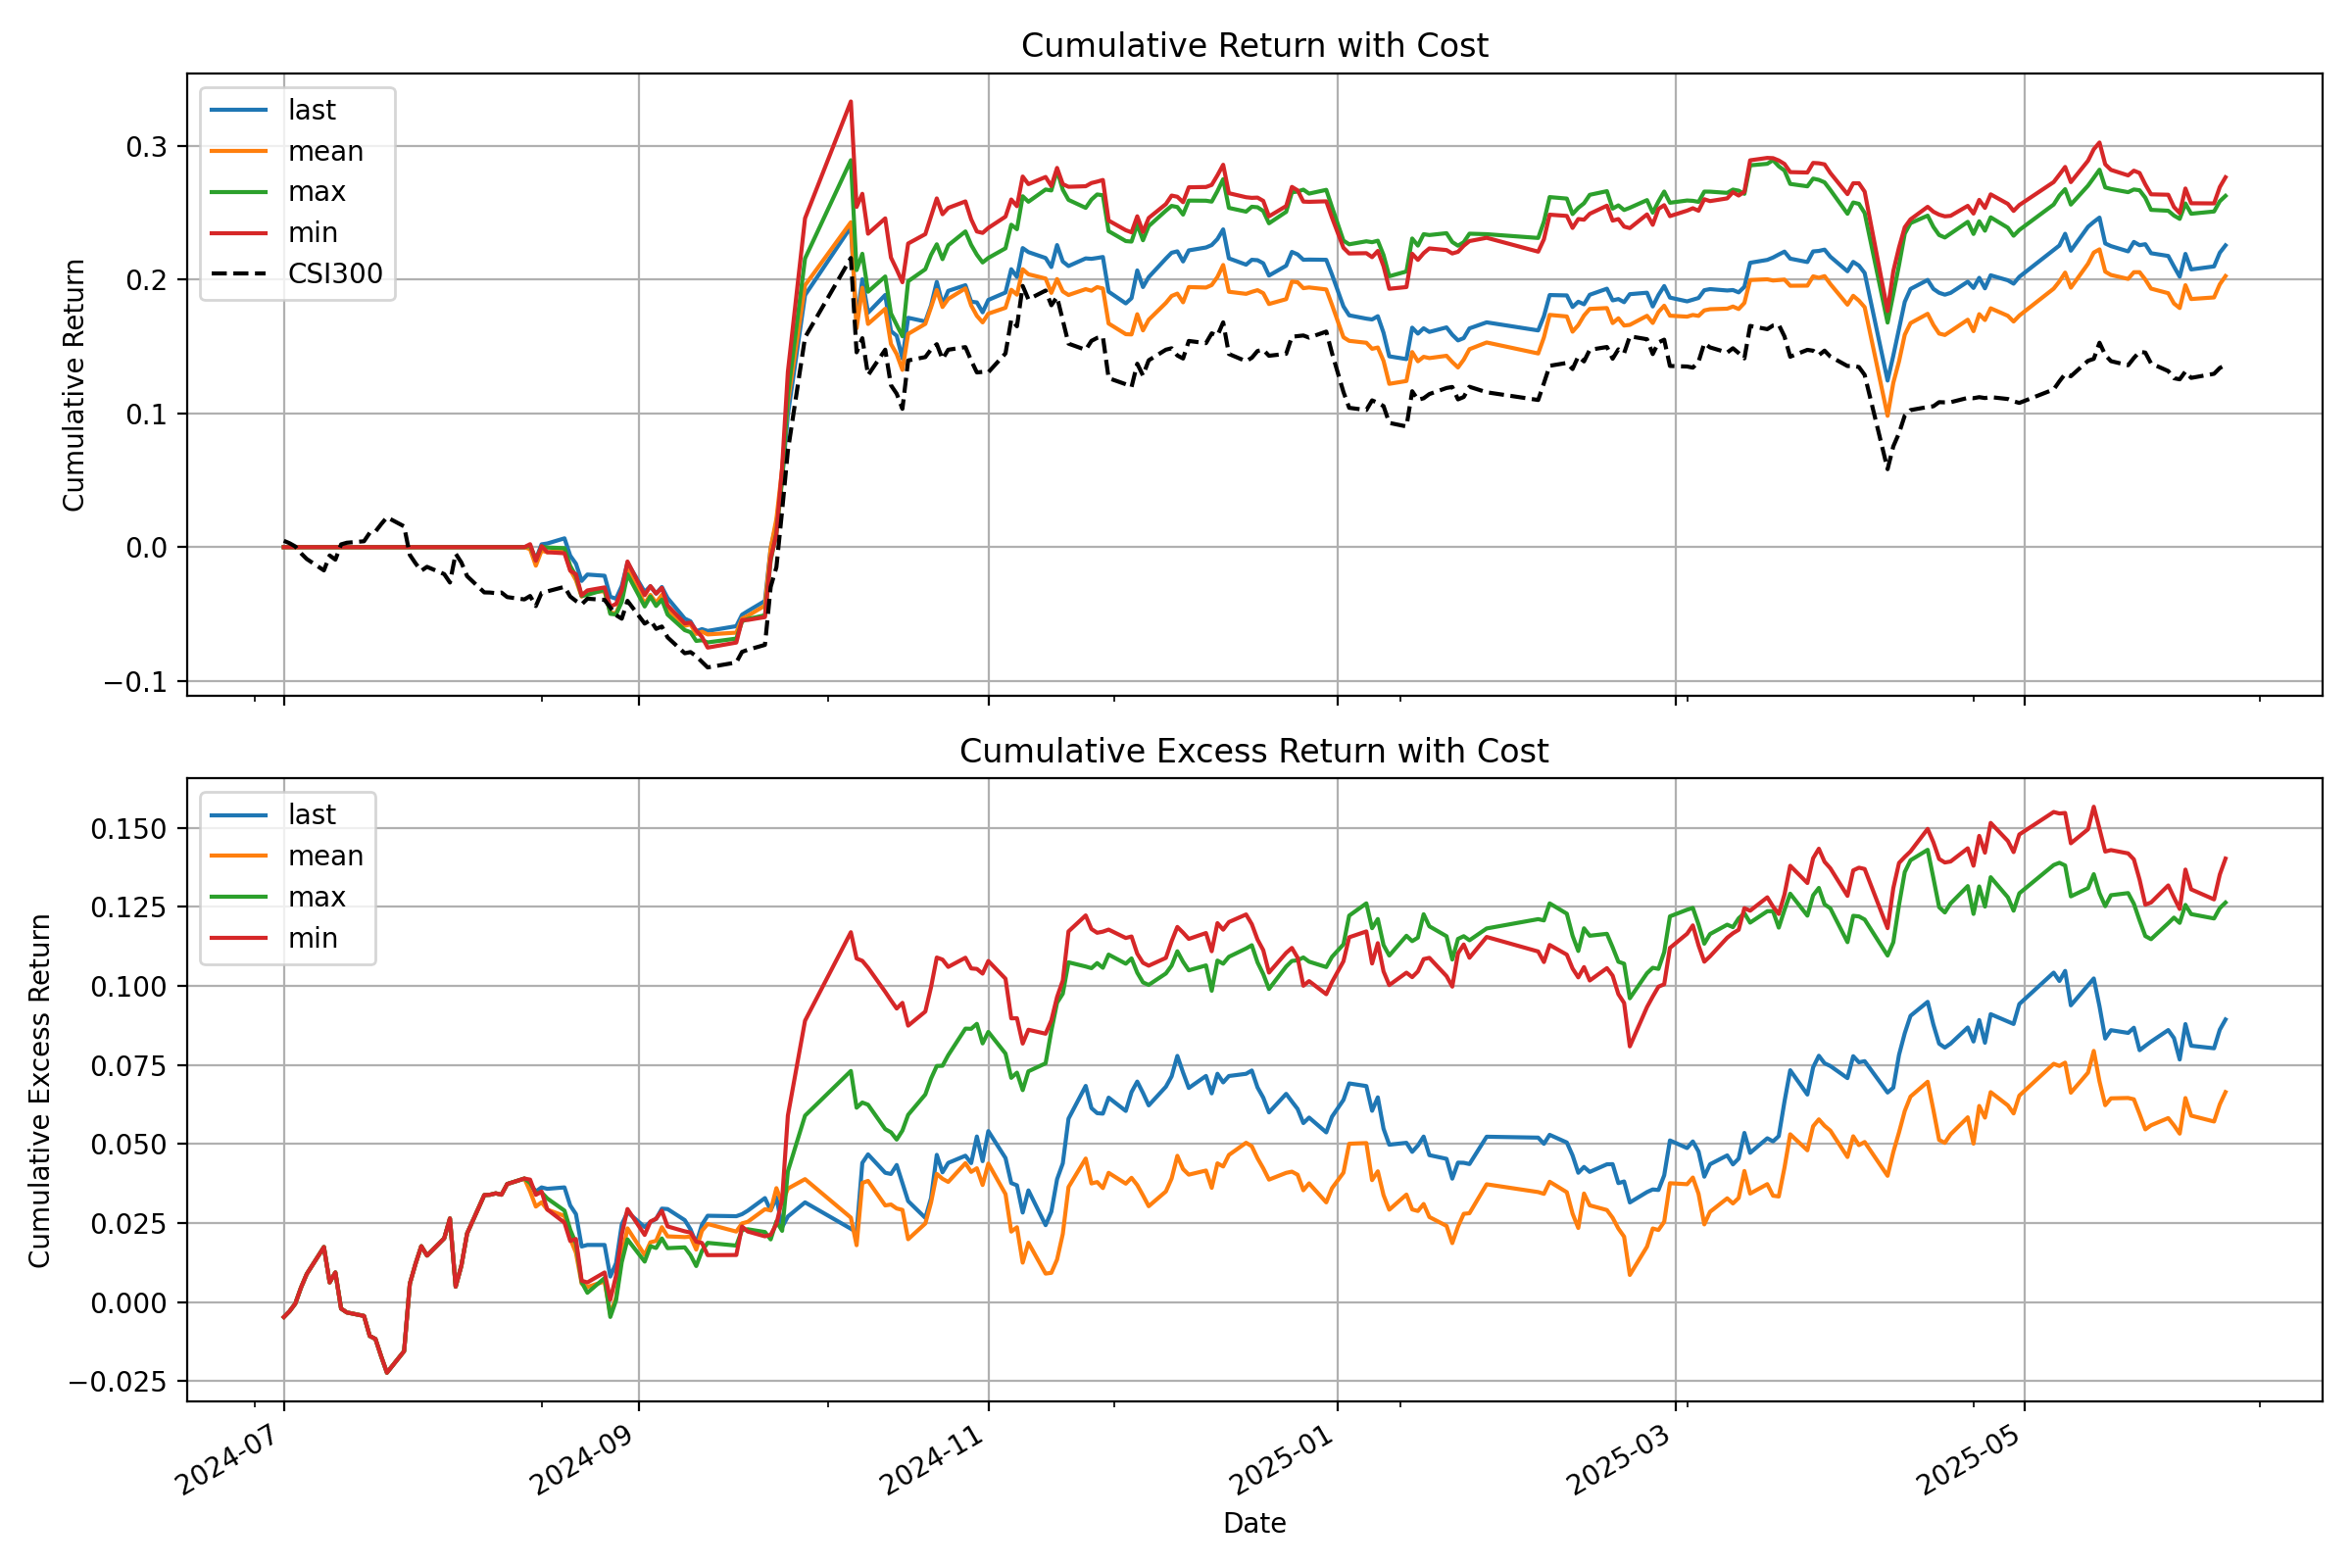
最后,运行回测脚本以评估你微调后的模型。该脚本加载模型,在测试集上进行推断,生成预测信号(例如预测的价格变化),并运行简单的 top-K 策略回测。
# 指定用于推断的 GPU
python finetune/qlib_test.py --device cuda:0
该脚本将在控制台中输出详细的性能分析,并生成一个图表,显示你的策略相对于基准的累计收益曲线,如下图所示:
💡 从演示到生产:重要考虑因素
- 原始信号 vs. 纯 Alpha:此演示中模型生成的信号是原始预测。在现实世界的量化工作流中,这些信号通常会输入到投资组合优化模型中。该模型将应用约束,以中性化常见风险因子(例如市场 beta、规模和价值等风格因子),从而隔离**“纯 Alpha”**,提高策略的稳健性。
- 数据处理:提供的
QlibDataset是一个示例。对于不同的数据源或格式,你需要调整数据加载和预处理逻辑。 - 策略和回测复杂性:这里使用的简单 top-K 策略是一个基本起点。生产级策略通常包含更复杂的逻辑,用于投资组合构建、动态仓位调整和风险管理(例如止损/止盈规则)。此外,高保真度的回测应精细地模拟交易成本、滑点和市场冲击,以更准确地估算实际表现。
📝 AI 生成的注释:请注意,
finetune/目录中的许多代码注释是由 AI 助手(Gemini 2.5 Pro)为解释而生成的。虽然它们旨在提供帮助,但可能包含不准确之处。我们建议将代码本身视为逻辑的最终依据。
📖 引用
如果你在研究中使用 Kronos,我们期待你引用我们的论文:
@misc{shi2025kronos,
      title={Kronos: A Foundation Model for the Language of Financial Markets},
      author={Yu Shi and Zongliang Fu and Shuo Chen and Bohan Zhao and Wei Xu and Changshui Zhang and Jian Li},
      year={2025},
      eprint={2508.02739},
      archivePrefix={arXiv},
      primaryClass={q-fin.ST},
      url={https://arxiv.org/abs/2508.02739},
}
📜 许可证
本项目采用 MIT 许可证。