LLMs-from-scratch

从零实现GPT-like LLM的完整教程,配套《Build a Large Language Model (From Scratch)》一书,覆盖数据预处理、注意力机制、训练、微调等全流程。亮点是纯PyTorch代码、循序渐进的讲解,附带丰富练习和扩展材料,适合想深入理解LLM内部原理的开发者。
README
从头构建大型语言模型(Build a Large Language Model From Scratch)
本仓库包含开发、预训练和微调类 GPT 的大语言模型(LLM)的代码,是书籍 《从头构建大型语言模型》 的官方代码仓库。
在 《从头构建大型语言模型》 一书中,你将通过从零开始逐步编码,从内到外理解大语言模型(LLM)的工作原理。本书将引导你创建自己的 LLM,用清晰的文字、图表和示例解释每个阶段。
本书所描述的用于训练和开发自己小规模但功能完备的模型(用于教育目的)的方法,与构建诸如 ChatGPT 背后的大规模基础模型所用方法一致。此外,本书还包含加载较大预训练模型权重以进行微调的代码。
- 官方源代码仓库链接
- Manning 出版社网站上的书籍链接
- 亚马逊 Amazon.com 上的书籍页面链接
- ISBN 9781633437166
要下载本仓库的副本,请点击 Download ZIP 按钮,或在终端中执行以下命令:
git clone --depth 1 https://github.com/rasbt/LLMs-from-scratch.git
(如果你是从 Manning 网站下载的代码包,建议访问 GitHub 上的官方代码仓库 https://github.com/rasbt/LLMs-from-scratch 以获取最新更新。)
目录
请注意,本 README.md 文件是一个 Markdown(.md)文件。如果你从 Manning 网站下载了代码包并在本地计算机上查看,建议使用 Markdown 编辑器或预览工具以获得正确显示。如果你尚未安装 Markdown 编辑器,Ghostwriter 是一个不错的免费选择。
你也可以在浏览器中直接查看 GitHub 上的本文件及其他文件:https://github.com/rasbt/LLMs-from-scratch,GitHub 会自动渲染 Markdown。
提示: 如果你在寻找关于安装 Python 和 Python 包以及设置代码环境的指导,建议阅读 setup 目录下的 README.md 文件。

| 章节标题 | 主要代码(快速访问) | 全部代码 + 补充材料 |
|---|---|---|
| 设置建议 如何最佳阅读本书 |
- | - |
| 第 1 章:理解大型语言模型 | 无需代码 | - |
| 第 2 章:处理文本数据 | - ch02.ipynb - dataloader.ipynb (总结) - exercise-solutions.ipynb |
./ch02 |
| 第 3 章:编码注意力机制 | - ch03.ipynb - multihead-attention.ipynb (总结) - exercise-solutions.ipynb |
./ch03 |
| 第 4 章:从头实现 GPT 模型 | - ch04.ipynb - gpt.py (总结) - exercise-solutions.ipynb |
./ch04 |
| 第 5 章:在无标签数据上预训练 | - ch05.ipynb - gpt_train.py (总结) - gpt_generate.py (总结) - exercise-solutions.ipynb |
./ch05 |
| 第 6 章:针对文本分类进行微调 | - ch06.ipynb - gpt_class_finetune.py - exercise-solutions.ipynb |
./ch06 |
| 第 7 章:为指令跟随进行微调 | - ch07.ipynb - gpt_instruction_finetuning.py (总结) - ollama_evaluate.py (总结) - exercise-solutions.ipynb |
./ch07 |
| 附录 A:PyTorch 简介 | - code-part1.ipynb - code-part2.ipynb - DDP-script.py - exercise-solutions.ipynb |
./appendix-A |
| 附录 B:参考文献与扩展阅读 | 无需代码 | ./appendix-B |
| 附录 C:练习解答 | - 练习解答列表 | ./appendix-C |
| 附录 D:为训练循环添加辅助功能 | - appendix-D.ipynb | ./appendix-D |
| 附录 E:使用 LoRA 的参数高效微调 | - appendix-E.ipynb | ./appendix-E |
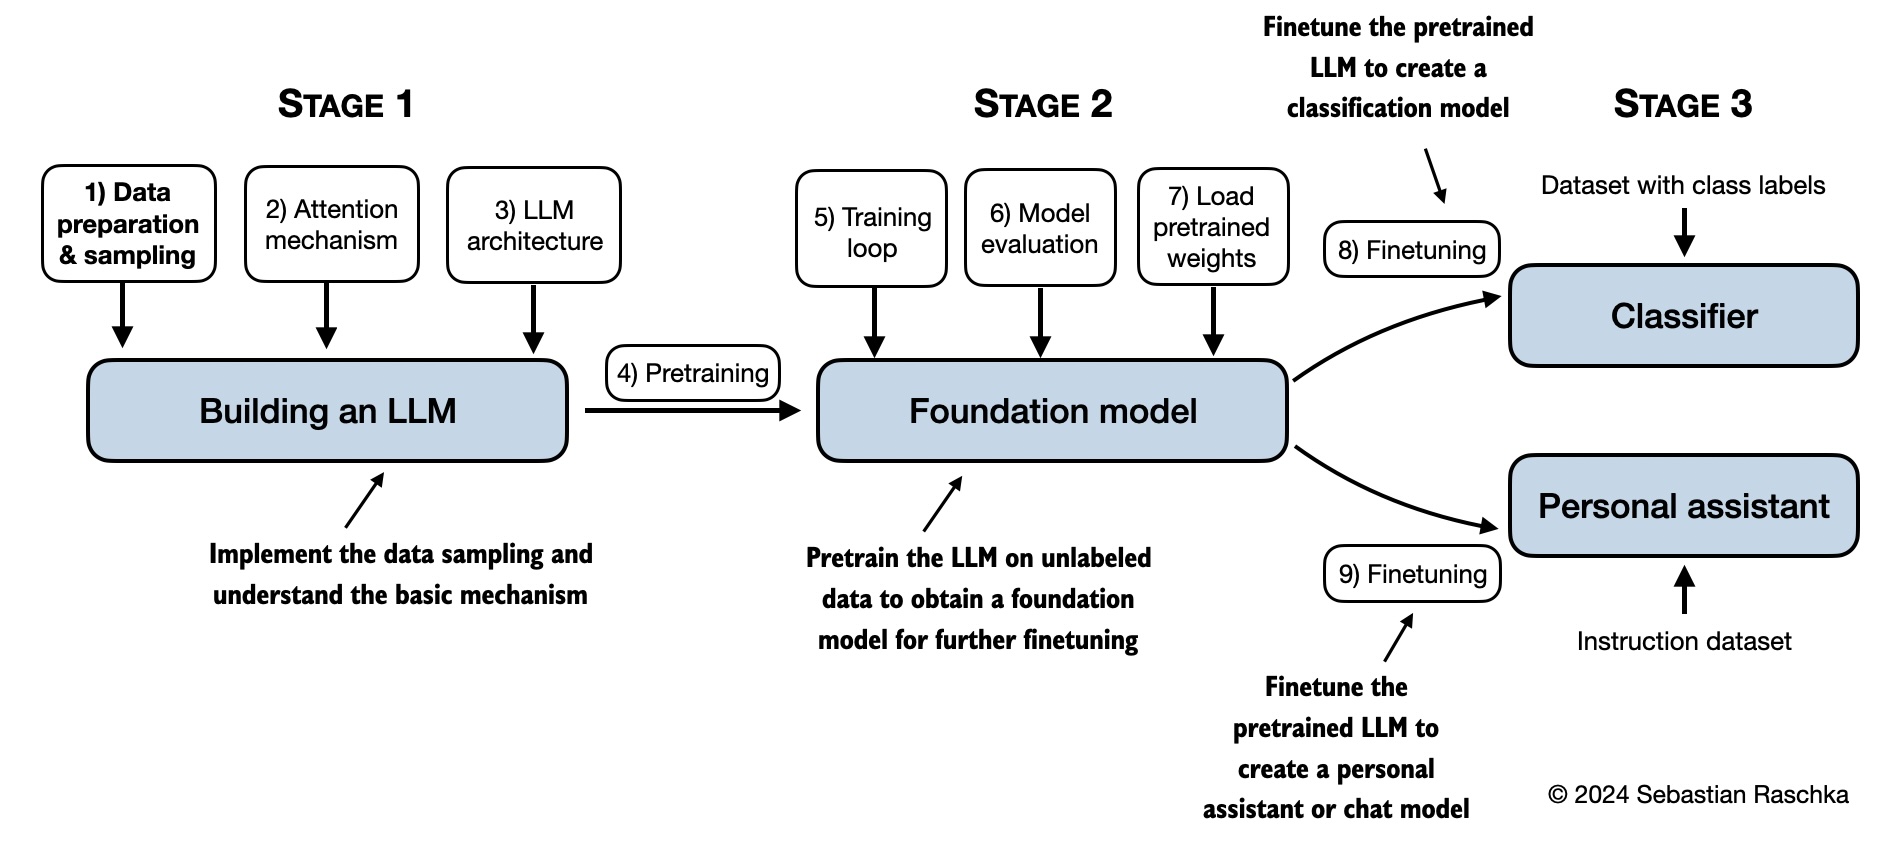
以下心智图总结了本书所涵盖的内容。
先决条件
最重要的先决条件是扎实的 Python 编程基础。有了这些知识,你将做好充分准备探索 LLM 的迷人世界,并理解本书中呈现的概念和代码示例。
如果你有一些深度神经网络的经验,由于 LLM 是建立在这些架构之上的,你可能会发现某些概念更为熟悉。
本书使用 PyTorch 从零实现代码,而不使用任何外部 LLM 库。虽然不要求精通 PyTorch,但了解 PyTorch 基础无疑是有帮助的。如果你是 PyTorch 新手,附录 A 提供了一份简洁的 PyTorch 介绍。或者,你也可以参考我的另一本书 《一小时 PyTorch:从张量到在多个 GPU 上训练神经网络》,它有助于学习关键内容。
硬件要求
本书主要章节的代码设计为在常规笔记本电脑上合理时间内运行,无需专用硬件。这种方法确保了广泛的受众可以参与其中。此外,如果可用,代码会自动利用 GPU。(请参阅 setup 文档以获取更多建议。)
视频课程
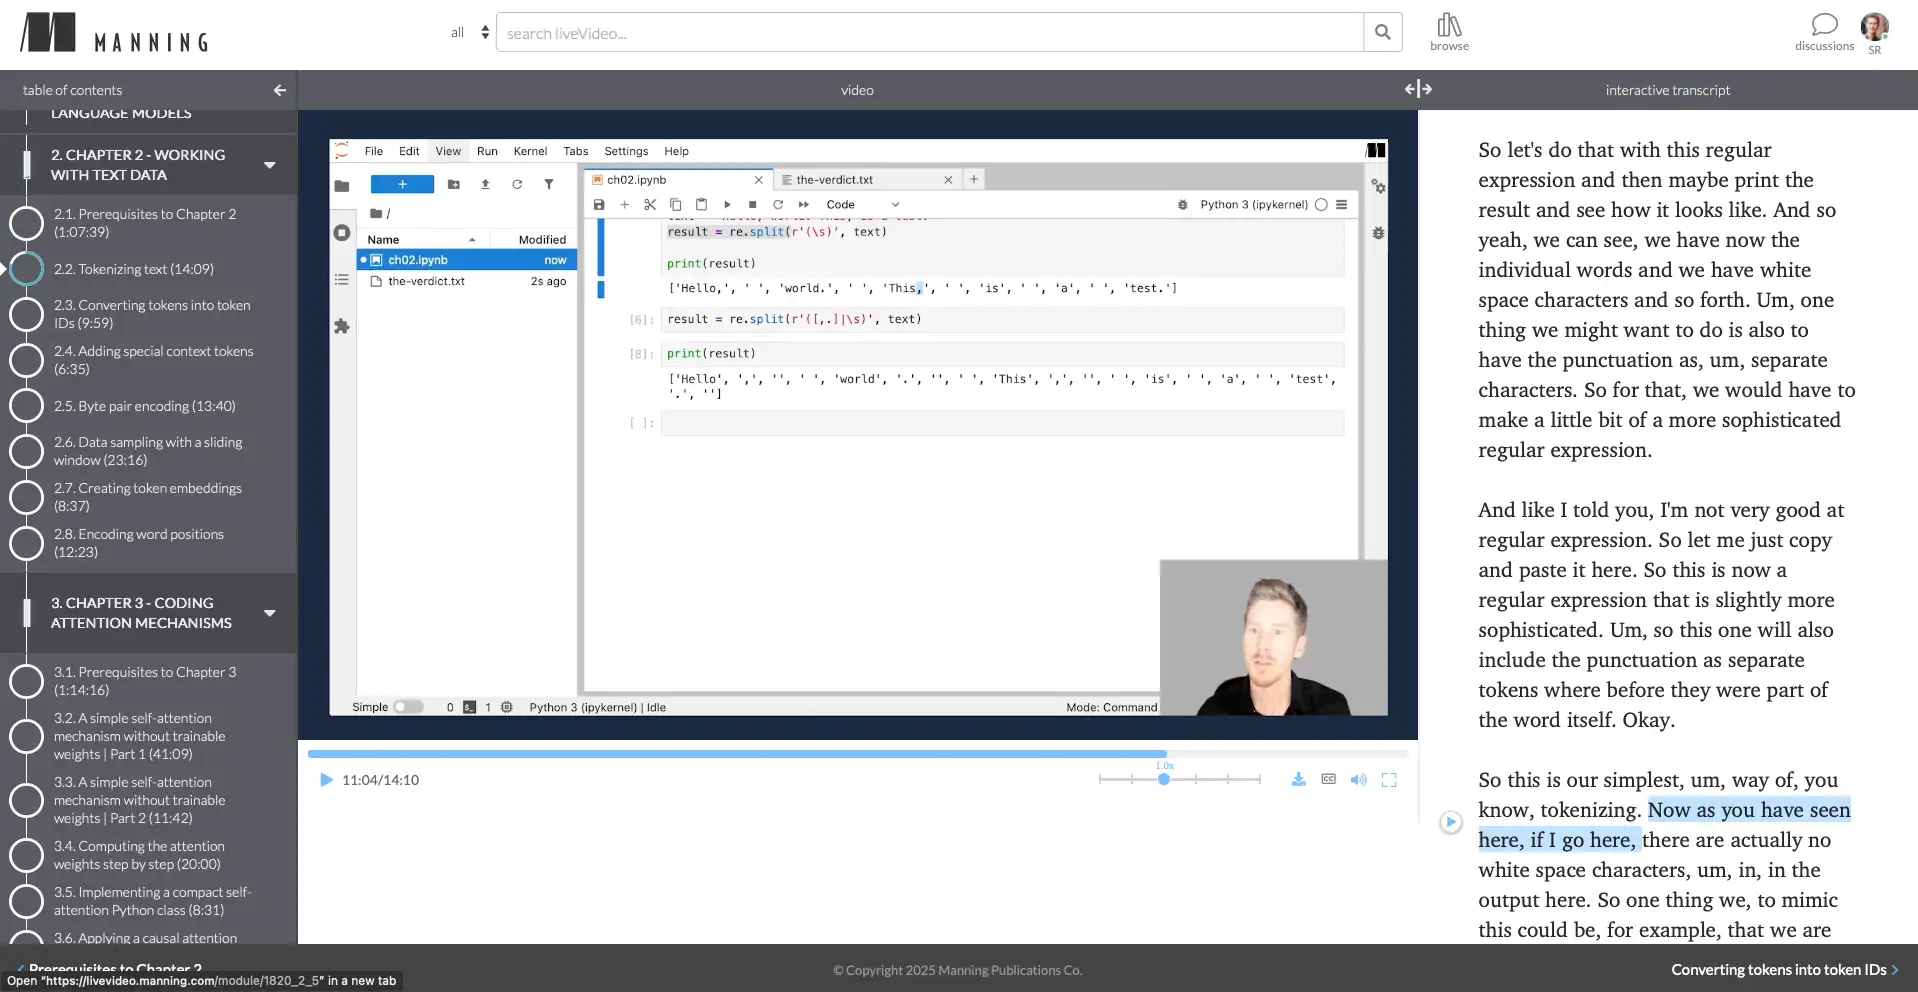
一个 17 小时 15 分钟的视频配套课程,其中我逐章编写代码。该课程按章和节组织,与书籍结构完全对应,因此可以作为书籍的独立替代品或互补的编码跟随资源。
配套书籍 / 续作
《从头构建推理模型》 是一本独立的书籍,但可视为《从头构建大型语言模型》的续作。
它从一个预训练模型开始,实现了不同的推理方法,包括推理时缩放(inference-time scaling)、强化学习(reinforcement learning)和蒸馏(distillation),以提高模型的推理能力。
与《从头构建大型语言模型》类似,《从头构建推理模型》 也采用动手实践的方法从零实现这些方法。
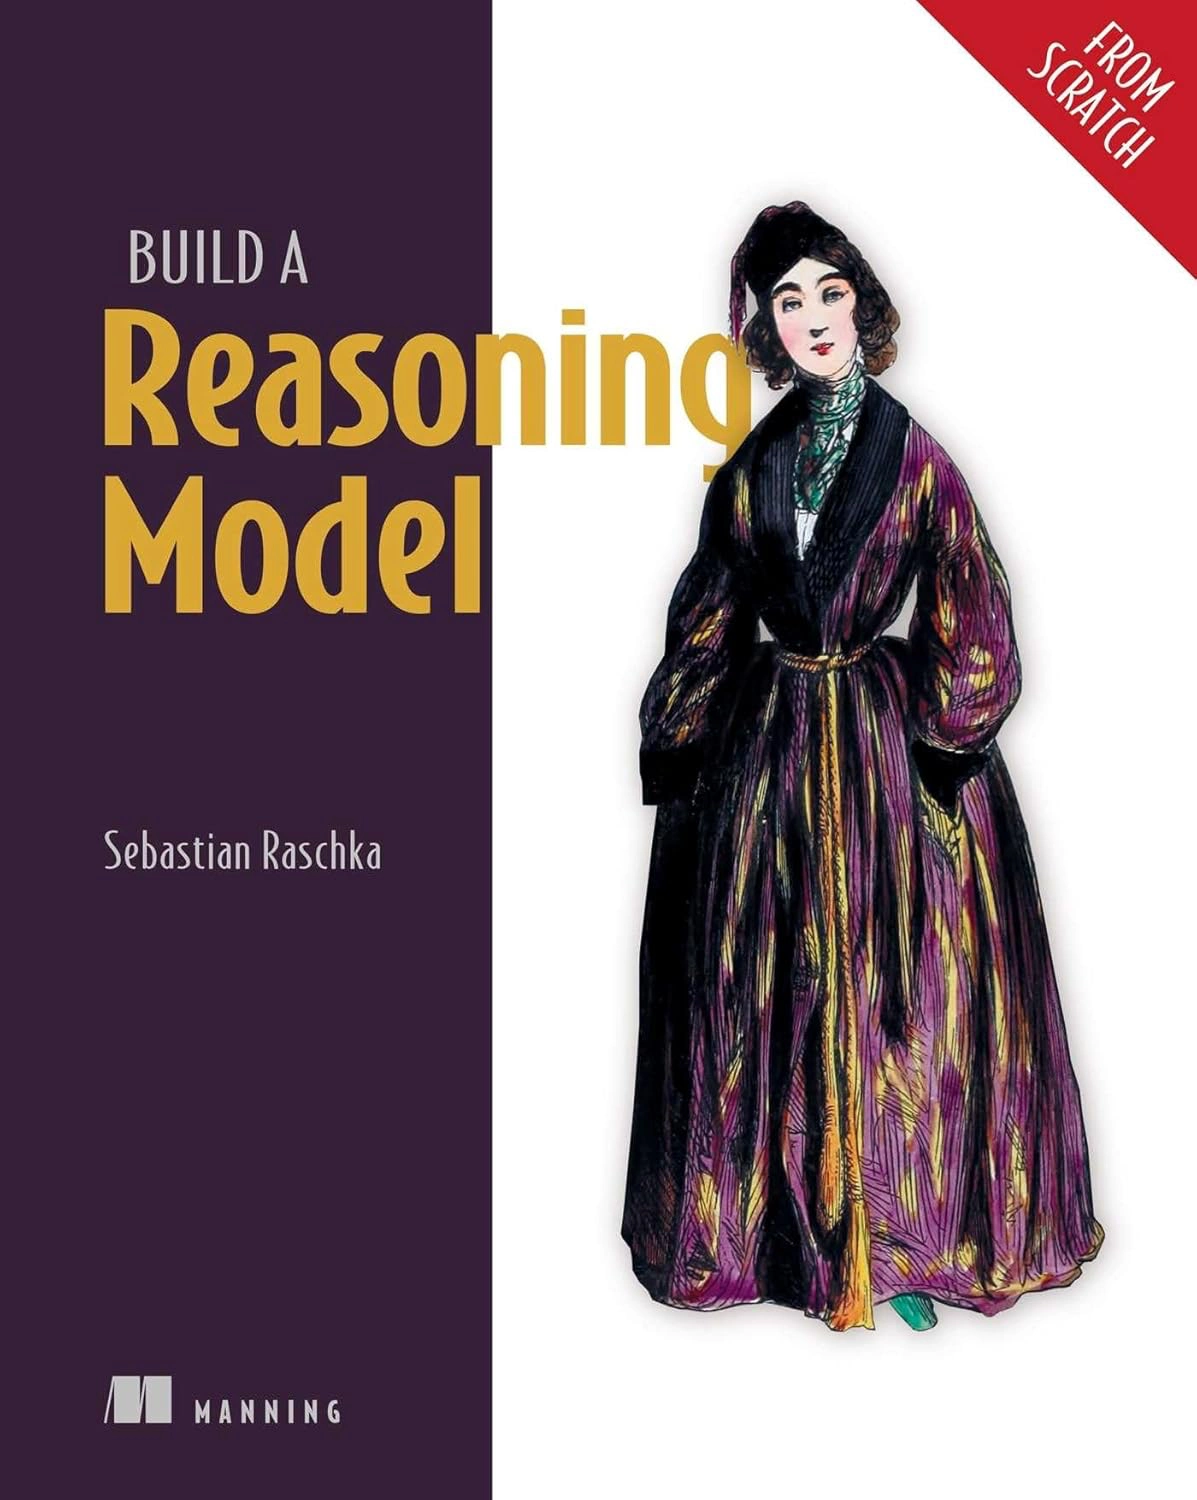
- 亚马逊链接(待定)
- Manning 链接
- GitHub 仓库
练习
本书每章都包含若干练习。练习解答汇总在附录 C 中,对应的代码 notebook 可在本仓库的主要章节文件夹中找到(例如 ./ch02/01_main-chapter-code/exercise-solutions.ipynb)。
除了代码练习,你还可以从 Manning 网站下载一份免费的 170 页 PDF,标题为 《测试你对《从头构建大型语言模型》的理解》。它每章包含约 30 道测验题及其解答,帮助你检验理解程度。
补充材料
以下文件夹包含供感兴趣读者选读的补充材料:
设置
第 2 章:处理文本数据
第 3 章:编码注意力机制
第 4 章:从头实现 GPT 模型
第 5 章:在无标签数据上预训练
第 6 章:分类微调
第 7 章:指令跟随微调
来自 Reasoning From Scratch 仓库的更多补充材料:
Qwen3(从头实现)基础
评估
推理缩放
强化学习 (RL)
问题、反馈及为此仓库做贡献
我欢迎各种反馈,最好通过 Manning 论坛 或 GitHub Discussions 分享。同样,如果你有任何问题或只是想与他人交流想法,也请随时在论坛上发帖。
请注意,由于本仓库包含与纸质书对应的代码,目前我无法接受会扩展主要章节代码内容的贡献,因为这会导致与纸质书产生偏差。保持一致性有助于确保每个人都能获得顺畅的体验。
引用
如果你发现本书或代码对你的研究有帮助,请考虑引用它。
芝加哥格式引用:
Raschka, Sebastian. Build A Large Language Model (From Scratch). Manning, 2024. ISBN: 978-1633437166.
BibTeX 条目:
@book{build-llms-from-scratch-book,
  author       = {Sebastian Raschka},
  title        = {Build A Large Language Model (From Scratch)},
  publisher    = {Manning},
  year         = {2024},
  isbn         = {978-1633437166},
  url          = {https://www.manning.com/books/build-a-large-language-model-from-scratch},
  github       = {https://github.com/rasbt/LLMs-from-scratch}
}