pytorch

深度学习框架,提供张量计算和自动求导能力,用动态计算图构建神经网络。与 TensorFlow 等静态框架不同,PyTorch 采用命令式编程,调试直观、灵活性强,已成为学术界和工业界的主流选择。支持 CPU/GPU/ROCm 等多种后端,生态完善,社区活跃。
README

PyTorch 是一个 Python 包,提供两个高级功能:
- 张量计算(类似 NumPy),具有强大的 GPU 加速能力
- 构建于磁带式 autograd 系统之上的深度神经网络
你可以按需复用你最喜欢的 Python 包(如 NumPy、SciPy、Cython)来扩展 PyTorch。
我们的主干健康状况(持续集成信号)可在 hud.pytorch.org 查看。
关于 PyTorch 的更多信息
从细粒度来看,PyTorch 是一个包含以下组件的库:
| 组件 | 描述 |
|---|---|
| torch | 类似 NumPy 的张量库,支持强大的 GPU 加速 |
| torch.autograd | 基于磁带的自动微分库,支持 torch 中所有可微张量操作 |
| torch.jit | 编译栈(TorchScript),用于从 PyTorch 代码创建可序列化和可优化的模型 |
| torch.nn | 与 autograd 深度集成、追求最大灵活性的神经网络库 |
| torch.multiprocessing | Python 多进程,但具有跨进程神奇共享 torch 张量的能力。适用于数据加载和 Hogwild 训练 |
| torch.utils | DataLoader 及其他便利工具函数 |
通常,PyTorch 用于以下两种场景之一:
- 作为 NumPy 的替代品,以利用 GPU 的计算能力。
- 作为深度学习研究平台,提供最大的灵活性和速度。
进一步阐述:
支持 GPU 的张量库
如果你使用过 NumPy,那么你已经接触过张量(即 ndarray)。
PyTorch 提供可以运行在 CPU 或 GPU 上的张量,并大幅加速计算。
我们提供了丰富的张量例程,以满足你的科学计算需求,例如切片、索引、数学运算、线性代数、规约等。而且它们速度极快!
动态神经网络:基于磁带的 Autograd
PyTorch 有一种构建神经网络的独特方式:使用并重放磁带记录器。
大多数框架(如 TensorFlow、Theano、Caffe 和 CNTK)采用静态视图。你需要构建一个神经网络并反复复用相同的结构。改变网络行为意味着必须从头开始。
而 PyTorch 使用一种称为反向模式自动微分的技术,允许你以零延迟或零开销任意改变网络行为。我们的灵感来自几篇相关研究论文,以及当前和过去的工作,如 torch-autograd、autograd、Chainer 等。
尽管这种技术并非 PyTorch 独有,但它是目前最快的实现之一。你可以在疯狂的研究中同时获得速度和灵活性。

Python 优先
PyTorch 并非将 Python 绑定到单一的 C++ 框架。它被设计成与 Python 深度融合。你可以像使用 NumPy / SciPy / scikit-learn 等一样自然地使用它。你可以用 Python 本身编写新的神经网络层,使用你喜欢的库,并利用 Cython 和 Numba 等包。我们的目标是在适当的地方不重复造轮子。
命令式体验
PyTorch 设计为直观、线性思维且易于使用。当你执行一行代码时,它会立即执行。不存在异步的世界观。当你进入调试器或收到错误消息和堆栈跟踪时,理解起来非常简单。堆栈跟踪会精确指向你定义代码的位置。我们希望你再也不用因为糟糕的堆栈跟踪或异步且不透明的执行引擎而花费数小时调试代码。
快速且轻量
PyTorch 的框架开销极小。我们集成了加速库,如 Intel MKL 和 NVIDIA(cuDNN、NCCL)以最大化速度。核心的 CPU 和 GPU 张量及神经网络后端已经成熟并经过多年测试。
因此,PyTorch 无论运行小型还是大型神经网络都非常快速。
与 Torch 或其他替代方案相比,PyTorch 的内存使用效率极高。我们为 GPU 编写了自定义内存分配器,以确保你的深度学习模型最大限度地内存高效。这使你能够训练比以前更大的深度学习模型。
无痛扩展
编写新的神经网络模块,或与 PyTorch 的张量 API 交互,被设计得简单直接且抽象极少。
你可以使用 torch API 或 你喜欢的基于 NumPy 的库(如 SciPy) 在 Python 中编写新的神经网络层。
如果你想用 C/C++ 编写层,我们提供了一个方便的扩展 API,高效且样板代码极少。无需编写包装代码。你可以查看 此教程 和 此示例。
安装
二进制包
通过 Conda 或 pip wheels 安装二进制包的命令请访问我们的网站:https://pytorch.org/get-started/locally/
NVIDIA Jetson 平台
适用于 NVIDIA Jetson Nano、Jetson TX1/TX2、Jetson Xavier NX/AGX 和 Jetson AGX Orin 的 Python wheels 在 此处 提供,L4T 容器发布在 此处。
它们需要 JetPack 4.2 及以上版本,由 @dusty-nv 和 @ptrblck 维护。
从源码编译
前置条件
如果从源码安装,你需要:
- Python 3.10 或更高版本
- 完全支持 C++20 的编译器,如 clang 或 gcc(Linux 上需要 gcc 11.3.0 或更新版本)
- Visual Studio 或 Visual Studio Build Tools(仅 Windows)
- 至少 10 GB 可用磁盘空间
- 初始构建需要 30-60 分钟(后续重新构建快得多)
* PyTorch CI 使用 Visual C++ BuildTools,它们随 Visual Studio Enterprise、Professional 或 Community 版本提供。你也可以从 https://visualstudio.microsoft.com/visual-cpp-build-tools/ 安装构建工具。构建工具 不会 随 Visual Studio Code 默认安装。
以下是一个环境设置示例:
- Linux:
$ source <CONDA_INSTALL_DIR>/bin/activate
$ conda create -y -n <CONDA_NAME>
$ conda activate <CONDA_NAME>
- Windows:
$ source <CONDA_INSTALL_DIR>\Scripts\activate.bat
$ conda create -y -n <CONDA_NAME>
$ conda activate <CONDA_NAME>
$ call "C:\Program Files\Microsoft Visual Studio\<VERSION>\Community\VC\Auxiliary\Build\vcvarsall.bat" x64
conda 环境并非必需。你也可以在标准虚拟环境(例如使用 uv 等工具创建的环境)中进行 PyTorch 构建,前提是你的系统已安装所有无法作为 pip 包获得的必要依赖(例如 CUDA、MKL)。
NVIDIA CUDA 支持
如果要用 CUDA 支持编译,请从我们的支持矩阵中选择一个受支持的 CUDA 版本,然后安装以下内容:
- NVIDIA CUDA
- NVIDIA cuDNN v9.0 或更高版本
- 与 CUDA 兼容的编译器
注意:你可以参考 cuDNN 支持矩阵 来了解不同受支持 CUDA、CUDA 驱动和 NVIDIA 硬件对应的 cuDNN 版本。
如果想禁用 CUDA 支持,请导出环境变量 USE_CUDA=0。其他可能有用的环境变量可以在 setup.py 中找到。如果 CUDA 安装在非标准位置,请设置 PATH 以便能找到你想使用的 nvcc(例如 export PATH=/usr/local/cuda-12.8/bin:$PATH)。
如果你正在为 NVIDIA 的 Jetson 平台(Jetson Nano、TX1、TX2、AGX Xavier)构建,适用于 Jetson Nano 的 PyTorch 安装说明 可在此处获取。
AMD ROCm 支持
如果要用 ROCm 支持编译,请安装:
- AMD ROCm 4.0 及以上版本
- ROCm 目前仅支持 Linux 系统。
默认情况下,构建系统期望 ROCm 安装在 /opt/rocm。如果 ROCm 安装在不同目录,必须设置 ROCM_PATH 环境变量指向 ROCm 安装目录。构建系统会自动检测 AMD GPU 架构。可选地,可以通过 PYTORCH_ROCM_ARCH 环境变量显式设置 AMD GPU 架构:AMD GPU 架构
如果想禁用 ROCm 支持,请导出环境变量 USE_ROCM=0。其他可能有用的环境变量可以在 setup.py 中找到。
Intel GPU 支持
如果要用 Intel GPU 支持编译,请按照以下步骤操作:
- PyTorch Intel GPU 前置条件 说明。
- Intel GPU 支持 Linux 和 Windows。
如果想禁用 Intel GPU 支持,请导出环境变量 USE_XPU=0。其他可能有用的环境变量可以在 setup.py 中找到。
获取 PyTorch 源码
git clone https://github.com/pytorch/pytorch
cd pytorch
# 如果你在更新已有的检出
git submodule sync
git submodule update --init --recursive
安装依赖
通用
# 在按照上面的“获取 PyTorch 源码”部分克隆源码后,在 PyTorch 目录下运行此命令
pip install --group dev
Linux
pip install mkl-static mkl-include
# 仅 CUDA:如果需要,为 GPU 添加 LAPACK 支持
# magma 安装:在激活的 conda 环境中运行。指定要安装的 CUDA 版本
.ci/docker/common/install_magma_conda.sh 12.4

# (可选)如果使用 torch.compile 配合 inductor/triton,请安装匹配版本的 triton
# 克隆后在 pytorch 目录下运行
# 对于 Intel GPU 支持,请在运行命令前显式执行 `export USE_XPU=1`
make triton
Windows
pip install mkl-static mkl-include
# 如果需要 torch.distributed,请添加这些包。
# Windows 上的分布式包支持是原型功能,可能会发生变化。
conda install -c conda-forge libuv=1.51
安装 PyTorch
Linux
如果你正在为 AMD ROCm 编译,请首先运行此命令:
# 仅当你为 ROCm 编译时运行此命令
python tools/amd_build/build_amd.py
安装 PyTorch
# conda 环境的 CMake 前缀
export CMAKE_PREFIX_PATH="${CONDA_PREFIX:-'$(dirname $(which conda))/../'}:${CMAKE_PREFIX_PATH}"
python -m pip install --no-build-isolation -v -e .

# 非 conda 环境(例如 Python venv)的 CMake 前缀
# 在激活 venv 后调用以下命令
export CMAKE_PREFIX_PATH="${VIRTUAL_ENV}:${CMAKE_PREFIX_PATH}"
macOS
python -m pip install --no-build-isolation -v -e .
Windows
如果你想构建遗留的 Python 代码,请参考 Building on legacy code and CUDA
仅 CPU 构建
在此模式下,PyTorch 计算将在你的 CPU 上运行,而不是 GPU。
python -m pip install --no-build-isolation -v -e .
关于 OpenMP 的说明:推荐的 OpenMP 实现是 Intel OpenMP(iomp)。为了链接 iomp,你需要手动下载该库,并通过调整 CMAKE_INCLUDE_PATH 和 LIB 来设置构建环境。此处的 说明 是同时设置 MKL 和 Intel OpenMP 的示例。如果没有为 CMake 配置这些,将使用 Microsoft Visual C OpenMP 运行时(vcomp)。
基于 CUDA 的构建
在此模式下,PyTorch 计算将通过 CUDA 利用你的 GPU 进行更快的数值运算。
构建带有 CUDA 的 PyTorch 需要 NVTX。NVTX 是 CUDA 发行版的一部分,其中被称为 "Nsight Compute"。要将其安装到已安装的 CUDA 上,请再次运行 CUDA 安装并勾选相应的复选框。确保在 Visual Studio 之后安装了带有 Nsight Compute 的 CUDA。
目前,VS 2017 / 2019 和 Ninja 支持作为 CMake 的生成器。如果在 PATH 中检测到 ninja.exe,则 Ninja 将被用作默认生成器;否则,将使用 VS 2017 / 2019。
如果选择 Ninja 作为生成器,则将选择最新的 MSVC 作为底层工具链。
通常还需要其他库,如 Magma、oneDNN(又称 MKLDNN 或 DNNL) 和 Sccache。请参考 installation-helper 来安装它们。
你可以参考 build_pytorch.bat 脚本了解一些其他环境变量的配置。
cmd

:: 下载并解压 mkl 包后,设置环境变量,否则 CMake 会报错 `Could NOT find OpenMP`。
set CMAKE_INCLUDE_PATH={Your directory}\mkl\include
set LIB={Your directory}\mkl\lib;%LIB%

:: 在继续之前,请仔细阅读上一节的内容。
:: [可选] 如果你想要覆盖 Ninja 和 Visual Studio 与 CUDA 使用的底层工具集,请运行以下脚本块。
:: 将自动运行 "Visual Studio 2019 Developer Command Prompt"。
:: 当你使用 Visual Studio 生成器时,请确保你已安装 CMake >= 3.12。
set CMAKE_GENERATOR_TOOLSET_VERSION=14.27
set DISTUTILS_USE_SDK=1
for /f "usebackq tokens=*" %i in (`"%ProgramFiles(x86)%\Microsoft Visual Studio\Installer\vswhere.exe" -version [15^,17^) -products * -latest -property installationPath`) do call "%i\VC\Auxiliary\Build\vcvarsall.bat" x64 -vcvars_ver=%CMAKE_GENERATOR_TOOLSET_VERSION%

:: [可选] 如果你想要覆盖 CUDA 主机编译器
set CUDAHOSTCXX=C:\Program Files (x86)\Microsoft Visual Studio\2019\Community\VC\Tools\MSVC\14.27.29110\bin\HostX64\x64\cl.exe

python -m pip install --no-build-isolation -v -e .
Intel GPU 构建
在此模式下,将构建具有 Intel GPU 支持的 PyTorch。
请确保在开始构建之前已正确安装 通用前置条件 和 Intel GPU 前置条件,并已配置好环境变量。对于构建工具支持,需要 Visual Studio 2022。
然后可以用以下命令构建 PyTorch:
:: CMD 命令:
:: 设置 CMAKE_PREFIX_PATH 以帮助找到相应的包
:: %CONDA_PREFIX% 仅在 `conda activate custom_env` 后生效

if defined CMAKE_PREFIX_PATH (
    set "CMAKE_PREFIX_PATH=%CONDA_PREFIX%\Library;%CMAKE_PREFIX_PATH%"
) else (
    set "CMAKE_PREFIX_PATH=%CONDA_PREFIX%\Library"
)

python -m pip install --no-build-isolation -v -e .
调整构建选项(可选)
你可以通过以下步骤可选地调整 cmake 变量的配置(无需先构建)。例如,调整 CuDNN 或 BLAS 的预检测目录可以通过这样的步骤完成。
在 Linux 上
export CMAKE_PREFIX_PATH="${CONDA_PREFIX:-'$(dirname $(which conda))/../'}:${CMAKE_PREFIX_PATH}"
CMAKE_ONLY=1 python setup.py build
ccmake build  # 或 cmake-gui build
在 macOS 上
export CMAKE_PREFIX_PATH="${CONDA_PREFIX:-'$(dirname $(which conda))/../'}:${CMAKE_PREFIX_PATH}"
MACOSX_DEPLOYMENT_TARGET=11.0 CMAKE_ONLY=1 python setup.py build
ccmake build  # 或 cmake-gui build
Docker 镜像
使用预构建镜像
你也可以从 Docker Hub 拉取预构建的 Docker 镜像,并用 docker v23.0+ 运行。
docker run --gpus all --rm -ti --ipc=host pytorch/pytorch:latest
请注意,PyTorch 使用共享内存在进程间共享数据,因此如果使用 torch 多进程(例如用于多线程数据加载器),容器运行的默认共享内存段大小可能不够,你应该通过 --ipc=host 或 --shm-size 命令行选项增加共享内存大小。
自行构建镜像
注意: 必须使用 Docker >= 23.0 版本构建。
提供的 Dockerfile 用于构建支持 CUDA 12.1 和 cuDNN v9 的镜像。你可以传递 PYTHON_VERSION=x.y make 变量来指定 Miniconda 使用的 Python 版本,或者保持未设置以使用默认值,因为 Dockerfile 使用系统 Python。
make -f docker.Makefile
# 镜像被标记为 docker.io/${your_docker_username}/pytorch
你还可以传递 CMAKE_VARS="..." 环境变量,以指定构建期间要传递给 CMake 的其他 CMake 变量。请参见 setup.py 了解可用变量列表。
make -f docker.Makefile
构建文档
要构建各种格式的文档,你需要 Sphinx 和 pytorch_sphinx_theme2。
在本地构建文档之前,请确保环境中已安装 torch。对于小修复,你可以按照 快速入门 中的说明安装 nightly 版本。
对于更复杂的修复(例如添加新模块和新模块的文档字符串),你可能需要 从源码 安装 torch。关于文档字符串约定,请参见 Docstring 指南。
cd docs/
pip install -r requirements.txt
make html
make serve
运行 make 以获取所有可用输出格式的列表。
如果遇到 katex 错误,请运行 npm install katex。如果仍存在问题,请尝试 npm install -g katex。
[!NOTE] 如果看到 numpy 不兼容错误,请运行:
pip install 'numpy<2'
排查 CI 错误
你的构建可能会显示你在本地未遇到的错误 - 以下是如何找到与文档相关的错误。
如果构建有任何错误,你会在 PR 上看到类似这样的内容:
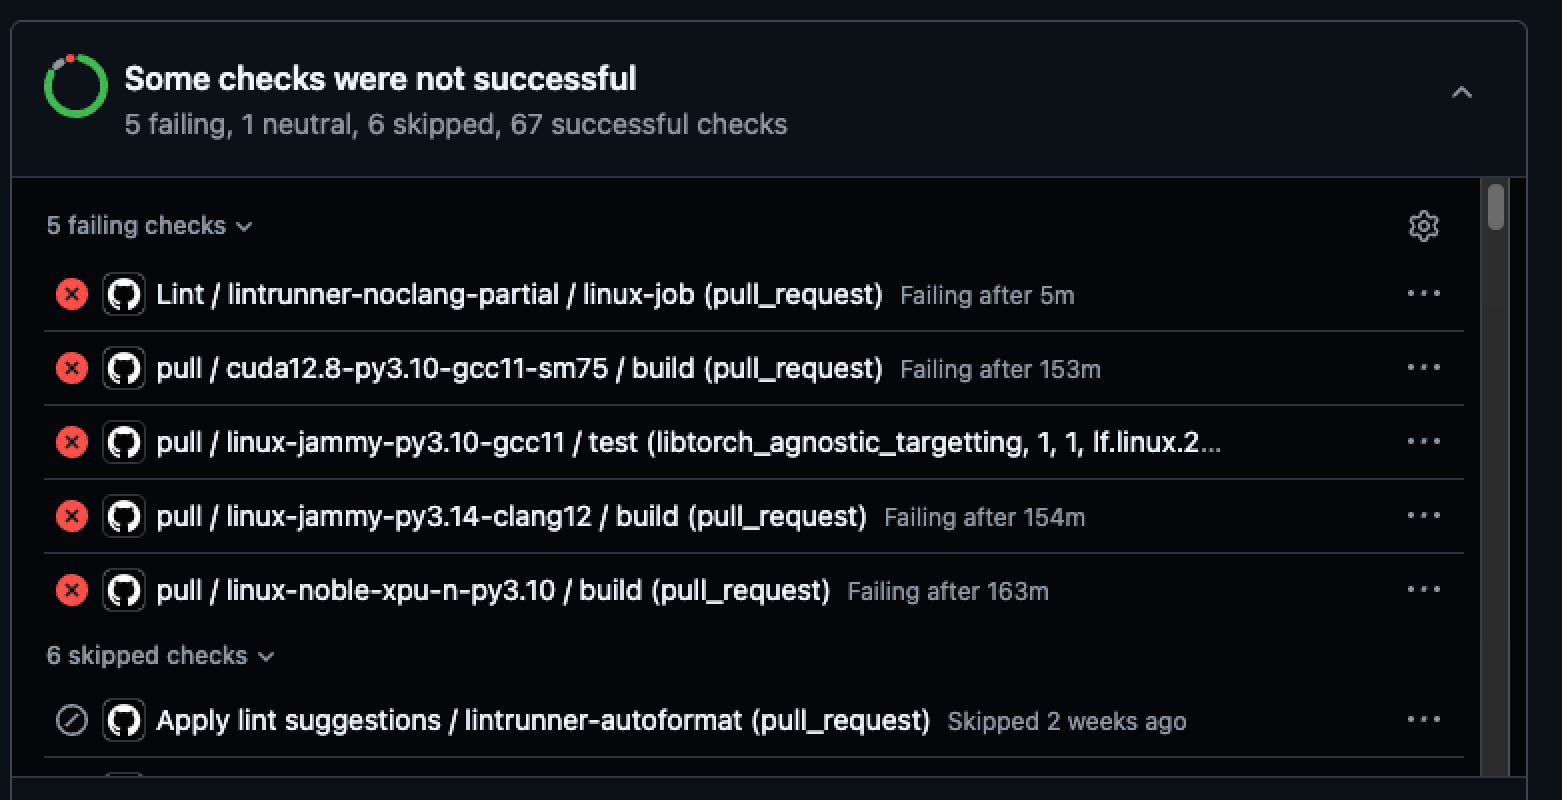
任何与文档相关的错误都会出现在标题中包含 "doc" 的任务中。看起来这些任务似乎都没有与文档相关。
我们仍然来看一下。点击任务以查看日志:

我们可以确定这个任务与文档无关。
查看这个构建,我们可以看到这些任务与我们的文档相关 - 并且它们没有出现任何错误:
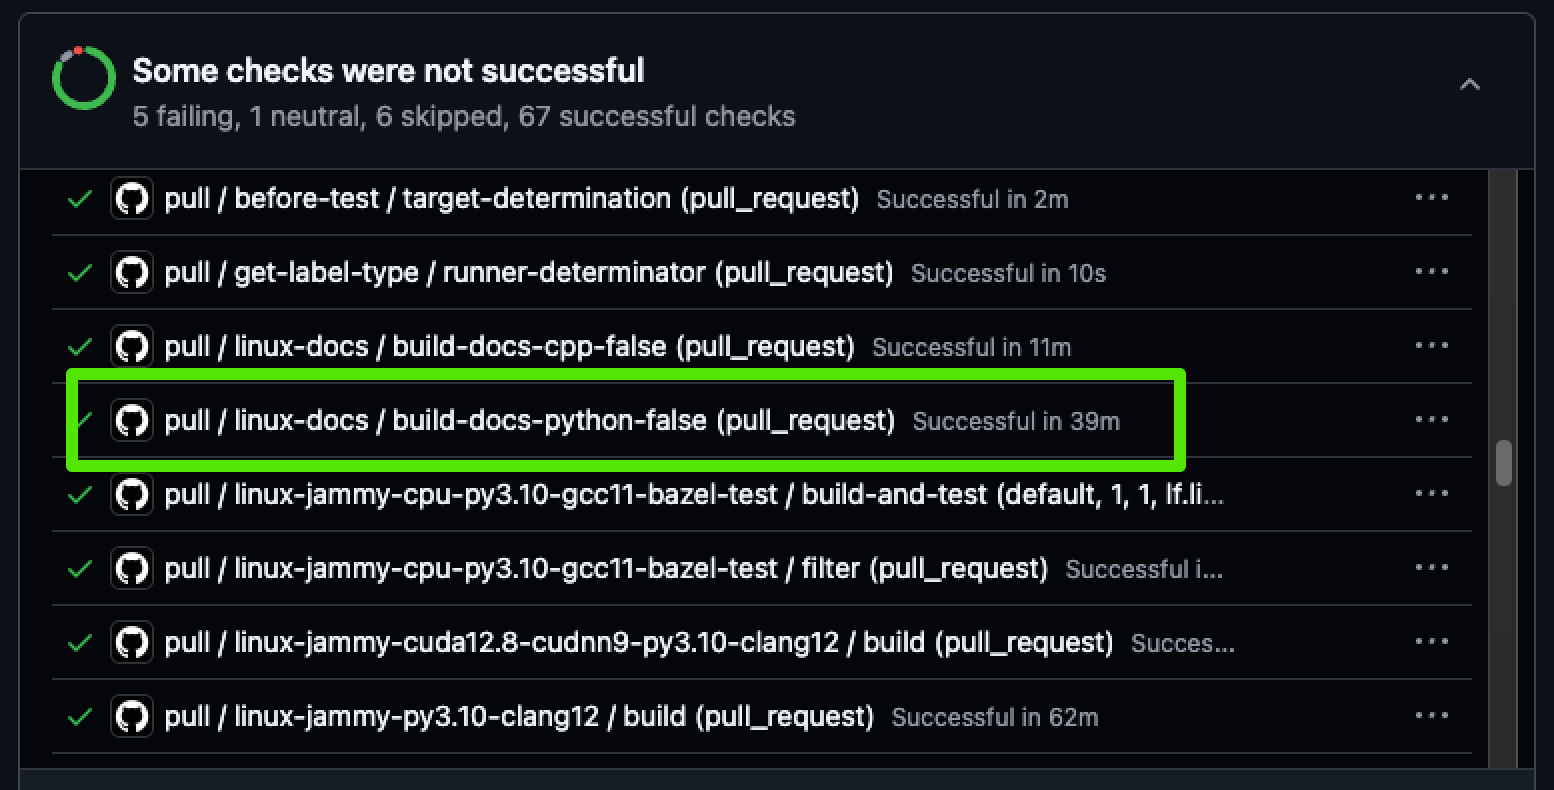
你可能还会在 PR 上看到这样的评论:
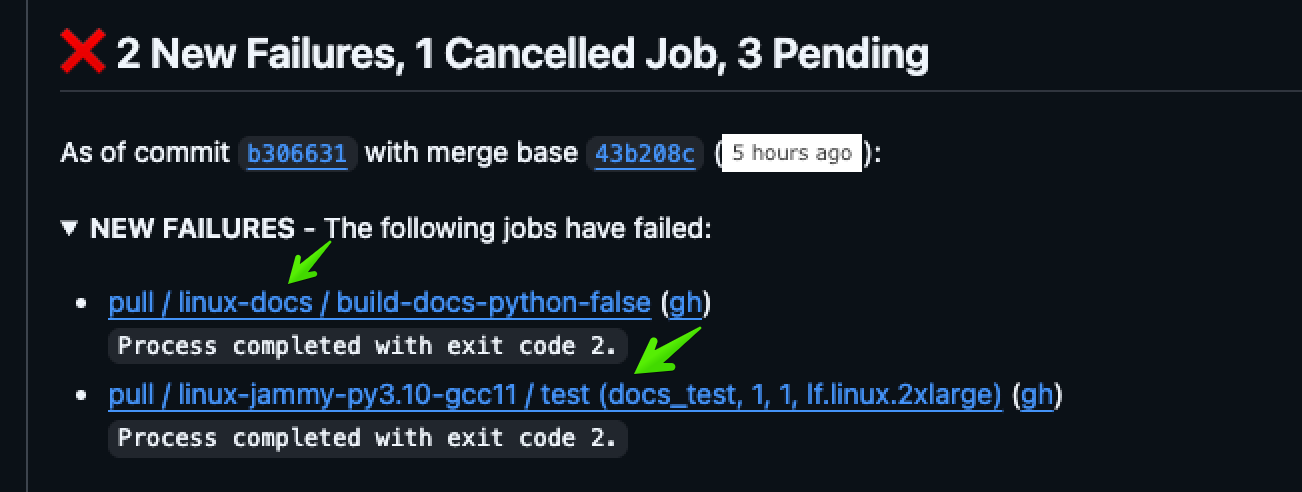
我们可以看到其中一些问题与我们的文档相关。
点击 gh 链接打开日志:
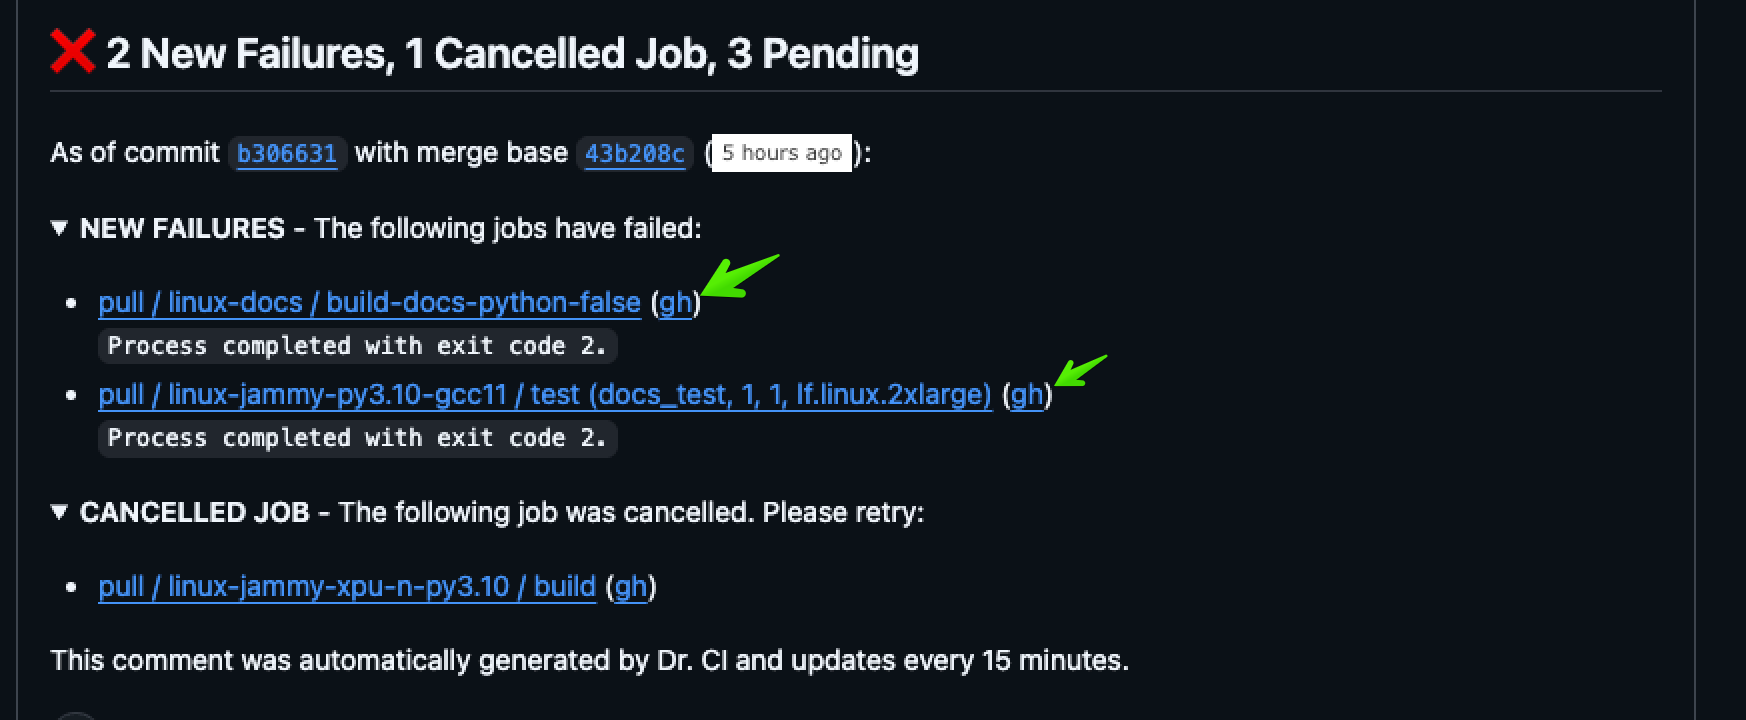
在这里我们可以看到一个与文档相关的错误:

你总是可以在 PR 的 Checks 选项卡中找到相关的文档构建,然后向下滚动到 pull。
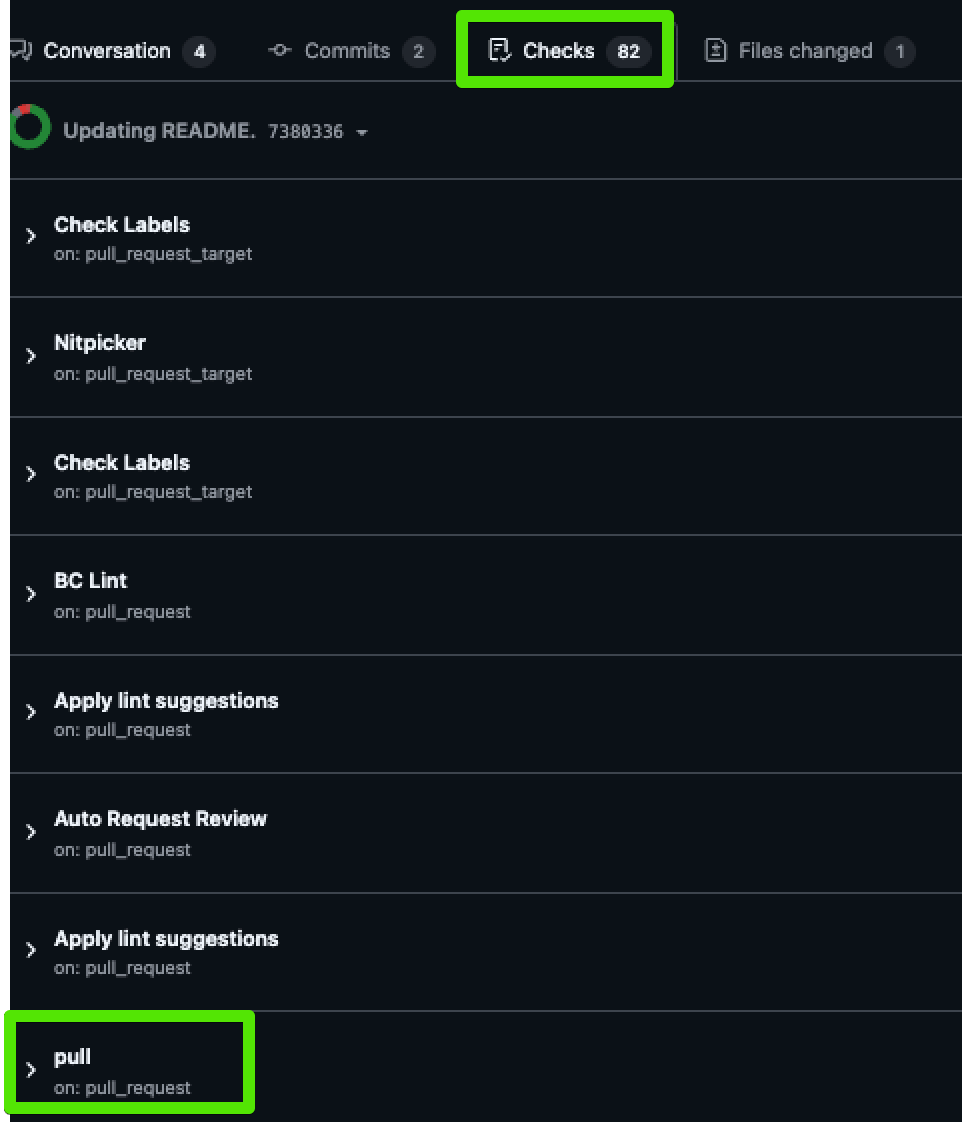
你可以点击浏览或切换手风琴来查看所有任务,其中文档任务已高亮显示:

如果点击进去,你会看到底部的文档任务,如下所示:
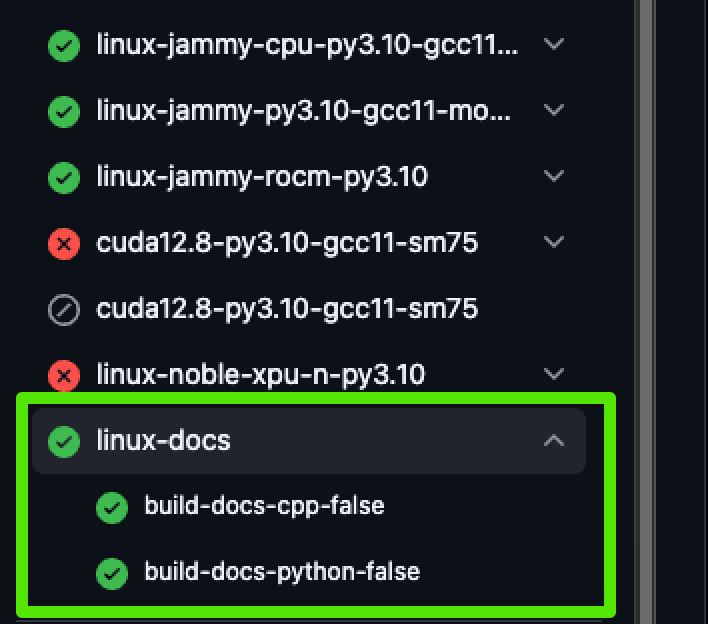
构建 PDF
要编译所有 PyTorch 文档的 PDF,请确保已安装 texlive 和 LaTeX。在 macOS 上,可以使用以下命令安装:
brew install --cask mactex
创建 PDF:
运行:
make latexpdf这将在
build/latex目录中生成必要的文件。导航到此目录并执行:
make LATEXOPTS="-interaction=nonstopmode"这将生成包含所需内容的
pytorch.pdf。再运行此命令一次,以生成正确的目录和索引。
[!NOTE] 要查看目录,请在 PDF 查看器中切换到 目录 视图。
历史版本
历史 PyTorch 版本的安装说明和二进制文件可以在 我们的网站 上找到。
快速入门
入门指引:
资源
- PyTorch.org
- PyTorch 教程
- PyTorch 示例
- PyTorch 模型
- Udacity 的 PyTorch 深度学习入门
- Udacity 的 PyTorch 机器学习入门
- Coursera 的 PyTorch 深度神经网络
- PyTorch Twitter
- PyTorch 博客
- PyTorch YouTube
沟通交流
- 论坛:讨论实现、研究等。https://discuss.pytorch.org
- GitHub Issues:错误报告、功能请求、安装问题、RFC、想法等。
- Slack:PyTorch Slack 的主要受众是中等至有经验的 PyTorch 用户和开发者,用于一般聊天、在线讨论、协作等。如果你是需要帮助的初学者,主要渠道是 PyTorch 论坛。如果需要 Slack 邀请,请填写此表格:https://goo.gl/forms/PP1AGvNHpSaJP8to1
- 通讯:无噪音的单向电子邮件通讯,包含关于 PyTorch 的重要公告。你可以在此注册:https://eepurl.com/cbG0rv
- Facebook 页面:关于 PyTorch 的重要公告。https://www.facebook.com/pytorch
- 关于品牌指南,请访问我们的网站 pytorch.org
发布与贡献
通常,PyTorch 每年有三个次要版本。如果你遇到错误,请通过 提交问题 告知我们。
我们感谢所有贡献。如果你打算贡献 bug 修复,请直接提交,无需进一步讨论。
如果你计划贡献新功能、工具函数或核心扩展,请先打开一个问题与我们讨论该功能。未经讨论就发送 PR 可能会导致 PR 被拒绝,因为我们可能正在向与你设想不同的方向发展核心。
要了解更多关于为 PyTorch 做贡献的信息,请参阅我们的 贡献页面。关于 PyTorch 发布的更多信息,请参见 发布页面。
团队
PyTorch 是一个社区驱动的项目,拥有许多技术娴熟的工程师和研究人员为其做出贡献。
PyTorch 目前由 Soumith Chintala、Gregory Chanan、Dmytro Dzhulgakov、Edward Yang、Alban Desmaison、Piotr Bialecki 和 Nikita Shulga 维护,还有数百名才华横溢的个人以各种形式和方法做出了重大贡献。一个非详尽但仍在增长的名单需要提及:Trevor Killeen、Sasank Chilamkurthy、Sergey Zagoruyko、Adam Lerer、Francisco Massa、Alykhan Tejani、Luca Antiga、Alban Desmaison、Andreas Koepf、James Bradbury、Zeming Lin、Yuandong Tian、Guillaume Lample、Marat Dukhan、Natalia Gimelshein、Christian Sarofeen、Martin Raison、Edward Yang、[Zachary Devito](https://github.com