heretic

自动去除语言模型审查(safety alignment)的命令行工具,基于方向消融(abliteration)技术,通过Optuna自动优化参数,在最小化拒绝回答的同时,尽量保留原模型能力。相比手动abliteration,全自动且KL散度更低,社区已发布3000+脱敏模型,效果获用户认可。
README
Heretic:语言模型的全自动去审查工具

Heretic 是一个工具,用于从基于 Transformer(自注意力架构)的语言模型中移除审查(即所谓的"安全对齐"),而无需昂贵的后训练。它结合了方向消融(directional ablation,也称为 'abliteration'(Arditi et al. 2024、Lai 2025(1,2))的高级实现,以及由 Optuna 驱动的基于 TPE(树形结构帕森估计器)的参数优化器。
这种方法使 Heretic 能够完全自动化地工作。Heretic 通过协同最小化拒绝回答的数量和与原始模型的 KL 散度(Kullback-Leibler divergence),找到高质量的去审查参数。这产生了一个保留原始模型尽可能多智能的去审查模型。使用 Heretic 不需要理解 Transformer 内部原理。事实上,任何知道如何运行命令行程序的人都可以使用 Heretic 来去除语言模型的审查。
Heretic 支持大多数密集模型(dense model),包括许多多模态模型、几种不同的 MoE(混合专家模型)架构,甚至一些混合模型如 Qwen3.5。纯状态空间模型和某些其他研究型架构尚不直接支持。
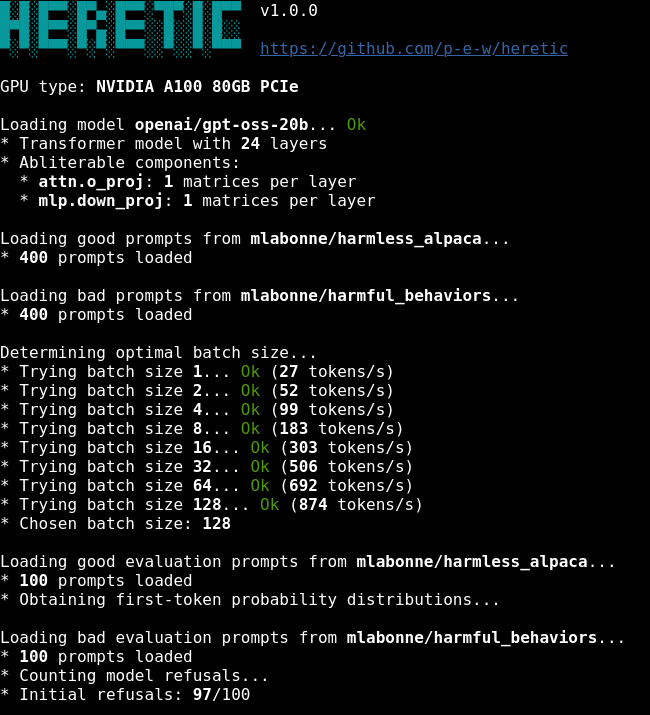
使用默认配置无监督运行,Heretic 可以生成与人类专家手动创建的去审查模型质量相当的模型:
| 模型 | 对"有害"提示的拒绝数 | 对"无害"提示的与原始模型的 KL 散度 |
|---|---|---|
| google/gemma-3-12b-it(原始模型) | 97/100 | 0 (按定义) |
| mlabonne/gemma-3-12b-it-abliterated-v2 | 3/100 | 1.04 |
| huihui-ai/gemma-3-12b-it-abliterated | 3/100 | 0.45 |
| p-e-w/gemma-3-12b-it-heretic(我们的) | 3/100 | 0.16 |
Heretic 版本无需任何人工干预,实现了与其他去审查模型相同的拒绝抑制水平,但 KL 散度低得多,表明对原始模型能力的损害更小。
(你可以使用 Heretic 内置的评估功能重现这些数字,例如 heretic --model google/gemma-3-12b-it --evaluate-model p-e-w/gemma-3-12b-it-heretic。注意具体数值可能因平台和硬件而异。上表是在 RTX 5090 上使用 PyTorch 2.8 编译的。)
当然,数学指标和自动化基准测试从来都不能说明全部问题,也不能替代人工评估。使用 Heretic 生成的模型已获得用户好评(添加了链接并强调):
"我之前持怀疑态度,但刚下载了 GPT-OSS 20B Heretic 模型,天哪。它能针对敏感话题给出格式正确的长回复,使用你期望未审查模型会使用的准确未审查词汇,还能生成包含细节的 markdown 表格等等。看起来这是迄今为止该模型最好的去审查版本……" (评论链接)
"Heretic GPT 20b 似乎是我试过的最好的未审查模型。它没有破坏模型的智能,而且能正常回答那些基础模型通常会拒绝的提示。" (评论链接)
"[Qwen3-4B-Instruct-2507-heretic] 是我在 16GB 显存上能运行的最佳未量化去审查模型。" (评论链接)
Heretic 模型也已使用 MMLU 和 GSM8K 等标准指标进行了独立基准测试,并被认为与竞争去审查工具产生的模型相比具有竞争力: 1、 2。
社区已使用 Heretic 创建并发布了 超过 3000 个 模型。
使用方法
准备一个安装了 PyTorch 2.2+ 的 Python 3.10+ 环境(根据你的硬件选择合适的版本)。然后运行:
pip install -U heretic-llm
heretic Qwen/Qwen3-4B-Instruct-2507
将 Qwen/Qwen3-4B-Instruct-2507 替换为你想要去除审查的模型。
[!重要]
虽然 PyTorch 2.2 是 Heretic 所需的最低版本,但某些模型和配置可能需要更高版本才有的功能。例如,加载 gpt-oss 等 MXFP4 量化模型使用了 PyTorch 2.6 中新增的
torch.accelerator。
[!提示]
Heretic 使用 uv 进行依赖管理,仓库中包含一个
uv.lock文件,固定了每个包的版本。如果你已经使用 uv(建议使用),你可以直接克隆仓库并运行uv run heretic,这样可以确保依赖项与开发者使用的匹配,提高可靠性和安全性。
整个过程完全自动化,无需配置;不过,Heretic 有各种可配置参数,以便更精细的控制。运行 heretic --help 查看可用的命令行选项,或者查看 config.default.toml 如果你更喜欢使用配置文件。
在程序运行开始时,Heretic 会基准测试系统以确定最佳批处理大小,从而充分利用可用硬件。在 RTX 3090 上,使用默认配置,去除 Qwen3-4B-Instruct-2507 的审查大约需要 20-30 分钟。注意,Heretic 支持使用 bitsandbytes 进行模型量化,这可以大幅减少处理模型所需的 VRAM。将 quantization 选项设置为 bnb_4bit 即可启用量化。
Heretic 完成模型去审查后,系统会提示你是否保存模型、上传到 Hugging Face、通过聊天测试效果、运行标准基准测试,或者同时执行多个操作。
研究功能
除了主要功能(移除模型审查)外,Heretic 还提供了一些旨在支持模型内部语义研究(可解释性)的功能。要使用这些功能,你需要安装带有额外依赖 research 的 Heretic:
pip install -U heretic-llm[research]
这让你可以使用以下功能:
通过传递 --plot-residuals 生成残差向量图
使用此标志运行时,Heretic 将:
- 计算第一个输出 token 在所有 Transformer 层的残差向量(隐藏状态),包括"有害"和"无害"提示。
- 使用 PaCMAP 投影 从残差空间投影到 2D 空间。
- 通过几何中位数将"有害"/"无害"残差的投影左右对齐,使连续层的投影更相似。此外,PaCMAP 会使用上一层的投影初始化新层的投影,以减少突兀的过渡。
- 生成散点图,为每一层生成 PNG 图像。
- 生成动画 GIF,展示残差在层间变换的过程。
请参阅配置文件中的选项,你可以控制生成图表的各个方面。
注意,PaCMAP 是一项昂贵的操作,在 CPU 上执行。对于较大的模型,计算所有层的投影可能需要一个多小时。
通过传递 --print-residual-geometry 打印残差几何细节
如果你对"有害"和"无害"提示的残差向量之间关系的定量分析感兴趣,此标志会为你提供以下表格,其中包含有助于理解这些关系的指标(此处以 gemma-3-270m-it 为例):
┏━━━━━━━┳━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━┳━━━━━━━━━┳━━━━━━━━┓
┃ 层数  ┃ S(g,b) ┃ S(g*,b*) ┃  S(g,r) ┃ S(g*,r*) ┃  S(b,r) ┃ S(b*,r*) ┃      |g| ┃     |g*| ┃      |b| ┃     |b*| ┃     |r| ┃    |r*| ┃   Silh ┃
┡━━━━━━━╇━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━╇━━━━━━━━━╇━━━━━━━━┩
│     1 │ 1.0000 │   1.0000 │ -0.4311 │  -0.4906 │ -0.4254 │  -0.4847 │   170.29 │   170.49 │   169.78 │   169.85 │    1.19 │    1.31 │ 0.0480 │
│     2 │ 1.0000 │   1.0000 │  0.4297 │   0.4465 │  0.4365 │   0.4524 │   768.55 │   768.77 │   771.32 │   771.36 │    6.39 │    5.76 │ 0.0745 │
│     3 │ 0.9999 │   1.0000 │ -0.5699 │  -0.5577 │ -0.5614 │  -0.5498 │  1020.98 │  1021.13 │  1013.80 │  1014.71 │   12.70 │   11.60 │ 0.0920 │
│     4 │ 0.9999 │   1.0000 │  0.6582 │   0.6553 │  0.6659 │   0.6627 │  1356.39 │  1356.20 │  1368.71 │  1367.95 │   18.62 │   17.84 │ 0.0957 │
│     5 │ 0.9987 │   0.9990 │ -0.6880 │  -0.6761 │ -0.6497 │  -0.6418 │   766.54 │   762.25 │   731.75 │   732.42 │   51.97 │   45.24 │ 0.1018 │
│     6 │ 0.9998 │   0.9998 │ -0.1983 │  -0.2312 │ -0.1811 │  -0.2141 │  2417.35 │  2421.08 │  2409.18 │  2411.40 │   43.06 │   43.47 │ 0.0900 │
│     7 │ 0.9998 │   0.9997 │ -0.5258 │  -0.5746 │ -0.5072 │  -0.5560 │  3444.92 │  3474.99 │  3400.01 │  3421.63 │   86.94 │   94.38 │ 0.0492 │
│     8 │ 0.9990 │   0.9991 │  0.8235 │   0.8312 │  0.8479 │   0.8542 │  4596.54 │  4615.62 │  4918.32 │  4934.20 │  384.87 │  377.87 │ 0.2278 │
│     9 │ 0.9992 │   0.9992 │  0.5335 │   0.5441 │  0.5678 │   0.5780 │  5322.30 │  5316.96 │  5468.65 │  5466.98 │  265.68 │  267.28 │ 0.1318 │
│    10 │ 0.9974 │   0.9973 │  0.8189 │   0.8250 │  0.8579 │   0.8644 │  5328.81 │  5325.63 │  5953.35 │  5985.15 │  743.95 │  779.74 │ 0.2863 │
│    11 │ 0.9977 │   0.9978 │  0.4262 │   0.4045 │  0.4862 │   0.4645 │  9644.02 │  9674.06 │  9983.47 │  9990.28 │  743.28 │  726.99 │ 0.1576 │
│    12 │ 0.9904 │   0.9907 │  0.4384 │   0.4077 │  0.5586 │   0.5283 │ 10257.40 │ 10368.50 │ 11114.51 │ 11151.21 │ 1711.18 │ 1664.69 │ 0.1890 │
│    13 │ 0.9867 │   0.9874 │  0.4007 │   0.3680 │  0.5444 │   0.5103 │ 12305.12 │ 12423.75 │ 13440.31 │ 13432.47 │ 2386.43 │ 2282.47 │ 0.1293 │
│    14 │ 0.9921 │   0.9922 │  0.3198 │   0.2682 │  0.4364 │   0.3859 │ 16929.16 │ 17080.37 │ 17826.97 │ 17836.03 │ 2365.23 │ 2301.87 │ 0.1282 │
│    15 │ 0.9846 │   0.9850 │  0.1198 │   0.0963 │  0.2913 │   0.2663 │ 16858.58 │ 16949.44 │ 17496.00 │ 17502.88 │ 3077.08 │ 3029.60 │ 0.1611 │
│    16 │ 0.9686 │   0.9689 │ -0.0029 │  -0.0254 │  0.2457 │   0.2226 │ 18912.77 │ 19074.86 │ 19510.56 │ 19559.62 │ 4848.35 │ 4839.75 │ 0.1516 │
│    17 │ 0.9782 │   0.9784 │ -0.0174 │  -0.0381 │  0.1908 │   0.1694 │ 27098.09 │ 27273.00 │ 27601.12 │ 27653.12 │ 5738.19 │ 5724.21 │ 0.1641 │
│    18 │ 0.9184 │   0.9196 │  0.1343 │   0.1430 │  0.5155 │   0.5204 │   190.16 │   190.35 │   219.91 │   220.62 │   87.82 │   87.59 │ 0.1855 │
└───────┴────────┴──────────┴─────────┴──────────┴─────────┴──────────┴──────────┴──────────┴──────────┴──────────┴─────────┴─────────┴────────┘
g = 良性提示残差向量的均值
g* = 良性提示残差向量的几何中位数
b = 有害提示残差向量的均值
b* = 有害提示残差向量的几何中位数
r = 均值的拒绝方向(即 b - g)
r* = 几何中位数的拒绝方向(即 b* - g*)
S(x,y) = x 和 y 的余弦相似度
|x| = x 的 L2 范数
Silh = 良/恶簇残差的平均轮廓系数
Heretic 的工作原理
Heretic 实现了一种参数化的方向消融变体。对于每个支持的 Transformer 组件(目前是注意力输出投影和 MLP 下投影),它识别每一层中相关的矩阵,并使其相对于相关的"拒绝方向"正交化,从而抑制该方向在与该矩阵相乘的结果中的表达。
拒绝方向是通过计算"有害"和"无害"示例提示的第一个 token 残差的均值差异,为每一层单独计算得出。
消融过程由几个可优化的参数控制:
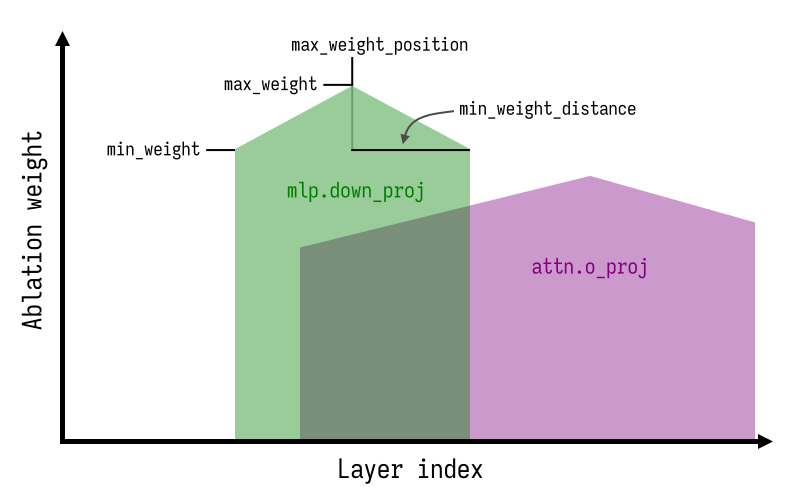
direction_index:要么是拒绝方向的索引,要么是特殊值per layer,表示每一层应使用与该层关联的拒绝方向进行消融。max_weight、max_weight_position、min_weight和min_weight_distance:对于每个组件,这些参数描述了消融权重核在层上的形状和位置。下图说明了这一点:
Heretic 相对于现有去审查系统的主要创新点在于:
- 消融权重核的形状非常灵活,结合自动参数优化,可以改善合规性/质量权衡。非恒定消融权重此前由 Maxime Labonne 在 gemma-3-12b-it-abliterated-v2 中探索过。
- 拒绝方向索引是一个浮点数而非整数。对于非整数值,会对两个最近的拒绝方向向量进行线性插值。这使得除了均值差异计算确定的那些方向之外,还能解锁大量额外的方向,并且通常使优化过程能够找到比任何单个层的方向更好的方向。
- 消融参数是分别为每个组件选择的。我发现 MLP 干预比注意力干预对模型的损害更大,因此使用不同的消融权重可以挤出一些额外的性能。
先前的相关工作
我知道以下公开可用的去审查技术实现:
- AutoAbliteration
- abliterator.py
- wassname 的 Abliterator
- ErisForge
- 使用 HF Transformers 移除拒绝 (Removing refusals with HF Transformers)
- deccp
注意,Heretic 是从头开始编写的,没有重用任何这些项目的代码。
致谢
Heretic 的开发参考了:
- 原始去审查论文 (Arditi et al. 2024)
- Maxime Labonne 关于去审查的文章,以及他个人去审查模型卡中的一些细节(见上文)
- Jim Lai 关于"投影去审查 (projected abliteration)" 和"保范双投影去审查 (norm-preserving biprojected abliteration)" 的文章
引用
如果你在研究中使用 Heretic,请使用以下 BibTeX 条目引用它:
@misc{heretic,
  author = {Weidmann, Philipp Emanuel},
  title = {Heretic: Fully automatic censorship removal for language models},
  year = {2025},
  publisher = {GitHub},
  journal = {GitHub repository},
  howpublished = {\url{https://github.com/p-e-w/heretic}}
}
许可证
版权所有 © 2025-2026 Philipp Emanuel Weidmann(pew@worldwidemann.com) + 贡献者
本程序是自由软件:你可以重新分发和/或修改它,前提是遵守自由软件基金会发布的 GNU Affero 通用公共许可证的条款,无论是许可证的第 3 版,还是(根据你的选择)任何更高版本。
本程序分发时希望它有用,但没有任何保证;甚至没有默示的适销性或特定用途适用性保证。详情请参阅 GNU Affero 通用公共许可证。
你应该已随本程序收到一份 GNU Affero 通用公共许可证的副本。如果没有,请参阅 https://www.gnu.org/licenses/。
通过向本项目贡献代码,你同意在同一许可证下发布你的贡献。