opendataloader-pdf

专为AI数据提取设计的PDF解析器,输出结构化Markdown/JSON(含边界框),支持RAG/LLM管道。混合模式下用AI处理复杂表格、公式、扫描件,综合解析准确率0.907,排名第一。与PDF Association合作,首次开源实现PDF自动标签生成(Tagged PDF),可验证的PDF/UA合规流程,大幅降低无障碍改造成本。Apache 2.0许可,本地运行无数据外传。
README
OpenDataLoader PDF
面向 AI 的 PDF 解析器。自动化 PDF 无障碍。开源。




🔍 面向 AI 数据提取的 PDF 解析器 — 从任意 PDF 中提取 Markdown、JSON(含边界框)和 HTML。基准测试排名第 1(总体 0.907)。确定性本地模式 + AI 混合模式可处理复杂页面。
- 准确性如何? — 基准测试第 1:总体 0.907,表格准确性 0.928(基于 200 份真实 PDF,包括多列和学术论文)。确定性本地模式 + AI 混合模式用于复杂页面(基准测试)
- 支持扫描 PDF 和 OCR 吗? — 是的。混合模式下内置 OCR(80+ 种语言)。可在 300 DPI+ 的低质量扫描件上工作(混合模式)
- 支持表格、公式、图像、图表吗? — 是的。复杂/无边框表格、LaTeX 公式以及 AI 生成的图片/图表描述均通过混合模式实现(混合模式)
- 如何用于 RAG? —
pip install opendataloader-pdf,3 行代码转换。输出结构化 Markdown 用于分块,JSON 含边界框用于来源引用,以及 HTML。提供 LangChain 集成。Python、Node.js、Java SDK(快速入门 | LangChain)
♿ PDF 无障碍自动化 — 大规模将未标记 PDF 自动标记为可供屏幕阅读器使用的 Tagged PDF。第一个端到端生成 Tagged PDF 的开源工具。
- 问题是什么? — 无障碍法规现在在全球范围内强制执行。手动 PDF 修复成本为每份文档 50-200 美元,且无法规模化(法规)
- 哪些是免费的? — 布局分析 + 自动标记(Apache 2.0)。输入未标记 PDF → 输出 Tagged PDF。无专有 SDK 依赖(自动标记)
- PDF/UA 合规性呢? — 将 Tagged PDF 转换为 PDF/UA-1 或 PDF/UA-2 是企业附加功能。自动标记生成 Tagged PDF;PDF/UA 导出是最后一步(流水线)
- 为什么信任这个? — 与 Dual Lab(veraPDF 开发者)合作开发,基于 PDF Association 规范、最佳实践指南和 PDF 社区 的专业知识。自动标记遵循 Well-Tagged PDF 规范,并通过 veraPDF 验证(合作)
30 秒快速入门
要求:Java 11+ 和 Python 3.10+(也支持 Node.js | Java)
开始前:运行
java -version。如果未找到,请从 Adoptium 安装 JDK 11+。
pip install -U opendataloader-pdf
import opendataloader_pdf

# 单次调用批量处理所有文件 — 每次 convert() 会启动一个 JVM 进程,因此重复调用会很慢
opendataloader_pdf.convert(
    input_path=["file1.pdf", "file2.pdf", "folder/"],
    output_dir="output/",
    format="markdown,json"
)
带标注的 PDF 输出 — 每个元素(标题、段落、表格、图像)都检测到边界框和语义类型。
解决了哪些问题?
| 问题 | 解决方案 | 状态 |
|---|---|---|
| 解析过程中 PDF 结构丢失 — 阅读顺序错误、表格损坏、无元素坐标 | 确定性本地模式将 PDF 转换为带有边界框的 Markdown/JSON,XY-Cut++ 阅读顺序 | 已发布 |
| 复杂表格、扫描 PDF、公式、图表需要 AI 级理解 | 混合模式将复杂页面路由到 AI 后端(基准测试第 1) | 已发布 |
| 手动 PDF 修复成本 — 无障碍法规(EAA、ADA、Section 508)要求 Tagged PDF。手动修复成本为每份文档 50-200 美元 | 自动将未标记 PDF 标记为 Tagged PDF(免费,Apache 2.0)。为 PDF/UA 工作流奠定基础;完整的 PDF/UA-1/2 导出是企业附加功能 | 自动标记:已发布。PDF/UA 导出:企业版 |
能力矩阵
| 能力 | 支持 | 层级 |
|---|---|---|
| 数据提取 | ||
| 以正确阅读顺序提取文本 | 是 | 免费 |
| 每个元素的边界框 | 是 | 免费 |
| 表格提取(简单边框) | 是 | 免费 |
| 表格提取(复杂/无边框) | 是 | 免费(混合模式) |
| 标题层级检测 | 是 | 免费 |
| 列表检测(编号、项目符号、嵌套) | 是 | 免费 |
| 带坐标的图像提取 | 是 | 免费 |
| AI 图表/图像描述 | 是 | 免费(混合模式) |
| 扫描 PDF 的 OCR | 是 | 免费(混合模式) |
| 公式提取(LaTeX) | 是 | 免费(混合模式) |
| Tagged PDF 结构提取 | 是 | 免费 |
| AI 安全(提示注入过滤) | 是 | 免费 |
| 页眉/页脚/水印过滤 | 是 | 免费 |
| 无障碍 | ||
| 自动标记 → 将未标记 PDF 转换为 Tagged PDF | 是 | 免费(Apache 2.0) |
| PDF/UA-1、PDF/UA-2 导出 | 💼 可用 | 企业版 |
| 无障碍工作室(可视化编辑器) | 💼 可用 | 企业版 |
| 局限性 | ||
| 处理 Word/Excel/PPT | 否 | — |
| 需要 GPU | 否 | — |
提取基准测试
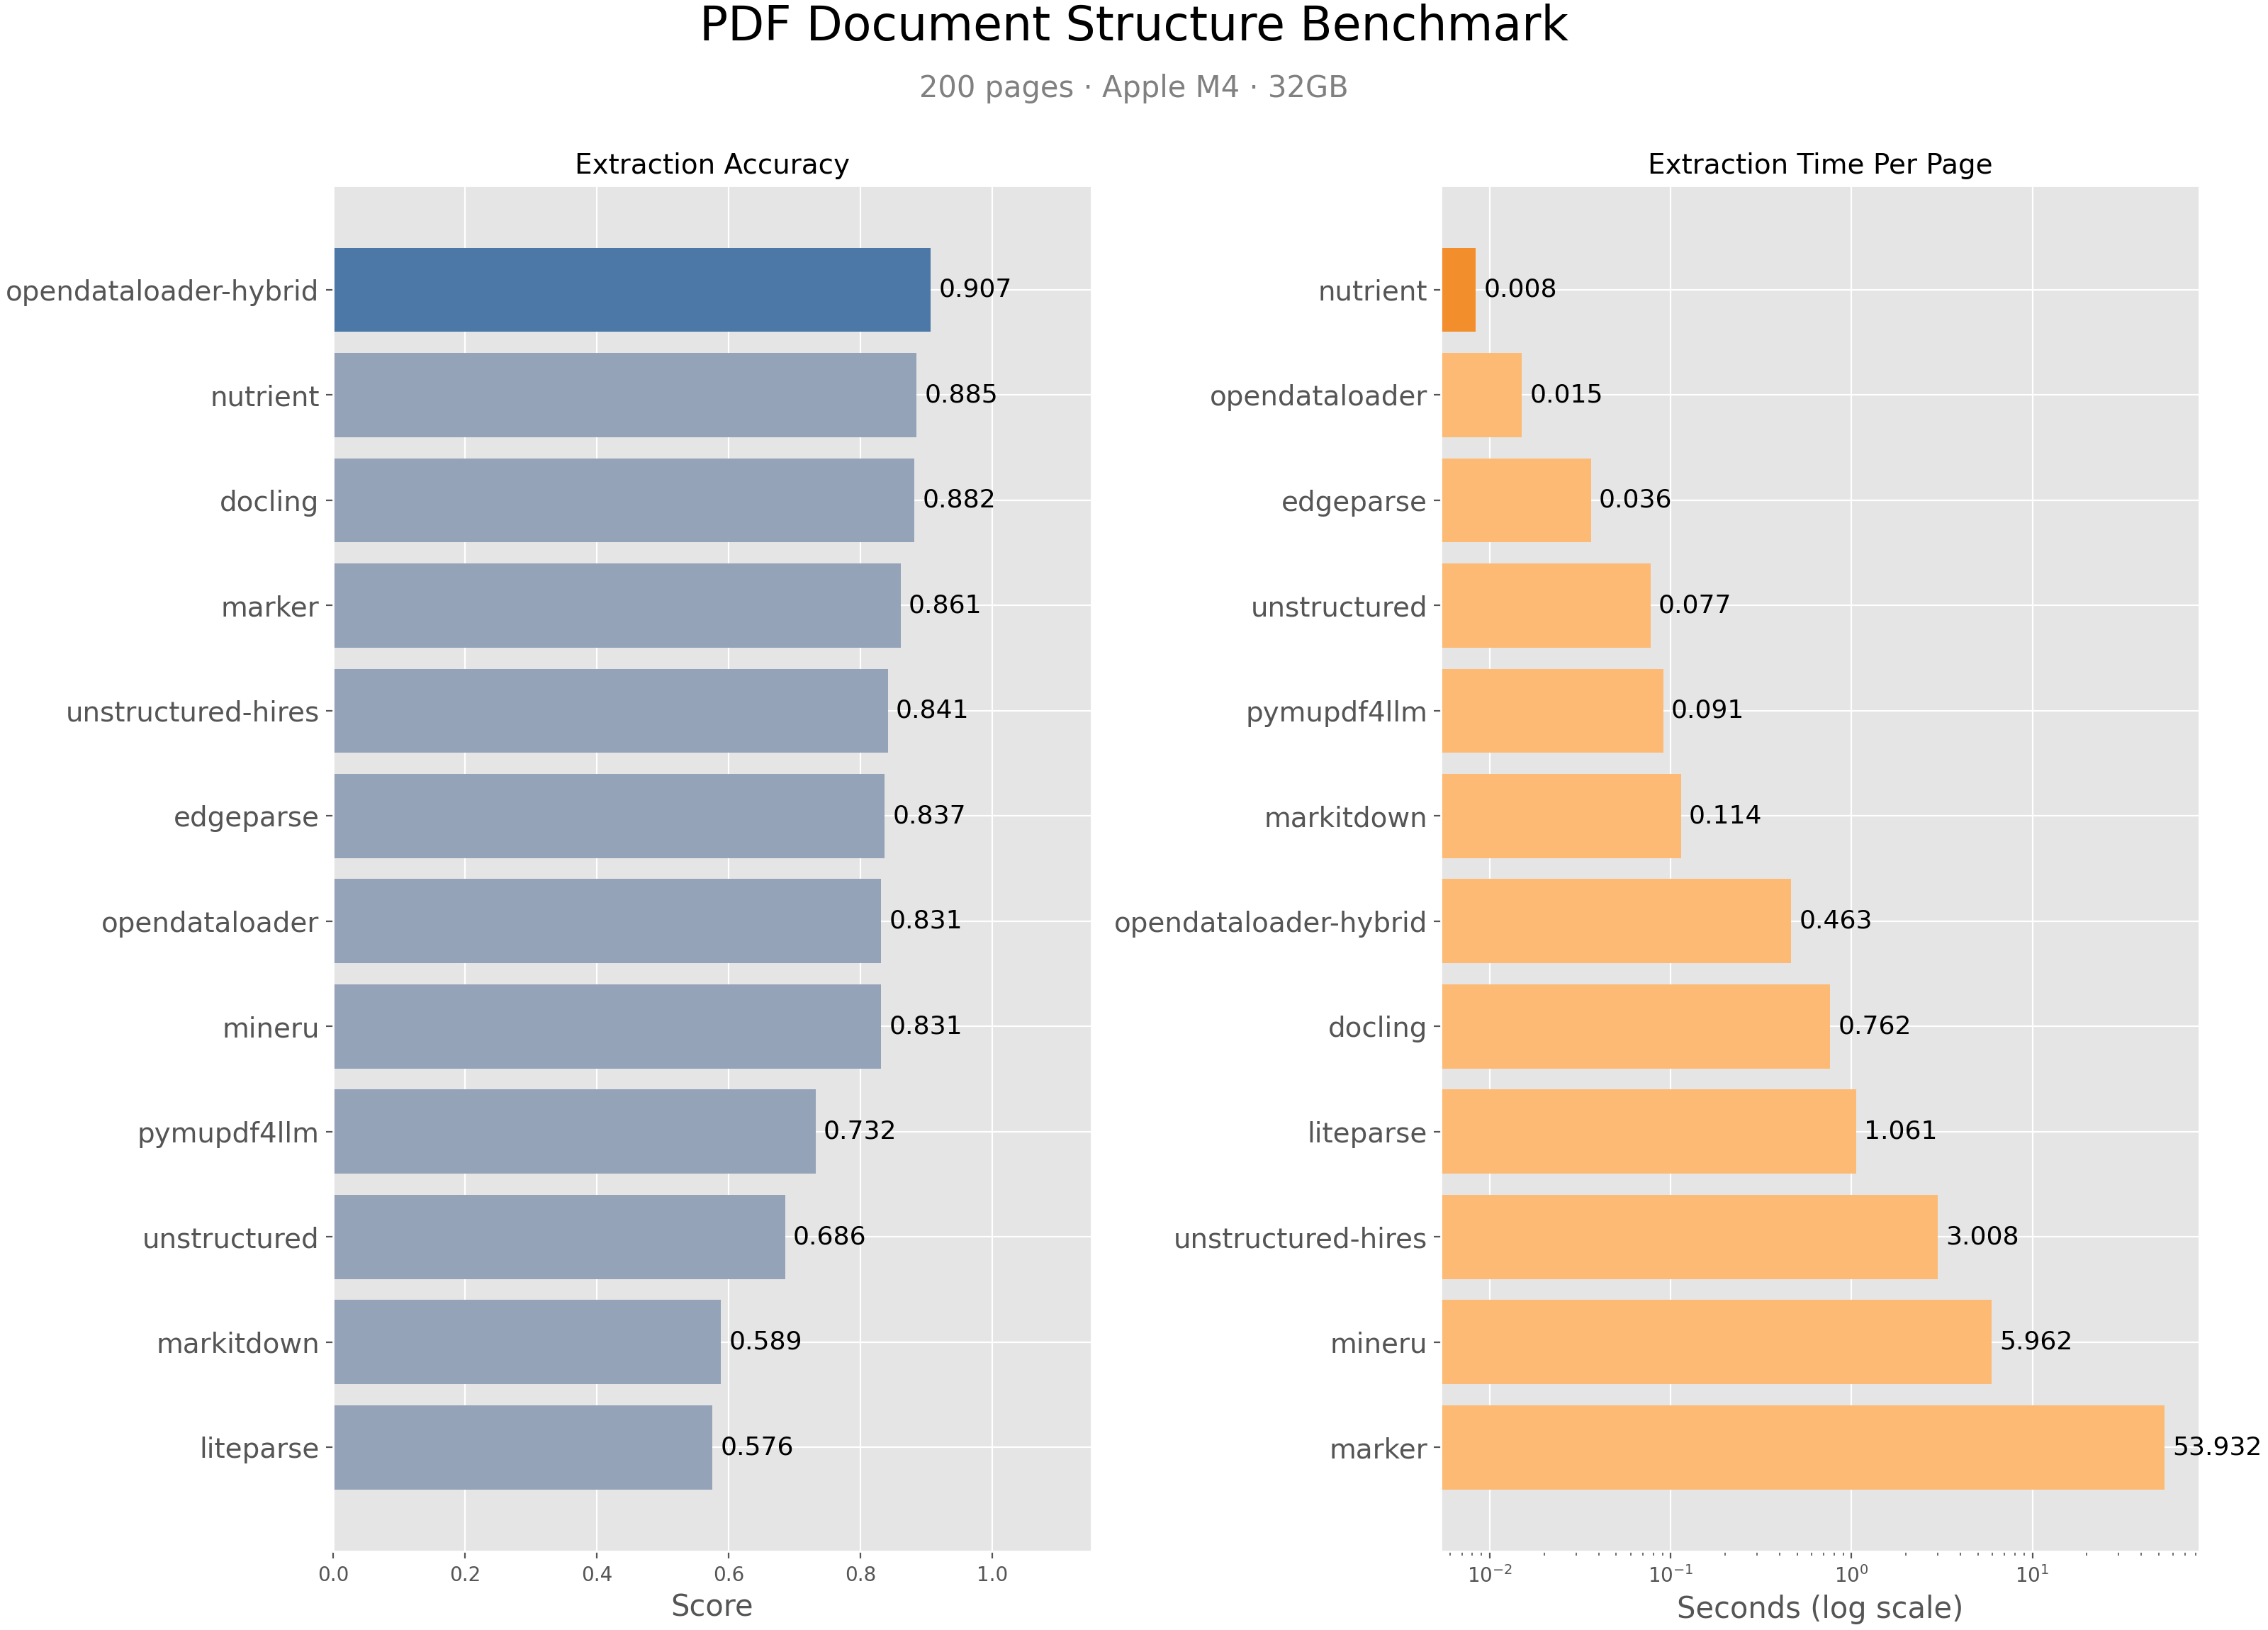
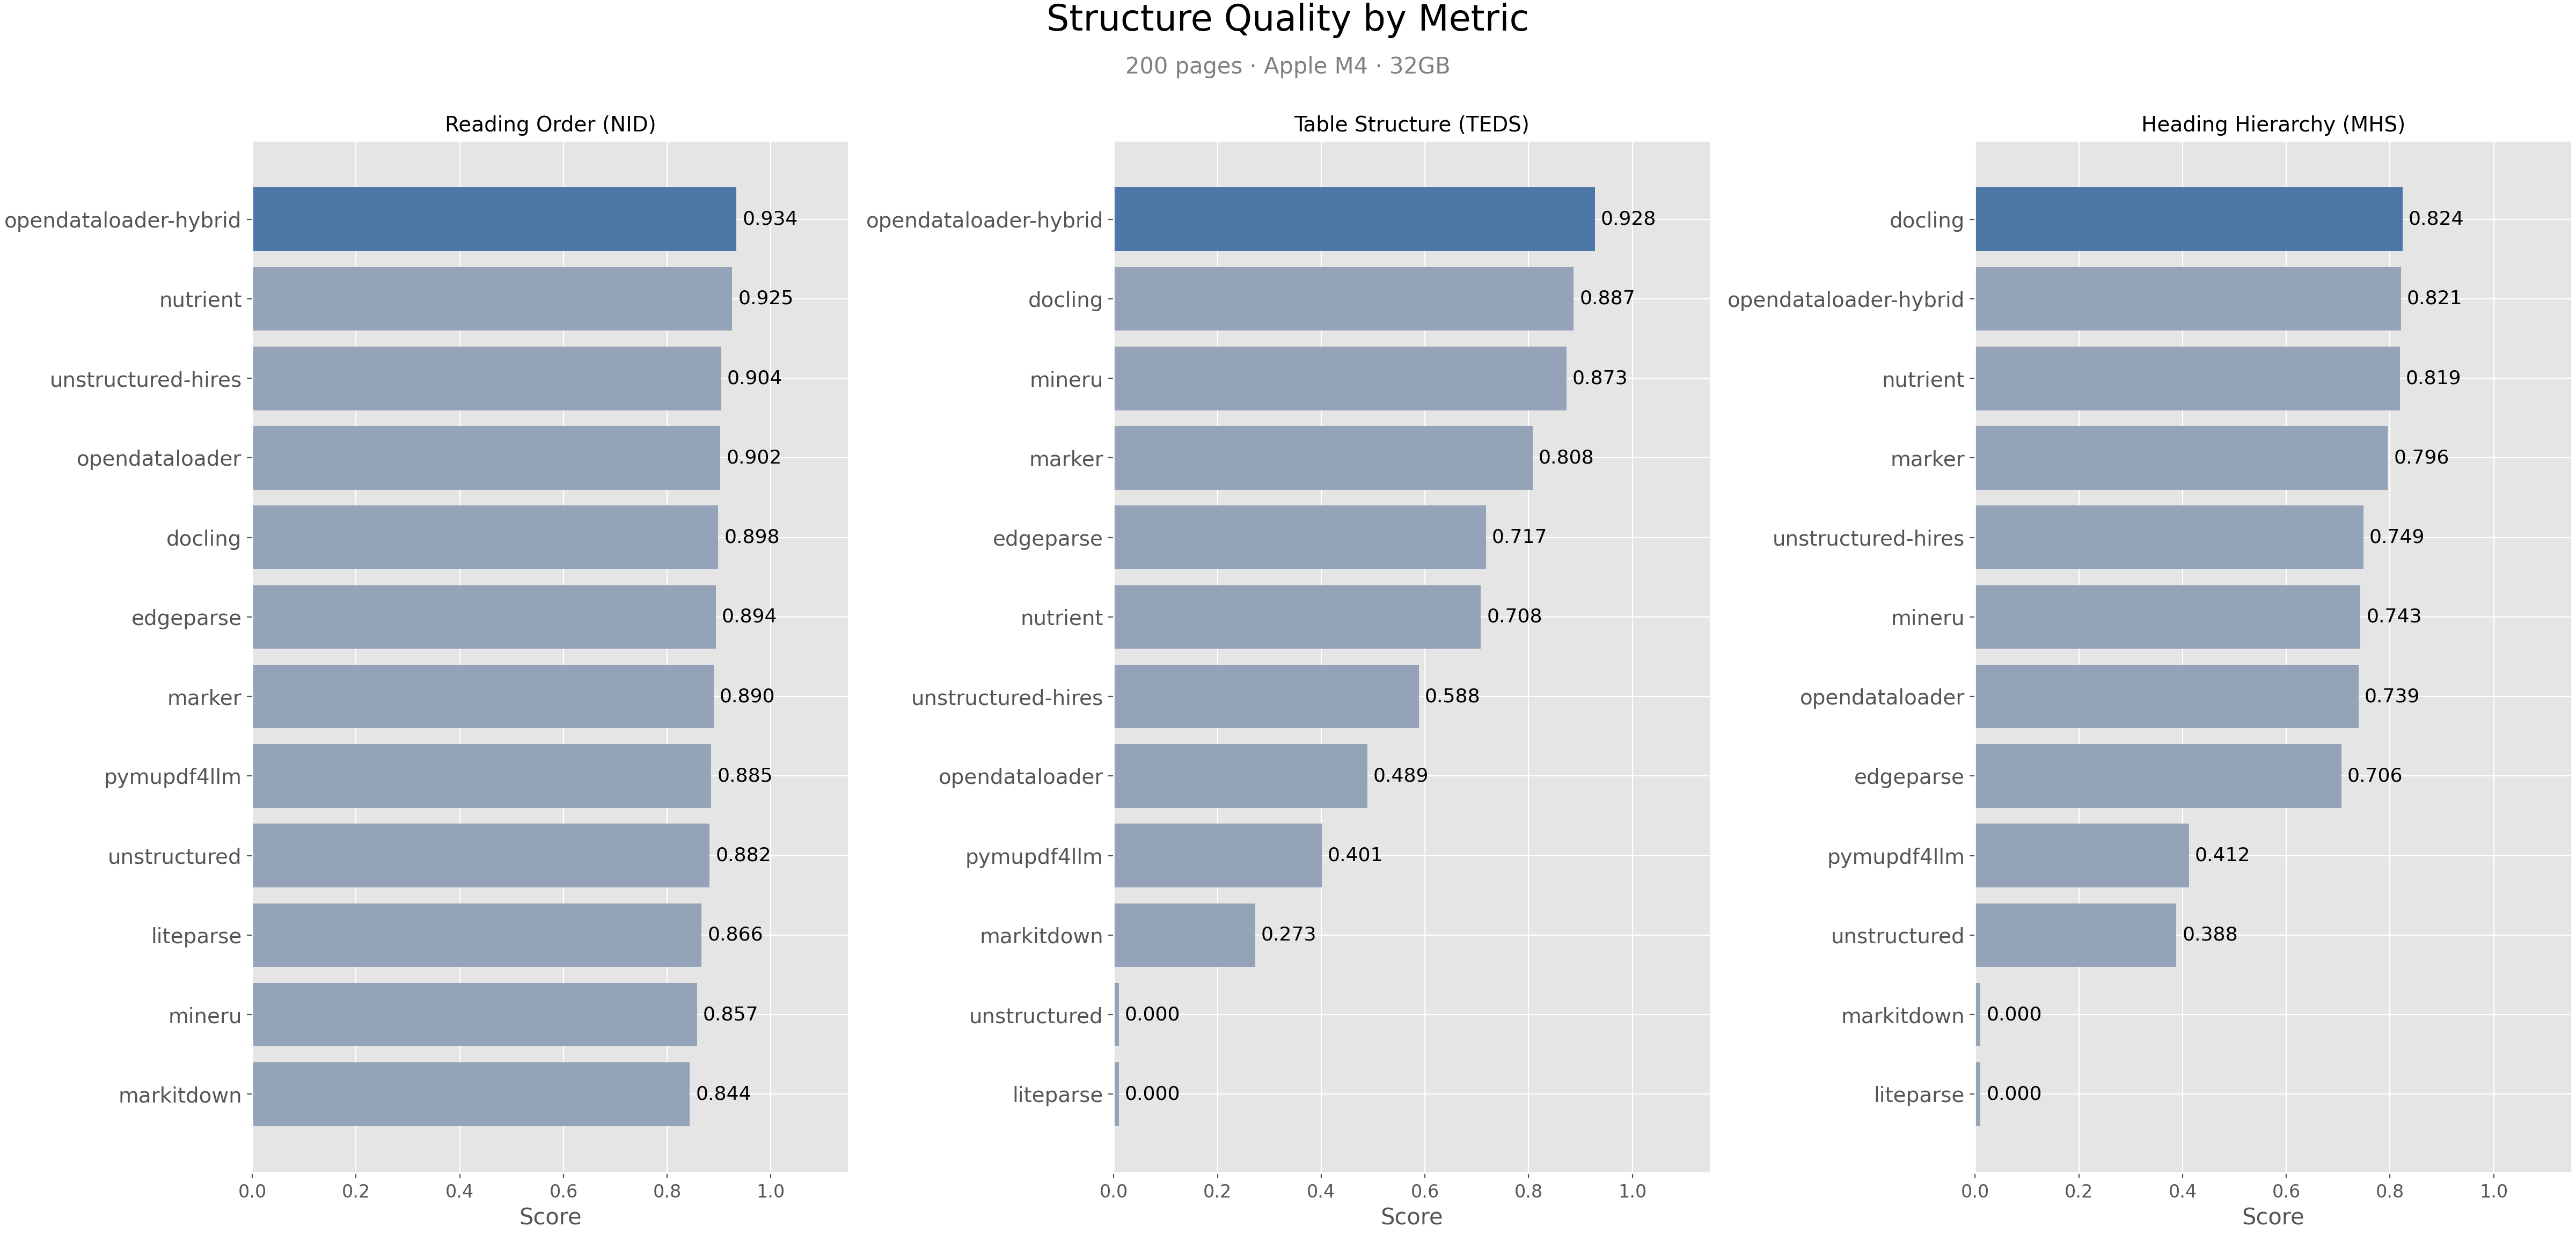
opendataloader-pdf [hybrid] 整体(0.907)排名第 1,涵盖阅读顺序、表格和标题提取准确性。
| 引擎 | 总体 | 阅读顺序 | 表格 | 标题 | 速度(秒/页) | 许可证 |
|---|---|---|---|---|---|---|
| opendataloader [hybrid] | 0.907 | 0.934 | 0.928 | 0.821 | 0.463 | Apache-2.0 |
| nutrient | 0.885 | 0.925 | 0.708 | 0.819 | 0.008 | 商业 |
| docling | 0.882 | 0.898 | 0.887 | 0.824 | 0.762 | MIT |
| marker | 0.861 | 0.890 | 0.808 | 0.796 | 53.932 | GPL-3.0 |
| unstructured [hi_res] | 0.841 | 0.904 | 0.588 | 0.749 | 3.008 | Apache-2.0 |
| edgeparse | 0.837 | 0.894 | 0.717 | 0.706 | 0.036 | Apache-2.0 |
| opendataloader | 0.831 | 0.902 | 0.489 | 0.739 | 0.015 | Apache-2.0 |
| mineru | 0.831 | 0.857 | 0.873 | 0.743 | 5.962 | AGPL-3.0 |
| pymupdf4llm | 0.732 | 0.885 | 0.401 | 0.412 | 0.091 | AGPL-3.0 |
| unstructured | 0.686 | 0.882 | 0.000 | 0.388 | 0.077 | Apache-2.0 |
| markitdown | 0.589 | 0.844 | 0.273 | 0.000 | 0.114 | MIT |
| liteparse | 0.576 | 0.866 | 0.000 | 0.000 | 1.061 | Apache-2.0 |
分数归一化到 [0, 1]。准确性越高越好;速度越低越好。加粗 = 最优。完整基准测试细节
应该使用哪种模式?
| 您的文档 | 模式 | 安装 | 服务端命令 | 客户端命令 |
|---|---|---|---|---|
| 标准数字 PDF | 快速(默认) | pip install opendataloader-pdf |
无需 | opendataloader-pdf file1.pdf file2.pdf folder/ |
| 复杂或嵌套表格 | 混合模式 | pip install "opendataloader-pdf[hybrid]" |
opendataloader-pdf-hybrid --port 5002 |
opendataloader-pdf --hybrid docling-fast file1.pdf file2.pdf folder/ |
| 扫描 / 基于图像的 PDF | 混合模式 + OCR | pip install "opendataloader-pdf[hybrid]" |
opendataloader-pdf-hybrid --port 5002 --force-ocr |
opendataloader-pdf --hybrid docling-fast file1.pdf file2.pdf folder/ |
| 非英语扫描 PDF | 混合模式 + OCR | pip install "opendataloader-pdf[hybrid]" |
opendataloader-pdf-hybrid --port 5002 --force-ocr --ocr-lang "ko,en" |
opendataloader-pdf --hybrid docling-fast file1.pdf file2.pdf folder/ |
| 数学公式 | 混合模式 + 公式 | pip install "opendataloader-pdf[hybrid]" |
opendataloader-pdf-hybrid --enrich-formula |
opendataloader-pdf --hybrid docling-fast --hybrid-mode full file1.pdf file2.pdf folder/ |
| 需要描述的图表 | 混合模式 + 图片 | pip install "opendataloader-pdf[hybrid]" |
opendataloader-pdf-hybrid --enrich-picture-description |
opendataloader-pdf --hybrid docling-fast --hybrid-mode full file1.pdf file2.pdf folder/ |
| 需要无障碍的未标记 PDF | 自动标记 → Tagged PDF | pip install opendataloader-pdf |
无需 | opendataloader-pdf --format tagged-pdf file1.pdf file2.pdf folder/ |
快速入门
Python
pip install -U opendataloader-pdf
import opendataloader_pdf

# 单次调用批量处理所有文件 — 每次 convert() 会启动一个 JVM 进程,因此重复调用会很慢
opendataloader_pdf.convert(
    input_path=["file1.pdf", "file2.pdf", "folder/"],
    output_dir="output/",
    format="markdown,json"
)
Node.js
npm install @opendataloader/pdf
import { convert } from '@opendataloader/pdf';

await convert(['file1.pdf', 'file2.pdf', 'folder/'], {
  outputDir: 'output/',
  format: 'markdown,json'
});
Java
<dependency>
  <groupId>org.opendataloader</groupId>
  <artifactId>opendataloader-pdf-core</artifactId>
</dependency>
Python 快速入门 | Node.js 快速入门 | Java 快速入门
混合模式:复杂 PDF 的 #1 准确性
混合模式结合了快速的本地 Java 处理与 AI 后端。简单页面留在本地处理(0.02 秒);复杂页面路由到 AI 以获得 +90% 的表格准确性。
pip install -U "opendataloader-pdf[hybrid]"
终端 1 — 启动后端服务器:
opendataloader-pdf-hybrid --port 5002
终端 2 — 处理 PDF:
# 单次调用批量处理所有文件 — 每次调用会启动一个 JVM 进程,因此重复调用会很慢
opendataloader-pdf --hybrid docling-fast file1.pdf file2.pdf folder/
Python:
# 单次调用批量处理所有文件 — 每次 convert() 会启动一个 JVM 进程,因此重复调用会很慢
opendataloader_pdf.convert(
    input_path=["file1.pdf", "file2.pdf", "folder/"],
    output_dir="output/",
    hybrid="docling-fast"
)
扫描 PDF 的 OCR
对于没有可选文本的基于图像的 PDF,使用 --force-ocr 启动后端:
opendataloader-pdf-hybrid --port 5002 --force-ocr
对于非英语文档,指定语言:
opendataloader-pdf-hybrid --port 5002 --force-ocr --ocr-lang "ko,en"
支持的语言:en、ko、ja、ch_sim、ch_tra、de、fr、ar 等。
公式提取(LaTeX)
从科学 PDF 中提取数学公式为 LaTeX:
# 服务器:启用公式增强
opendataloader-pdf-hybrid --enrich-formula

# 单次调用批量处理所有文件 — 每次调用会启动一个 JVM 进程,因此重复调用会很慢
opendataloader-pdf --hybrid docling-fast --hybrid-mode full file1.pdf file2.pdf folder/
JSON 输出:
{
  "type": "formula",
  "page number": 1,
  "bounding box": [226.2, 144.7, 377.1, 168.7],
  "content": "\\frac{f(x+h) - f(x)}{h}"
}
注意:公式和图片描述增强需要在客户端使用
--hybrid-mode full。
图表和图像描述
为图表和图像生成 AI 描述 — 有助于 RAG 搜索和无障碍替代文本:
# 服务器
opendataloader-pdf-hybrid --enrich-picture-description

# 单次调用批量处理所有文件 — 每次调用会启动一个 JVM 进程,因此重复调用会很慢
opendataloader-pdf --hybrid docling-fast --hybrid-mode full file1.pdf file2.pdf folder/
JSON 输出:
{
  "type": "picture",
  "page number": 1,
  "bounding box": [72.0, 400.0, 540.0, 650.0],
  "description": "A bar chart showing waste generation by region from 2016 to 2030..."
}
使用 SmolVLM (256M),一个轻量级视觉模型。通过
--picture-description-prompt支持自定义提示词。
Hancom Data Loader 集成 — 即将推出
通过 Hancom Data Loader 实现企业级 AI 文档分析 — 客户定制的模型,针对特定领域文档进行训练。30 多种元素类型(表格、图表、公式、标题、脚注等),基于 VLM 的图像/图表理解,复杂表格提取(合并单元格、嵌套表格),有 SLA 保障的扫描文档 OCR,以及原生 HWP/HWPX 支持。支持 PDF、DOCX、XLSX、PPTX、HWP、PNG、JPG。在线演示
输出格式
| 格式 | 使用场景 |
|---|---|
| JSON | 包含边界框、语义类型的结构化数据 |
| Markdown | 用于 LLM 上下文的整洁文本,RAG 分块 |
| HTML | 带有样式的网页显示 |
| 带标注的 PDF | 可视化调试 — 查看检测到的结构(示例) |
| 文本 | 纯文本提取 |
组合格式:format="json,markdown"
JSON 输出示例
{
  "type": "heading",
  "id": 42,
  "level": "Title",
  "page number": 1,
  "bounding box": [72.0, 700.0, 540.0, 730.0],
  "heading level": 1,
  "font": "Helvetica-Bold",
  "font size": 24.0,
  "text color": "[0.0]",
  "content": "Introduction"
}
| 字段 | 描述 |
|---|---|
type |
元素类型:heading(标题)、paragraph(段落)、table(表格)、list(列表)、image(图像)、caption(标题)、formula(公式) |
id |
用于交叉引用的唯一标识符 |
page number |
从 1 开始的页码引用 |
bounding box |
PDF 点单位中的 [left, bottom, right, top](72pt = 1 英寸) |
heading level |
标题深度(1+) |
content |
提取的文本 |
高级功能
Tagged PDF 支持
当 PDF 具有结构标签时,OpenDataLoader 提取作者预期的精确布局 — 无需猜测,无需启发式方法。标题、列表、表格和阅读顺序均从源文件保留。
输出质量取决于标签质量。 并非所有 Tagged PDF 都标记良好。对于标签稀疏或不正确的 PDF,默认的启发式模式或
--hybrid docling-fast通常能产生更好的结果。
# 单次调用批量处理所有文件 — 每次 convert() 会启动一个 JVM 进程,因此重复调用会很慢
opendataloader_pdf.convert(
    input_path=["file1.pdf", "file2.pdf", "folder/"],
    output_dir="output/",
    use_struct_tree=True           # 使用原生 PDF 结构标签
)
大多数 PDF 解析器完全忽略结构标签。了解更多
AI 安全:提示注入保护
PDF 可能包含隐藏的提示注入攻击。OpenDataLoader 自动过滤:
- 隐藏文本(透明、零号字体)
- 页面外内容
- 可疑的不可见图层
要清理敏感数据(电子邮件、URL、电话号码 → 占位符),请显式启用:
# 单次调用批量处理所有文件 — 每次调用会启动一个 JVM 进程,因此重复调用会很慢
opendataloader-pdf file1.pdf file2.pdf folder/ --sanitize
LangChain 集成
pip install -U langchain-opendataloader-pdf
from langchain_opendataloader_pdf import OpenDataLoaderPDFLoader

loader = OpenDataLoaderPDFLoader(
    file_path=["file1.pdf", "file2.pdf", "folder/"],
    format="text"
)
documents = loader.load()
LangChain 文档 | GitHub | PyPI
高级选项
# 单次调用批量处理所有文件 — 每次 convert() 会启动一个 JVM 进程,因此重复调用会很慢
opendataloader_pdf.convert(
    input_path=["file1.pdf", "file2.pdf", "folder/"],
    output_dir="output/",
    format="json,markdown,pdf",
    image_output="embedded",        # "off"、"embedded"(Base64)或 "external"(默认)
    image_format="jpeg",            # "png" 或 "jpeg"
    use_struct_tree=True,           # 使用原生 PDF 结构
)
PDF 无障碍与 PDF/UA 转换
问题:数百万现有的 PDF 缺乏结构标签,无法满足无障碍法规(EAA、ADA/Section 508、韩国数字包容法案)。手动修复成本为每份文档 50-200 美元,且无法规模化。
OpenDataLoader 的方法:与 PDF Association 和 Dual Lab(veraPDF 的开发者,veraPDF 是行业参考的开源 PDF/A 和 PDF/UA 验证器)合作构建。自动标记遵循 Well-Tagged PDF 规范,并通过 veraPDF 进行程序化验证 — 自动进行符合性检查,无需人工审查。现有的开源工具没有一个能够端到端生成 Tagged PDF — 大多数依赖专有 SDK 进行标签写入。OpenDataLoader 在 Apache 2.0 下完成所有这些工作。(合作详情)
| 法规 | 截止日期 | 要求 |
|---|---|---|
| 欧洲无障碍法案(EAA) | 2025 年 6 月 28 日 | 欧盟境内可访问的数字产品 |
| ADA 与 Section 508 | 已生效 | 美国联邦机构和公共住宿 |
| 数字包容法案 | 已生效 | 韩国数字服务无障碍 |
标准与验证
| 方面 | 详情 |
|---|---|
| 规范 | PDF Association 的 Well-Tagged PDF |
| 验证 | veraPDF — 行业参考的开源 PDF/A 和 PDF/UA 验证器 |
| 合作 | PDF Association + Dual Lab(veraPDF 开发者)共同开发标记和验证 |
| 许可证 | 自动标记 → Tagged PDF:Apache 2.0(免费)。PDF/UA 导出:企业版 |
无障碍流水线
| 步骤 | 功能 | 状态 | 层级 |
|---|---|---|---|
| 1. 审计 | 读取现有 PDF 标签,检测未标记的 PDF | 已发布 | 免费 |
| 2. 自动标记 → Tagged PDF | 为未标记的 PDF 生成结构标签 | 已发布 | 免费(Apache 2.0) |
| 3. 导出 PDF/UA | 转换为符合 PDF/UA-1 或 PDF/UA-2 的文件 | 💼 可用 | 企业版 |
| 4. 可视化编辑 | 无障碍工作室 — 审查和修复标签 | 💼 可用 | 企业版 |
💼 企业功能可按需提供。联系我们 开始。
自动标记
从未标记的 PDF 生成 Tagged PDF — 输出是一个带有结构标签(标题、段落、列表、表格、阅读顺序)、可被屏幕阅读器读取的 PDF。
import opendataloader_pdf

# 未标记 PDF 输入 → Tagged PDF 输出
opendataloader_pdf.convert(
    input_path=["file1.pdf", "file2.pdf", "folder/"],
    output_dir="output/",
    format="tagged-pdf"
)
# CLI
opendataloader-pdf --format tagged-pdf file1.pdf file2.pdf folder/
与其他格式组合:format="json,tagged-pdf"。
端到端合规工作流
现有 PDF(未标记)
    │
    ▼
┌─────────────────┐    ┌──────────────────┐    ┌─────────────────┐    ┌──────────────────┐
│  1. 审计        │───>│  2. 自动标记     │───>│  3. 导出        │───>│  4. 工作室       │
│  (检查标签)    │    │  (→ Tagged PDF) │    │  (PDF/UA)      │    │  (可视化编辑器)  │
└─────────────────┘    └──────────────────┘    └─────────────────┘    └──────────────────┘
        │                       │                       │                      │
        ▼                       ▼                       ▼                      ▼
  use_struct_tree      format="tagged-pdf"        PDF/UA export       无障碍工作室
  (现已可用)          (可用,Apache 2.0)         (企业版)           (企业版)
路线图
| 功能 | 时间线 | 层级 |
|---|---|---|
| Hancom Data Loader — 企业级 AI 文档分析、客户定制模型、基于 VLM 的图表/图像理解、生产级 OCR | 2026 年第二至第三季度 | 计划中 |
| 结构验证 — 验证 PDF 标签树 | 2026 年第三季度 | 计划中 |
常见问题
用于 RAG 的最佳 PDF 解析器是什么?
对于 RAG 流水线,您需要一个能够保留文档结构、保持正确阅读顺序并提供元素坐标用于引用的解析器。OpenDataLoader 专门为此设计 — 它输出带有边界框的结构化 JSON,使用 XY-Cut++ 处理多列布局,并在本地运行无需 GPU。在混合模式下,它在基准测试中总体排名第 1(0.907)。
最佳的开源 PDF 解析器是什么?
OpenDataLoader PDF 是唯一结合了以下特性的开源解析器:基于规则的确定性提取(无需 GPU)、每个元素的边界框、XY-Cut++ 阅读顺序、内置 AI 安全过滤器、原生 Tagged PDF 支持以及用于复杂文档的 AI 混合模式。它在本地 CPU 上运行,总体准确性排名第 1(0.907)。
如何从 PDF 中提取表格供 LLM 使用?
OpenDataLoader 通过边框分析和文本聚类检测表格,保留行/列结构。对于复杂表格,启用混合模式可将准确性提升 +90%(0.489 到 0.928 TEDS 分数):
# 单次调用批量处理所有文件 — 每次 convert() 会启动一个 JVM 进程,因此重复调用会很慢
opendataloader_pdf.convert(
    input_path=["file1.pdf", "file2.pdf", "folder/"],
    output_dir="output/",
    format="json",
    hybrid="docling-fast"           # 用于复杂表格
)
与 docling、marker 或 pymupdf4llm 相比如何?
OpenDataLoader [hybrid] 在阅读顺序、表格和标题准确性方面总体排名第 1(0.907)。关键区别:docling (0.882) 很强但缺乏边界框和 AI 安全过滤器。marker (0.861) 需要 GPU 且慢 1000 倍(53.932 秒/页)。pymupdf4llm (0.732) 速度快但表格(0.401)和标题(0.412)准确性差。OpenDataLoader 是唯一结合确定性本地提取、每个元素的边界框和内置提示注入保护的解析器。查看完整基准测试。
我可以在不将数据发送到云端的情况下使用它吗?
是的。OpenDataLoader 100% 本地运行。无 API 调用,无数据传输 — 您的文档永远不会离开您的环境。混合模式后端