whisper

通用语音识别模型,基于大规模弱监督训练,支持多语种语音识别、翻译和语言检测。亮点在于开源提供了从tiny到turbo多个尺寸的预训练模型,命令行和Python API开箱即用,MIT许可证便于商业集成。
README
Whisper
Whisper 是一个通用语音识别模型。它在大量多样化音频数据集上训练,也是一个多任务模型,能够执行多语言语音识别、语音翻译和语言识别。
方法
一个 Transformer 序列到序列模型在多种语音处理任务上训练,包括多语言语音识别、语音翻译、口语语言识别和语音活动检测。这些任务被联合表示为解码器要预测的一系列 token,使得单个模型可以取代传统语音处理管道的多个阶段。多任务训练格式使用一组特殊 token,这些 token 充当任务说明符或分类目标。
环境配置
我们使用 Python 3.9.9 和 PyTorch 1.10.1 来训练和测试模型,但代码库预计与 Python 3.8-3.11 以及较新版本的 PyTorch 兼容。代码库还依赖几个 Python 包,最值得注意的是 OpenAI 的 tiktoken 用于其快速分词器实现。你可以通过以下命令下载并安装(或更新到)Whisper 的最新版本:
pip install -U openai-whisper
或者,以下命令将从该仓库拉取并安装最新的提交及其 Python 依赖项:
pip install git+https://github.com/openai/whisper.git
要将包更新到此仓库的最新版本,请运行:
pip install --upgrade --no-deps --force-reinstall git+https://github.com/openai/whisper.git
它还要求系统上安装命令行工具 ffmpeg,该工具可从大多数包管理器获取:
# 在 Ubuntu 或 Debian 上
sudo apt update && sudo apt install ffmpeg

# 在 Arch Linux 上
sudo pacman -S ffmpeg

# 在 MacOS 上使用 Homebrew (https://brew.sh/)
brew install ffmpeg

# 在 Windows 上使用 Chocolatey (https://chocolatey.org/)
choco install ffmpeg

# 在 Windows 上使用 Scoop (https://scoop.sh/)
scoop install ffmpeg
你可能还需要安装 rust,以防 tiktoken 没有为你的平台提供预构建的 wheel。如果在上述 pip install 命令期间看到安装错误,请按照 Getting started 页面 安装 Rust 开发环境。此外,你可能需要配置 PATH 环境变量,例如 export PATH="$HOME/.cargo/bin:$PATH"。如果安装失败并报错 No module named 'setuptools_rust',你需要安装 setuptools_rust,例如运行:
pip install setuptools-rust
可用模型和语言
有六种模型大小,其中四种提供纯英文版本,在速度和准确性之间进行权衡。 下表列出了可用模型的名称及其近似内存需求和相对于 large 模型的推理速度。 下面的相对速度是通过在 A100 上转录英语语音测量的,实际速度可能因许多因素(包括语言、说话速度和可用硬件)而有显著差异。
| 大小 | 参数 | 纯英文模型 | 多语言模型 | 所需VRAM | 相对速度 |
|---|---|---|---|---|---|
| tiny | 39 M | tiny.en |
tiny |
~1 GB | ~10x |
| base | 74 M | base.en |
base |
~1 GB | ~7x |
| small | 244 M | small.en |
small |
~2 GB | ~4x |
| medium | 769 M | medium.en |
medium |
~5 GB | ~2x |
| large | 1550 M | N/A | large |
~10 GB | 1x |
| turbo | 809 M | N/A | turbo |
~6 GB | ~8x |
用于纯英文应用的 .en 模型通常表现更好,特别是对于 tiny.en 和 base.en 模型。我们观察到对于 small.en 和 medium.en 模型,差异变得不那么显著。
此外,turbo 模型是 large-v3 的优化版本,提供更快的转录速度,同时准确性损失极小。
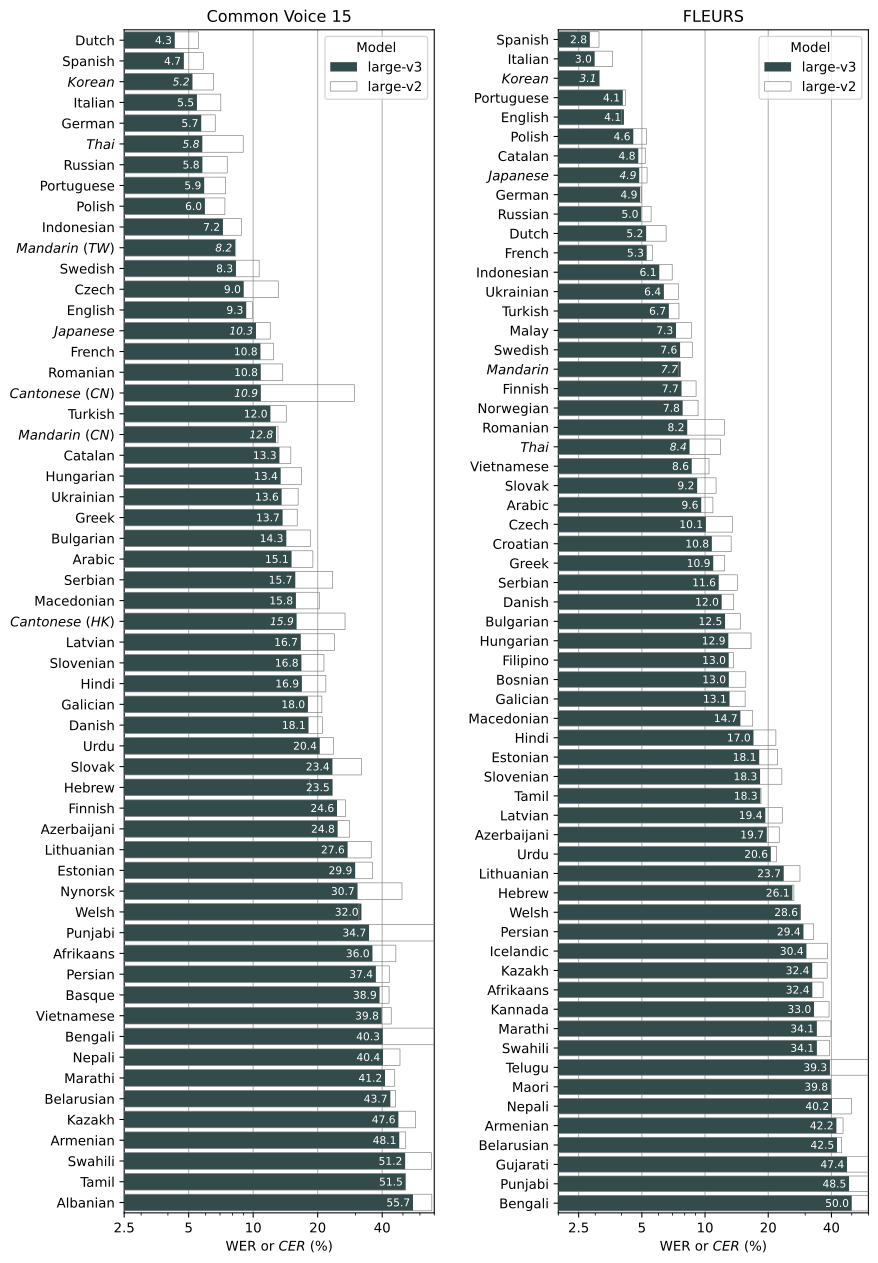
Whisper 的性能因语言而异。下图显示了 large-v3 和 large-v2 模型按语言划分的性能分解,使用在 Common Voice 15 和 Fleurs 数据集上评估的 WER(词错误率)或 CER(字符错误率,以 斜体 显示)。其他模型和数据集的额外 WER/CER 指标可以在 论文 的附录 D.1、D.2 和 D.4 以及翻译的 BLEU 分数(附录 D.3)中找到。
命令行用法
以下命令将使用 turbo 模型转录音频文件中的语音:
whisper audio.flac audio.mp3 audio.wav --model turbo
默认设置(选择 turbo 模型)适用于转录英语。但是,turbo 模型未针对翻译任务进行训练。如果你需要将非英语语音翻译成英语,请使用多语言模型(tiny、base、small、medium、large)之一,而不是 turbo。
例如,要转录包含非英语语音的音频文件,你可以指定语言:
whisper japanese.wav --language Japanese
要将语音翻译成英语,请使用:
whisper japanese.wav --model medium --language Japanese --task translate
注意: 即使指定了
--task translate,turbo模型也会返回原始语言。使用medium或large以获得最佳翻译结果。
运行以下命令查看所有可用选项:
whisper --help
所有可用语言的列表请参见 tokenizer.py。
Python 用法
也可以在 Python 中执行转录:
import whisper

model = whisper.load_model("turbo")
result = model.transcribe("audio.mp3")
print(result["text"])
在内部,transcribe() 方法读取整个文件,并使用滑动的 30 秒窗口处理音频,在每个窗口上执行自回归序列到序列预测。
以下是 whisper.detect_language() 和 whisper.decode() 的示例用法,它们提供对模型的较低层级访问。
import whisper

model = whisper.load_model("turbo")

# 加载音频并将其填充/修剪为 30 秒
audio = whisper.load_audio("audio.mp3")
audio = whisper.pad_or_trim(audio)

# 生成 log-Mel 频谱图并移动到与模型相同的设备
mel = whisper.log_mel_spectrogram(audio, n_mels=model.dims.n_mels).to(model.device)

# 检测口语语言
_, probs = model.detect_language(mel)
print(f"检测到的语言: {max(probs, key=probs.get)}")

# 解码音频
options = whisper.DecodingOptions()
result = whisper.decode(model, mel, options)

# 打印识别的文本
print(result.text)
更多示例
请使用 Discussions 中的 🙌 展示与分享 类别来分享更多 Whisper 的示例用法和第三方扩展,例如 Web 演示、与其他工具的集成、不同平台的移植等。
许可证
Whisper 的代码和模型权重根据 MIT 许可证发布。请参阅 LICENSE 了解更多详情。