VibeVoice

微软开源的语音AI模型家族,包含ASR和TTS两大方向,核心创新是7.5Hz超低帧率连续语音标记器与下一标记扩散框架。ASR模型可一次性处理60分钟长音频并输出说话人/时间戳/文本结构化转录,TTS支持90分钟多说话人合成,还有轻量0.5B实时流式版本。集成了vLLM推理加速和Hugging Face Transformers支持,在多语言和细粒度控制上表现突出。研究向,非商用建议,需注意深度伪造风险。
README
🎙️ VibeVoice: 开源前沿语音 AI



📰 新闻
2026-03-06: 🚀 VibeVoice ASR 现已作为 Transformers 发布 的一部分!您现在可以通过 Hugging Face Transformers 库直接使用我们的语音识别模型,以便无缝集成到您的项目中。
2026-01-21: 📣 我们开源了 VibeVoice-ASR,一个统一的语音转文本模型,能够单次处理 60 分钟的长音频,生成包含“谁(说话人)、什么时候(时间戳)、说了什么(内容)”的结构化转录,并支持用户自定义上下文。在游乐场中试用。
- ⭐️ VibeVoice-ASR 原生支持多语言,覆盖 50 多种语言——详情请见支持语言。
- 🔥 VibeVoice-ASR 微调代码现已可用!
- ⚡️ 现已支持 vLLM 推理以实现更快的推理速度;更多详情请参阅 vllm-asr。
- 📑 VibeVoice-ASR 技术报告已发布。
2025-12-16: 📣 我们在 VibeVoice‑Realtime‑0.5B 中添加了实验性说话人以供探索,包括九种语言(德语、法语、意大利语、日语、韩语、荷兰语、波兰语、葡萄牙语、西班牙语)的多语言声音和 11 种不同的英语风格声音。试试看。未来将逐步添加更多说话人类型。
2025-12-03: 📣 我们开源了 VibeVoice‑Realtime‑0.5B,一个支持流式文本输入和稳健长语音生成的实时文本转语音模型。在 Colab 中试用。
2025-09-05: VibeVoice 是一个开源研究框架,旨在促进语音合成社区的合作。发布后,我们发现该工具在某些使用场景中与既定意图不一致。由于负责任的 AI 使用是微软的指导原则之一,我们从本仓库中移除了 VibeVoice-TTS 代码。
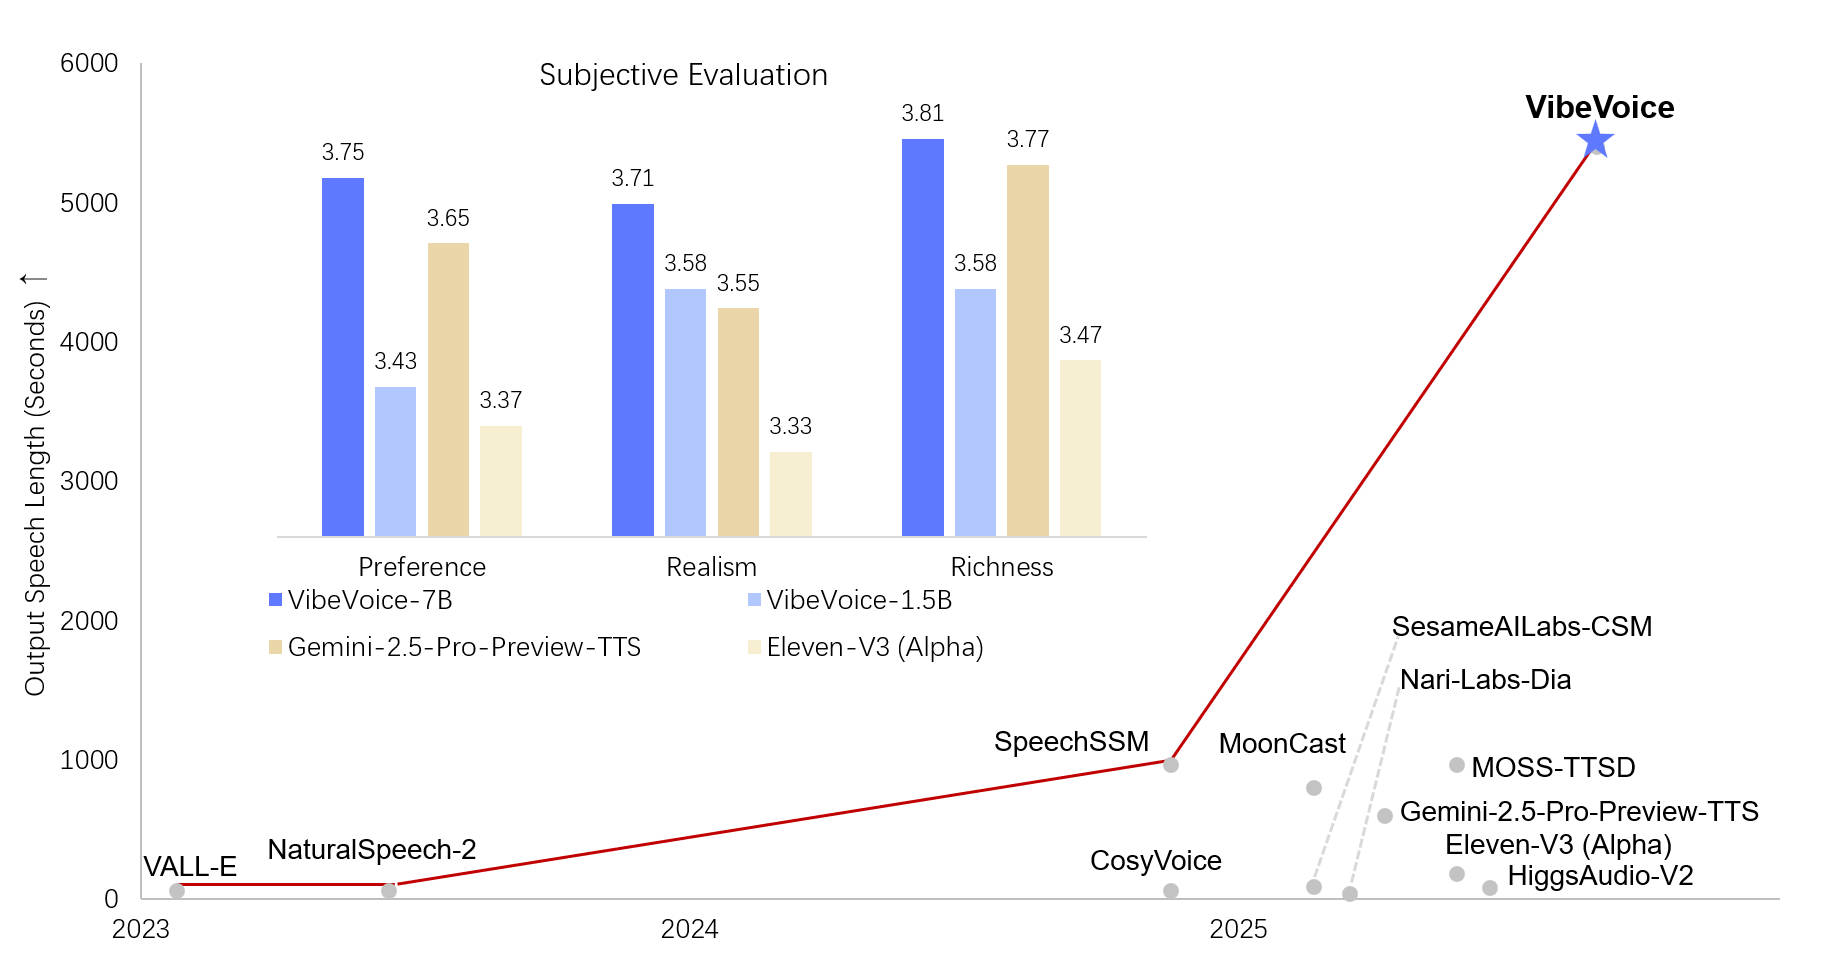
2025-08-25: 📣 我们开源了 VibeVoice-TTS,一个长格式多说话人文本转语音模型,能够合成最长 90 分钟、最多 4 个不同说话人的语音——该工作已被 ICLR 2026 接收为 Oral!🔥
概述
VibeVoice 是一个开源前沿语音 AI 模型系列,包含文本转语音(TTS)和自动语音识别(ASR)模型。
VibeVoice 的一项核心创新是使用连续语音分词器(声学和语义),以极低的 7.5 Hz 帧率运行。这些分词器高效地保留了音频保真度,同时显著提升了长序列处理的计算效率。VibeVoice 采用 下一个 Token 扩散 框架,利用大型语言模型(LLM)理解文本上下文和对话流程,并通过扩散头生成高保真声学细节。
更多信息、演示和示例,请访问我们的项目页面。
| 模型 | 权重 | 快速体验 |
|---|---|---|
| VibeVoice-ASR-7B | HF 链接 | 游乐场 |
| VibeVoice-TTS-1.5B | HF 链接 | 已禁用 |
| VibeVoice-Realtime-0.5B | HF 链接 | Colab |
模型
1. 📖 VibeVoice-ASR - 长语音识别
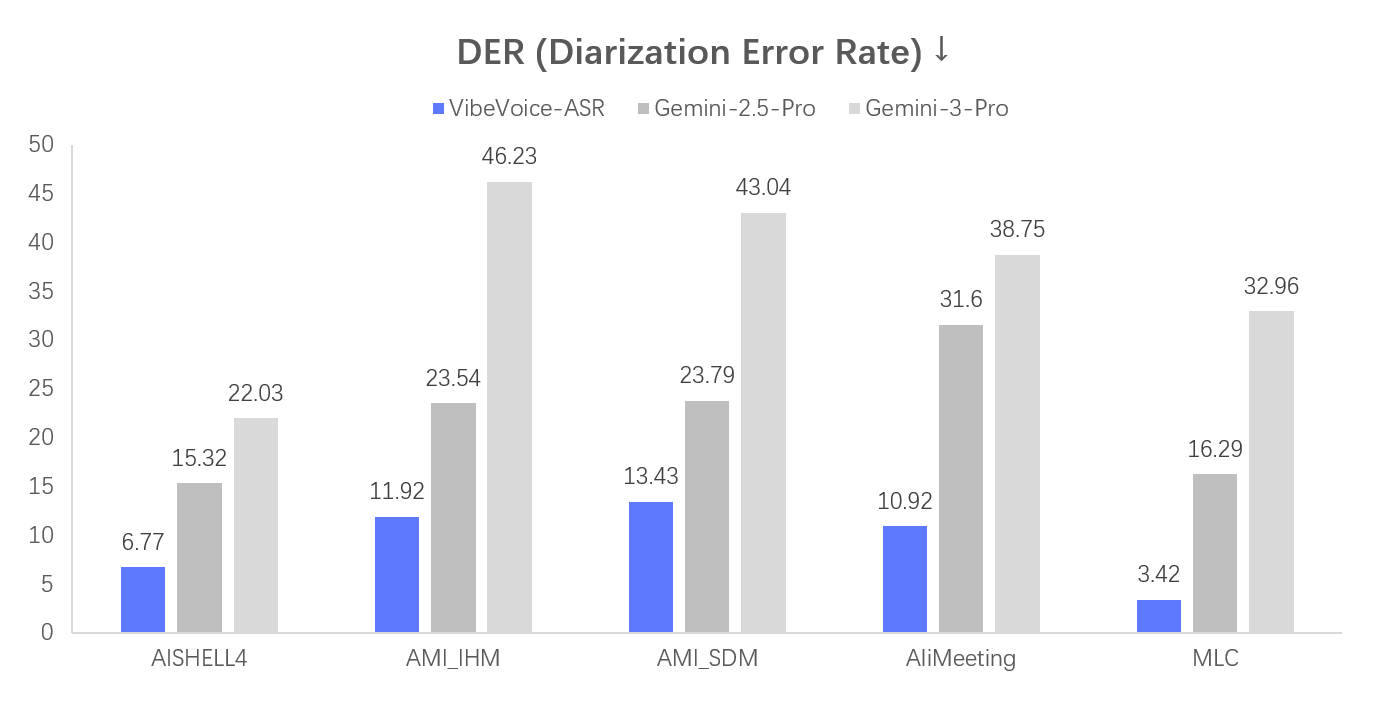
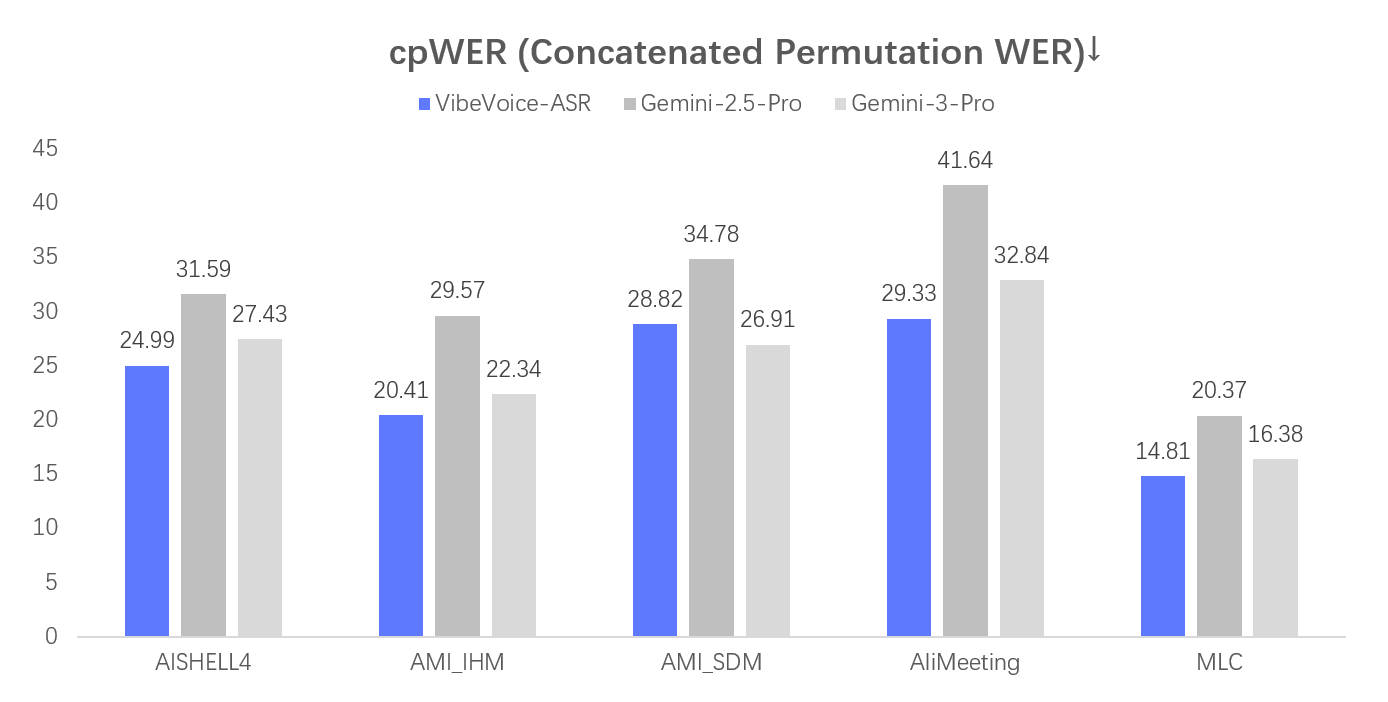
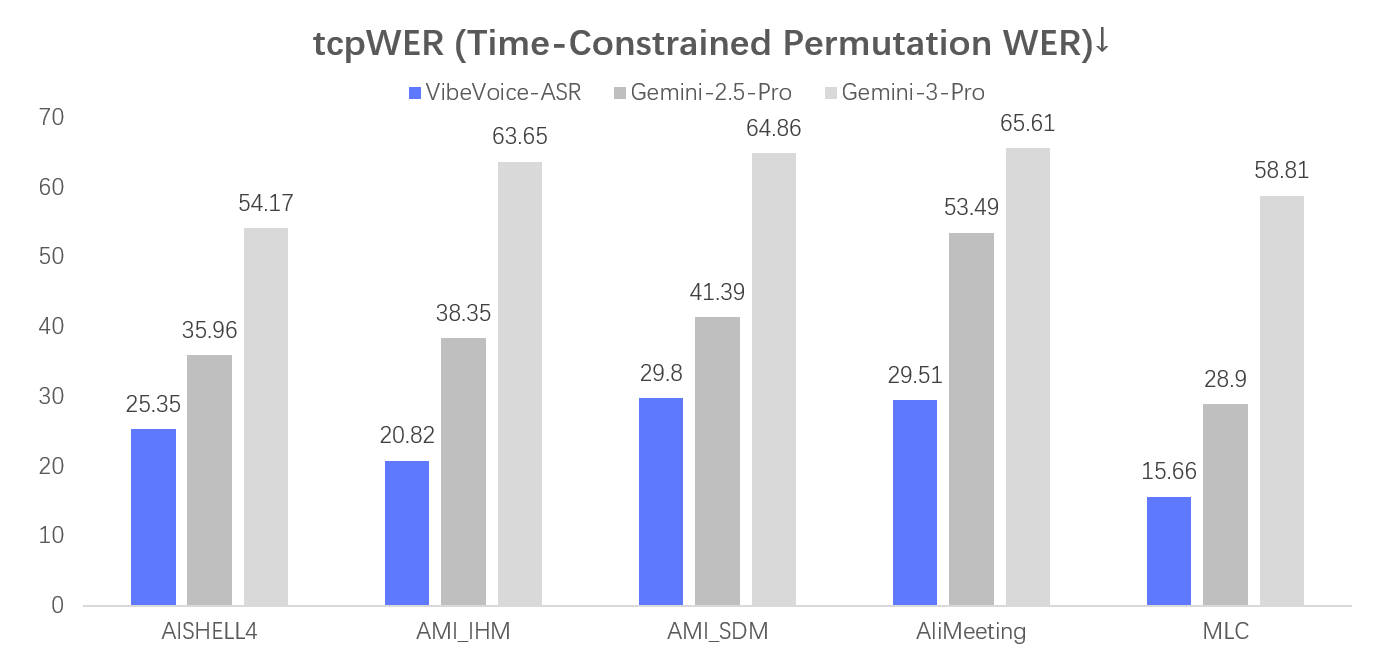
VibeVoice-ASR 是一个统一的语音转文本模型,能够单次处理 60 分钟的长音频,生成包含谁(说话人)、什么时候(时间戳)、说了什么(内容) 的结构化转录,并支持自定义热词。
🕒 60 分钟单次处理: 与将音频切分为短块(常常丢失全局上下文)的传统 ASR 模型不同,VibeVoice-ASR 可在 64K Token 长度内接收最长 60 分钟 的连续音频输入。这确保了在整个一小时内一致的说话人追踪和语义连贯性。
👤 自定义热词: 用户可以提供自定义热词(例如特定名称、技术术语或背景信息)来指导识别过程,显著提升领域特定内容的准确率。
📝 丰富转录(谁、什么时候、说了什么): 该模型联合执行 ASR、说话人日志和时间戳生成,产生结构化输出,指示谁在什么时候说了什么。
📖 文档 | 🤗 Hugging Face | 🎮 游乐场 | 🛠️ 微调 | 📊 论文
https://github.com/user-attachments/assets/acde5602-dc17-4314-9e3b-c630bc84aefa
2. 🎙️ VibeVoice-TTS - 长格式多说话人 TTS
最佳应用场景:长格式对话音频、播客、多说话人对话
⏱️ 90 分钟长格式生成: 单次合成最长 90 分钟 的对话/单说话人语音,在整个过程中保持说话人一致性和语义连贯性。
👥 多说话人支持: 在一次对话中支持最多 4 个不同说话人,具有自然的轮次切换和跨长对话的一致性。
🎭 表现力语音: 生成富有表现力、自然流畅的语音,捕捉对话动态和情感细微差别。
🌐 多语言支持: 支持英语、中文和其他语言。
📖 文档 | 🤗 Hugging Face | 📊 论文
英语
https://github.com/user-attachments/assets/0967027c-141e-4909-bec8-091558b1b784
中文
https://github.com/user-attachments/assets/322280b7-3093-4c67-86e3-10be4746c88f
跨语言
https://github.com/user-attachments/assets/838d8ad9-a201-4dde-bb45-8cd3f59ce722
自发性歌唱
https://github.com/user-attachments/assets/6f27a8a5-0c60-4f57-87f3-7dea2e11c730
4 人长对话
https://github.com/user-attachments/assets/a357c4b6-9768-495c-a576-1618f6275727
3. ⚡ VibeVoice-Streaming - 实时流式 TTS
VibeVoice-Realtime 是一个轻量级实时文本转语音模型,支持流式文本输入和稳健的长语音生成。
- 参数量:0.5B(易于部署)
- 实时 TTS(首次可听延迟约 300 毫秒)
- 流式文本输入
- 稳健的长语音生成(约 10 分钟)
📖 文档 | 🤗 Hugging Face | 🚀 Colab
https://github.com/user-attachments/assets/0901d274-f6ae-46ef-a0fd-3c4fba4f76dc
贡献
请参阅 CONTRIBUTING.md 了解详细的贡献指南。
⚠️ 风险与局限性
尽管已通过各种技术努力优化,它仍可能产生意外、有偏见或不准确的输出。VibeVoice 继承了其基座模型(本次发布中为 Qwen2.5 1.5B)产生的所有偏见、错误或遗漏。 深度伪造和虚假信息风险:高质量的合成语音可能被滥用以创建令人信服的虚假音频内容,用于冒名顶替、欺诈或传播虚假信息。用户必须确保转录文本可靠、检查内容准确性,并避免以误导方式使用生成内容。用户应以合法方式使用生成内容并部署模型,全面遵守相关司法管辖区的所有适用法律法规。分享 AI 生成内容时,建议披露 AI 的使用。
我们不建议在未经进一步测试和开发的情况下将 VibeVoice 用于商业或现实应用。此模型仅供研究目的使用。请负责任地使用。
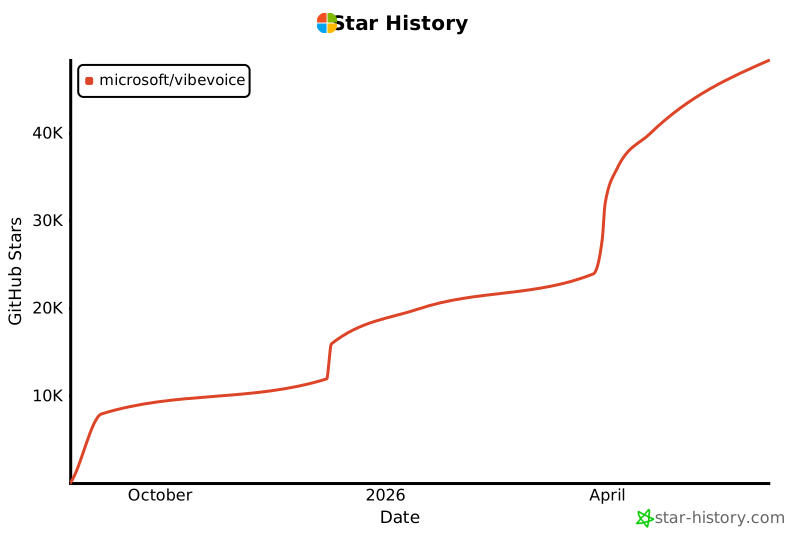
Star 历史