openmed

本地优先的医疗 AI 工具包,专为临床文本设计的实体提取和 PII 脱敏库,包含 1000+ 预训练模型。一次 pip install 即可离线运行,支持 CPU/CUDA/Apple MLX 加速,并提供 Swift SDK 集成到 iOS/macOS 应用。亮点在于完全本地执行、覆盖 12 种语言和 247 个 PII 检查点,Apache-2.0 协议无厂商锁定,适合医疗隐私合规场景。
README
本地优先的医疗 AI,永不离设备
一行代码将临床文本转化为结构化洞察。
实体提取、PII 去标识化,以及 1000+ 专业医学模型,完全运行在您自己的硬件上——从一行 Python 代码到 iPhone 上的原生 Swift 应用,由 Apple MLX 驱动。无需云端,无供应商锁定,无患者数据离开您的网络。
1,000+ 模型 · 12 种语言 · 247 个 PII 检查点 · 100% 设备端 · Apache-2.0
English · 简体中文 · Español · Français · Deutsch · Italiano · Português · Nederlands · العربية · हिन्दी · తెలుగు · 日本語 · Türkçe · فارسی
实际演示
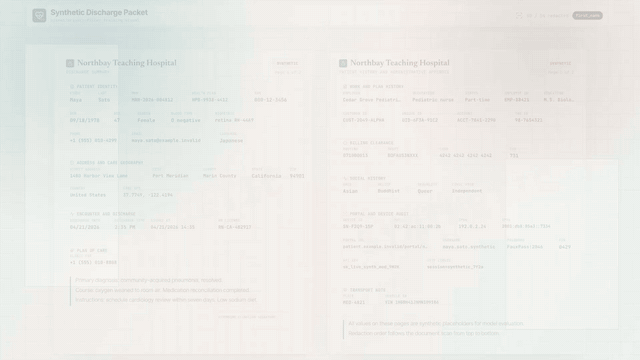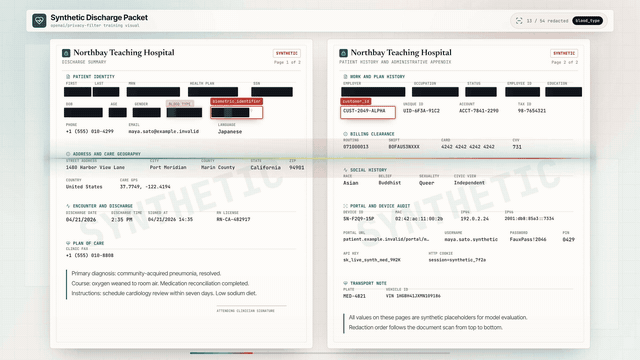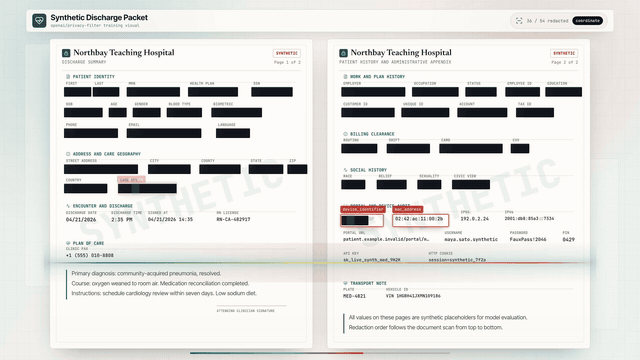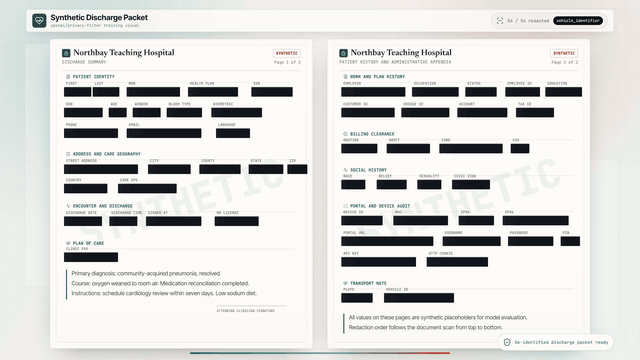
实时 PII 去标识化 — Nemotron Privacy Filter 对临床出院包中的姓名、地址、ID 和账单数据进行编辑,完全在设备端运行。(所有显示的值均为合成数据。)
30 秒示例
from openmed import analyze_text

result = analyze_text(
    "Patient started on imatinib for chronic myeloid leukemia.",
    model_name="disease_detection_superclinical",
)

for entity in result.entities:
    print(f"{entity.label:<12} {entity.text:<28} {entity.confidence:.2f}")
# DISEASE      chronic myeloid leukemia     0.98
# DRUG         imatinib                     0.95
一个最先进的临床 NER(命名实体识别)模型在本地运行——无需 API 密钥,无需网络调用。
为什么选择 OpenMed?
| OpenMed | 云端医疗 API | |
|---|---|---|
| 在您的设备/服务器上运行 | ✅ | ❌ |
| 患者数据离开您的网络 | 永不 | 发送给供应商 |
| 成本 | 免费且开源 | 按次计费 |
| 专业医学模型 | 1,000+ | 有限 |
| 语言 | 12+ | 各不相同 |
| 离线 / 气隙环境 | ✅ | ❌ |
| Apple Silicon (MLX) 加速 | ✅ | n/a |
| 原生 iOS / macOS 应用 | ✅ 通过 OpenMedKit | ❌ |
| 供应商锁定 | 无 — Apache-2.0 | 是 |
- 专业模型 — 1,000+ 个精选的生物医学与临床模型,许多优于专有堆栈。
- 符合 HIPAA 标准的去标识化 — 所有 18 个 Safe Harbor 标识符、智能实体合并、保留格式的伪造数据。
- 随处运行 — CPU、CUDA、Apple Silicon (MLX),以及通过 OpenMedKit 在 iOS/macOS 应用中原生运行。
- 一行部署 — Python API、Docker 化 REST 服务或批量处理管道。
- 零锁定 — Apache-2.0 许可证,您的基础设施,您的数据。
Apple 设备端运行 — Swift、MLX 和 iOS
OpenMed 的设计宗旨是在您的数据所在之处运行。在 Apple 硬件上,它通过 MLX 加速,并可直达 iPhone、iPad 和 Mac 应用(通过 OpenMedKit)——因此 PII 检测和临床提取完全离线,在设备端完成。
// 将 OpenMedKit 添加到您的应用
dependencies: [
    .package(url: "https://github.com/maziyarpanahi/openmed.git", from: "1.5.5"),
]
- MLX 运行时 — 用于 PII token 分类、Privacy Filter 系列以及实验性的 GLiNER 系列零样本任务,并附带 CoreML 回退路径。
- 一个模型名称,所有平台 — MLX 模型名称在非 Apple 硬件上自动回退到匹配的 PyTorch 检查点。
- Apple Silicon 上的 Python 同样支持:
pip install "openmed[mlx]"。
指南:MLX 后端 · OpenMedKit (Swift) · CoreML 导出
工作原理
flowchart LR
    A["临床文本"] --> B["OpenMed<br/>(100% 设备端)"]
    B --> C["医疗实体"]
    B --> D["检测到的 PII"]
    B --> E["去标识化文本"]
    style B fill:#0D6E6E,stroke:#0A5656,stroke-width:2px,color:#ffffff
    style C fill:#D6EBEB,stroke:#0D6E6E,color:#0E1116
    style D fill:#F7DCD8,stroke:#C5453A,color:#0E1116
    style E fill:#F5E27A,stroke:#A9A088,color:#0E1116
快速开始
# 核心 + Hugging Face 运行时(Linux、macOS、Windows;CPU 或 CUDA)
pip install "openmed[hf]"

# 添加 REST 服务
pip install "openmed[hf,service]"

# Apple Silicon 加速(MLX)
pip install "openmed[mlx]"
Python API |
REST 服务
|
批量处理 |
离线 / 气隙环境? 将 model_name(或 model_id)指向本地目录,OpenMed 将直接加载,无需联系 Hugging Face Hub:
from openmed import OpenMedConfig, analyze_text

result = analyze_text(
    "Patient presents with chronic myeloid leukemia and Type 2 diabetes.",
    model_id="./models/OpenMed-NER-DiseaseDetect-SuperClinical-434M",
    config=OpenMedConfig(device="cpu"),
)
模型
精选的专业医学 NER 模型注册表——浏览完整目录。
| 模型 | 专长 | 实体类型 | 大小 |
|---|---|---|---|
disease_detection_superclinical |
疾病与状况 | DISEASE, CONDITION, DIAGNOSIS | 434M |
pharma_detection_superclinical |
药物与用药 | DRUG, MEDICATION, TREATMENT | 434M |
pii_superclinical_large |
PII 与去标识化 | NAME, DATE, SSN, PHONE, EMAIL, ADDRESS | 434M |
anatomy_detection_electramed |
解剖学与身体部位 | ANATOMY, ORGAN, BODY_PART | 109M |
gene_detection_genecorpus |
基因与蛋白质 | GENE, PROTEIN | 109M |
隐私:PII 检测与去标识化
from openmed import extract_pii, deidentify

text = "Patient: John Doe, DOB: 01/15/1970, SSN: 123-45-6789"

# 提取 PII 并启用智能合并(防止 token 化碎片)
result = extract_pii(text, model_name="pii_superclinical_large", use_smart_merging=True)

# 使用所需方法进行去标识化
deidentify(text, method="mask")     # [NAME], [DATE]
deidentify(text, method="replace")  # 基于 Faker,感知区域设置,保留格式的伪造数据
deidentify(text, method="hash")     # 加密哈希
deidentify(text, method="shift_dates", date_shift_days=180)
- 智能实体合并 保持
01/15/1970完整,而非将其碎片化。 - 基于 Faker 的混淆,附带自定义临床 ID 提供者(CPF、CNPJ、BSN、NIR、Codice Fiscale、NIE、Aadhaar、Steuer-ID、NPI)。
- HIPAA:所有 18 个 Safe Harbor 标识符,可配置置信度阈值。
- 批量 PII(v1.5.5):使用
BatchProcessor(operation="extract_pii" | "deidentify", batch_size=16)跨多个文档提取或去标识化。
完整的 PII 笔记本 · 智能合并 · 匿名化
Privacy Filter 系列 — 基于 OpenAI Privacy Filter 架构的三个模型家族相同的模型代码(gpt-oss 风格稀疏 MoE transformer,带局部注意力、sink tokens、RoPE+YaRN、tiktoken o200k_base),不同的训练数据。所有变体均通过相同的 extract_pii() / deidentify() API 路由——只需更改 model_name= 参数。
| 变体 | PyTorch (CPU + CUDA) | MLX (Apple Silicon) | MLX 8-bit |
|---|---|---|---|
| OpenAI Privacy Filter | openai/privacy-filter |
OpenMed/privacy-filter-mlx |
…-mlx-8bit |
| Nemotron-PII 微调 | OpenMed/privacy-filter-nemotron |
…-nemotron-mlx |
…-nemotron-mlx-8bit |
| OpenMed 多语言 | OpenMed/privacy-filter-multilingual |
…-multilingual-mlx |
…-multilingual-mlx-8bit |
from openmed import extract_pii

text = "Patient Sarah Connor (DOB: 03/15/1985) at MRN 4471882."

extract_pii(text, model_name="openai/privacy-filter")              # PyTorch 基线
extract_pii(text, model_name="OpenMed/privacy-filter-nemotron")    # 相同代码,不同权重
extract_pii(text, model_name="OpenMed/privacy-filter-mlx")         # Apple Silicon (MLX)
在非 Apple Silicon 主机上,MLX 模型名称会自动替换为匹配的 PyTorch 检查点(并给出一次性警告)——指定一个模型名称,随处运行。参见 Privacy Filter 架构与后端路由。
多语言 PII(12 种语言)
跨 en、fr、de、it、es、nl、hi、te、pt、ar、ja 和 tr 进行提取和去标识化——总共 247 个 PII 检查点。
python -c "from openmed import extract_pii; print([(e.label, e.text) for e in extract_pii('Dr. Pedro Almeida, CPF: 123.456.789-09, email: pedro@hospital.pt', lang='pt').entities])"
from openmed import extract_pii

portuguese = extract_pii("Paciente: Pedro Almeida, CPF: 123.456.789-09, telefone: +351 912 345 678", lang="pt", use_smart_merging=True)
dutch      = extract_pii("Patiënt: Eva de Vries, BSN: 123456782, telefoon: +31 6 12345678", lang="nl", use_smart_merging=True)
hindi      = extract_pii("रोगी: अनीता शर्मा, फोन: +91 9876543210, पता: नई दिल्ली 110001", lang="hi", use_smart_merging=True)
arabic     = extract_pii("المريضة ليلى حسن، الهاتف +20 10 1234 5678، الرقم القومي 29801011234567.", lang="ar", use_smart_merging=True)
japanese   = extract_pii("患者 佐藤 花子、電話 +81 90 1234 5678、マイナンバー 1234 5678 9012.", lang="ja", use_smart_merging=True)
turkish    = extract_pii("Hasta Ayşe Yılmaz, telefon +90 532 123 45 67, TCKN 10000000146.", lang="tr", use_smart_merging=True)

for r in (portuguese, dutch, hindi, arabic, japanese, turkish):
    print([(e.label, e.text) for e in r.entities])
REST API
一个对 Docker 友好的 FastAPI 服务,包含请求验证、共享 pipeline 预加载和统一的错误封装。
pip install "openmed[hf,service]"
uvicorn openmed.service.app:app --host 0.0.0.0 --port 8080

# 或使用 Docker
docker build -t openmed:1.5.5 .
docker run --rm -p 8080:8080 -e OPENMED_PROFILE=prod openmed:1.5.5
curl -X POST http://127.0.0.1:8080/pii/extract \
  -H "Content-Type: application/json" \
  -d '{"text":"Paciente: Maria Garcia, DNI: 12345678Z","lang":"es"}'
模型生命周期(v1.5.5): 按需释放内存,支持 GET /models/loaded、POST /models/unload 和 keep_alive 空闲窗口:
OPENMED_SERVICE_KEEP_ALIVE=10m uvicorn openmed.service.app:app --host 0.0.0.0 --port 8080
curl -X POST http://127.0.0.1:8080/models/unload -H "Content-Type: application/json" -d '{"all":true}'
参见完整的 REST 服务指南。
文档
完整指南位于 openmed.life/docs。
| 开始使用 | 分析文本 | 模型注册表 |
| PII 检测指南 | 匿名化 | 批量处理 |
| 配置方案 | REST 服务 | MLX 后端 |
认识吉祥物
OpenMed 的守护者是一只毛茸茸的波斯猫,装扮成微型的 阿维森纳(伊本·西那)——这位伟大的波斯医生所著的《医典》在约 600 年间一直是全球医学标准教材。它守护着这本开放的医学知识之书,色彩搭配基于波斯绿松石(fīrūza):一位本地优先、守护您最私密数据的守护者。
贡献
欢迎贡献——包括 bug 报告、功能请求和 PR。
- 创建 Issue
- 欢迎翻译——帮助完善顶部语言切换器中链接的其他语言 README。
致谢
OpenMed 建立在优秀的开源工作之上——特别感谢 OpenAI(Privacy Filter 架构)、NVIDIA(Nemotron PII 数据集)、Hugging Face(transformers 及模型生态系统)、Apple(MLX),以及 Faker 维护者。
许可证
发布于 Apache-2.0 许可证 下。
引用
@misc{panahi2025openmedneropensourcedomainadapted,
      title={OpenMed NER: Open-Source, Domain-Adapted State-of-the-Art Transformers for Biomedical NER Across 12 Public Datasets},
      author={Maziyar Panahi},
      year={2025},
      eprint={2508.01630},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2508.01630},
}
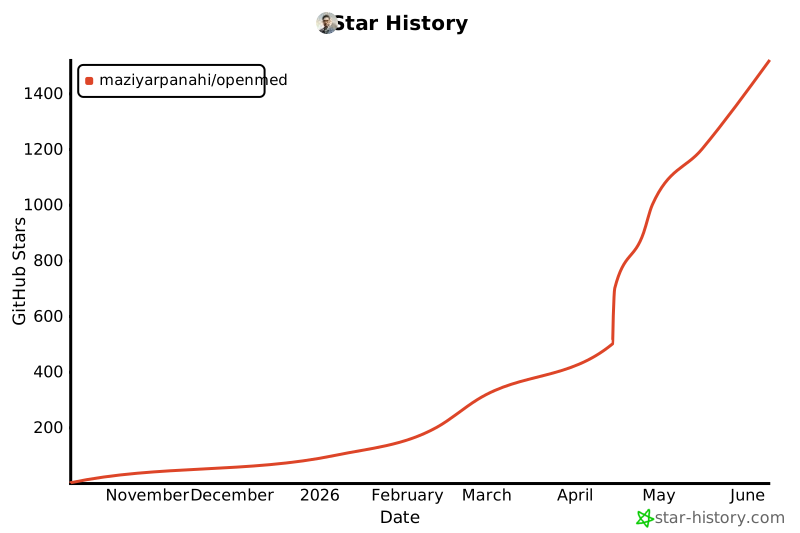
Star 历史
如果 OpenMed 对您有帮助,一个 star 能帮助更多人发现它。
由 OpenMed 团队构建
网站 · 文档 · X / Twitter · LinkedIn