magnitude
开源本地推理服务器,自动检测硬件并推荐/下载/调优适合的本地模型,供 Cline、Codex、Claude Code 等 agent 客户端接入使用。亮点是 agent-first 流程:一条命令让 agent 自动完成模型选型与配置,支持懒加载/空闲卸载,数据完全本地化。Apache 2.0 许可,适合想摆脱云端 token 成本的开发者。
README
Magnitude
用本地模型运行你的 agent。免费、私密、可离线。




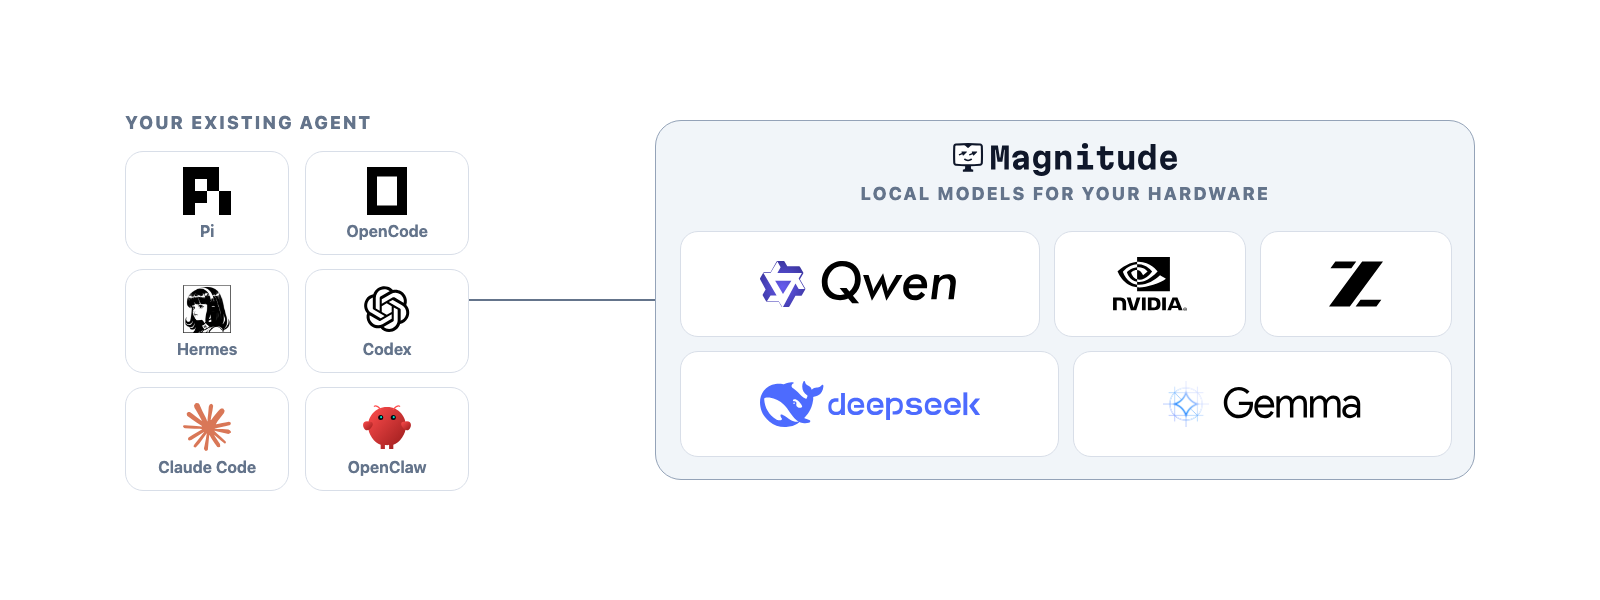
Magnitude 是一个开源的 inference server(推理服务器),可为你当前的硬件运行最合适的本地模型,并接入你已经在使用的 agent。它会分析你的机器配置,推荐匹配的模型,然后下载、调优并运行它们。支持 Pi、OpenCode、Hermes、OpenClaw、Codex、Claude Code、Oh My Pi 和 Cline,也可以使用内置的 harness(agent 运行框架)。
⭐ 帮助我们触达更多开发者,壮大 Magnitude 社区。Star 这个仓库吧!
快速开始
把下面这段发送给你的 agent,让它带你完成模型选择和设置:
Set up local models for me with the Magnitude CLI. Install it with `npm i -g @magnitudedev/cli` (or my package manager), then run `magnitude docs onboarding` and follow the instructions.
你的 agent 会分析你的硬件、带你了解最适合的本地模型、下载你选择的模型,并把自己切换到这些模型上。
Magnitude 支持 macOS 和 Linux。Windows 可通过 WSL 使用。
想直接浏览模型?npm i -g @magnitudedev/cli
magnitude setup
交互式设置会列出推荐的模型,你可以自行选择。
为什么选择 Magnitude?
- **免费运行:**无 token 费用、无需 API 密钥,也没有速率限制
- **完全私密且离线:**模型、prompt(提示词)和文件都保留在你的机器上
- **Agent 优先的配置流程:**一条指令即可让 agent 带你完成后续配置
- **了解你的硬件:**分析你的芯片、内存和带宽
- **推荐合适的模型:**根据你的机器推荐最佳模型,并估算 tok/s
- **端到端调优:**speculative decoding(投机式解码)、concurrency(并发)等都已针对你的机器配置好
- **按需加载模型:**请求时加载,空闲或内存紧张时自动卸载
- **开源:**Apache 2.0,可自行修改
常见问题
Magnitude 是什么?
一个开源的 inference server(推理服务器),可运行最适合你硬件的本地模型,并接入你已经在使用的 agent。它会分析你的机器配置,推荐匹配的模型,然后下载、调优并运行它们。
需要什么硬件?
没有固定的最低要求。Magnitude 会分析你的硬件,推荐最适合你机器的模型。内存越大,可运行的模型也就越大。
为什么不直接让我的 agent 设置 Ollama?
因为你的 agent 只能靠猜。它不知道你的硬件配置、哪种 quant(量化版本)适合,也不清楚实际运行速度。Magnitude 会为它提供一份根据你的机器计算出的推荐目录、一个会写入 harness 配置的引导流程,并提供专为 agent 工作负载构建的 inference(推理)能力。模型会按需即时加载,空闲或内存紧张时自动卸载。
支持哪些 harness(agent 运行框架)?
Pi、OpenCode、Herm