omlx

专为 Apple Silicon 优化的本地 LLM 推理服务器,支持连续批处理与两级 KV 缓存(内存+SSD),可通过 macOS 菜单栏或 CLI 管理。亮点在于将 vLLM 风格的缓存管理与 macOS 原生体验结合,支持多模型加载、LRU 驱逐、模型固定,以及 OpenAI/Anthropic 兼容 API,适合 Mac 用户本地运行和调试大模型。项目采用 Apache 2.0 许可。
README
oMLX
专为你的 Mac 优化的 LLM 推理
连续批处理与分层 KV 缓存,直接从菜单栏管理。

junkim.dot@gmail.com · https://omlx.ai/me
安装 · 快速上手 · 功能特性 · 模型 · CLI 配置 · 性能基准 · oMLX.ai
我用过的每个 LLM 服务器都让我在便利和控制之间做选择。我想把日常使用的模型固定在内存中,按需自动交换更重的模型,设置上下文限制——全部通过菜单栏管理。
oMLX 在热内存层和冷 SSD 层之间持久化 KV 缓存——即使在对话中途改变上下文,所有历史上下文仍保持缓存状态并可跨请求复用,使得本地 LLM 能够通过 Claude Code 等工具真正用于实际编程工作。这就是我构建它的原因。
安装
macOS 应用
从 Releases 下载 .dmg 文件,拖入 Applications 文件夹即可。应用包含自动更新功能,未来升级只需一键操作。注意,macOS 应用不会安装 omlx CLI 命令。如需终端使用,请通过 Homebrew 或源码安装。
Homebrew
brew tap jundot/omlx https://github.com/jundot/omlx
brew install omlx

# 升级到最新版本
brew update && brew upgrade omlx

# 作为后台服务运行(崩溃后自动重启)
brew services start omlx

# 可选:MCP(Model Context Protocol)支持
/opt/homebrew/opt/omlx/libexec/bin/pip install mcp
源码安装
git clone https://github.com/jundot/omlx.git
cd omlx
pip install -e .          # 仅核心功能
pip install -e ".[mcp]"   # 含 MCP(Model Context Protocol)支持
需要 macOS 15.0+ (Sequoia)、Python 3.10+ 和 Apple Silicon (M1/M2/M3/M4)。
快速上手
macOS 应用
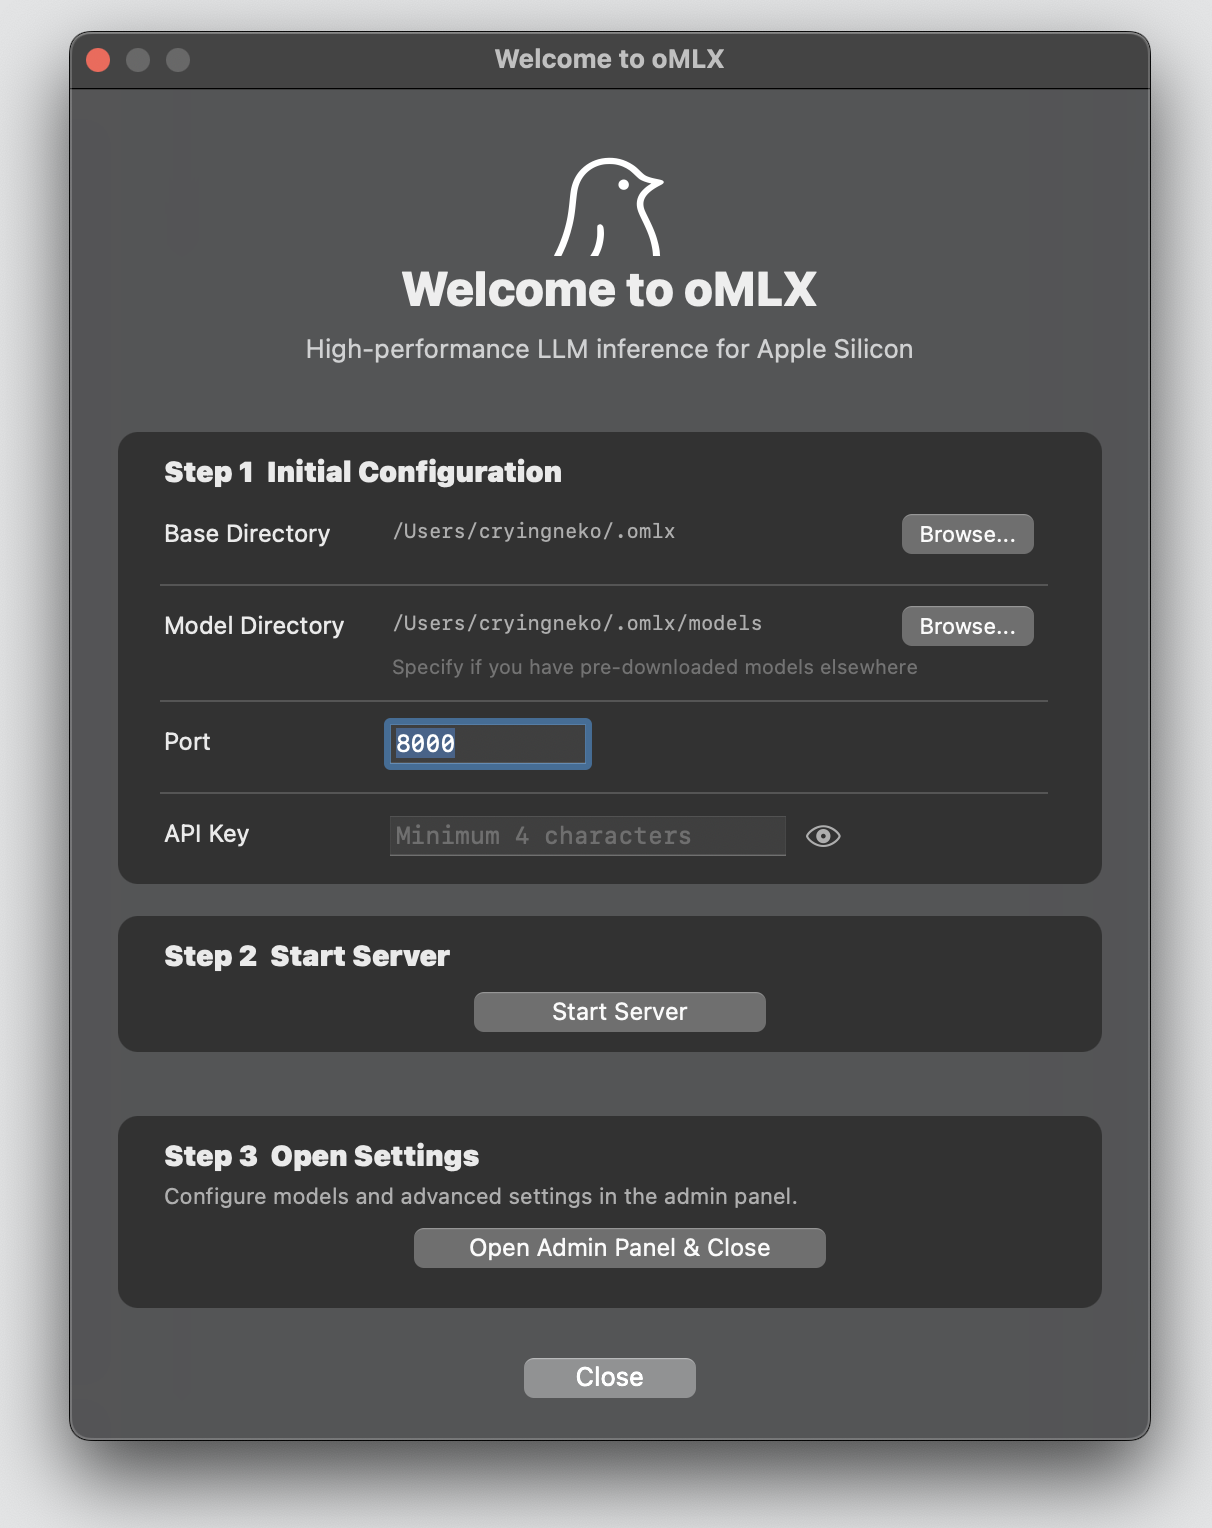
从应用程序文件夹启动 oMLX。欢迎屏幕会引导你完成三步设置——模型目录、服务器启动和首个模型下载。就这么简单。要连接 OpenClaw、OpenCode 或 Codex,请参考集成部分。
CLI
omlx serve --model-dir ~/models
服务器会自动发现子目录中的 LLM、VLM、embedding 模型和 reranker 模型。任何兼容 OpenAI 的客户端都可以连接到 http://localhost:8000/v1。内置聊天 UI 也可在 http://localhost:8000/admin/chat 使用。
Homebrew 服务
如果通过 Homebrew 安装,可以将 oMLX 作为托管后台服务运行:
brew services start omlx    # 启动(崩溃后自动重启)
brew services stop omlx     # 停止
brew services restart omlx  # 重启
brew services info omlx     # 检查状态
该服务使用零配置默认值运行 omlx serve(~/.omlx/models,端口 8000)。如需自定义,可设置环境变量(OMLX_MODEL_DIR、OMLX_PORT 等),或运行一次 omlx serve --model-dir /你的路径 以将设置持久化到 ~/.omlx/settings.json。
日志写入两个位置:
- 服务日志:
$(brew --prefix)/var/log/omlx.log(stdout/stderr) - 服务器日志:
~/.omlx/logs/server.log(结构化应用日志)
功能特性
在 Apple Silicon 上支持文本 LLM、视觉语言模型(VLM)、OCR 模型、embedding 和 reranker。
管理仪表板
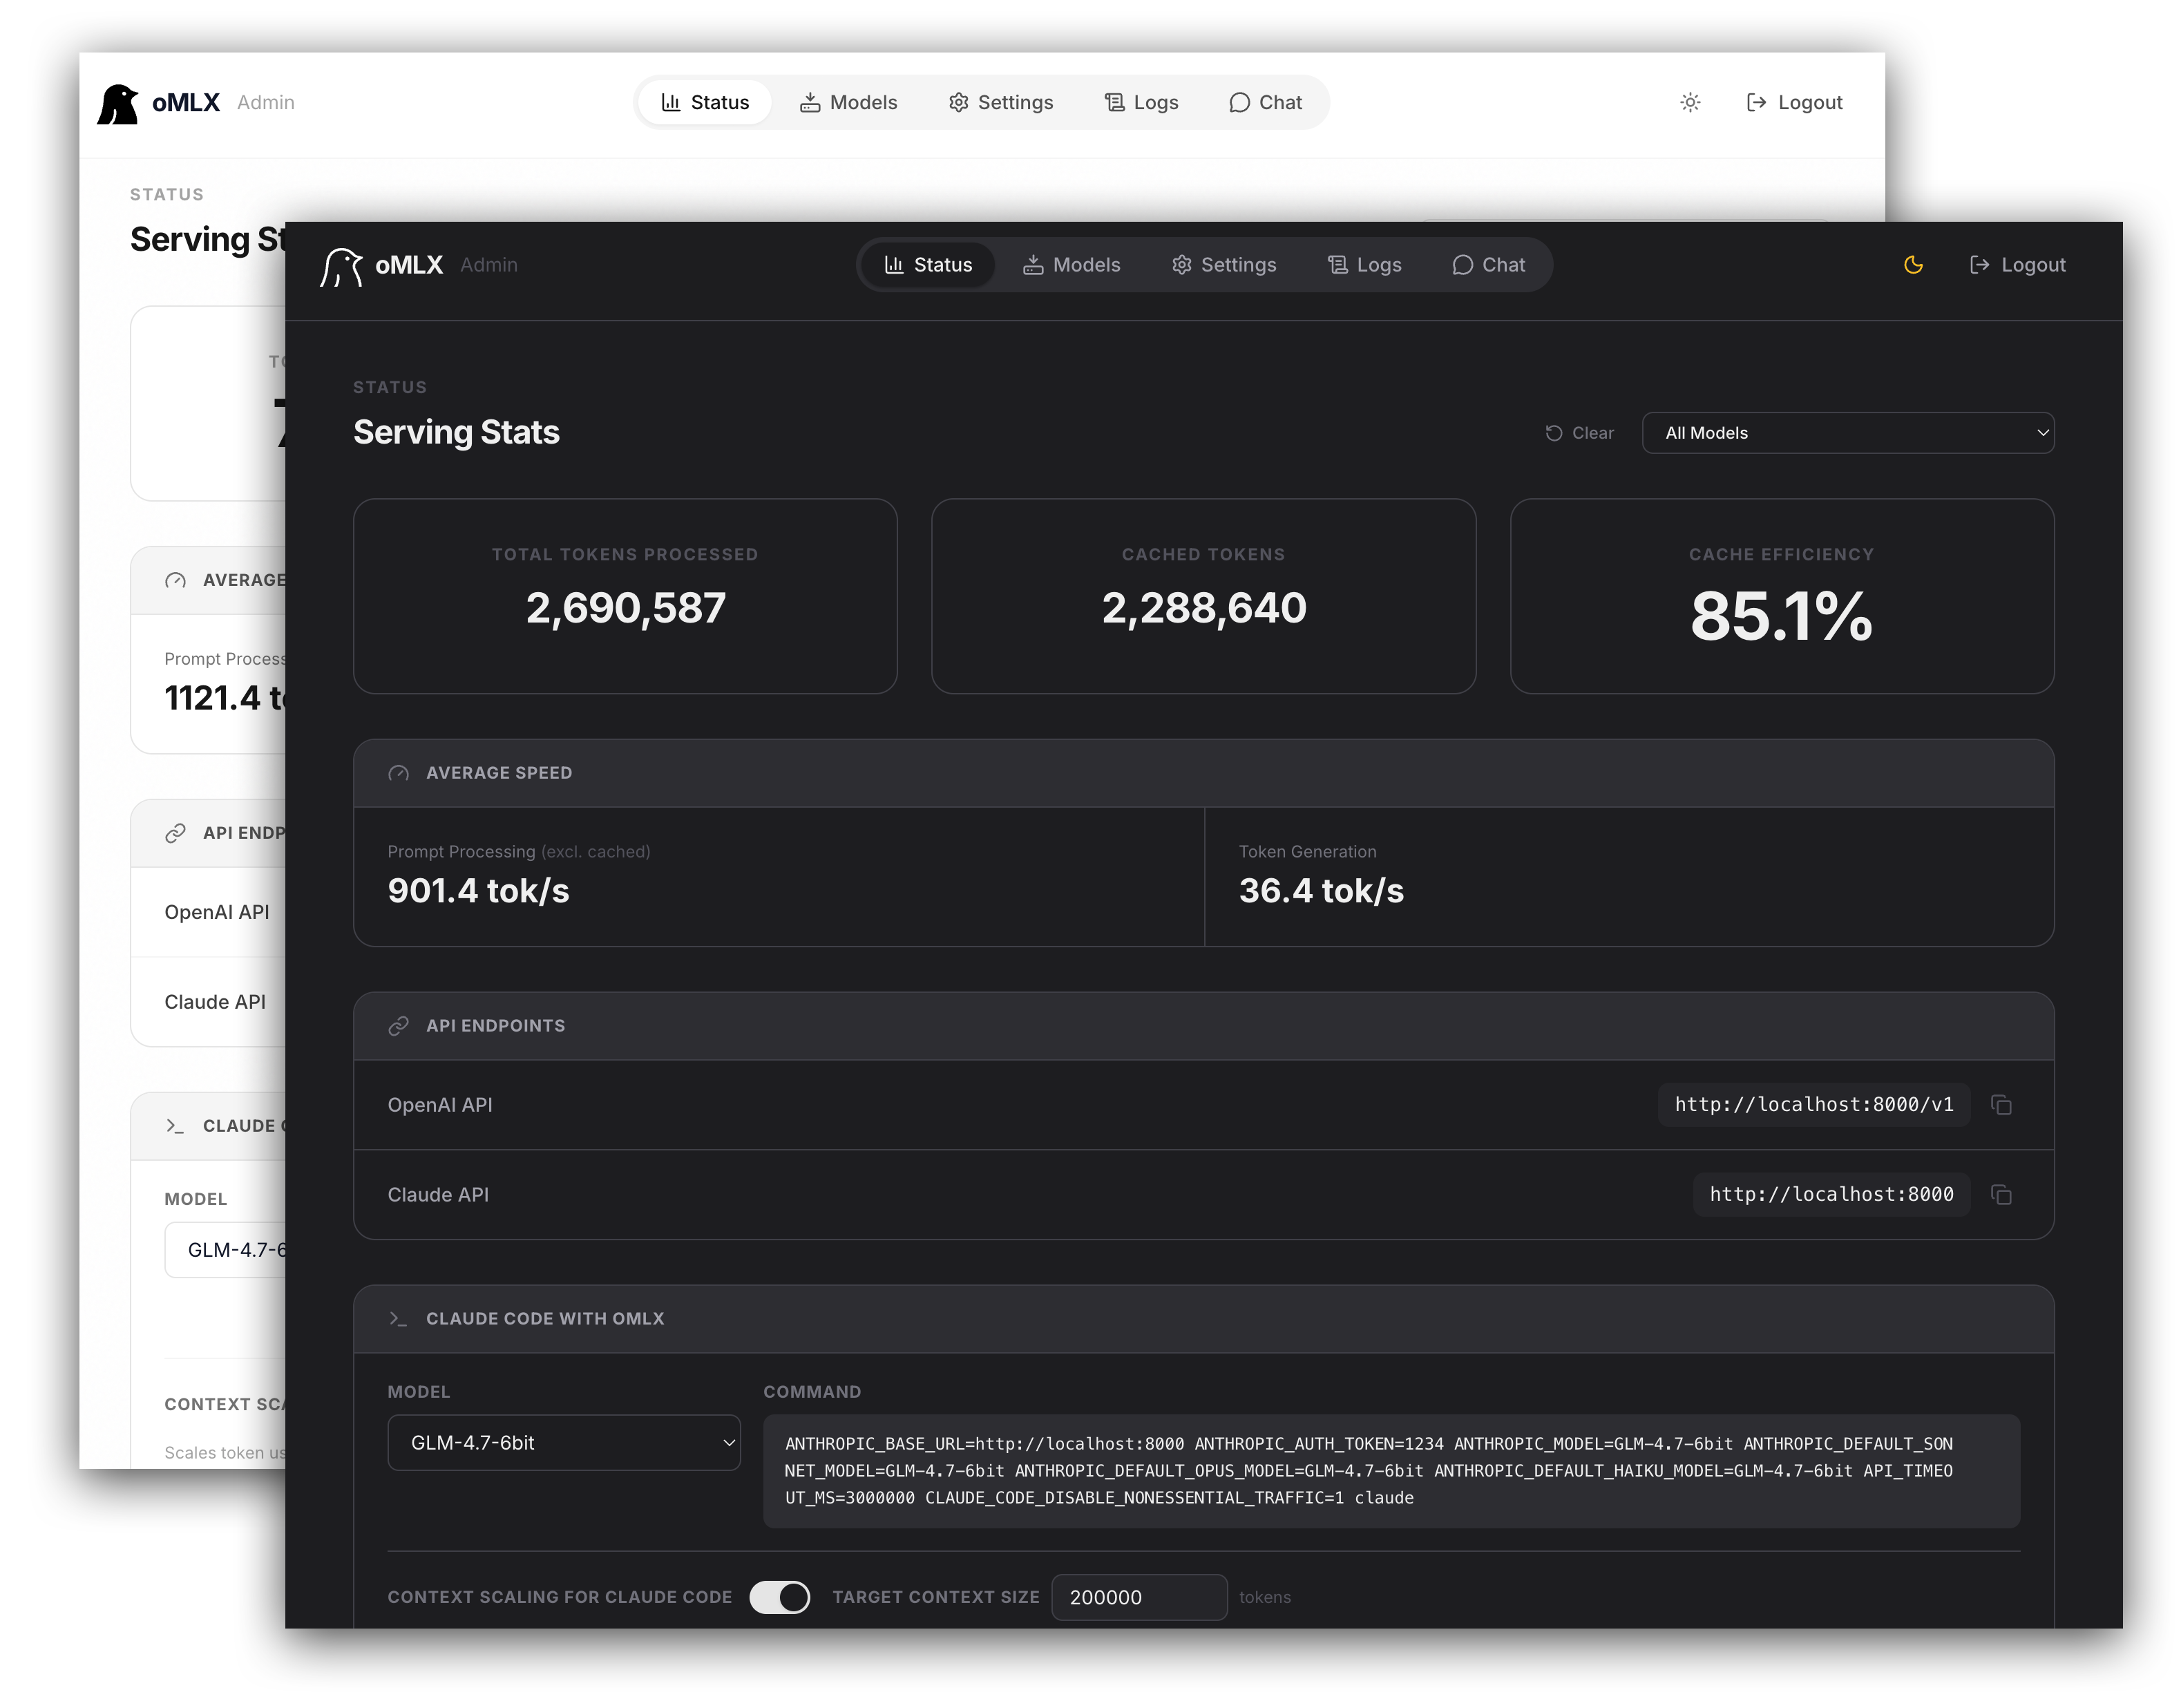
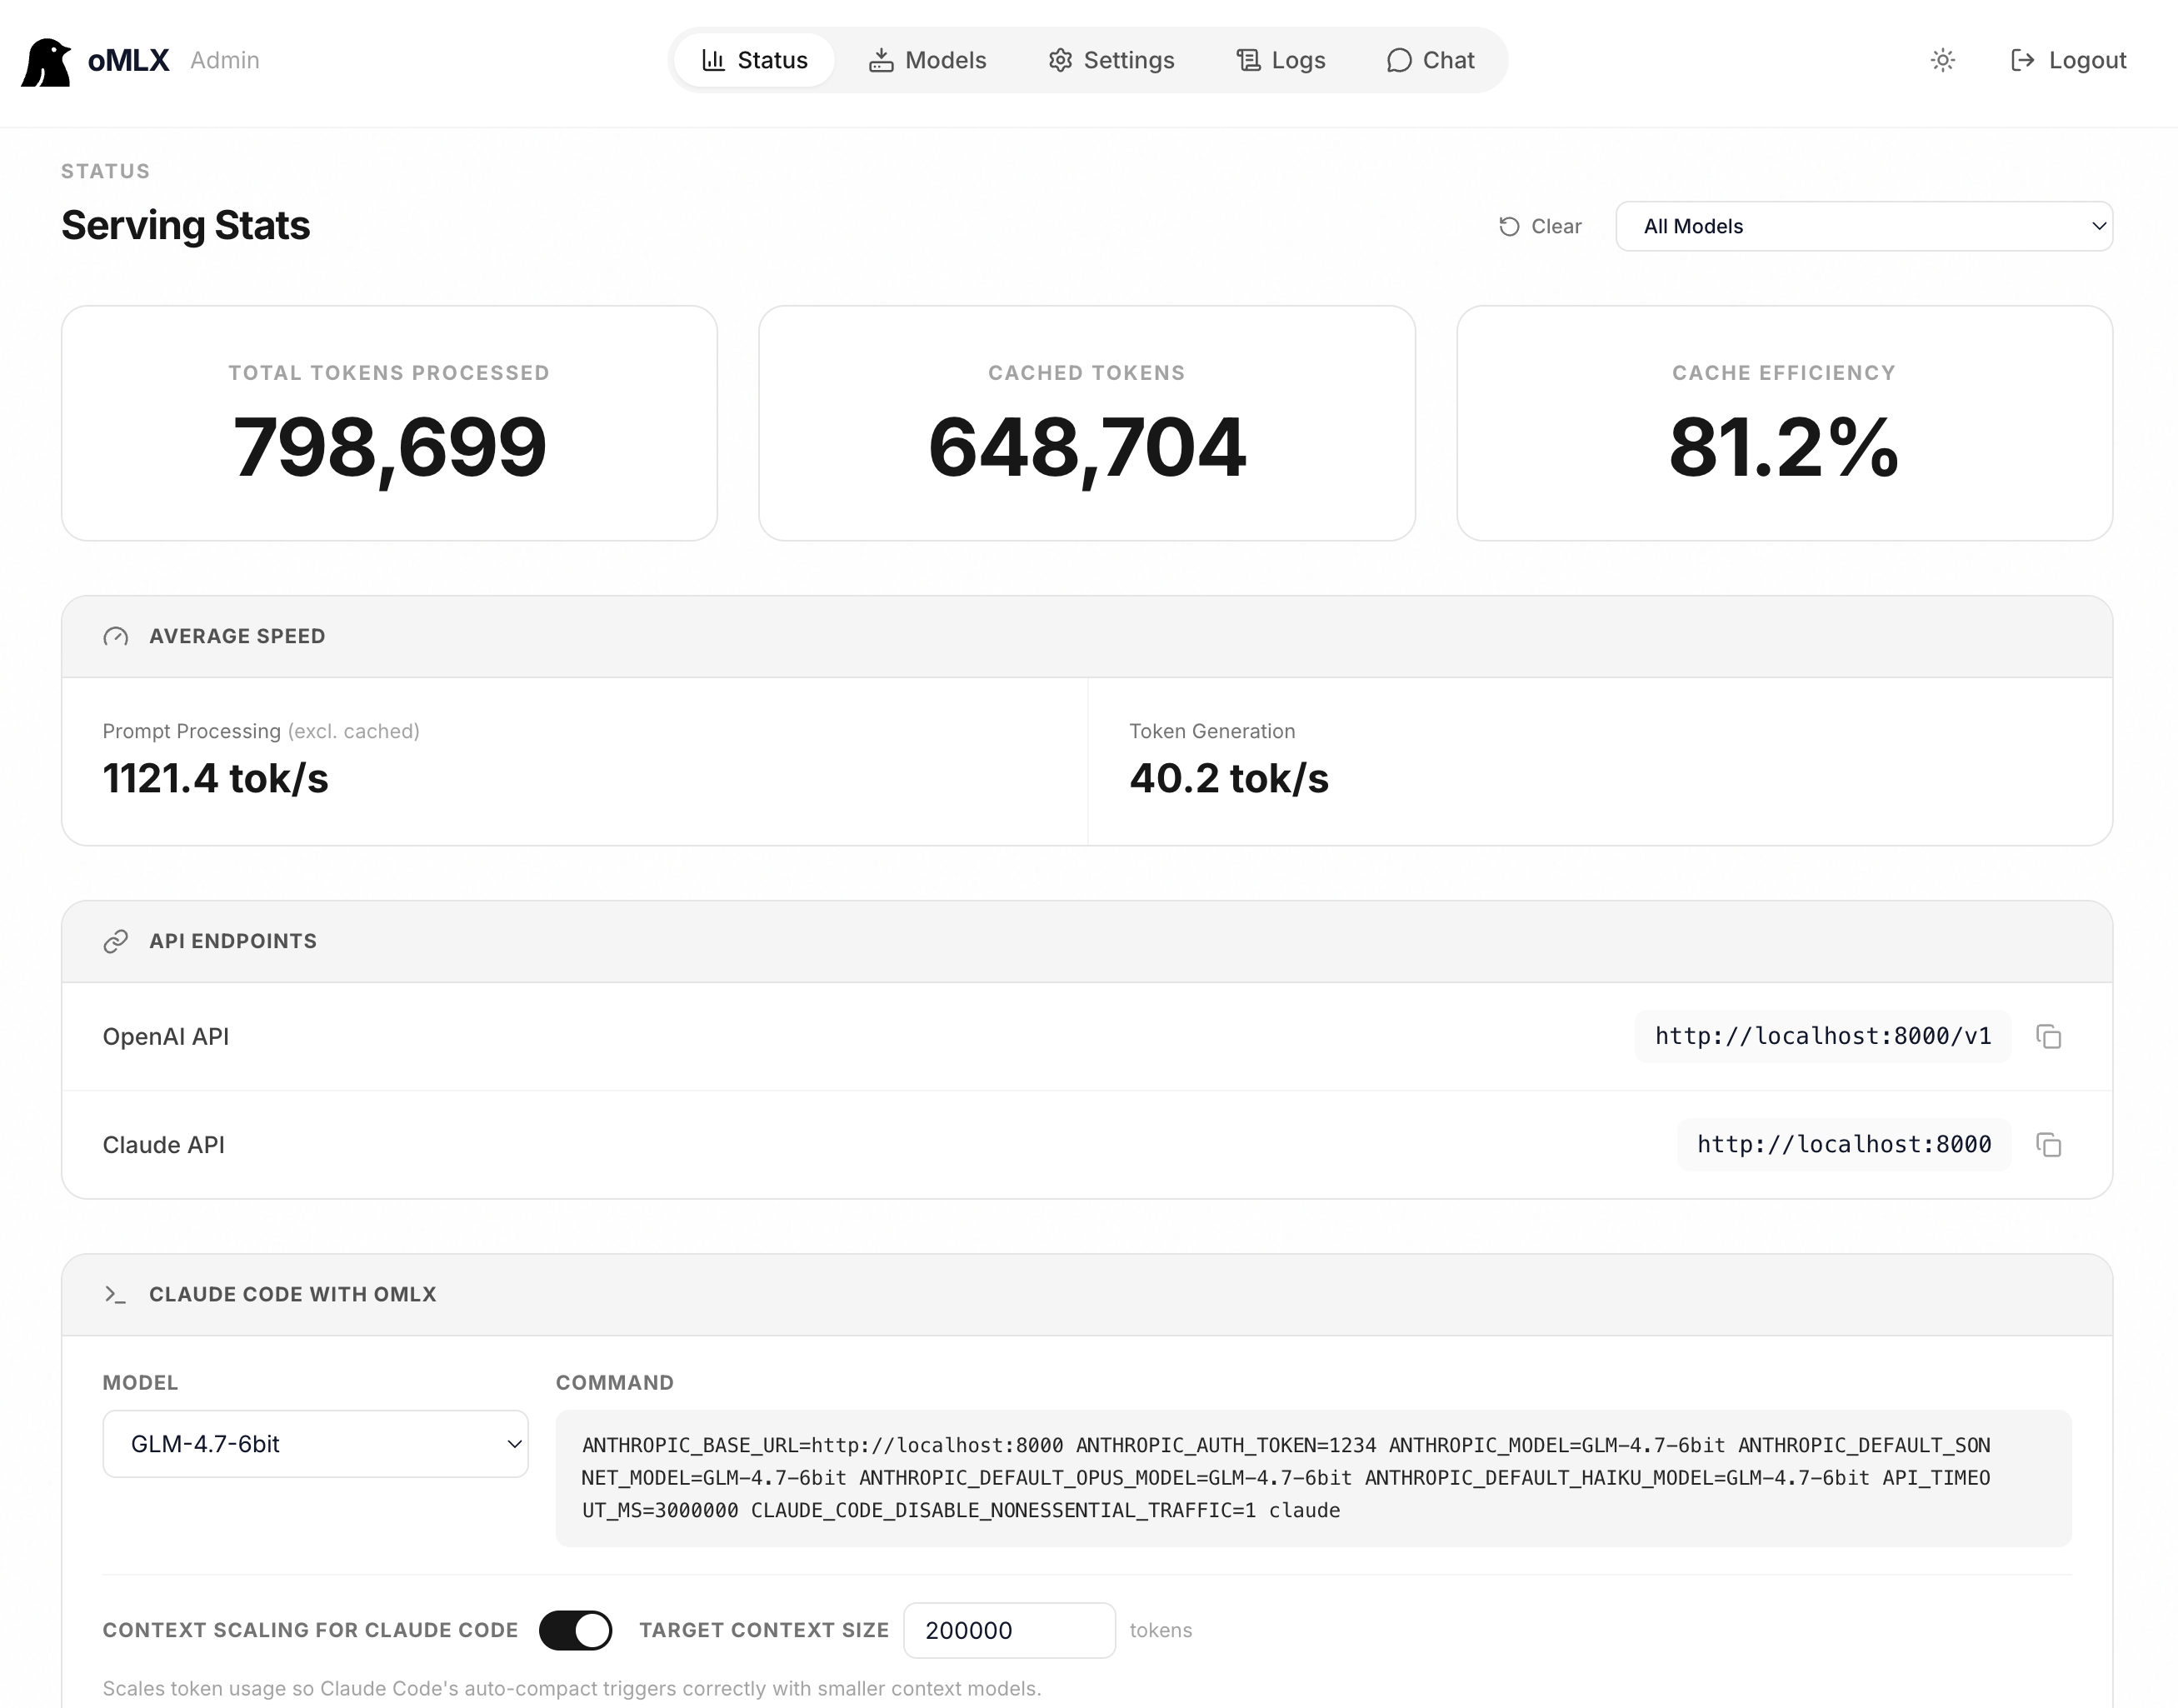
位于 /admin 的 Web UI,用于实时监控、模型管理、聊天、性能基准测试和每个模型的设置。支持英语、韩语、日语、中文和俄语。所有 CDN 依赖项均已绑定,支持完全离线运行。
视觉语言模型
运行 VLM,同样支持连续批处理和分层 KV 缓存栈,与文本 LLM 相同。支持多图像聊天、base64/URL/文件图像输入,以及带视觉上下文的工具调用。OCR 模型(DeepSeek-OCR、DOTS-OCR、GLM-OCR)会被自动检测并使用优化后的提示词。
分层 KV 缓存(热 + 冷)
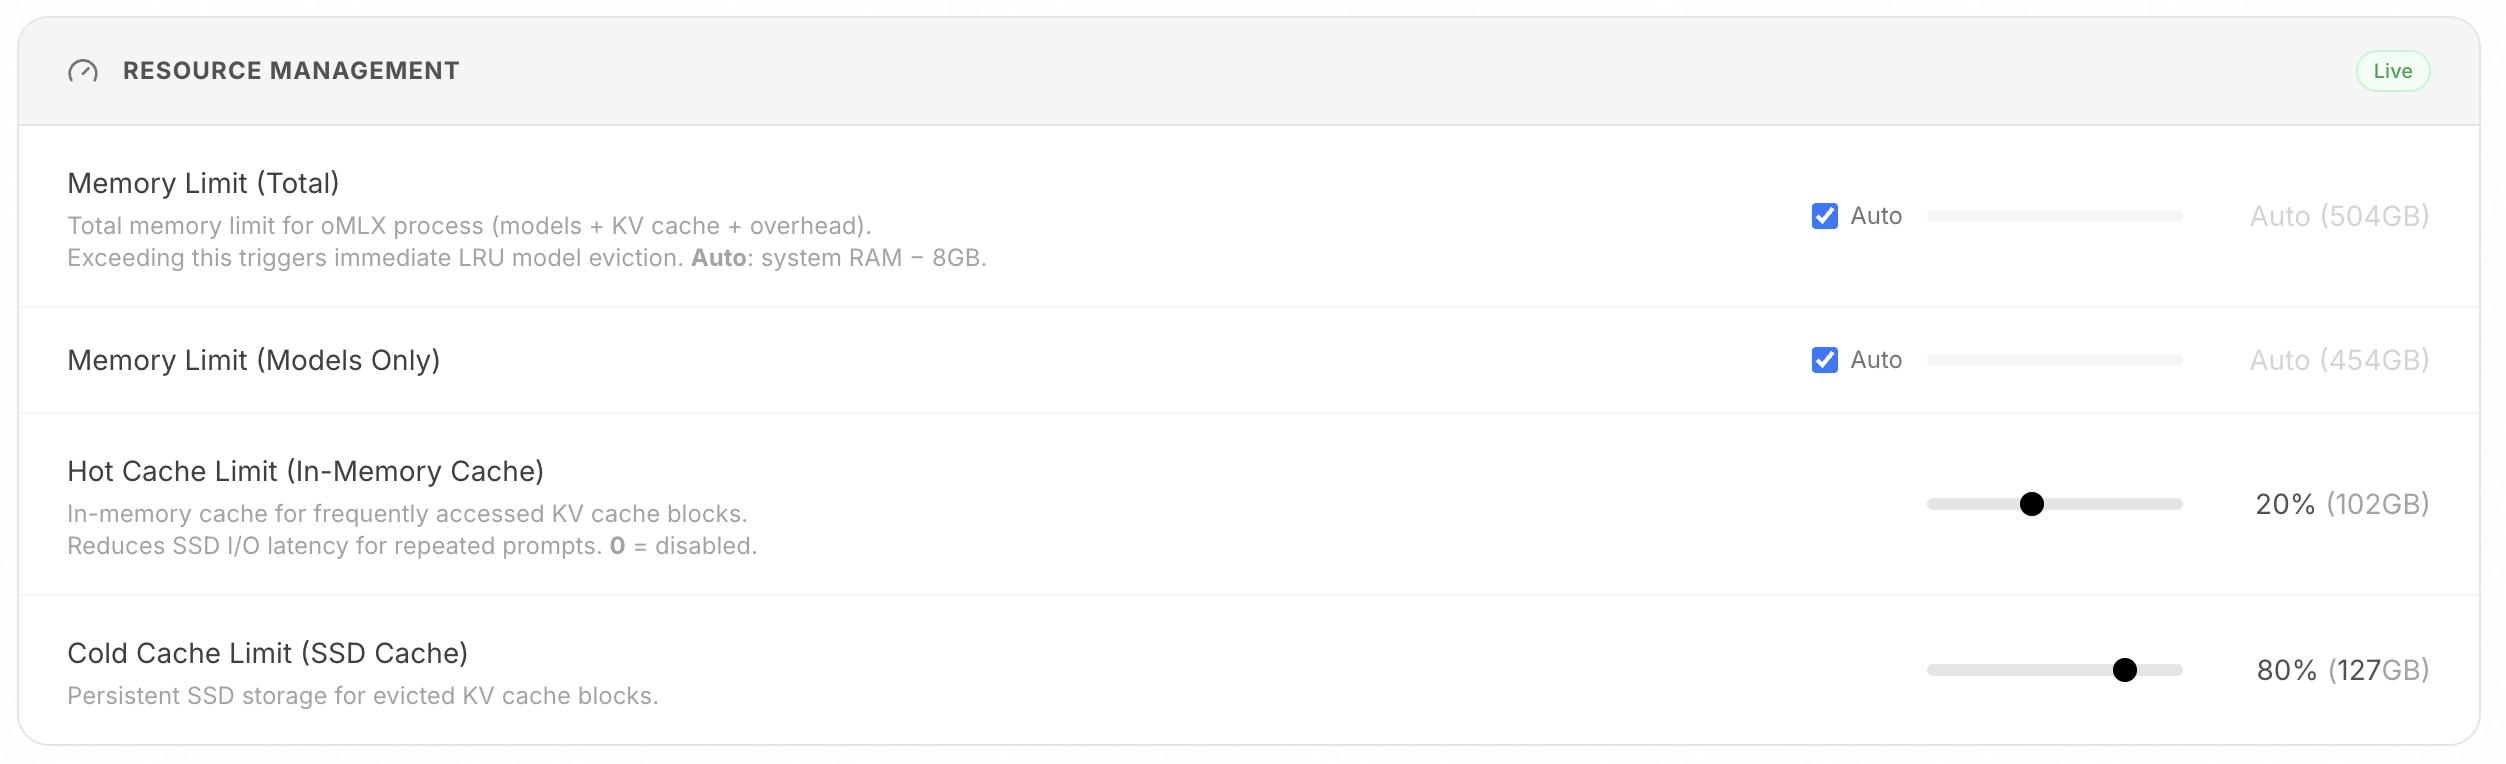
受 vLLM 启发的基于块的 KV 缓存管理,支持前缀共享和写时复制。缓存跨越两个层级:
- 热层(RAM):经常访问的块留在内存中,实现快速访问。
- 冷层(SSD):当热缓存填满时,块以 safetensors 格式卸载到 SSD。在下次请求匹配前缀时,它们会从磁盘恢复而不是从头计算——即使服务器重启后也如此。
连续批处理
通过 mlx-lm 的 BatchGenerator 处理并发请求。最大并发请求数可通过 CLI 或管理面板配置。
Claude Code 优化
支持在运行较小上下文模型时与 Claude Code 配合使用的上下文缩放。缩放报告的 token 计数,使自动压缩在正确时机触发;SSE 保活机制可防止长预填充期间的读取超时。
多模型服务
在同一服务器中加载 LLM、VLM、embedding 模型和 reranker。模型通过自动和手动控制相结合的方式管理:
- LRU 驱逐:内存不足时,最近最少使用的模型会被自动驱逐。
- 手动加载/卸载:管理面板中的交互式状态徽章可让你按需加载或卸载模型。
- 模型固定:固定常用模型使其始终保持加载状态。
- 每模型 TTL:为每个模型设置空闲超时,在无活动一段时间后自动卸载。
- 进程内存强制执行:总内存限制(默认:系统 RAM - 8GB)防止系统范围 OOM。
每模型设置
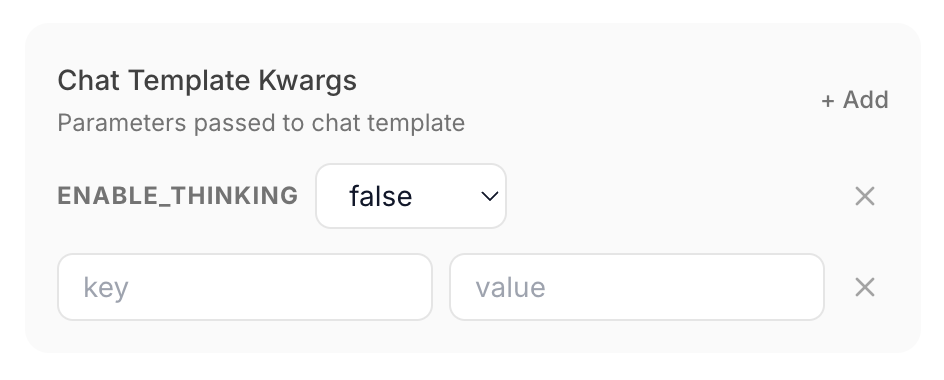
直接从管理面板为每个模型配置采样参数、聊天模板 kwargs、TTL、模型别名、模型类型覆盖等。更改立即生效,无需重启服务器。
- 模型别名:设置一个自定义的 API 可见名称。
/v1/models返回别名,请求同时接受别名和目录名。 - 模型类型覆盖:无论自动检测结果如何,手动将模型设置为 LLM 或 VLM。
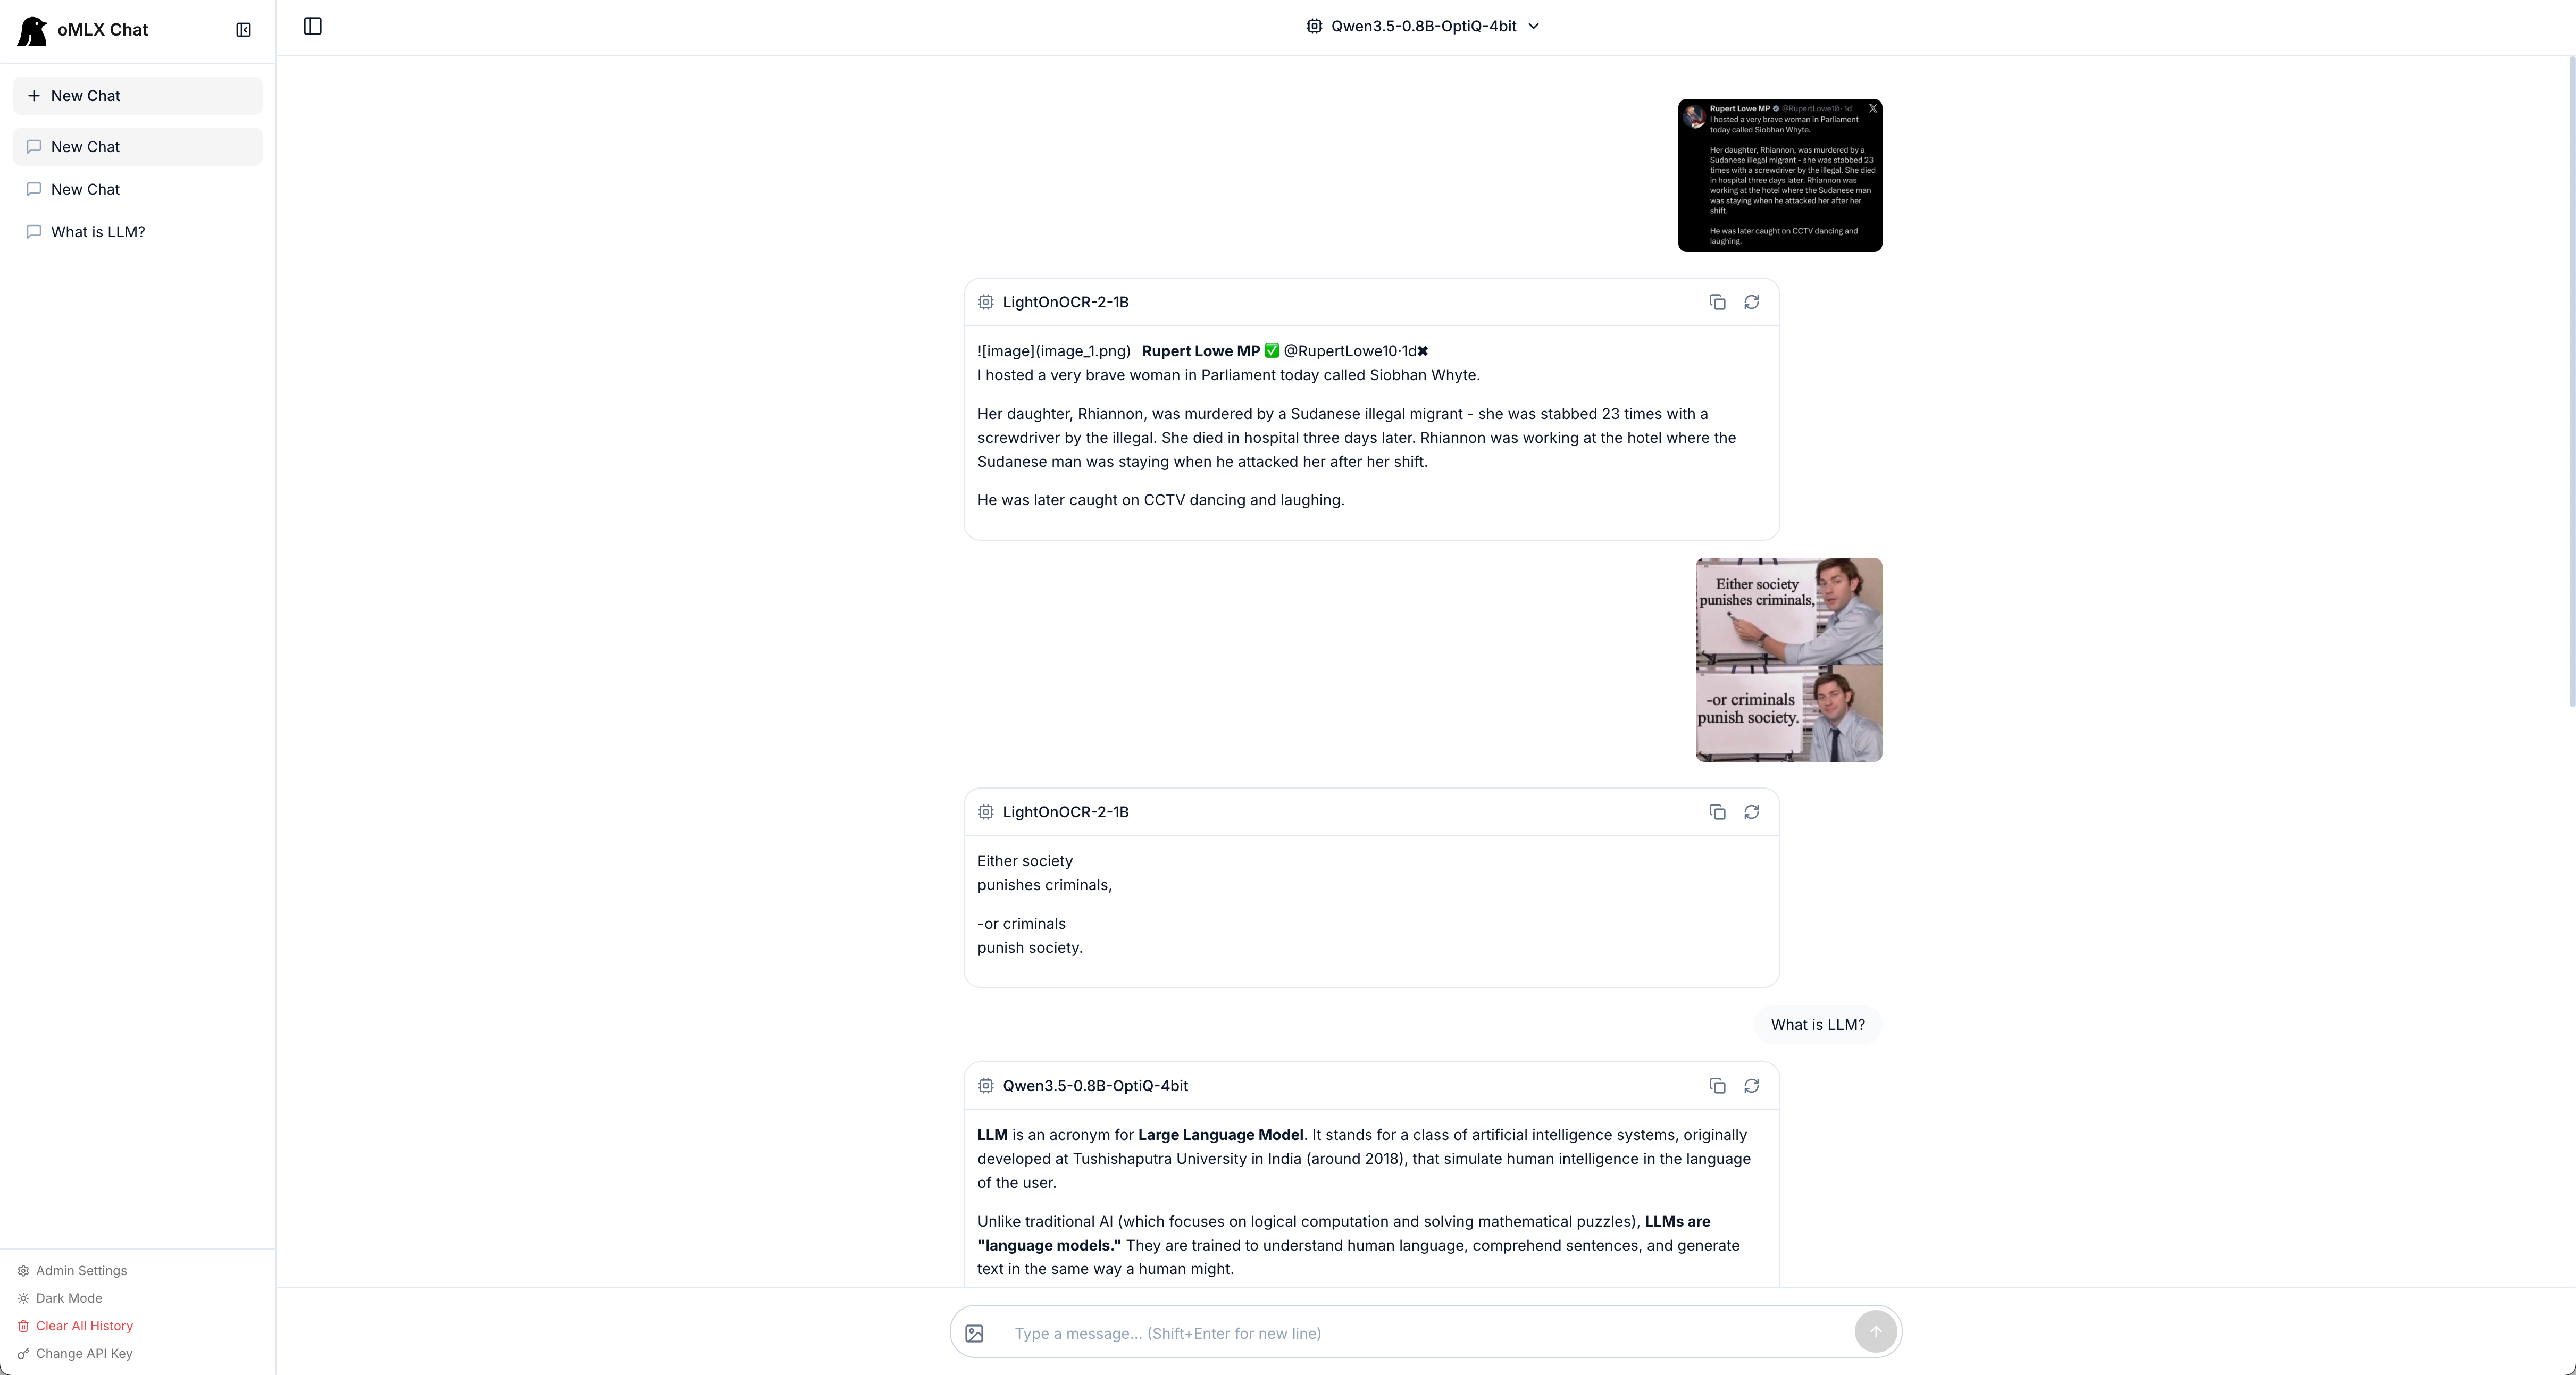
内置聊天
直接从管理面板与任何已加载模型聊天。支持对话历史、模型切换、深色模式、推理模型输出,以及 VLM/OCR 模型的图像上传。
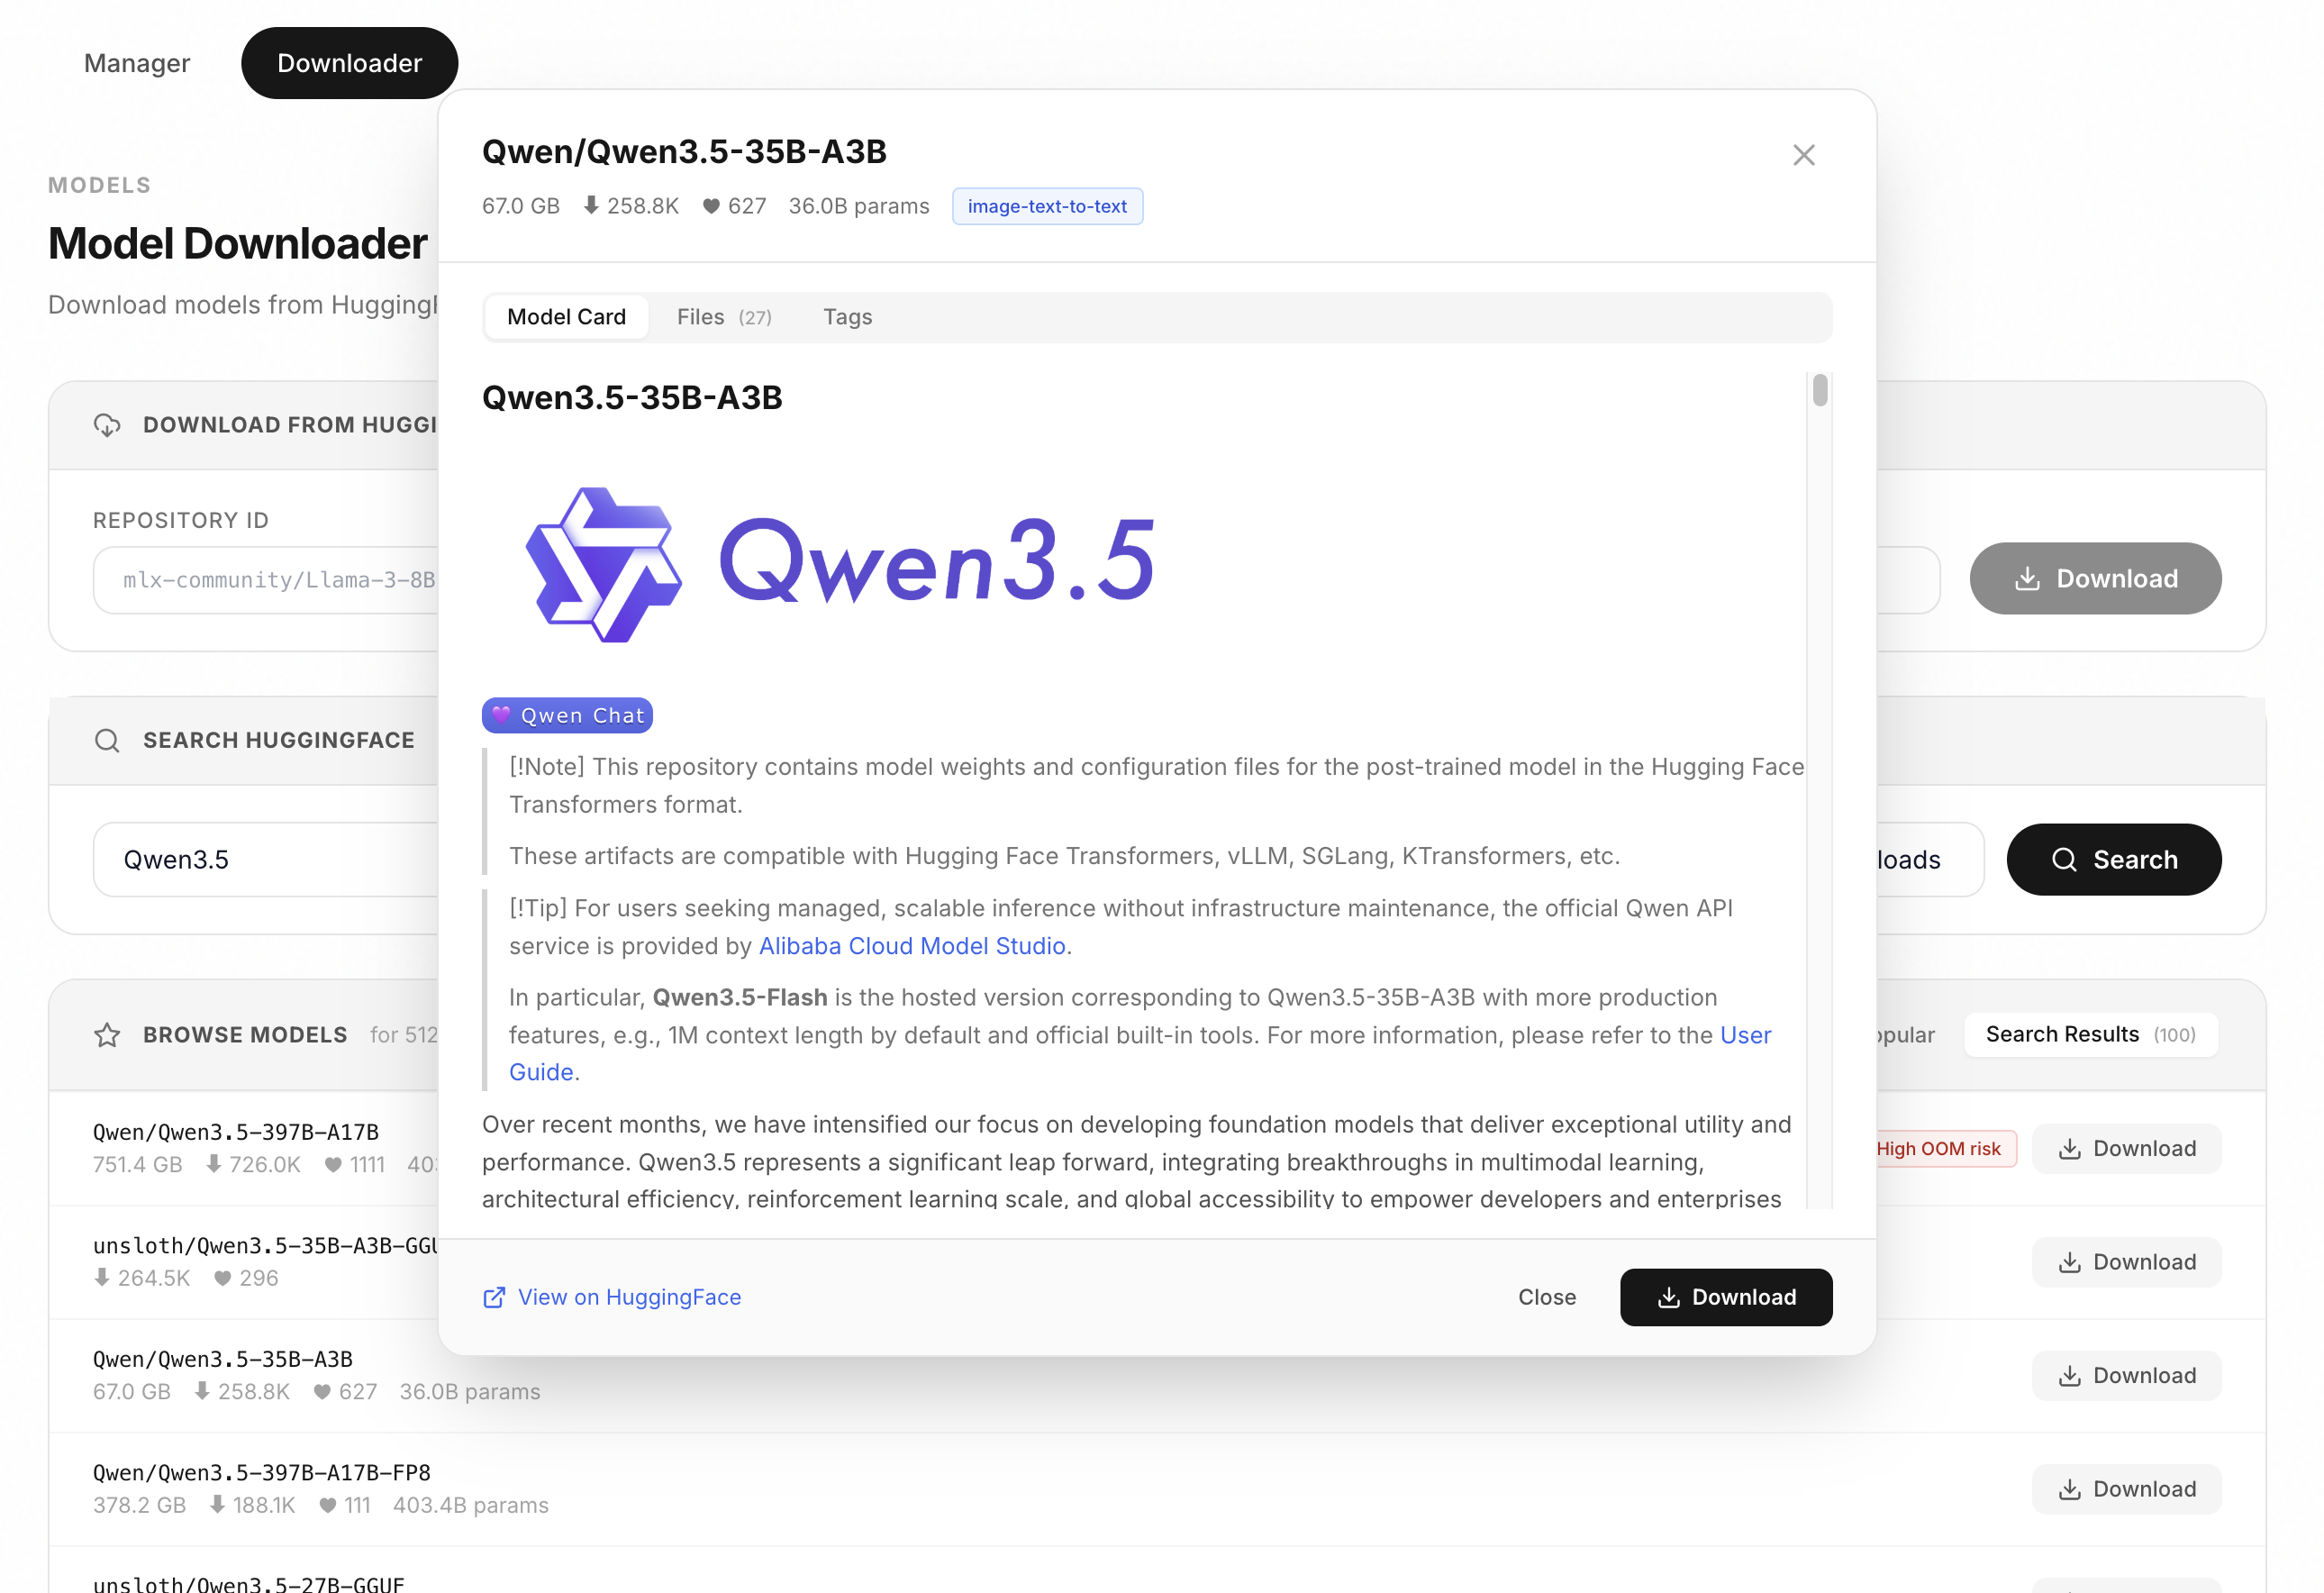
模型下载器
在管理面板中直接搜索并从 HuggingFace 下载 MLX 模型。浏览模型卡、检查文件大小,一键下载。
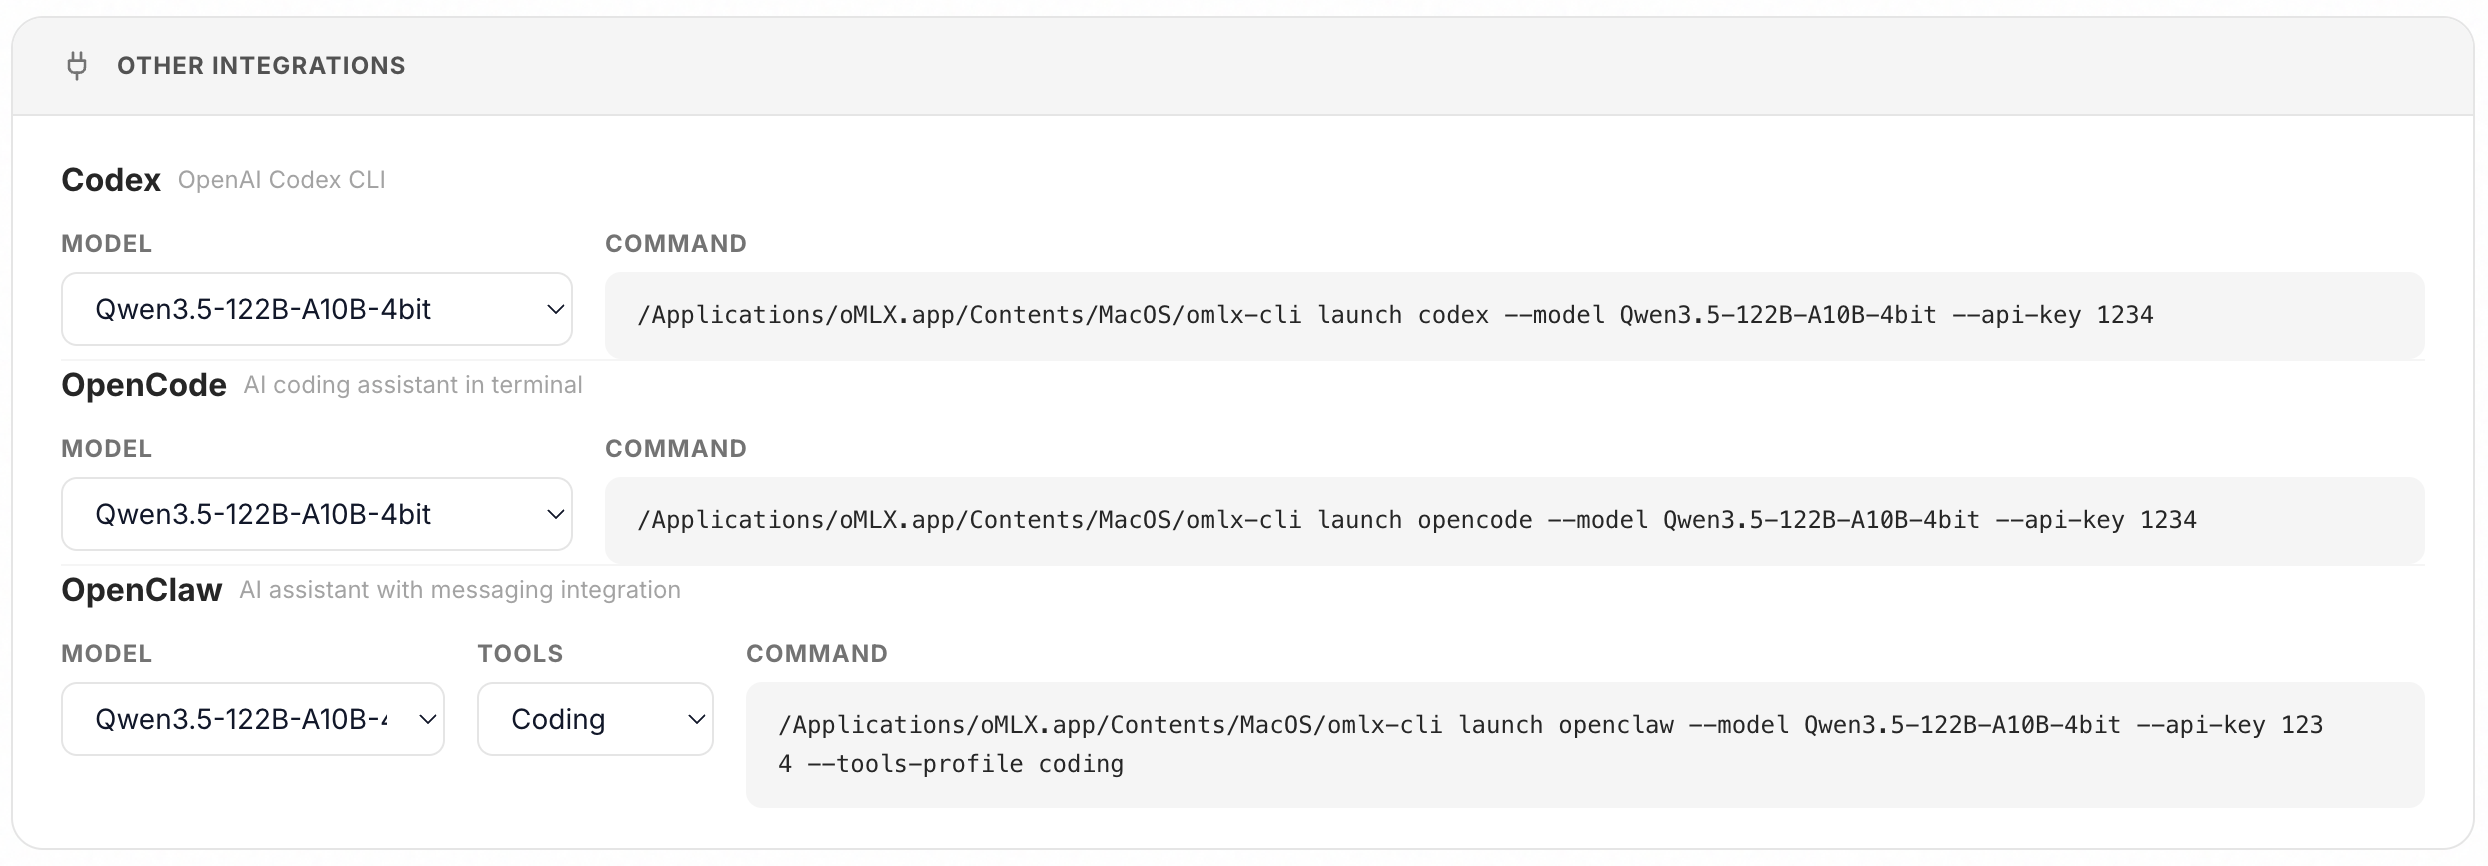
集成
从管理面板一键设置 OpenClaw、OpenCode、Codex 和 Pi。无需手动编辑配置。
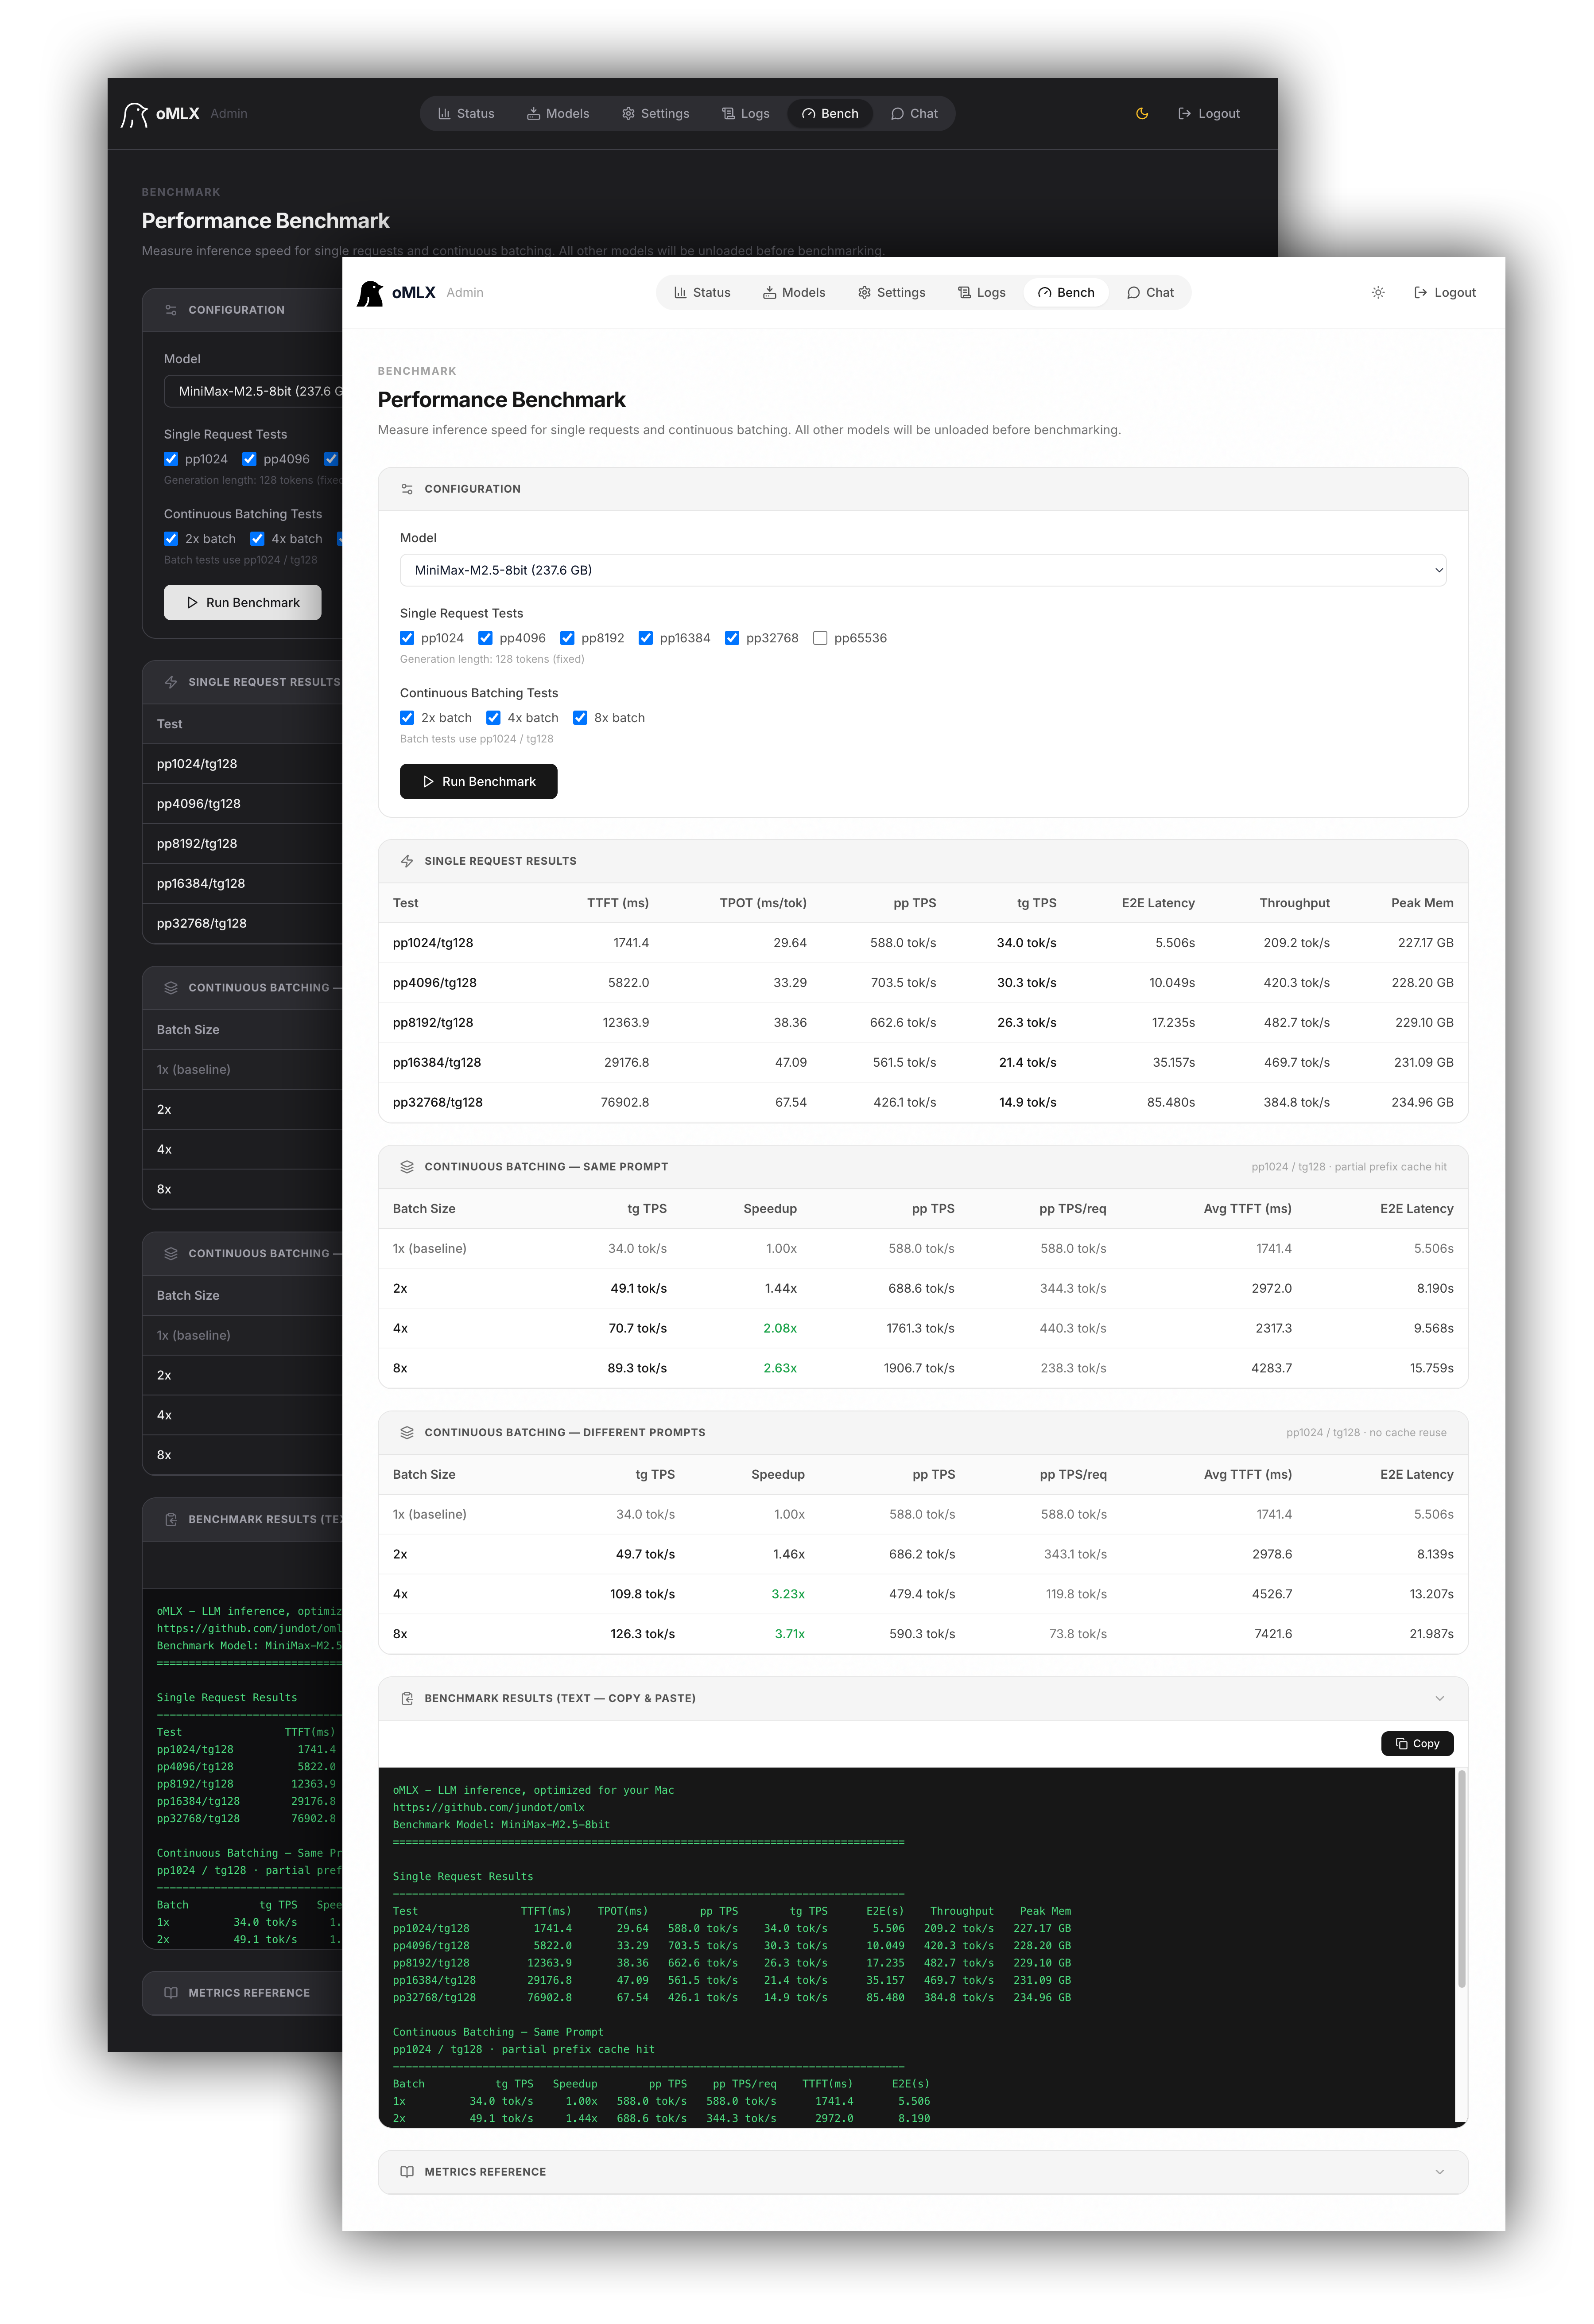
性能基准
从管理面板一键运行基准测试。测量预填充(PP)和文本生成(TG)的每秒 token 数,支持部分前缀缓存命中测试,以得出实际性能数据。
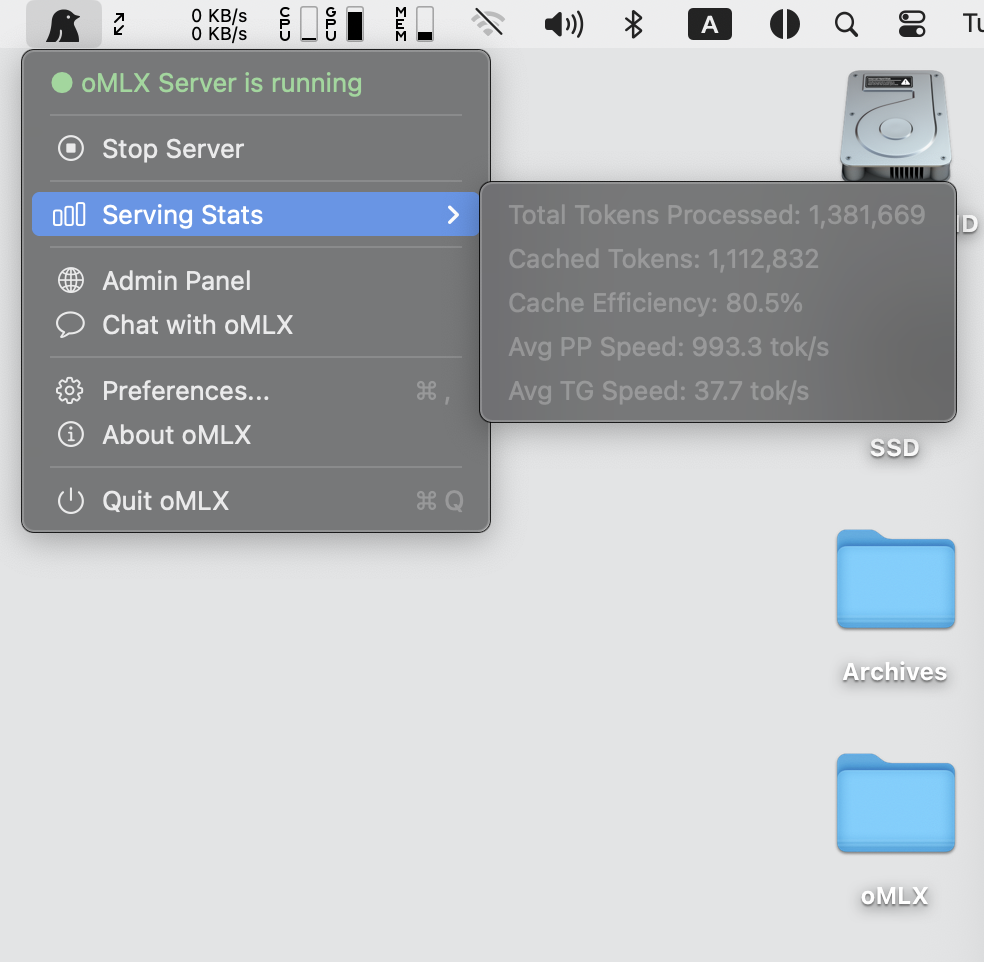
macOS 菜单栏应用
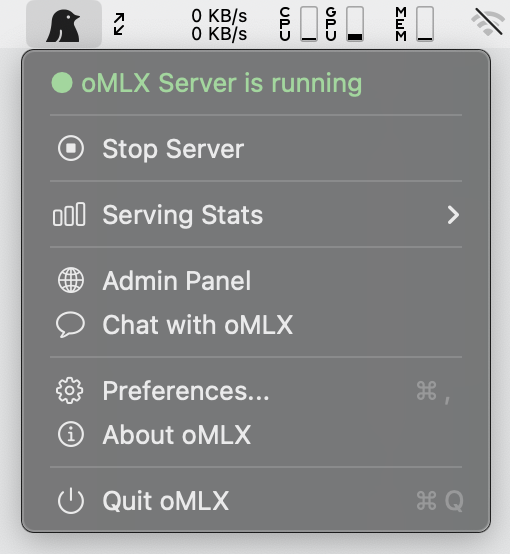
原生 PyObjC 菜单栏应用(非 Electron)。无需打开终端即可启动、停止和监控服务器。包含持久化服务统计(重启后保留)、崩溃后自动重启和应用内自动更新。
API 兼容性
可直接替代 OpenAI 和 Anthropic API。支持流式使用统计(stream_options.include_usage)、Anthropic 自适应思考以及视觉输入(base64、URL)。
| 端点 | 描述 |
|---|---|
POST /v1/chat/completions |
聊天补全(流式) |
POST /v1/completions |
文本补全(流式) |
POST /v1/messages |
Anthropic Messages API |
POST /v1/embeddings |
文本嵌入 |
POST /v1/rerank |
文档重排序 |
GET /v1/models |
列出可用模型 |
工具调用与结构化输出
支持 mlx-lm 中所有可用的函数调用格式、JSON schema 验证和 MCP 工具集成。工具调用要求模型的聊天模板支持 tools 参数。以下模型系列通过 mlx-lm 的内置工具解析器自动检测:
| 模型系列 | 格式 |
|---|---|
| Llama、Qwen、DeepSeek 等 | JSON <tool_call> |
| Qwen3.5 Series | XML <function=...> |
| Gemma | <start_function_call> |
| GLM (4.7, 5) | <arg_key>/<arg_value> XML |
| MiniMax | 命名空间 <minimax:tool_call> |
| Mistral | [TOOL_CALLS] |
| Kimi K2 | <|tool_calls_section_begin|> |
| Longcat | <longcat_tool_call> |
上表未列出的模型如果其聊天模板接受 tools 且输出使用可识别的 <tool_call> XML 格式,也可能正常工作。对于启用工具调用的流式输出,助手文本会逐步发出,同时已知的工具调用控制标记会从可见内容中隐藏;完成轮次解析后会发出结构化工具调用。
模型
将 --model-dir 指向包含 MLX 格式模型子目录的目录。也支持两级组织文件夹(例如 mlx-community/model-name/)。
~/models/
├── Step-3.5-Flash-8bit/
├── Qwen3-Coder-Next-8bit/
├── gpt-oss-120b-MXFP4-Q8/
├── Qwen3.5-122B-A10B-4bit/
└── bge-m3/
模型会自动按类型检测。你也可以直接从管理面板下载模型。
| 类型 | 模型 |
|---|---|
| LLM | mlx-lm 支持的任何模型 |
| VLM | Qwen3.5 Series、GLM-4V、Pixtral 及其他 mlx-vlm 模型 |
| OCR | DeepSeek-OCR、DOTS-OCR、GLM-OCR |
| Embedding | BERT、BGE-M3、ModernBERT |
| Reranker | ModernBERT、XLM-RoBERTa |
CLI 配置
# 已加载模型的内存限制
omlx serve --model-dir ~/models --max-model-memory 32GB

# 进程级内存限制(默认:auto = RAM - 8GB)
omlx serve --model-dir ~/models --max-process-memory 80%

# 启用 KV 块的 SSD 缓存
omlx serve --model-dir ~/models --paged-ssd-cache-dir ~/.omlx/cache

# 设置内存热缓存大小
omlx serve --model-dir ~/models --hot-cache-max-size 20%

# 调整最大并发请求数(默认:8)
omlx serve --model-dir ~/models --max-concurrent-requests 16

# 使用 MCP 工具
omlx serve --model-dir ~/models --mcp-config mcp.json

# HuggingFace 镜像端点(适用于受限区域)
omlx serve --model-dir ~/models --hf-endpoint https://hf-mirror.com

# API 密钥认证
omlx serve --model-dir ~/models --api-key your-secret-key
# 仅本地主机:通过管理面板全局设置跳过验证
所有设置也可通过 Web 管理面板(/admin)配置。设置持久化到 ~/.omlx/settings.json,CLI 标志优先。
FastAPI Server (OpenAI / Anthropic API)
    │
    ├── EnginePool (多模型,LRU 驱逐,TTL,手动加载/卸载)
    │   ├── BatchedEngine(LLM,连续批处理)
    │   ├── VLMEngine(视觉语言模型)
    │   ├── EmbeddingEngine
    │   └── RerankerEngine
    │
    ├── ProcessMemoryEnforcer(总内存限制,TTL 检查)
    │
    ├── Scheduler(FCFS,可配置并发度)
    │   └── mlx-lm BatchGenerator
    │
    └── 缓存栈
        ├── PagedCacheManager(GPU,基于块,写时复制,前缀共享)
        ├── 热缓存(内存层,写回)
        └── PagedSSDCacheManager(SSD 冷层,safetensors 格式)
开发
CLI 服务器
git clone https://github.com/jundot/omlx.git
cd omlx
pip install -e ".[dev]"
pytest -m "not slow"
macOS 应用
需要 Python 3.11+ 和 venvstacks(pip install venvstacks)。
cd packaging

# 完整构建(venvstacks + 应用包 + DMG)
python build.py

# 跳过 venvstacks(仅代码修改)
python build.py --skip-venv

# 仅 DMG
python build.py --dmg-only
关于应用包结构和层配置的详细信息,请参阅 packaging/README.md。
贡献
欢迎贡献!详情请参阅贡献指南。
- 错误修复和改进
- 性能优化
- 文档改进
许可证
致谢
- MLX 和 mlx-lm by Apple
- mlx-vlm - 在 Apple Silicon 上进行视觉语言模型推理
- vllm-mlx - oMLX 起源于 vllm-mlx v0.1.0,并在多模型服务、分层 KV 缓存、支持完整分页缓存的 VLM、管理面板和 macOS 菜单栏应用方面进行了显著演进
- venvstacks - 用于 macOS 应用包的可移植 Python 环境分层
- mlx-embeddings - 适用于 Apple Silicon 的嵌入模型支持
- dflash-mlx - 在 Apple Silicon 上进行块扩散推测解码