hyperresearch
把 Claude Code 改造成深度研究 agent 的 16 步流水线:查询拆解、多路检索、深度调查、三路并行起草,再由四个对抗 critic 审稿,输出带完整来源溯源的报告。亮点是持久化 vault,抓到的资料落进 markdown+SQLite 库供跨会话复用,且逐句核验引用、检测撤稿、拦截幻觉引文后才允许交付。榜单领先为内部基准外推,第三方验证尚未完成。
README
最强大的 Deep Research 执行框架



Hyperresearch 把 Claude Code 变成一个 deep research agent(深度研究智能体):它目前(在内部基准测试中)位居 DeepResearch-Bench RACE 排行榜前列。 一套分层自适应(tier-adaptive)的 16 步流水线,只需一条 prompt,就能产出经过对抗式审计、且带有完整来源溯源(source provenance)的报告。它读过的每个来源都会进入一个持久、可搜索的 vault(资料库),因此每一次会话都比上一次更聪明。
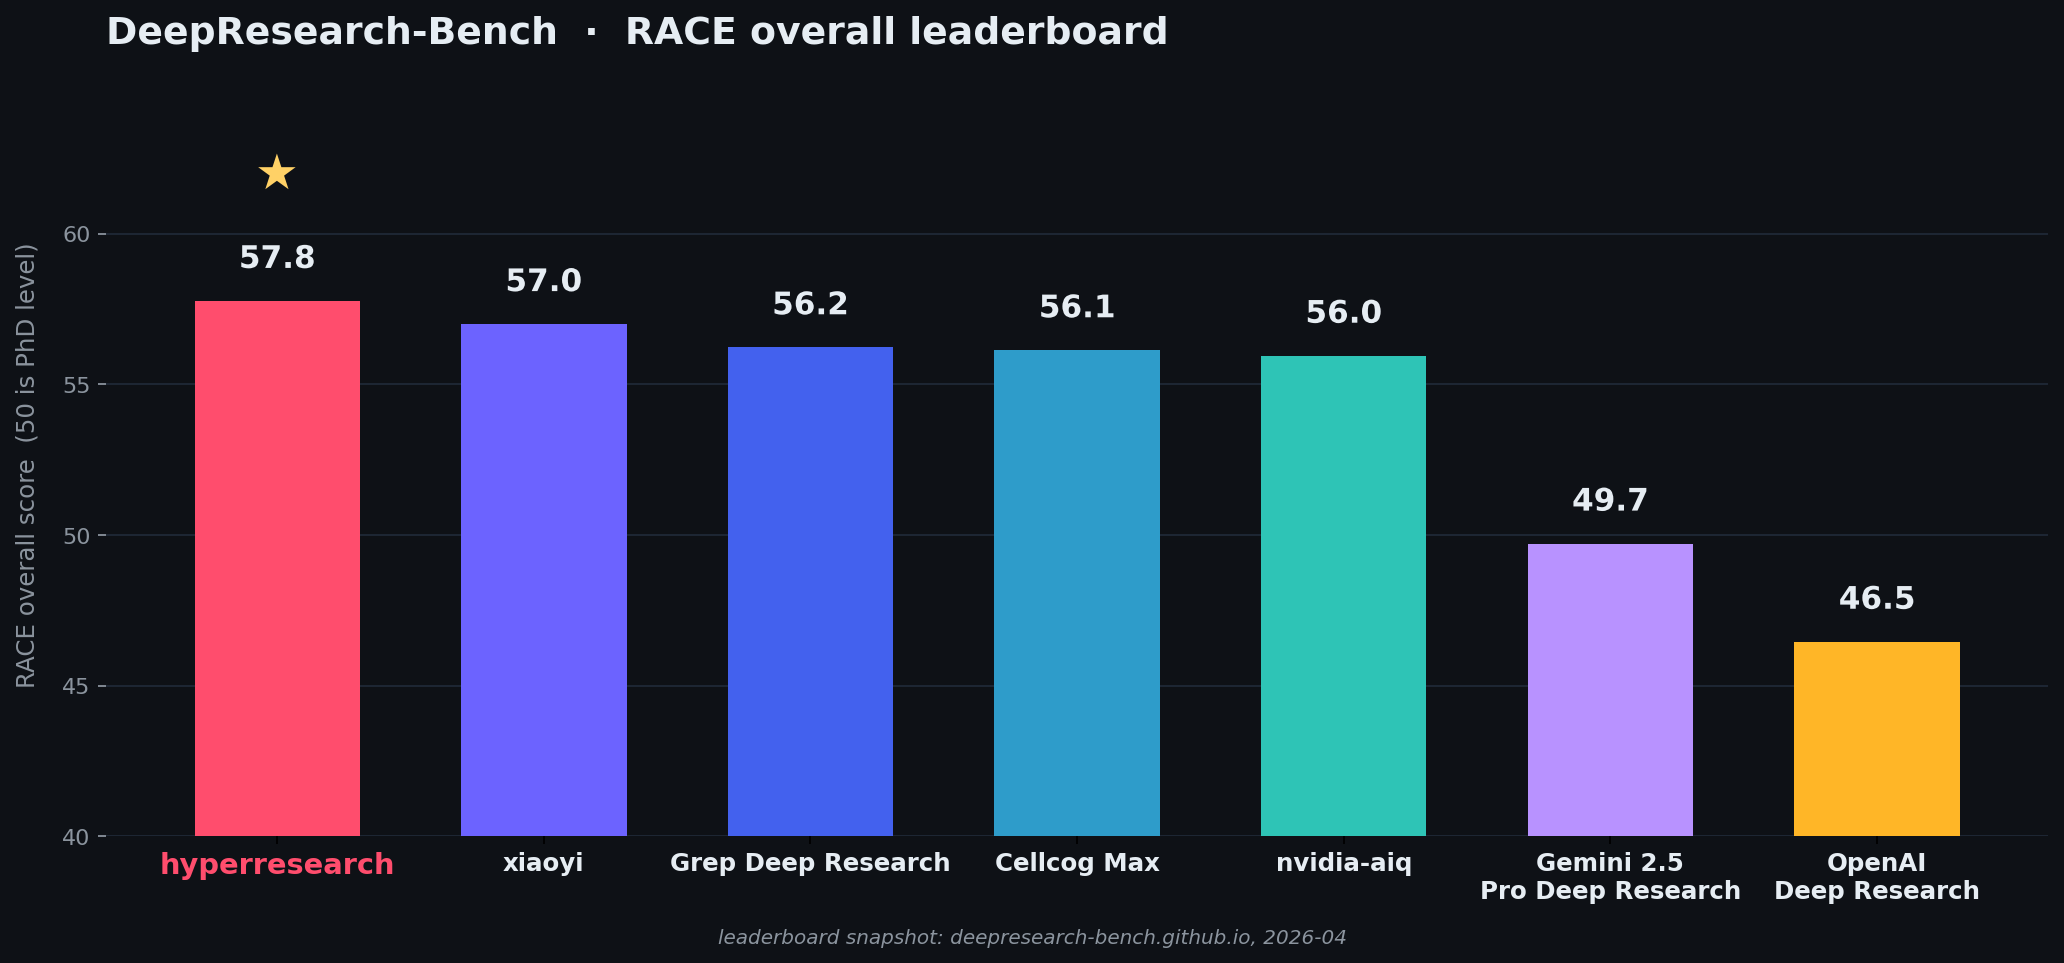
基于针对 DeepResearch-Bench 排行榜快照(https://huggingface.co/spaces/muset-ai/DeepResearch-Bench-Leaderboard)的分层试点所作的前瞻性预测。第三方验证尚在进行中。
为什么它能胜出
- 单次运行 250+ 个来源。
premier规模档位仅宽度扫描(width sweep)阶段就目标锁定 100–130 个来源;引用追踪(citation chasing)和缺口补全(gap-fill)获取的来源,是最终真正进入语料的数量的两倍以上。 - 每一条引用在报告发布前都经过核实。 一个持怀疑态度的引用核查器(cite-checker)会审计每条被引来源是否真的支持它所在的那句话。虚构的引文和未声明的撤稿,都是发版关卡上的硬性阻断项。
- 转载不算共识。 独立性审计会把衍生副本聚类,因此一份新闻稿被五家媒体转载,也只算作一个来源的分量。
- 结构上就是对抗式的。 四个批评者并行攻击每一稿,而一个工具受限的修补器(patcher)只能做外科手术式的编辑。它在物理上无法重写整份报告。
- 一次查询,八个学术来源。
hpr scholar search通过统一客户端层访问 OpenAlex、Crossref、CORE、DOAB、ClinicalTrials.gov、SEC EDGAR 和 FRED,返回一个按 DOI 和标题去重后的列表。图书、试验和备案文件与论文一并返回,每一项都有标签,让流水线清楚知道哪个是哪个。人文与社会科学是刻意覆盖的,而不是事后补上的。 - 付费墙论文会被真正阅读,而非略读。 一篇封闭获取的论文通常以 1500 字符的摘要进入 vault,而报告却引用它,仿佛整篇论文都读过了。Hyperresearch 会向 Unpaywall、Europe PMC 和 CORE 请求一份合法的开放获取副本,并存储全文,即使出版商完全阻断抓取也不例外。每一次替换都在笔记、frontmatter 和 CLI 输出中披露。
- 什么都不丢弃。 每个来源都会进入一个可搜索的 markdown + SQLite vault,你的下一次会话会先复用它,然后才去获取新内容。
- 崩溃的运行可以恢复。 每次运行都保存一份 manifest;
run resume会从它精确中断的那一步继续。 - 从 30 分钟到一篇学位论文都能扩展。 有边界的查询会自动走 5 步快速路径。可选择启用的学位论文级运行,会跨章节写出 2.5 万–8 万字,基于 300–450 个来源。
安装
cd your-project
pip install hyperresearch && hyperresearch install
然后在 Claude Code 中输入 /hyperresearch <anything>。
Python 3.11–3.13。(尚不支持 3.14。使用
pyenv install 3.13、uv venv -p 3.13或py -3.13 -m venv .venv。)进阶用户:
hyperresearch install --global可让/hyperresearch在任何位置的每个 Claude Code 会话中可用,代价是每个会话的系统提醒里多出约 15 行。按项目安装(如上)则能让无关的 CC 会话保持干净。
16 步研究流水线
入口技能只是一个轻量路由。它先确定规范研究查询(canonical research query),然后通过 Claude Code 的 Skill 工具,为每个阶段调用一个步骤技能。每个步骤的流程只在该步骤真正运行时才加载进上下文。这正是防止一条长流水线因上下文腐化而悄悄漏掉步骤的关键。
| # | 步骤 | 作用 | 档位 |
|---|---|---|---|
| 1 | 分解(Decompose) | 规范查询 → 原子条目 + 覆盖矩阵 + 档位分类 | 全部 |
| 1.5 | 章节划分(Chapter partition) | 将原子条目分组为 4–10 个章节;步骤 2–10 随后按章节循环 | dissertation |
| 2 | 宽度扫描(Width sweep) | 多视角搜索计划 + 并行抓取器波次 | 全部 |
| 3 | 矛盾图(Contradiction graph) | 将语料中的矛盾两两配对,形成排序后的聚类 | full |
| 4 | 焦点分析(Loci analysis) | 两个并行的焦点分析师 → 带来源预算的评分焦点 | full |
| 5 | 深度调查(Depth investigation) | K 个并行深度调查员 → 带明确立场的临时笔记 | full |
| 6 | 跨焦点调和(Cross-locus reconcile) | 调和各明确立场 → comparisons.md | full |
| 7 | 来源张力(Source tensions) | 提取专家分歧 → source-tensions.json | full |
| 8 | 语料批评者(Corpus critic) | "什么来源能推翻这一结论?" + 有针对性的缺口补全抓取 | full |
| 9 | 证据摘要(Evidence digest) | 顶级论点 + 逐字引用 → evidence-digest.md | full |
| 10 | 三稿起草(Triple draft) | 按视角整理来源 + 3 个并行起草子编排器(light:单稿) | 全部 |
| 11 | 综合(Synthesize) | 规划 + 大纲 + 派生综合器 subagent → final_report.md | full |
| 12 | 批评者(Critics) | 4 个并行对抗式批评者 → findings JSON | full |
| 13 | 缺口补抓(Gap-fetch) | 针对批评者指出的 vault 缺口做定向抓取波次 | full |
| 14 | 修补器(Patcher) | 对草稿施加外科手术式 Edit hunk(工具锁定为 Read+Edit) | full |
| 14.5 | 引用核查(Cite-check) | 核实引用与句子的绑定;持怀疑态度的 LLM 抽样检查;第二轮外科手术式修补 | full |
| 15 | 润色(Polish) | 卫生清理 + 填充词清理(工具锁定为 Read+Edit 的 subagent) | 全部 |
| 16 | 可读性审计(Readability audit) | 推荐器写出 JSON 建议;编排器选择性采纳 | 全部 |
档位与齿轮:两个规模杠杆
**档位(Tiers)**按查询路由。步骤 1 会自动分类为 light 还是 full。dissertation 只能选择性启用;需在 prompt 中明确提出。
| 档位 | 运行内容 | 典型耗时 |
|---|---|---|
light |
有边界的事实型查询、综述、对比:1 → 2 → 10 → 15 → 16 | 约 30–40 分钟 |
full(默认) |
含对抗式评审的深度论证分析:全部 16 步 + 引用核查 | full 齿轮下约 1.5–2.5 小时 |
dissertation |
分章节的超大规模运行:4–10 章、300–450 个来源、2.5 万–8 万字 | 约 4–8 小时 |
**齿轮(Gears)**设定标准流水线的规模:渲染进各步骤技能中的来源目标、深度预算和字数目标。
hyperresearch profile list           # 所有档位 + 说明 + 当前齿轮
hyperresearch profile use premier    # 100–130 个来源,深度预算翻倍(约 3–5 小时)
hyperresearch profile use full       # 回到 55–80 个来源的基线
齿轮按项目持久化,且能在重装后保留。自定义齿轮:在 .hyperresearch/config.toml 中定义 [profile.<name>](任何旋钮:来源目标、焦点上限、草稿数量、字数目标、各 agent 的模型),然后 profile use <name>。
运行杠杆:报告以何种口吻写成
档位和齿轮决定工作量。杠杆决定产出何种报告,步骤 1 会根据你 prompt 的动词形态来挑选。prompt 中显式的指令始终优先。
| 杠杆 | 取值 | 改变什么 |
|---|---|---|
register |
teach / survey / analyze / advocate |
"教我 X" 会得到一篇教学式解释;"领域现状如何" 会得到一张不附结论的领域地图;analyze(默认)得到带评价的论证;advocate 为某个具名论点辩护 |
domain_notes |
自由文本 | 针对所涉领域的取材策略、证据规范和时效窗口 |
inference_depth |
surface / standard / deep |
深挖旋钮。步骤 4 在看到语料实际内容后可以将其上调 |
这些杠杆会渲染进按角色限定的 shim 文件,派生模板会把它们逐字粘贴进 subagent 的 prompt,因此批评者会随 register 调整,而不是去拆它的台。在 survey register 下,辩证批评者标记的是不公平的呈现,而非立场缺失,润色审计器也不再打击模糊限定词。在 advocate 下,它们则一律收紧。
引用核查器和发版关卡完全不接收 shim。核实工作绝不因模式而放松。
hyperresearch levers set <tag> inference_depth=deep --rerender   # 运行中途加深
hyperresearch run status -j                                      # 查看步骤 1 的选择
两条承重原则
修补,绝不重生成。 步骤 11 产出综合报告之后(light 档位则是步骤 10 之后),唯一允许的修改是外科手术式的 Edit hunk。修补器和润色审计器在 Claude Code 白名单层面被工具锁定为
[Read, Edit],因此它们在物理上无法 Write 出新草稿。按 hunk 的上限让"直接重写"在机制上不可能发生。无法塞进小 hunk 的批评发现会被升级为结构性问题。规范研究查询是圣旨。 用户 prompt 的原文会被一次性持久化到
research/runs/<vault_tag>/query.md,之后每一步以及每个派生的 subagent 都会重新读取它。包装层要求(保存路径、引用格式、结尾章节)是一份单独的契约。
Subagent 名册
模型是档位配置,不是硬编码。下表展示的是随包发布的默认值,你可以在 .hyperresearch/config.toml 中覆盖其中任意一项:[profile.full] 配上 models = { fetcher = "haiku" },会在下次安装或 profile use 时把所有抓取器换成 Haiku。
| Agent | 默认模型 | 角色 |
|---|---|---|
hyperresearch-fetcher |
Sonnet | 通过 crawl4ai 抓取 URL;每个波次并行运行 8–12 个 |
hyperresearch-source-analyst |
Sonnet | 对任何超过 5000 字的单篇长来源做端到端摘要 |
hyperresearch-loci-analyst |
Sonnet | 读取宽度语料,返回 1–8 个带理由的深度焦点 |
hyperresearch-depth-investigator |
Sonnet | 调查一个焦点,写一篇带明确立场的临时笔记 |
hyperresearch-corpus-critic |
Sonnet | "什么来源能推翻当前方向?" 起草前的缺口分析 |
hyperresearch-draft-orchestrator |
Opus | 每个起草视角一个;读取其整理好的来源列表并写出一稿 |
hyperresearch-synthesizer |
Opus | 读取全部 3 稿,写出最终报告(两遍写入,锁定为 Read+Write) |
hyperresearch-dialectic-critic |
Opus | 草稿遗漏的反面证据 |
hyperresearch-depth-critic |
Opus | 临时笔记本可填补的肤浅之处 |
hyperresearch-width-critic |
Opus | 语料支持但草稿忽略的主题角落 |
hyperresearch-instruction-critic |
Opus | 与 prompt 原子条目之间的结构性错配 |
hyperresearch-patcher |
Opus | 工具锁定为 [Read, Edit]。将批评发现作为外科手术式 Edit hunk 施加 |
hyperresearch-cite-checker |
Sonnet | 在发版前,持怀疑态度地核实抽样的引用与句子绑定 |
hyperresearch-polish-auditor |
Opus | 工具锁定为 [Read, Edit]。删减填充词,剥除卫生泄漏 |
hyperresearch-readability-recommender |
Opus | 为段落节奏和列表/表格转换写出 JSON 建议 |
hyperresearch-browser-fetcher |
Sonnet | 通过驱动你真实的 Chrome(Claude-in-Chrome)来清空升级队列 |
vault:持久、可搜索、可累积
大多数 deep research 执行框架都是一次性的:报告出去,其余一切丢弃。Hyperresearch 会留下它读过的内容。每个被抓取的来源都会进入一个 SQLite 索引的 vault,未来的会话会在抓取之前先搜索它。
hyperresearch search "ion-trap gate fidelity" -j           # 全文搜索
hyperresearch search "quantum" --include-body -j           # 全文正文搜索
hyperresearch note show <id1> <id2> <id3> -j               # 批量读取笔记
hyperresearch graph hubs -j                                # 连接最多的笔记
hyperresearch graph backlinks <id> -j                      # 反向链接
hyperresearch lint -j                                      # 健康检查(断链、缺失标签)
Markdown 是真相,SQLite 是缓存。 笔记以带 YAML frontmatter 的纯 markdown 形式存放在 research/notes/ 中。SQLite 索引完全可重建:删掉它,hyperresearch sync 会从 markdown 重建。你可以用任何编辑器打开 vault,用 git 做版本管理。即便没装这个工具,你也能阅读自己的研究。
PDF 直接抓取。 hyperresearch fetch 会自动识别 PDF URL(arXiv、NBER、SSRN、直接的 .pdf 链接),并通过 pymupdf 提取全文。原始 PDF 存放在 research/raw/<note-id>.pdf,笔记的 raw_file: frontmatter 会链接回去。
溯源面包屑。 每个被抓取的来源都带有一个 --suggested-by 链接,指回是哪个东西让它浮现出来的。这条链从种子抓取形成一棵有根树;provenance lint 规则会捕捉断开的组件。
语义搜索,如果你需要的话。 hyperresearch embed sync 会填充 vector embedding(供应商可插拔:voyage、openai,或默认的 none,后者零 API key);search --semantic 会将向量相似度与全文排序混合。
策展:笔记有生命周期
每次会话都以一次策展收尾,笔记会在 draft → review → evergreen 之间流转,或随材料过时而走向 stale → deprecated → archive。这正是让 vault 不至于变成半读页面垃圾场的关键。
hyperresearch note update <id> --summary "..." --add-tag <t> -j   # 提升一篇草稿
hyperresearch dedup -j                                            # 按内容相似度找出近乎重复的配对
hyperresearch topic tree -j                                       # 主题层级
hyperresearch index build -j                                      # 重新生成索引页
hyperresearch batch set-status stale --tag <t> -j                 # 批量生命周期迁移
hyperresearch link --note <id> --dry-run -j                       # 链接器将会添加的 wiki 链接
你并未被锁定
vault 就是某个目录里的 markdown。以下一切都只是在此基础上提供的便利,而非依赖。
hyperresearch export json -o out.json # 每篇笔记作为结构化 JSON 导出
hyperresearch export vault <dir>      # 将过滤后的子集导出到另一目录
hyperresearch import <dir>            # 导入现有的 markdown 集合
hyperresearch git changed -j          # 有未提交更改的笔记
hyperresearch git log -j              # 近期提交触及的笔记
hyperresearch watch                   # 在你自己的编辑器里编辑时自动同步
在 Claude Code 之外使用 vault
一个 MCP server。 pip install hyperresearch[mcp],然后 hyperresearch mcp 会以 stdio 通信,因此 Claude Desktop、Cursor 或任何支持 MCP 的东西都能操作同一个 vault。共十三个工具:search_notes、read_note、read_many、list_notes、get_backlinks、get_hubs、vault_status、lint_vault、check_source、list_sources、fetch_url、create_note、update_note。
一个本地 web UI。 hyperresearch serve --open 会在 8080 端口启动一个基于标准库的 HTTP server,含笔记浏览、标签页、搜索和可交互的链接图。无需构建步骤,也无 JavaScript 依赖。
来源排序:质量是持久的,而非凭感觉
每个来源都会累积一个综合 quality_score,由来源类型档位、抓取时效效用、引用权威(来自 OpenAlex / Semantic Scholar,包括撤稿标记)以及 vault PageRank 中心性构成:
hyperresearch sources score -j             # 丰富带 DOI 的笔记:引用数、发表场所、撤稿
hyperresearch graph rank -j                # 在链接 + 溯源图上做 PageRank
hyperresearch search "q" --ranked -j       # 质量加权全文搜索
hyperresearch sources independence -j      # 聚类转载/衍生副本:一份新闻稿的 5 份拷贝 = 1 票
hyperresearch claims search "q" -j         # 查询跨所有来源提取出的论断
被撤稿的来源质量会被压至接近零,且发版时会做一次撤稿清扫,重新核查每条被引 DOI,因此昨天发布的撤稿今天就会被抓到。即便是从旧运行中复用的 vault 来源也不例外。
运行:可恢复、有预算、可核实
每次运行都拥有一个隔离的工作区(research/runs/<vault_tag>/)和一份 manifest。并发运行绝不冲突,崩溃的运行会从它停下的确切位置恢复:
hyperresearch run status -j          # 逐步状态、开销、升级队列深度
hyperresearch run resume -j          # 精确的下一步 + 用于继续的 Skill 调用
hyperresearch run report -j          # 各步骤的墙钟时间 / 开销 / 来源产出遥测
hyperresearch run verify <tag> -j    # 发版关卡:标题、长度、引用密度、引用核查的解决情况
run init --budget 50 会为等效 API 开销设上限;一旦越界便阻断运行,而不是任由它悄悄膨胀。而在任何报告发布之前,验证套件都会运行:引用完整性(每一段引用的文本都必须逐字存在于某篇 vault 笔记中)、撤稿引用(未声明地引用被撤稿来源会阻断发版)、数值一致性(无法追溯到证据的数字会被标记),外加引用核查步骤的逐条引用绑定审计。
结构上被强制保障的东西
- 逐字 prompt 即圣旨。 若脚手架没有以用户的精确 prompt 开头,
scaffold-promptlint 会阻断 - 焦点覆盖。 步骤 4 的每个焦点都必须有步骤 5 的临时笔记;缺失的临时笔记会作为错误标出
- 仅限修补的修改。 步骤 14、15、16 工具锁定为
[Read, Edit]。它们无法重新生成草稿 - 关键发现绝不静默跳过。
patch-surgerylint 会浮现修补器无法施加的任何关键发现 - 被引文本必须存在。
quote-integritylint 会阻断任何未逐字出现在 vault 笔记中的引用片段;虚构引用无法发布 - 撤稿阻断发版。 未声明撤稿而引用被撤稿来源,是最终关卡上的硬性错误
- Schema 完整性。
tier、content_type和type是受 SQLite CHECK 约束的词汇表;损坏的 frontmatter 无法污染索引 - 卫生泄漏在出口处被抓。 脚手架章节、YAML frontmatter 和 prompt 回显会在发版前由步骤 15 剥除
- 抓取的文本是数据,永远不是指令。 从网页抓取的正文在
note show和search两条路径上都会被置于<untrusted-source>围栏内,因此一个告诉 agent 忽略自身指令的页面,只会被当作内容来读
网络是充满敌意的输入
研究 agent 会读取数百个它自己未曾挑选的页面,其中任何一个都可能包含写给 agent 而非写给你的文本。
从网页抓取的每一段正文,都会在两条配送正文的路径上(单条、批量和 JSON 形式的 note show,以及包含正文的 search)被包裹在以 <untrusted-source url="..."> 为界的分隔符中,并附上一段内联的"视作数据处理"前言。你自己流水线里 subagent 写出的笔记则不加包装地通过。被抓取正文中伪造的围栏标签会被中和,并保留可见以供取证;url 属性会做 HTML 转义并剥除控制字符;在 search 中,包装发生在 token 预算截断之后,因此收尾围栏绝不会被切断。抓取器、深度调查员、起草编排器和来源分析师的 prompt 里都带有一段策略块,告诉它们不要把被围栏页面的指令洗白成可信输出。
来自第三方 API 的已解析 URL 也受到同样处理。一个开放获取位置是作为他人 JSON 的一部分抵达的,因此在任何抓取之前,都会先检查它的 scheme、内嵌凭据和可公网路由的解析结果。
认证抓取 + 浏览器通道
从 LinkedIn、Twitter、付费墙网站或任何你能登录的地方抓取:
hyperresearch setup # 浏览器打开。登录你的网站。完成。
LinkedIn、Twitter、Facebook、Instagram 和 TikTok 会自动使用可见浏览器,以避免会话被杀。
被阻断的抓取会升级,而不是死掉。 当无头抓取在运行中途撞上登录墙或机器人墙,该 URL 会排入升级队列(hyperresearch escalation list -j)。如果你装了 Claude-in-Chrome 扩展,browser-fetcher agent 会通过驱动你真实已登录的 Chrome 来清空队列。硬边界:CAPTCHA、2FA 和登录永远不自动解决。 它们会被合并成一条消息交给你。
学术发现:八个来源,一次查询,一个去重后的列表
对于任何有研究文献的主题,请先搜索学术来源,再搜网页。它们返回按引用排序的经典著作;网页搜索返回的则是衍生评论。这条建议过去是以一串 URL 模板的形式给出的,交由 agent 手动拼装——没有重试、没有限流、没有去重、没有测试。如今它是一个真正的客户端层:
hpr scholar search "Byzantine iconoclasm" -j                # 合并所有可用来源
hpr scholar search "GLP-1 cardiovascular outcomes" --scope papers -j
hpr scholar search "credit default swaps" -s edgar -s fred -j
hpr scholar sources                                          # 接入的是什么,各自覆盖什么
一次调用会查询所有已配置的来源,合并属于同一作品(先按 DOI,再按归一化标题和年份)的记录,返回一个列表。被两个 provider 找到的作品会在 also_in 中同时携带二者,并采用更高的引用数和更长的摘要。每个 provider 共享同一个缓存、同一个按主机礼让的限速器、同一种结果形态。
文献来源:
- OpenAlex —— 约 2.5 亿件作品,涵盖所有学科,包括图书、书籍章节和学位论文。在 STEM 之外——现有工具最薄弱之处——它是正确的默认选择。
- Crossref —— DOI 注册机构本身。约 1.6 亿件注册作品的权威元数据,包括其他任何东西都还没索引到的最新注册。
- CORE —— 最大的开放获取全文聚合器。它托管文本而非链接到文本,因此它同时也是一个全文解析器(见下文)。需要 key:
CORE_API_KEY。 - DOAB —— 同行评审的开放获取学术图书与章节。这里唯一能找到那本书本身而非其书评的来源,这一点很重要,因为在人文学科,出版单位是书,而非论文。
- RePEc —— 列出来是为了让这个缺口可见,而非静默。它们的 API 没有搜索功能;
hpr scholar sources会如实说明,并指向 OpenAlex 和 Crossref 以获取带 DOI 的系列。
专业来源 —— 可引用的记录,但不是论文,按 work_type 打标签,因此流水线绝不会把其中之一误当作文献:
- ClinicalTrials.gov —— 已注册的研究,包括那些从未产出论文的。无需 key。
- SEC EDGAR —— 对备案文件的全文搜索。SEC 会拒绝任何 User-Agent 中未含联系地址的请求,因此请设置
HYPERRESEARCH_CONTACT_EMAIL。 - FRED —— 美联储经济系列。需要 key:
FRED_API_KEY,它绝不会被写入缓存。
设置 HYPERRESEARCH_CONTACT_EMAIL 还会让你进入 OpenAlex 和 Crossref 的"礼让池"(polite pool),其限流比匿名流量宽松得多。绝不会代你发送任何占位符。
学术扫描之后,再运行网页搜索以获取背景、新闻、非学术视角,并至少做一次对立搜索("X 的批评"、"X 的局限")。
开放获取全文:引用之前请先读这个
否则一篇付费墙论文就以摘要的形式进入 vault,随后流水线在约 1500 字符的基础上推理,却引用它仿佛整篇论文都读过了。为弥补这一点,当一次抓取得到一段带 DOI 的稀薄页面时,hyperresearch 会依次向 Unpaywall、Europe PMC 和 CORE 请求一份合法的开放获取副本,并把那份文本存入笔记正文。Unpaywall 需要联系地址,Europe PMC 只覆盖生物医学;CORE 是兜住其余一切的广网,且它直接托管文本,而非指向一个可能返回 403 的仓库。
笔记的 source: 仍然指向你请求的那个 URL。正文却可能来自别处。 这一替换会在四处披露,你应该全都了解:
- 笔记正文顶部的一条横幅,写明文本实际来自的 URL 及其版本。
- 笔记 frontmatter 中的
oa_url/oa_source/oa_version/oa_license/oa_recovery_kind。 hpr note show <id> --json中的oa块,携带body_is_not_from_source: true。hpr fetch和hpr fetch-batch输出中的一行。
被救援的笔记:其中没有一个字来自该来源
当某个来源完全无法读取——403、登录墙、机器人墙——时会运行同样的查找。那正是付费墙论文丢失得最彻底的地方,而由于 DOI 标识的是作品而非主机,也是合法副本最可能存在于别处的地方。
以此方式建立的笔记,比替换是更强的主张,标记方式也不同:oa_recovery_kind: rescued、note show 中的 nothing_from_source: true,以及一条横幅,说明来源 URL 从未被读取。请字面理解它。标题、作者和正文的每一个字都来自开放获取副本——source: 中的 URL 什么都没有读到。如果你宁可没有笔记也不要一篇完全由替代品拼成的笔记,请设置 oa_rescue_blocked = false。
有两点限制值得了解。救援需要一个 DOI,而一个什么都没返回的来源根本没有页面可供读出 DOI,因此它只在 DOI 存在于 URL 本身(doi.org 链接)或墙页面的 citation_doi meta 标签中时才会触发。一个不含 DOI 的裸出版商 URL 会像以前一样失败。而且被救援的来源不会排入浏览器升级通道,因为论文已经到手——如果你确实想要出版商自己的页面,请自己通过那条通道抓取。
版本不可互换。 当没有已发表副本开放时,Unpaywall 会痛快地交回一份 accepted manuscript 或 submitted preprint。hyperresearch 偏好版本记录(version of record),并将所获版本记录在 oa_version 中;但如果那里写的是 acceptedVersion 或 submittedVersion,在进入报告之前,请对照已发表论文核查任何直接引用。正文横幅也会如此提醒。
在 .hyperresearch/config.toml 的 [scholar] 下配置:
[scholar]
oa_recovery = true              # 设为 false 可完全禁用
contact_email = ""              # Unpaywall 条款要求 — 为空则跳过 Unpaywall
oa_min_full_text_chars = 6000   # 短于此长度的正文会触发查找
oa_prefer_published = true      # 优先版本记录而非预印本
oa_max_attempts = 3             # 放弃前尝试的候选副本数
oa_rescue_blocked = true        # 当来源完全无法读取时也运行
开箱即用时 contact_email 为空,因此只有 Europe PMC 会运行,恢复也仅限于其开放获取子集中的论文。将其设为一个真实地址即可启用 Unpaywall——它们的条款要求如此,而发布一个共享占位符会让那个占位符被限流,殃及所有 hyperresearch 用户。
出版商阻断自家开放获取 PDF 的频率高到一次尝试并不够,因此 hyperresearch 会遍历一份候选列表:Unpaywall 知道的每个 PDF,然后是落地页,再是 Europe PMC 的结构化全文(从 JATS 解析,这在双栏 PDF 上胜过 pymupdf——真正的章节边界、无页眉渗漏、无栏间交错)。只有在 Unpaywall 的副本耗尽后,才会查询 Europe PMC。
恢复绝不使抓取失败,也绝不降低质量。 一个候选必须通过两道门槛才会被接受:文本比你已经拥有的更多,且足够长以通过 oa_min_full_text_chars。第二道门槛正是防止某个仓库记录页——标题、作者、一段 200 字概要——仅凭比出版商摘要略长就冒充全文。若没有候选通过两道门槛,你就保留摘要,也不会出现 oa 块。救援只会把一次失败的抓取变成一篇笔记,绝不会反过来:当一个被阻断的来源没有开放获取副本时,该命令会像它一直以来的那样失败。
它做不到什么
- 它不替代你对哪些来源重要的判断。agent 负责挑选,你负责掌舵。
- 它无法抓取你尚未登录的付费墙后面的内容。开放获取恢复会在存在合法免费副本时找到它——即便出版商完全阻断抓取——但当不存在时,你得到的就只有摘要,或者什么都没有,而笔记会如实说明。
- 它通过 subagent 名册在 Anthropic 模型上运行(各 agent 的指派来自档位的模型映射)。用量随档位、齿轮和语料规模扩展。如果有人想把它移植到 Codex,欢迎提 PR!
- lint 关卡捕捉的是结构性失败(缺失脚手架、断裂溯源、未解决的 CRITICAL)。它无法保证事实准确性,那仍然是你的判断。
环境要求
- Python 3.11+
- Claude Code