production-agentic-rag-course

从零到一构建生产级RAG系统的实战教程,涵盖从基础设施搭建到Agentic RAG、Telegram Bot集成的完整流程。亮点在于遵循专业搜索先行的设计理念,逐步引入混合检索、本地LLM、监控缓存和LangGraph智能决策,适合想要深入掌握RAG工程实践的AI开发者。
README
AI之母项目
阶段1 RAG系统:arXiv论文策展人
以学习者为中心的生产级RAG系统实践之旅
从零开始构建现代AI系统,通过动手实践掌握核心技能
掌握最热门的AI工程技能:RAG(检索增强生成)


📖 关于本课程
这是一个 以学习者为中心的项目,您将构建一个完整的研究助手系统,能够自动获取学术论文、理解其内容,并利用高级 RAG 技术回答您的研究问题。
arXiv论文策展人 将教您使用 行业最佳实践构建生产级 RAG 系统。与那些直接跳到向量搜索的教程不同,我们遵循 专业路径:先掌握关键词搜索基础,再通过向量增强实现混合检索。
🎯 专业差异: 我们按照成功企业的方式构建 RAG 系统——基于可靠的搜索基础,用 AI 增强,而不是忽略搜索基础的 AI 优先方法。
完成本课程后,您将拥有自己的 AI 研究助手,以及为任何领域构建生产级 RAG 系统的深厚技术能力。
🎓 您将构建的内容
- 第 1 周: 完整基础设施:Docker、FastAPI、PostgreSQL、OpenSearch 和 Airflow
- 第 2 周: 自动化数据管道:从 arXiv 获取并解析学术论文
- 第 3 周: 生产级 BM25 关键词搜索(含过滤和相关性评分)
- 第 4 周: 智能分块 + 混合搜索(结合关键词与语义理解)
- 第 5 周: 完整 RAG 管道(本地 LLM、流式响应、Gradio 界面)
- 第 6 周: 生产级监控(Langfuse 追踪)和 Redis 缓存优化
- 第 7 周: Agentic RAG:LangGraph + 移动端 Telegram 机器人
🏗️ 系统架构演进
第 7 周:Agentic RAG 与 Telegram 机器人集成
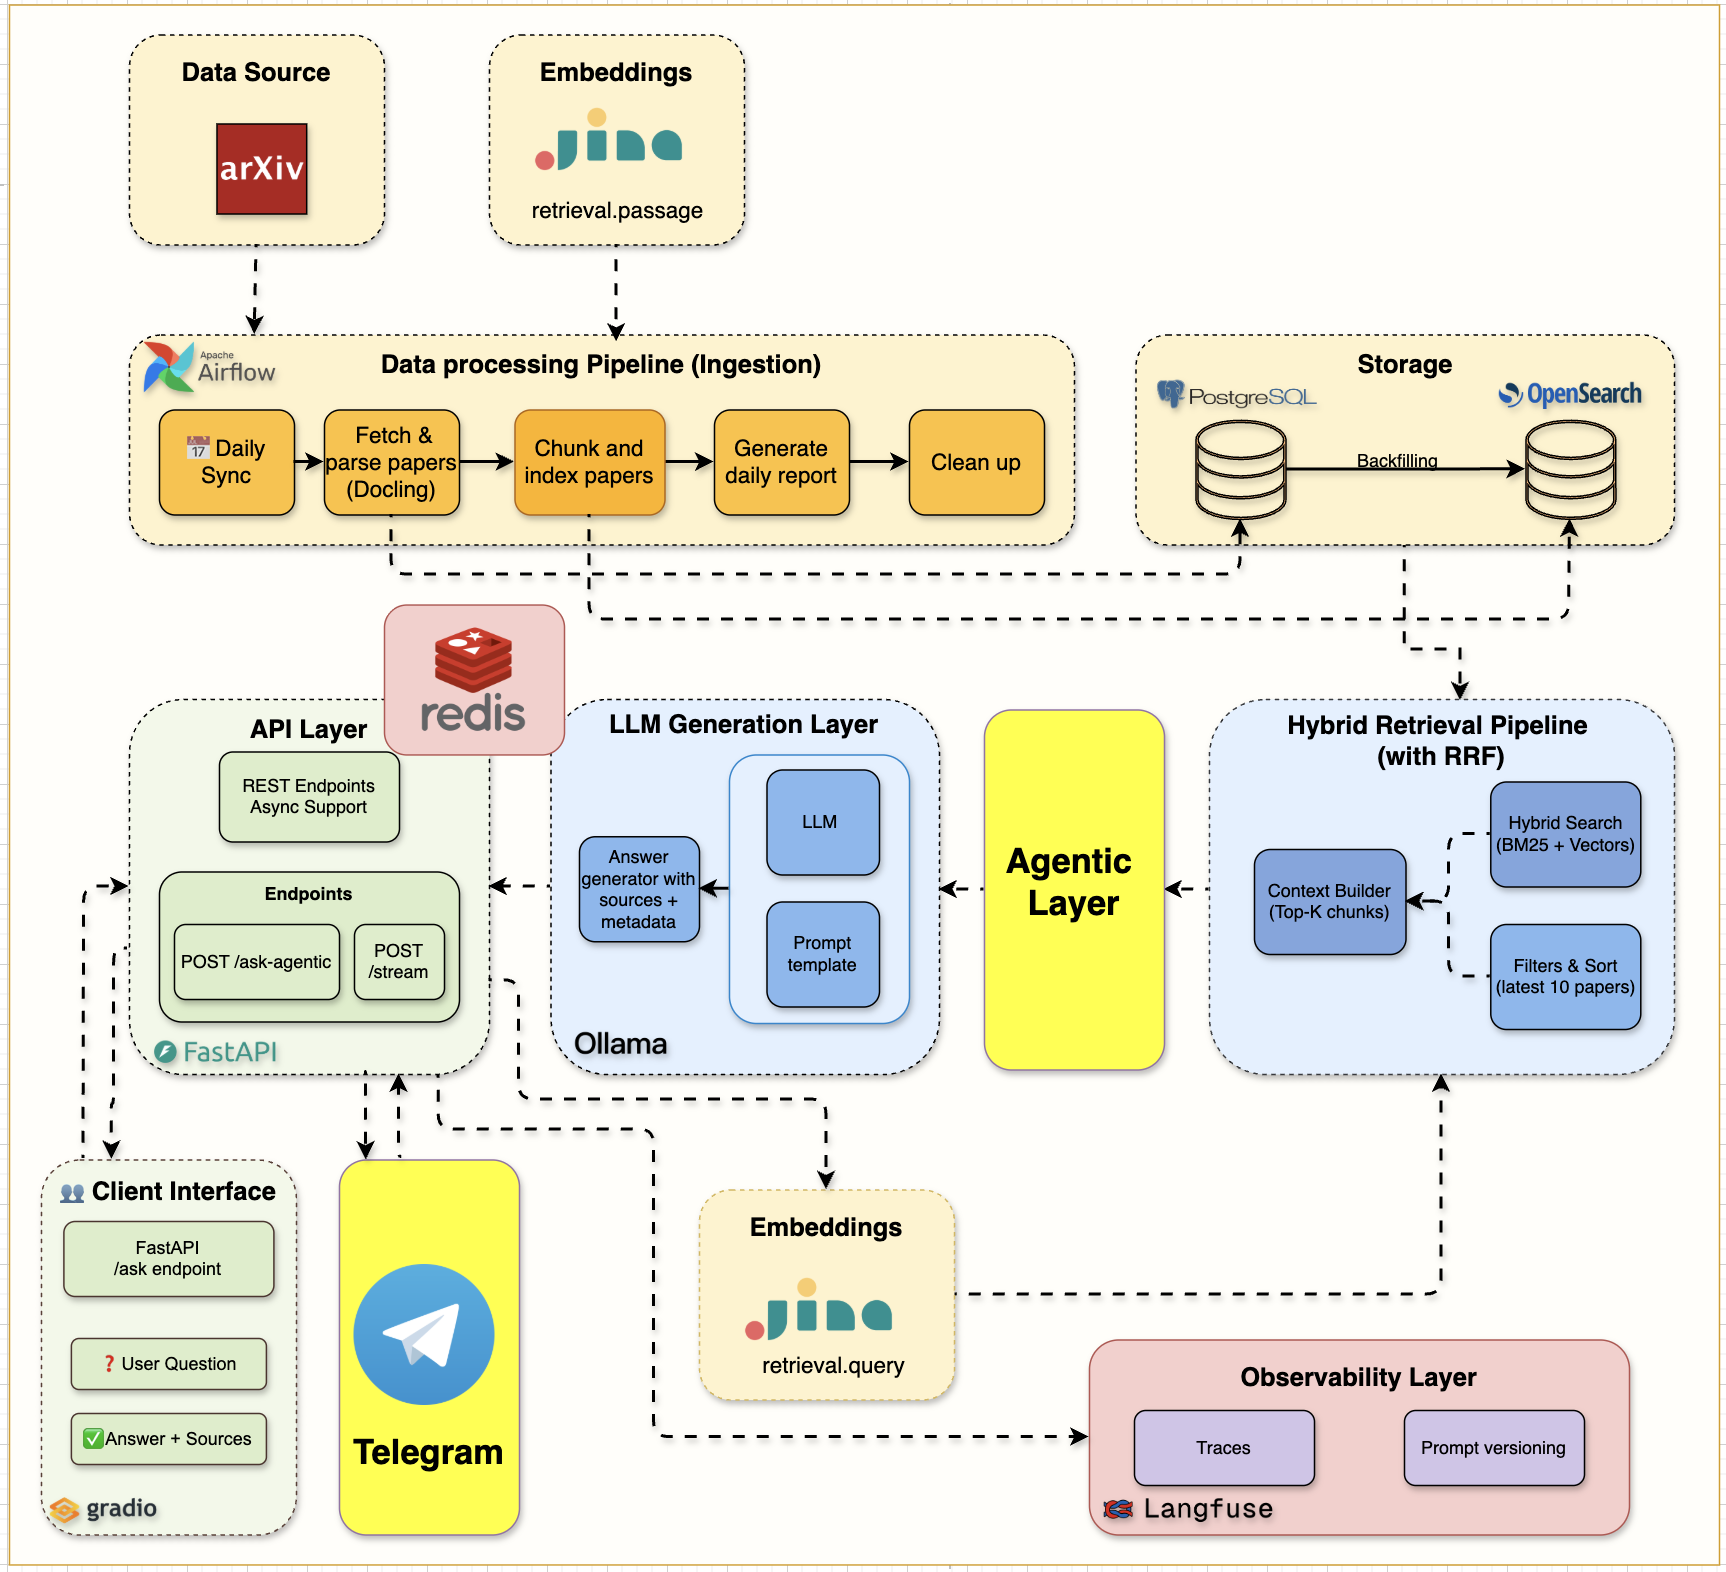
第 7 周完整架构:Telegram 机器人集成到 Agentic RAG 系统
LangGraph Agentic RAG 工作流
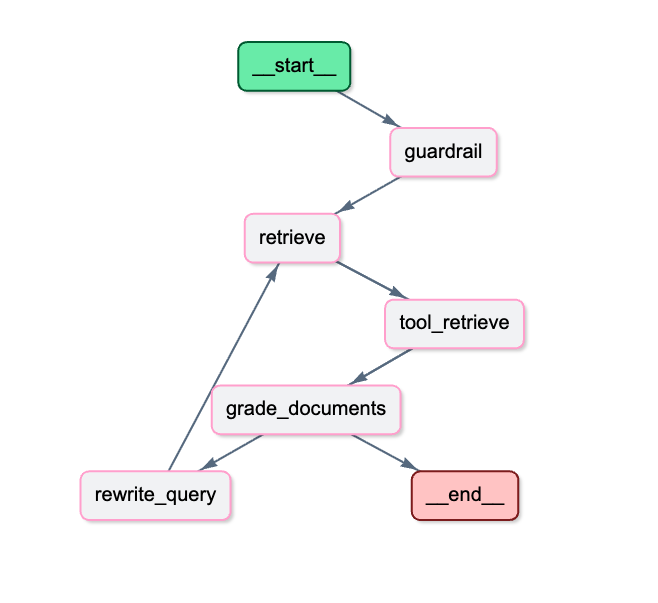
详细的 LangGraph 工作流:决策节点、文档评分和自适应检索
第 7 周代码讲解 + 博客: Agentic RAG with LangGraph and Telegram
第 7 周关键创新:
- 智能决策: 代理评估并自适应调整检索策略
- 文档评分: 基于语义评估的自动相关性判断
- 查询重写: 结果不足时自适应优化查询
- 护栏机制: 领域外检测,防止幻觉
- 移动访问: Telegram 机器人,随时随地对话式 AI
- 可解释性: 完整推理步骤追踪,便于调试和信任
🚀 快速开始
📋 前置要求
- Docker Desktop(含 Docker Compose)
- Python 3.12+
- UV 包管理器(安装指南)
- 至少 8GB 内存 和 20GB 可用磁盘空间
⚡ 开始搭建
# 1. 克隆并配置
git clone <repository-url>
cd arxiv-paper-curator

# 2. 配置环境变量(重要!)
cp .env.example .env
# .env 文件包含了 OpenSearch、arXiv API 和服务连接所需的所有配置。
# 默认配置可直接使用。
# 您需要添加 Jina embeddings 免费 API 密钥和 langfuse 密钥(详见博客)

# 3. 安装依赖
uv sync

# 4. 启动所有服务
docker compose up --build -d

# 5. 验证一切正常
curl http://localhost:8000/api/v1/health
📚 每周学习路径
| 周次 | 主题 | 博客文章 | 代码发布 |
|---|---|---|---|
| 第 0 周 | AI之母项目 - 6 个阶段 | AI之母项目 | - |
| 第 1 周 | 基础设施基础 | 支撑RAG系统的基础设施 | week1.0 |
| 第 2 周 | 数据摄取管道 | 为RAG构建数据摄取管道 | week2.0 |
| 第 3 周 | OpenSearch 摄取与 BM25 检索 | 每个RAG系统需要的搜索基础 | week3.0 |
| 第 4 周 | 分块与混合搜索 | 使混合搜索有效的分块策略 | week4.0 |
| 第 5 周 | 完整 RAG 系统 | 完整 RAG 系统 | week5.0 |
| 第 6 周 | 生产级监控与缓存 | 生产级 RAG:监控与缓存 | week6.0 |
| 第 7 周 | Agentic RAG 与 Telegram 机器人 | Agentic RAG with LangGraph and Telegram | week7.0 |
📥 克隆特定周的发布版本:
# 克隆特定周的代码
git clone --branch <WEEK_TAG> https://github.com/jamwithai/arxiv-paper-curator
cd arxiv-paper-curator
uv sync
docker compose down -v
docker compose up --build -d

# 将 <WEEK_TAG> 替换为:week1.0, week2.0 等
📊 访问您的服务
| 服务 | URL | 用途 |
|---|---|---|
| API 文档 | http://localhost:8000/docs | 交互式 API 测试 |
| Gradio RAG 界面 | http://localhost:7861 | 用户友好的聊天界面 |
| Langfuse 仪表盘 | http://localhost:3000 | RAG 管道监控与追踪 |
| Airflow 仪表盘 | http://localhost:8080 | 工作流管理 |
| OpenSearch Dashboards | http://localhost:5601 | 混合搜索引擎界面 |
注意:查看 airflow/simple_auth_manager_passwords.json.generated 获取 Airflow 用户名和密码
📚 第 1 周:基础设施基础 ✅
从这里开始! 掌握现代 RAG 系统的基础设施。
🎯 学习目标
- 使用 Docker Compose 完成基础设施搭建
- FastAPI 开发(自动文档与健康检查)
- PostgreSQL 数据库配置与管理
- OpenSearch 混合搜索引擎搭建
- Ollama 本地 LLM 服务配置
- 服务编排与健康监控
- 专业开发环境(代码质量工具)
🏗️ 架构概览
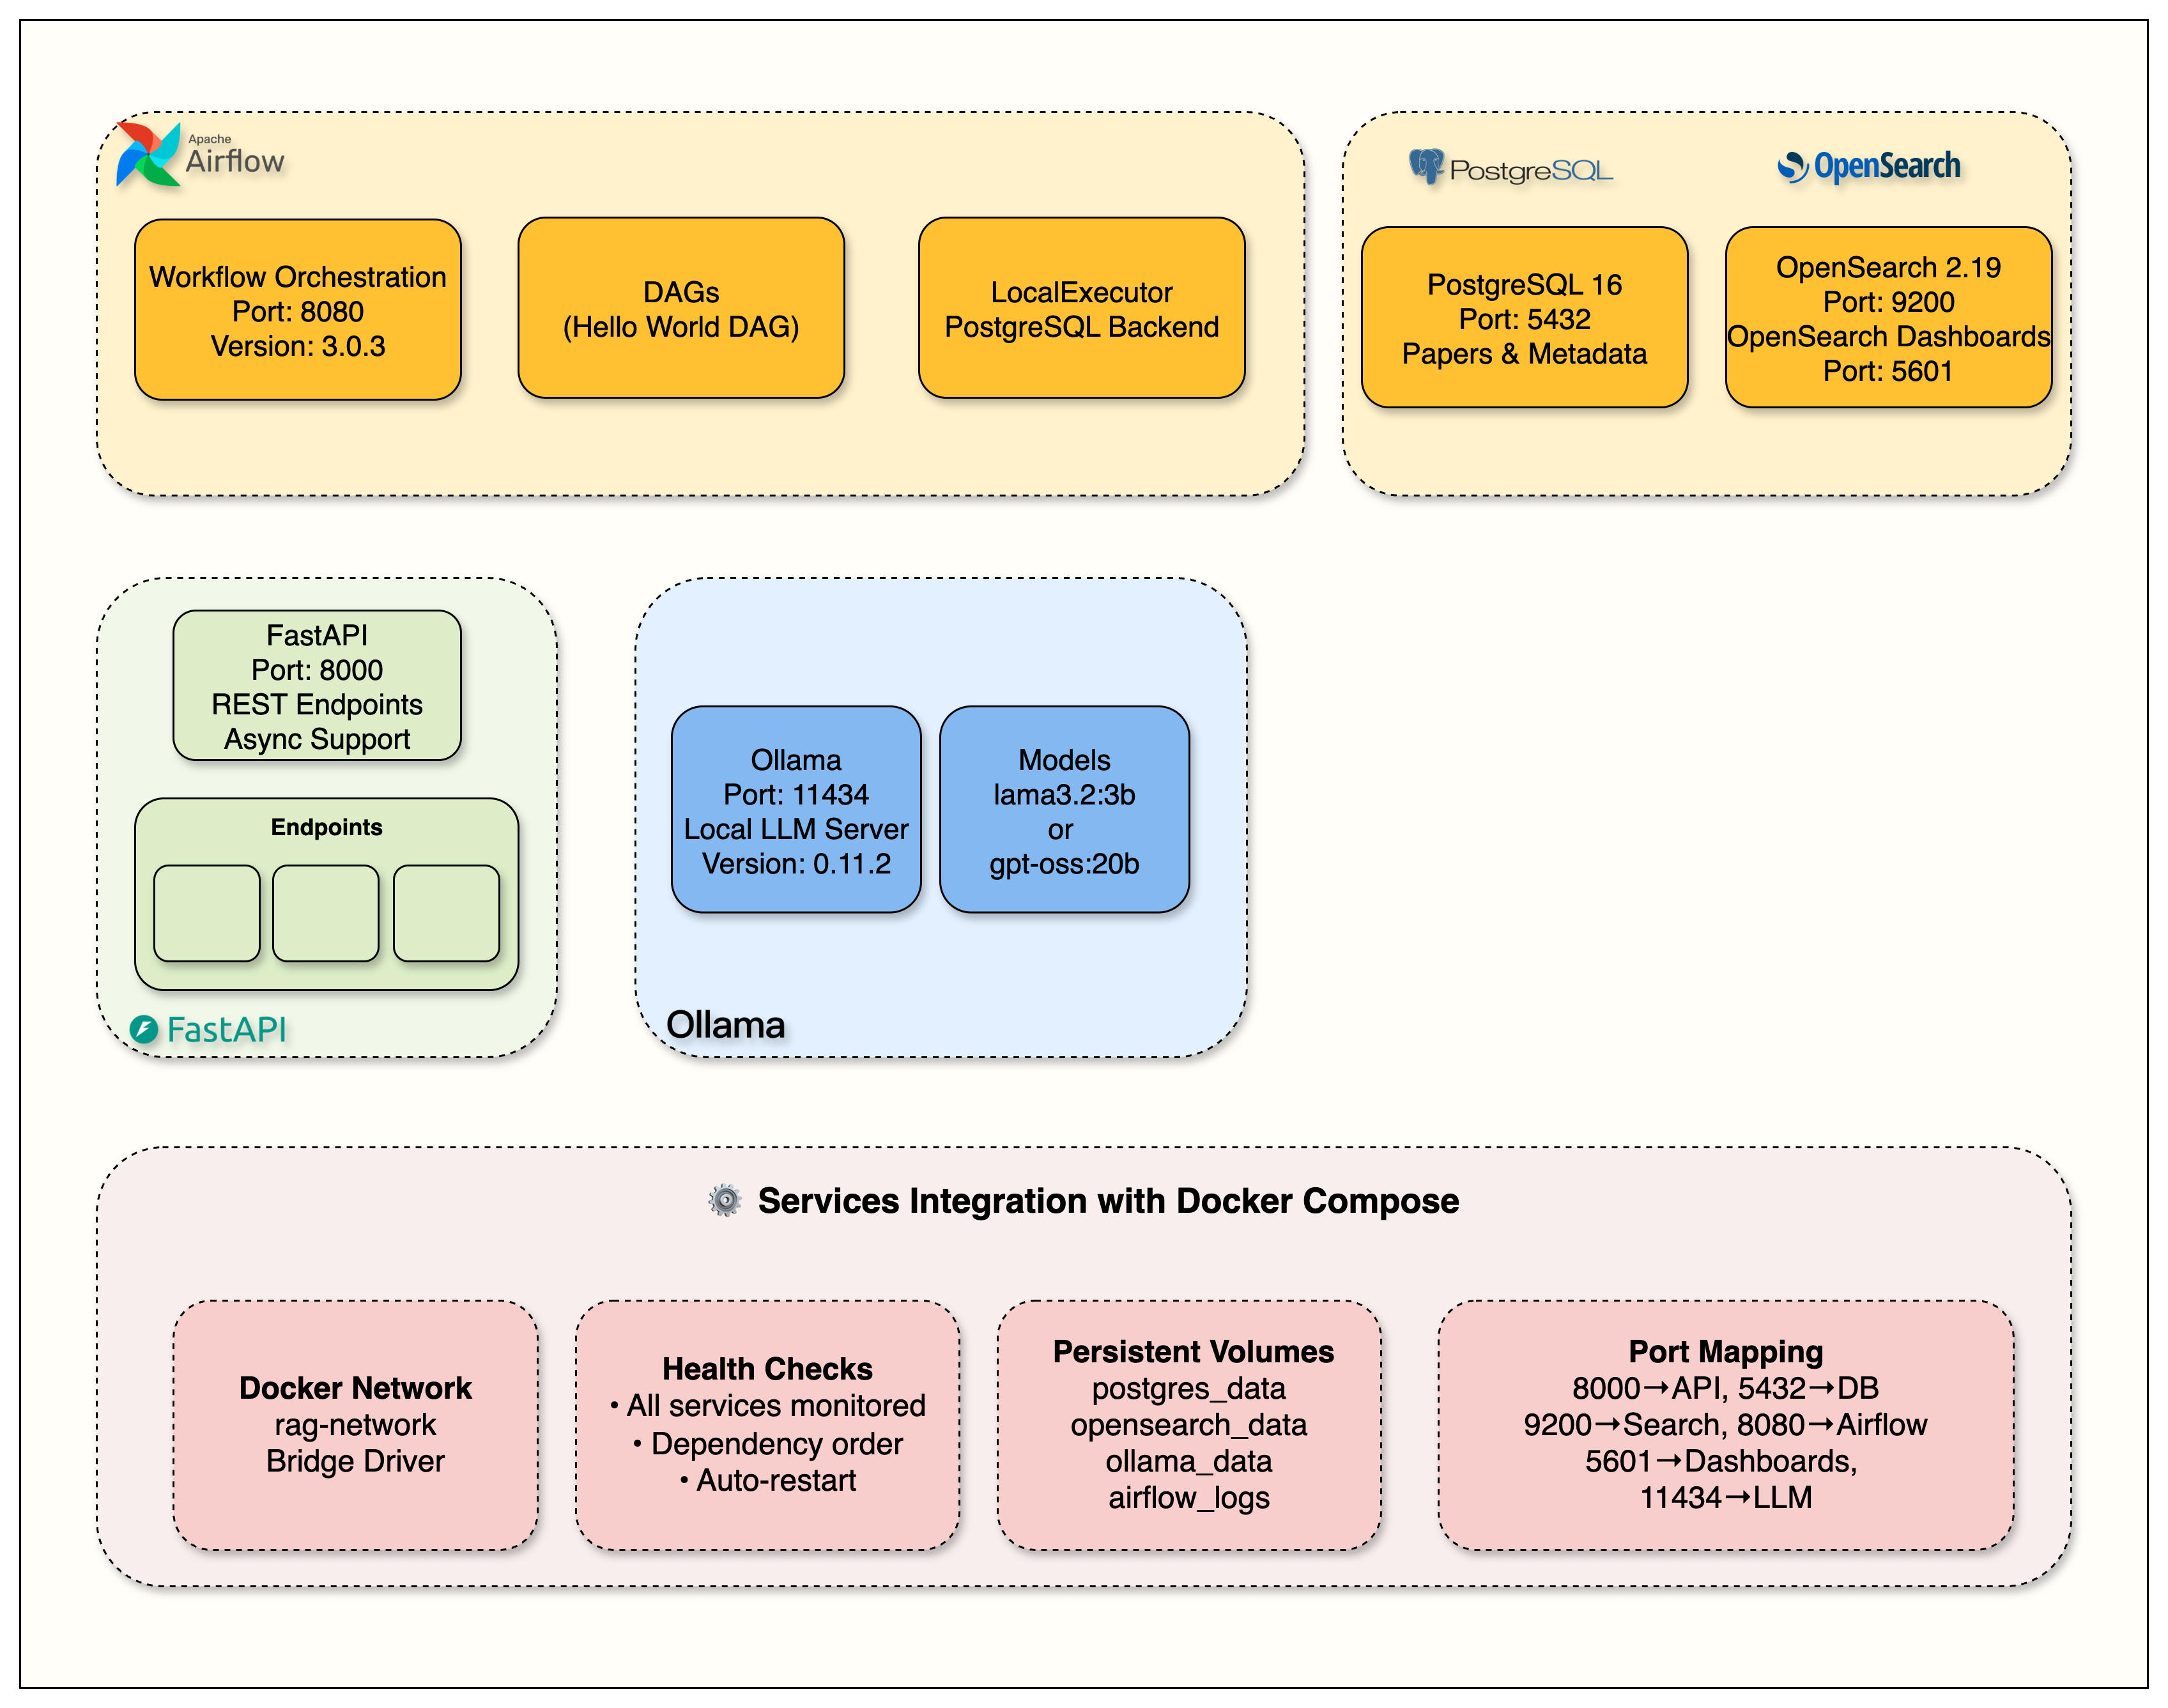
基础设施组件:
- FastAPI:带异步支持的 REST 端点(端口 8000)
- PostgreSQL 16:论文元数据存储(端口 5432)
- OpenSearch 2.19:带仪表盘的搜索引擎(端口 9200、5601)
- Apache Airflow 3.0:工作流编排(端口 8080)
- Ollama:本地 LLM 服务器(端口 11434)
📓 搭建指南
# 启动第 1 周笔记本
uv run jupyter notebook notebooks/week1/week1_setup.ipynb
完成指南: 按照第 1 周笔记本进行动手搭建和验证。
📖 深入阅读
博客文章: The Infrastructure That Powers RAG Systems - 详细讲解与生产洞察
📚 第 2 周:数据摄取管道 ✅
基于第 1 周基础设施: 学习自动获取、处理和存储学术论文。
🎯 学习目标
- arXiv API 集成(含速率限制与重试逻辑)
- 使用 Docling 解析科学 PDF
- 使用 Apache Airflow 构建自动化数据摄取管道
- 元数据提取与存储工作流
- 从 API 到数据库的完整论文处理
🏗️ 架构概览
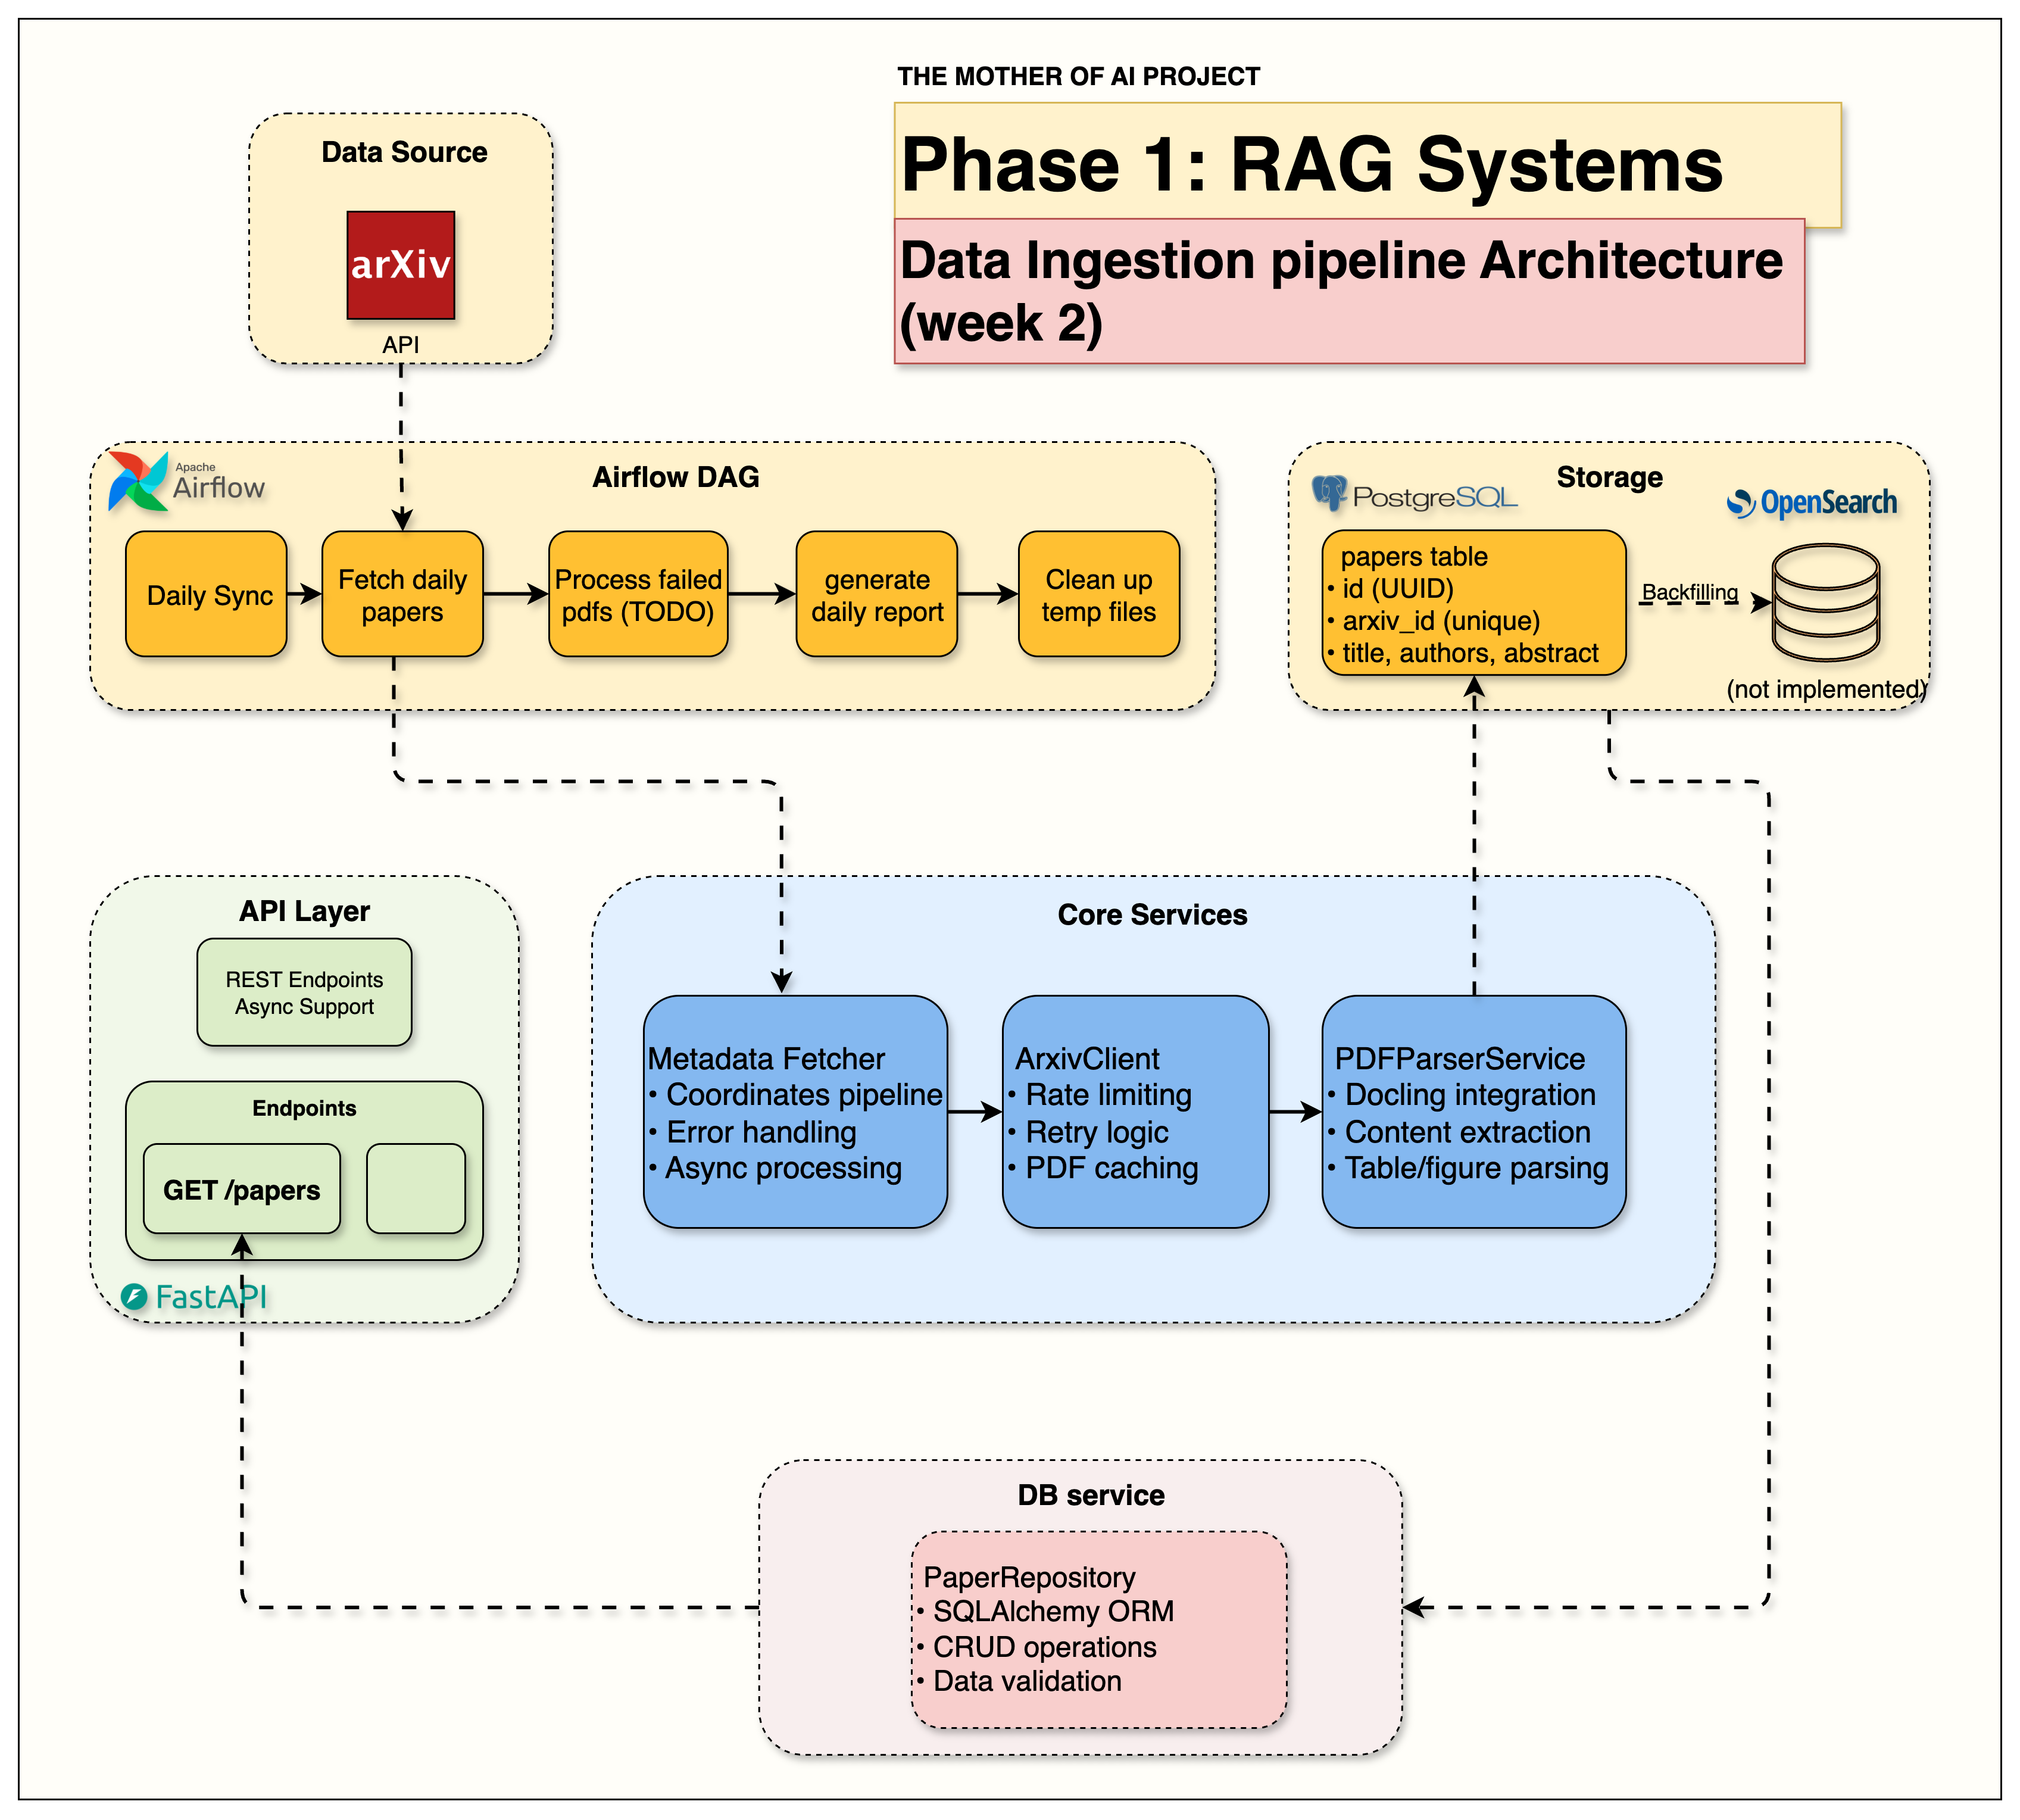
数据管道组件:
- MetadataFetcher:🎯 主编排器,协调整个管道
- ArxivClient:带速率限制和重试逻辑的论文获取
- PDFParserService:基于 Docling 的科学文档处理
- Airflow DAGs:自动化的每日论文摄取工作流
- PostgreSQL 存储:结构化的论文元数据和内容
📓 实现指南
# 启动第 2 周笔记本
uv run jupyter notebook notebooks/week2/week2_arxiv_integration.ipynb
完成指南: 按照第 2 周笔记本进行动手实现和验证。
📖 深入阅读
博客文章: Building Data Ingestion Pipelines for RAG - arXiv API 集成与 PDF 处理
📚 第 3 周:关键词搜索先行——关键基础
基于第 1-2 周基础: 实现专业 RAG 系统依赖的关键词搜索基础。
🎯 学习目标
- 为什么关键词搜索对 RAG 系统至关重要(基础先行方法)
- OpenSearch 索引管理、映射和搜索优化
- BM25 算法及有效关键词搜索背后的数学原理
- 使用 Query DSL 构建带过滤和提升的复杂搜索查询
- 用于衡量相关性和性能的搜索分析
- 真实公司使用的生产模式
🏗️ 架构概览
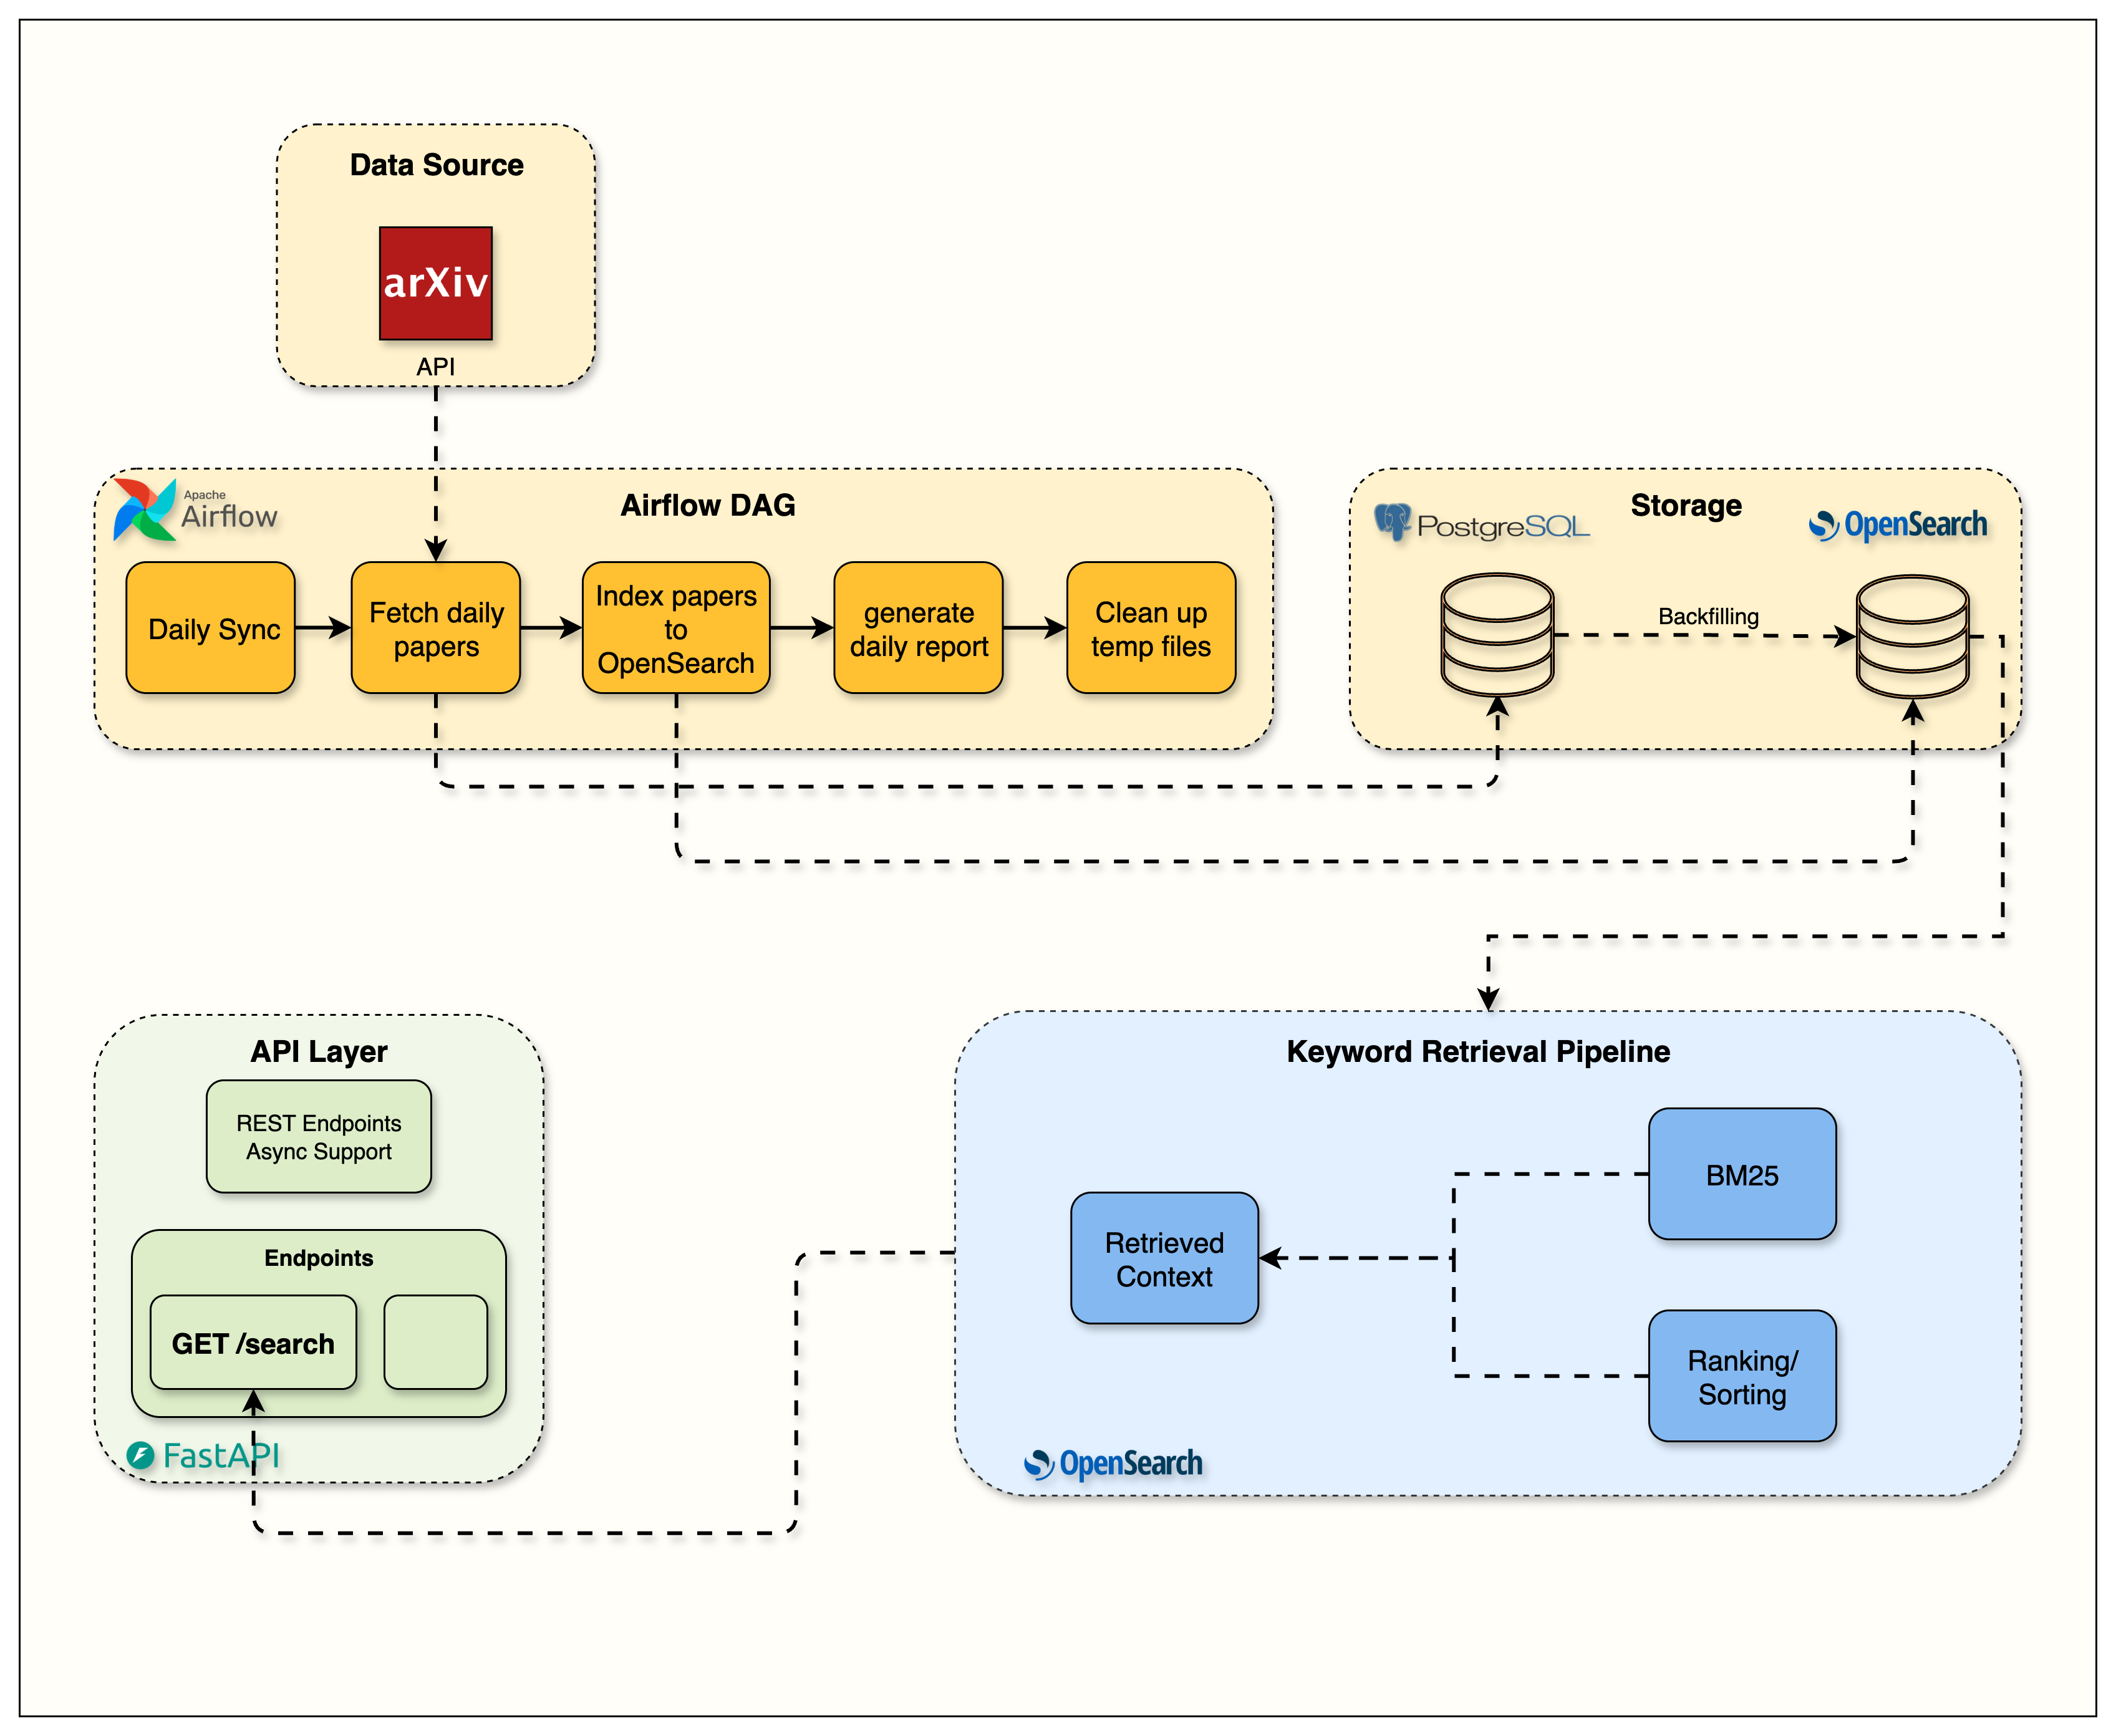
搜索基础设施组件:
- OpenSearch 服务:
src/services/opensearch/- 专业搜索服务实现 - 搜索 API:
src/routers/search.py- 带 BM25 评分的搜索 API 端点 - 学习材料:
notebooks/week3/- 完整的 OpenSearch 集成指南 - 质量指标:精确率、召回率和相关性评分
📓 搭建指南
# 启动第 3 周笔记本
uv run jupyter notebook notebooks/week3/week3_opensearch.ipynb
完成指南: 按照第 3 周笔记本进行 OpenSearch 动手搭建和 BM25 搜索实现。
📖 深入阅读
博客文章: The Search Foundation Every RAG System Needs - 使用 OpenSearch 完成 BM25 实现
📚 第 4 周:分块与混合搜索——语义层
基于第 3 周基础: 添加使搜索真正智能的语义层。
🎯 学习目标
- 基于章节的分块与智能文档分段
- 生产级嵌入:Jina AI 集成与回退策略
- 混合搜索精通:使用 RRF 融合进行关键词 + 语义检索
- 统一 API 设计:单个端点支持多种搜索模式
- 性能分析与不同搜索方法的权衡
🏗️ 架构概览
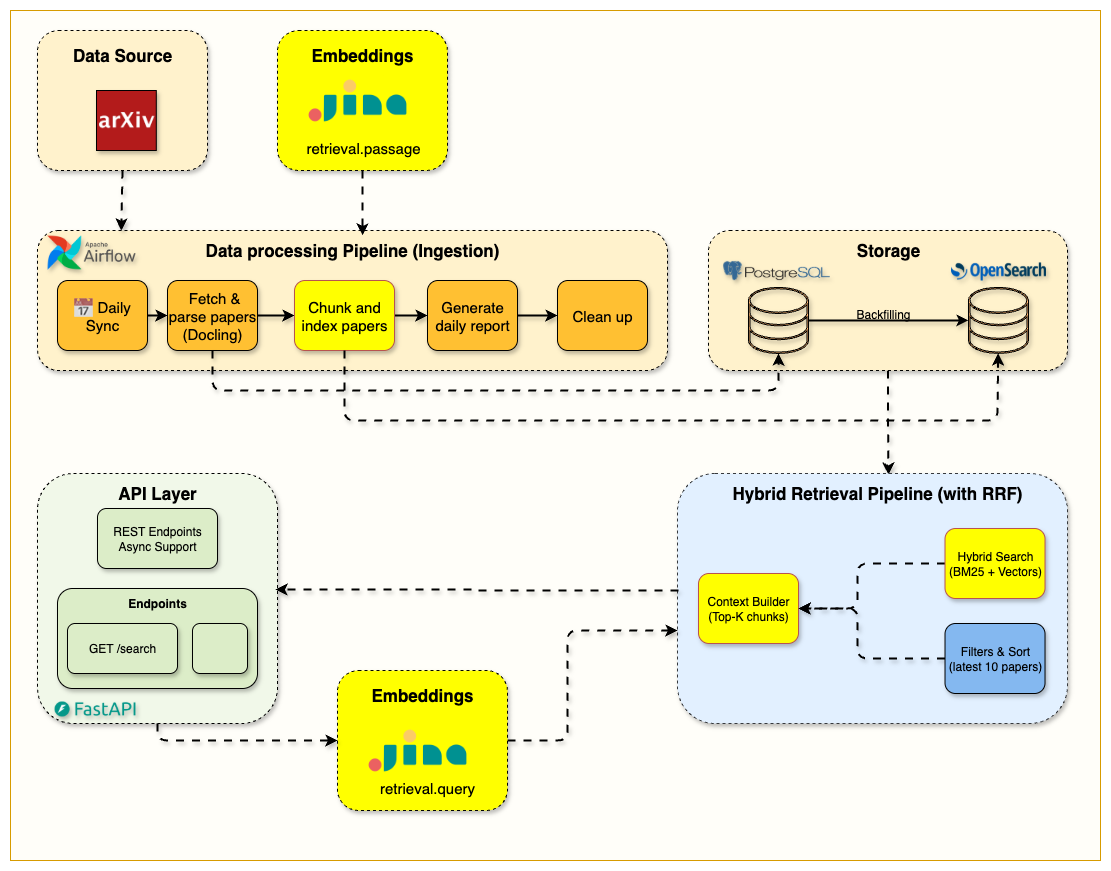
混合搜索基础设施组件:
- Text Chunker:
src/services/indexing/text_chunker.py- 支持重叠策略的章节感知分块 - Embeddings 服务:
src/services/embeddings/- 基于 Jina AI 的生产级嵌入管道 - 混合搜索 API:
src/routers/hybrid_search.py- 支持所有模式的统一搜索 API - 学习材料:
notebooks/week4/- 完整的混合搜索实现指南
📓 搭建指南
# 启动第 4 周笔记本
uv run jupyter notebook notebooks/week4/week4_hybrid_search.ipynb
完成指南: 按照第 4 周笔记本进行动手实现和验证。
📖 深入阅读
博客文章: The Chunking Strategy That Makes Hybrid Search Work - 生产级分块与 RRF 融合实现
📚 第 5 周:完整 RAG 管道与 LLM 集成
基于第 4 周混合搜索: 添加 LLM 层,将搜索转变为智能对话。
🎯 学习目标
- 本地 LLM 集成(Ollama)确保完全数据隐私
- 性能优化:提示词缩减 80%(速度提升 6 倍)
- 使用 Server-Sent Events 实现流式响应
- 双 API 设计:标准端点和流式端点
- 交互式 Gradio 界面(高级参数控制)
🏗️ 架构概览
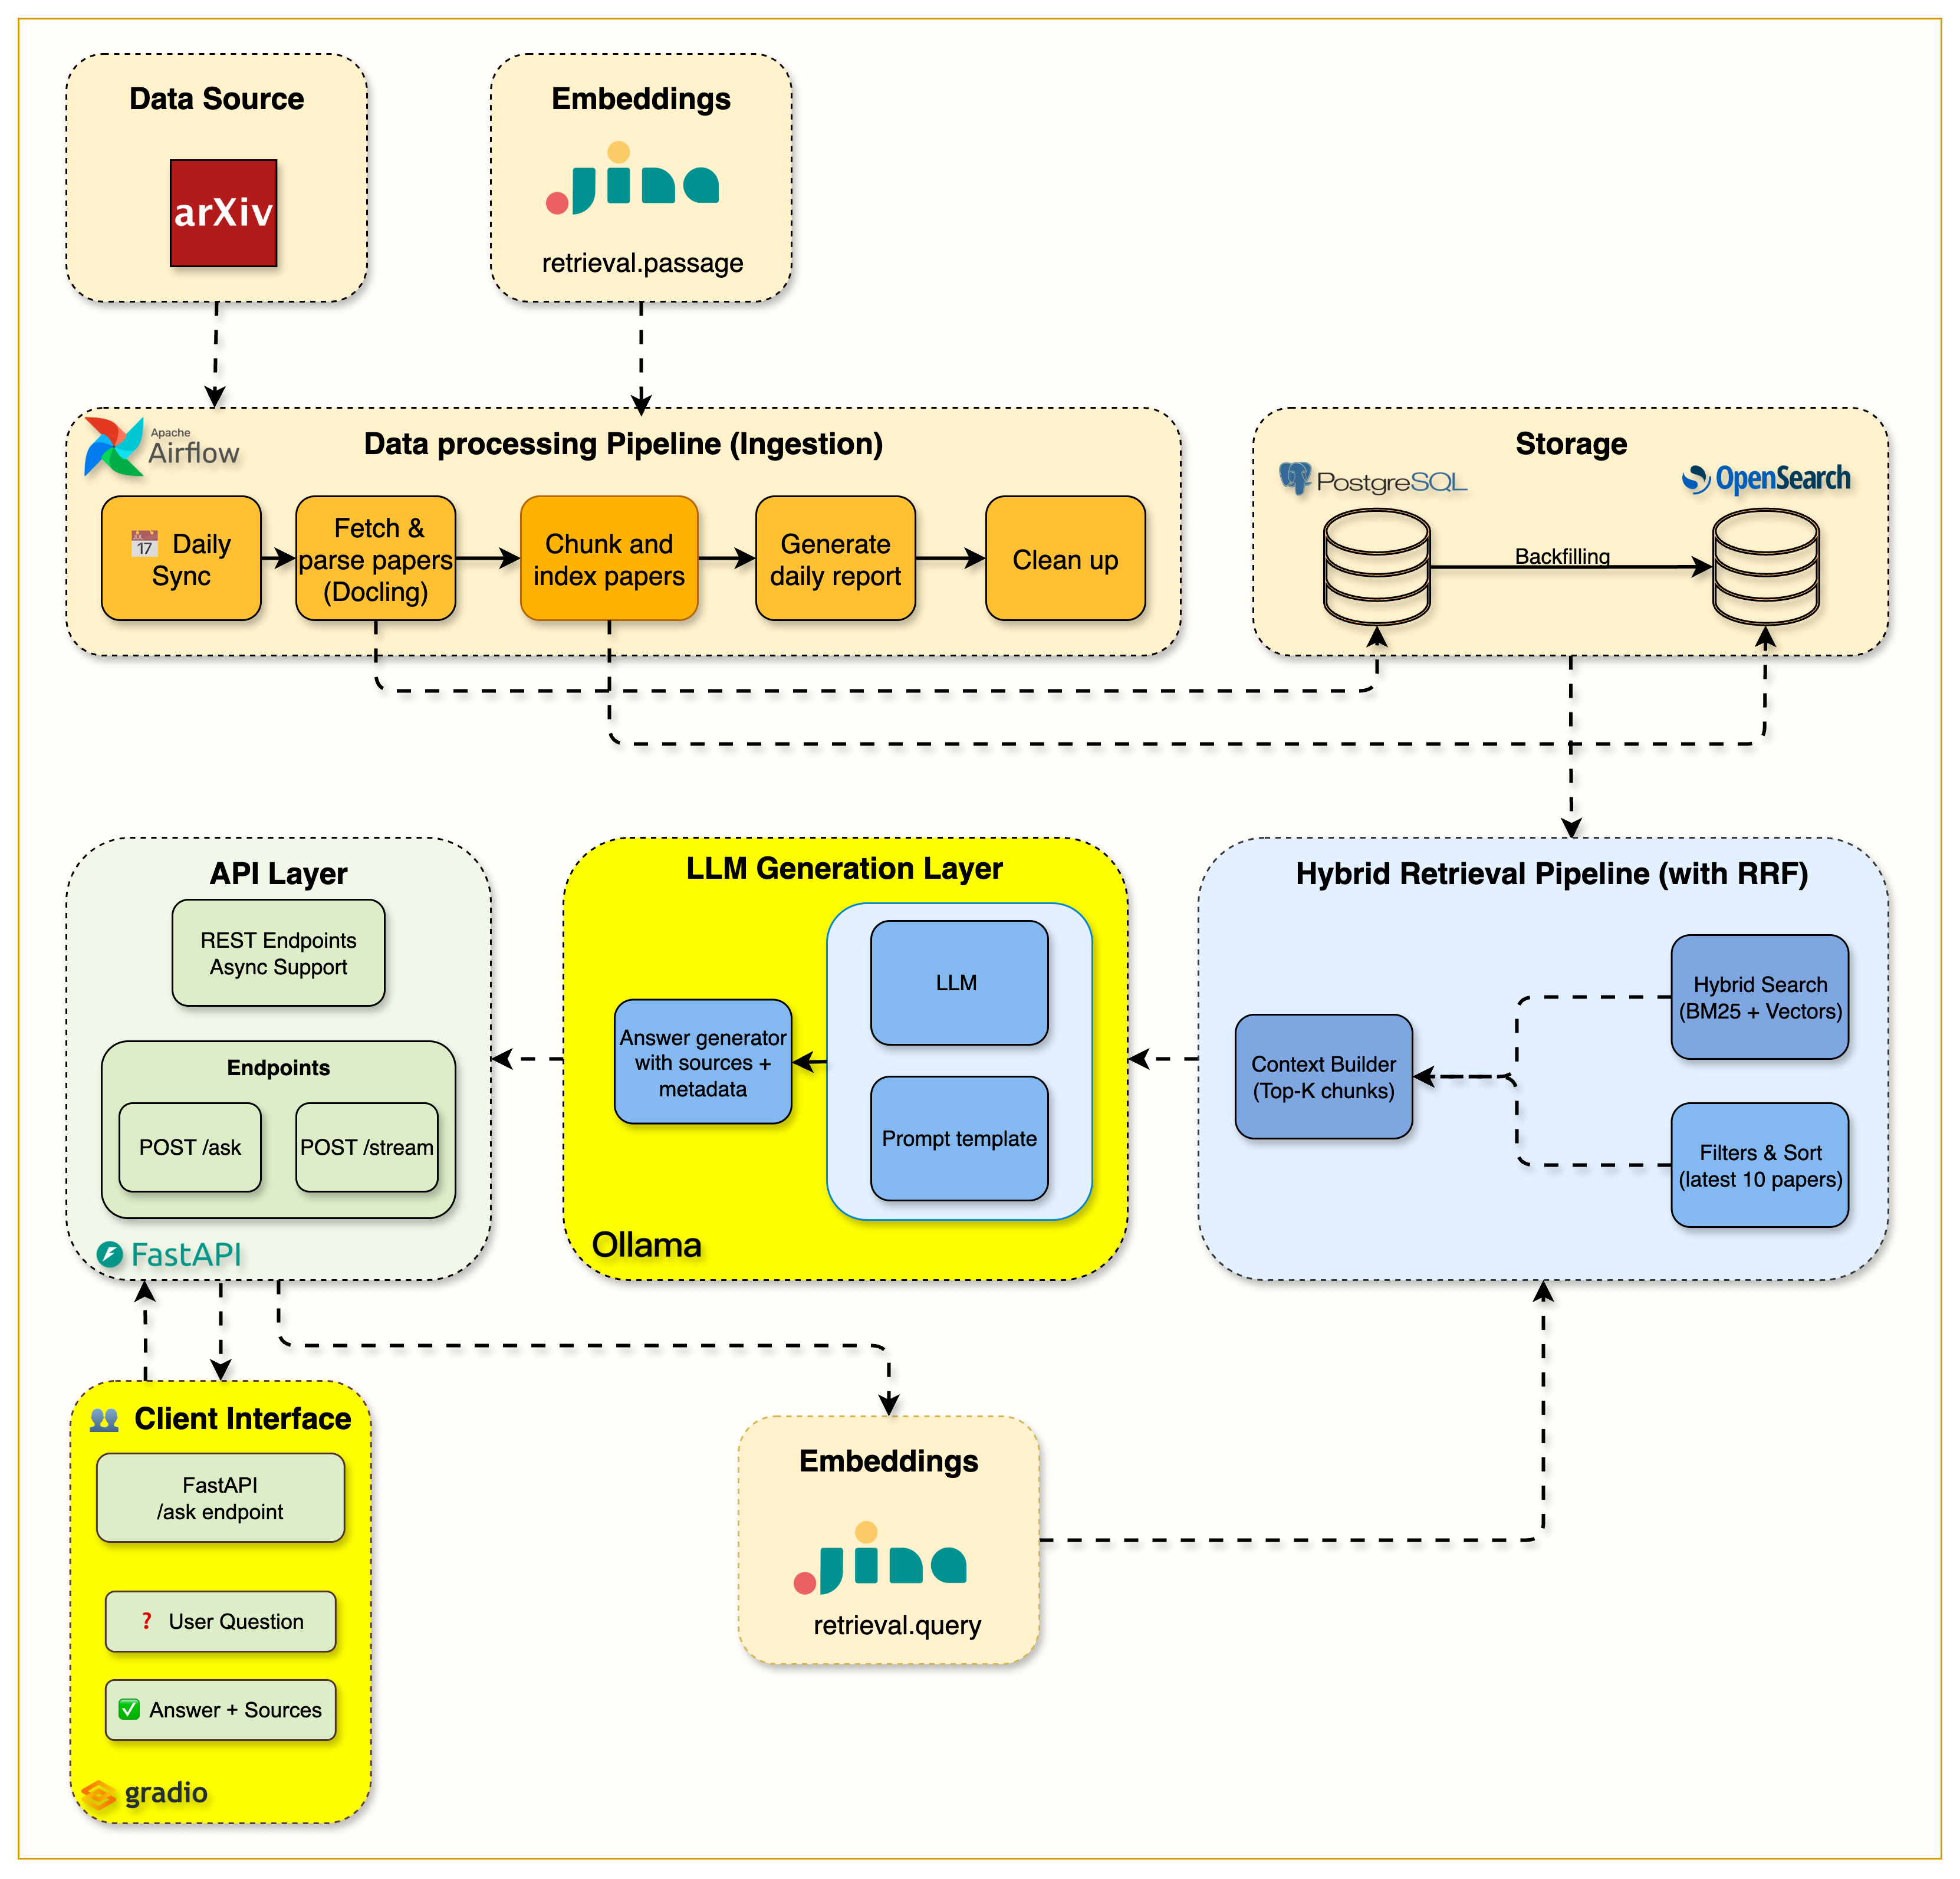
完整 RAG 基础设施组件:
- RAG 端点:
src/routers/ask.py- 双端点(/api/v1/ask+/api/v1/stream) - Ollama 服务:
src/services/ollama/- 带优化提示词的 LLM 客户端 - 系统提示词:
src/services/ollama/prompts/rag_system.txt- 针对学术论文优化 - Gradio 界面:
src/gradio_app.py- 支持流式响应的交互式 Web 界面 - 启动脚本:
gradio_launcher.py- 一键启动脚本(运行在端口 7861)
📓 搭建指南
# 启动第 5 周笔记本
uv run jupyter notebook notebooks/week5/week5_complete_rag_system.ipynb

# 启动 Gradio 界面
uv run python gradio_launcher.py
# 打开 http://localhost:7861
完成指南: 按照第 5 周笔记本进行 LLM 集成和 RAG 管道实现。
📖 深入阅读
博客文章: The Complete RAG System - 完整 RAG 系统(本地 LLM 集成与优化技术)
📚 第 6 周:生产级监控与缓存
基于第 5 周完整 RAG 系统: 添加可观测性、性能优化和生产级监控。
🎯 学习目标
- Langfuse 集成:端到端 RAG 管道追踪
- Redis 缓存策略:智能缓存键与 TTL 管理
- 性能监控:实时仪表盘(延迟和成本)
- 可观测性与优化的生产模式
- 成本分析与 LLM 使用优化(缓存实现 150-400 倍加速)
🏗️ 架构概览
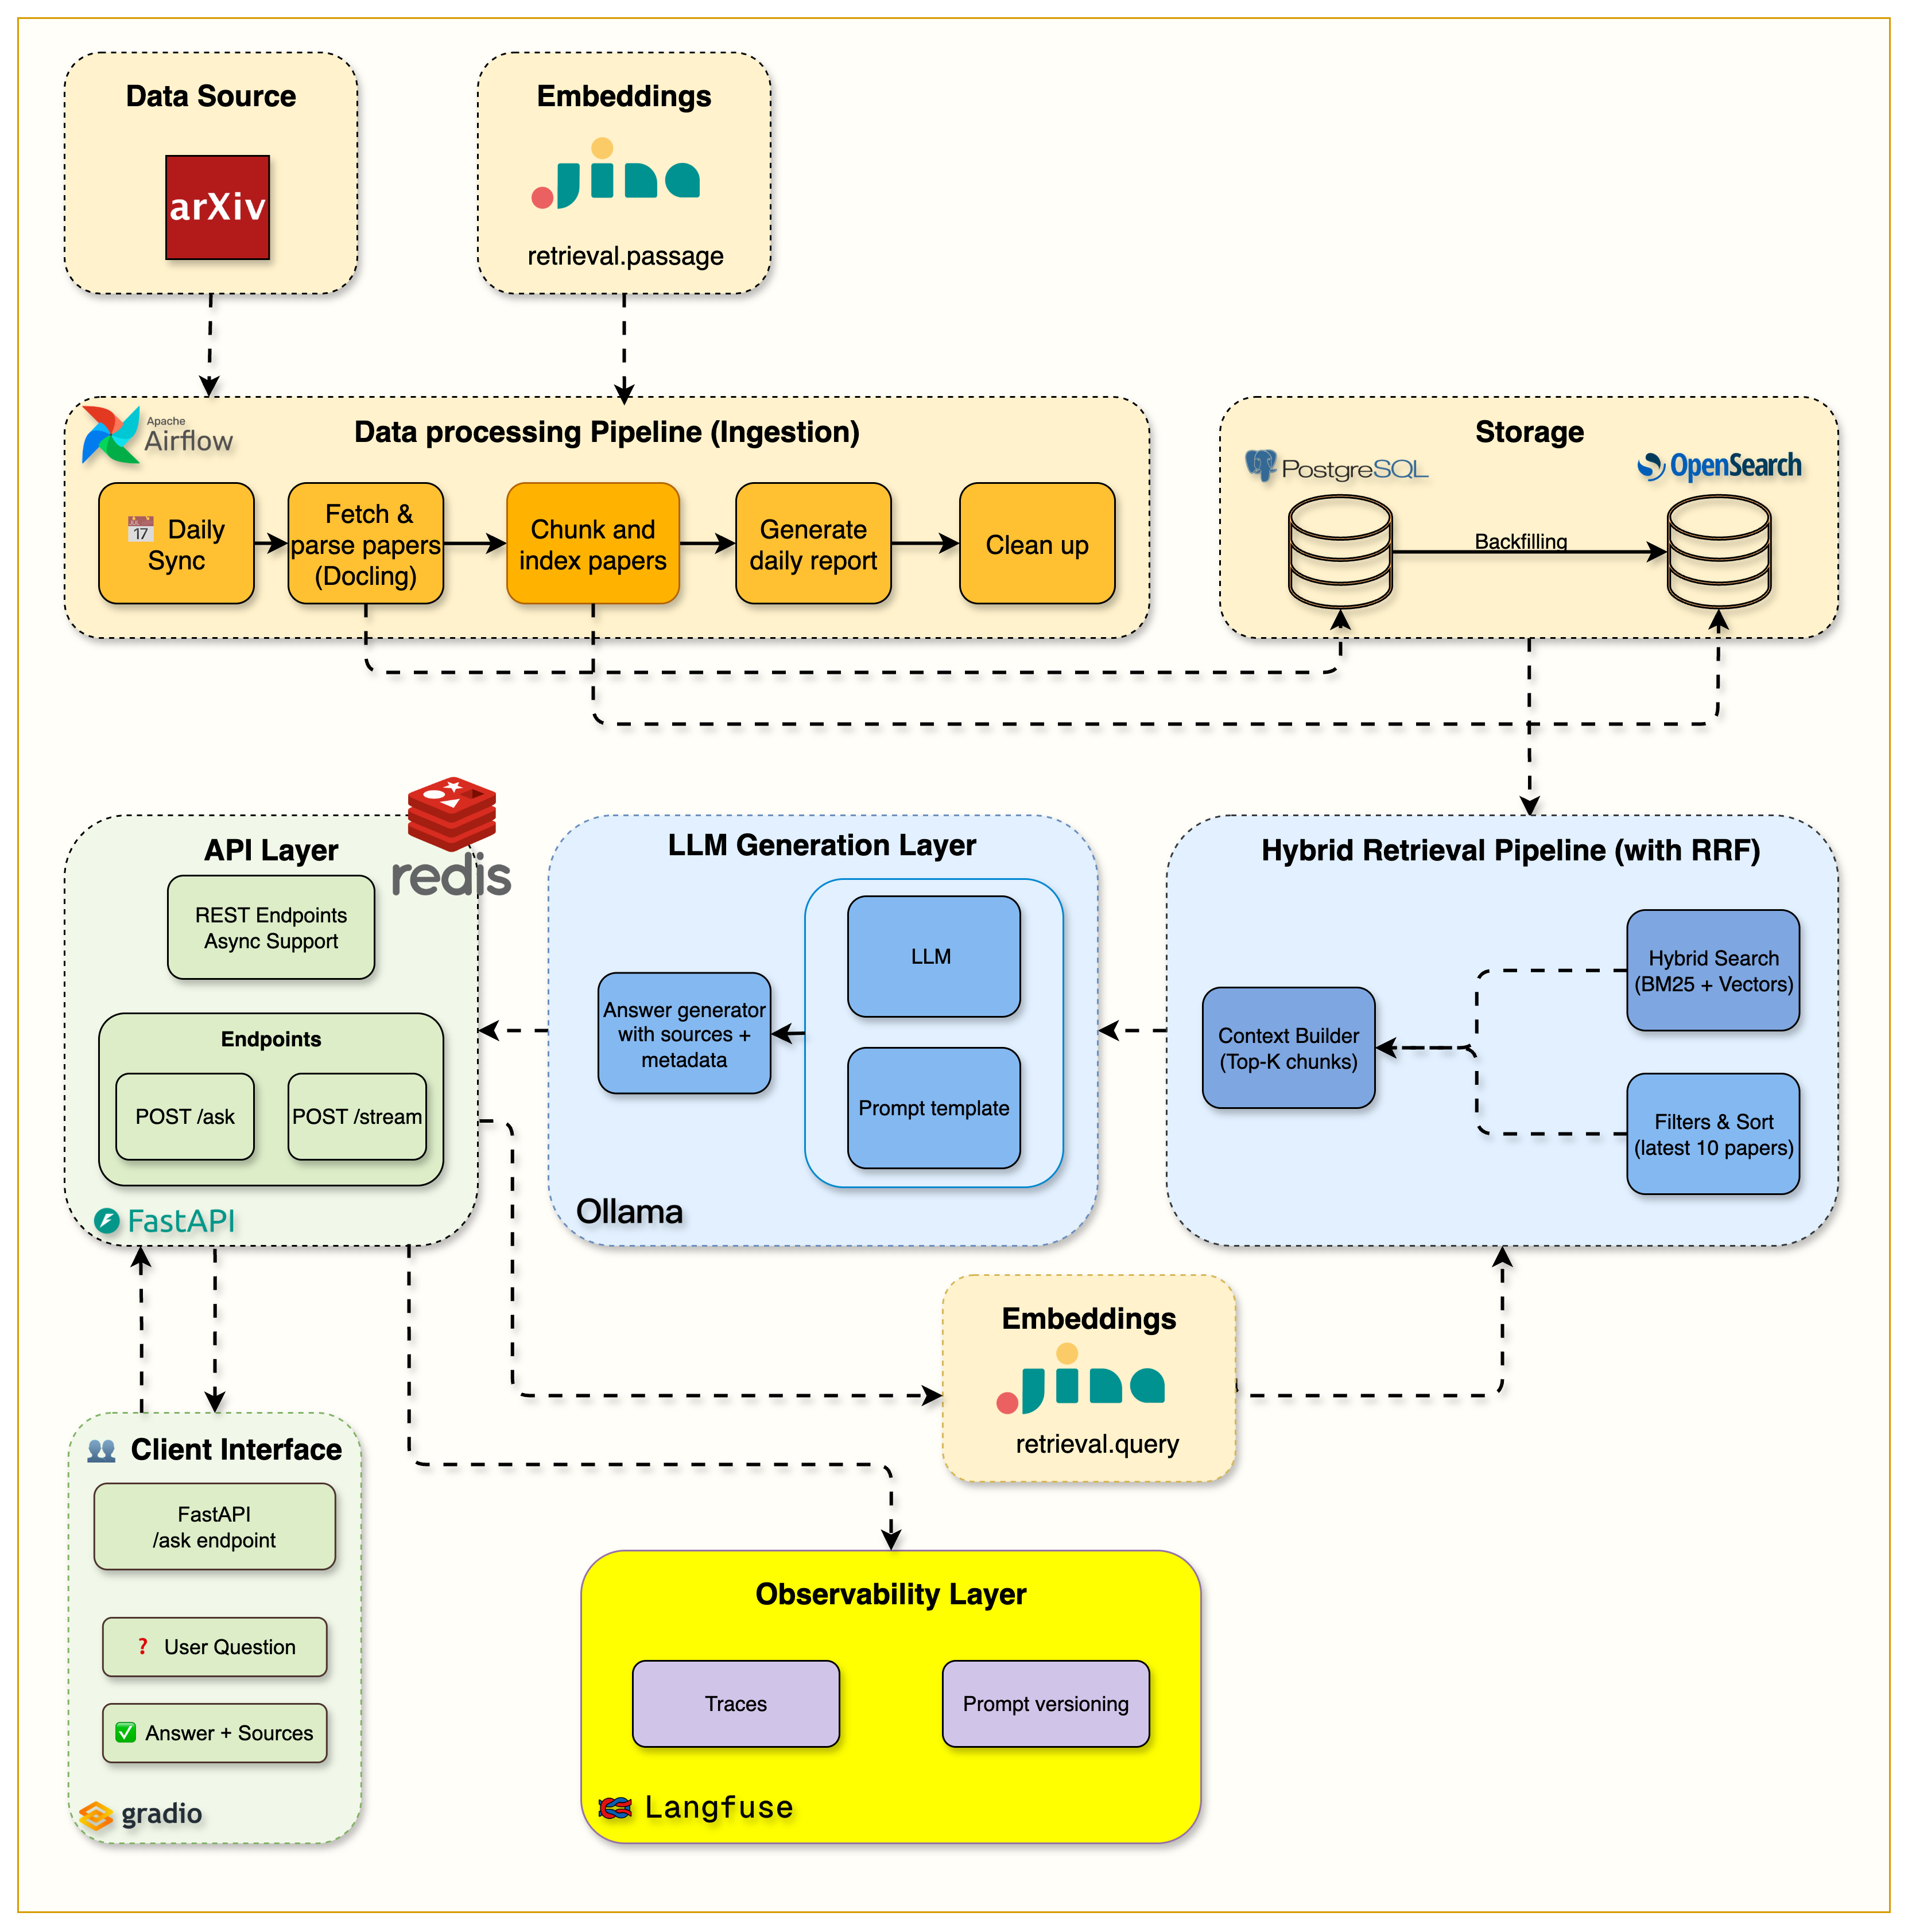
生产基础设施组件:
- Langfuse 服务:
src/services/langfuse/- 完整的追踪集成(含 RAG 特定指标) - 缓存服务:
src/services/cache/- Redis 客户端(精确匹配缓存与优雅回退) - 更新后的端点:
src/routers/ask.py- 集成追踪和缓存中间件 - Docker 配置:
docker-compose.yml- 新增 Redis 服务和 Langfuse 本地实例 - 学习材料:
notebooks/week6/- 完整的监控与缓存实现指南
📓 搭建指南
# 启动第 6 周笔记本
uv run jupyter notebook notebooks/week6/week6_cache_testing.ipynb
完成指南: 按照第 6 周笔记本进行 Langfuse 追踪和 Redis 缓存实现。
📖 深入阅读
博客文章: Production-ready RAG: Monitoring & Caching - 生产级 RAG:监控与缓存
📚 第 7 周:Agentic RAG with LangGraph and Telegram 机器人
基于第 6 周生产系统: 添加智能推理、多步决策和 Telegram 机器人集成,实现移动优先的 AI 交互。
🎯 学习目标
- LangGraph 工作流:基于状态的代理编排(含决策节点)
- 护栏实现:查询验证与领域边界检测
- 文档评分:基于语义评估的相关性判断
- 查询重写:自动查询优化,改善检索效果
- 自适应检索:多次尝试检索与智能回退
- Telegram 机器人集成:异步操作与错误处理
- 推理透明度:暴露代理决策过程
🏗️ 架构概览
Agentic RAG 基础设施组件:
- 代理节点:
src/services/agents/nodes/- 护栏、检索、评分、重写和生成节点 - 工作流编排:
src/services/agents/agentic_rag.py- LangGraph 工作流协调 - Telegram 机器人:
src/services/telegram/- 命令处理与消息处理 - Agentic 端点:
src/routers/agentic_ask.py- Agentic RAG API 端点 - 学习材料:
notebooks/week7/- 第 7 周学习材料与示例
📓 搭建指南
# 启动第 7 周笔记本
uv run jupyter notebook notebooks/week7/week7_agentic_rag.ipynb
完成指南: 按照第 7 周笔记本进行 LangGraph Agentic RAG 和 Telegram 机器人的动手实现。
📖 深入阅读
博客文章: Agentic RAG with LangGraph and Telegram - 构建具有决策能力、自适应检索和移动访问的智能代理
⚙️ 配置
设置:
cp .env.example .env
# 根据您的环境编辑 .env
关键变量:
JINA_API_KEY- 第 4 周起需要(使用嵌入的混合搜索)TELEGRAM__BOT_TOKEN- 第 7 周需要(Telegram 机器人集成)LANGFUSE__PUBLIC_KEY和LANGFUSE__SECRET_KEY- 第 6 周可选(监控)
完整配置: 参见 .env.example 查看所有可用选项和详细文档。
🔧 参考与开发指南
🛠️ 技术栈
| 服务 | 用途 | 状态 |
|---|---|---|
| FastAPI | 带自动文档的 REST API | ✅ 就绪 |
| PostgreSQL 16 | 论文元数据和内容存储 | ✅ 就绪 |
| OpenSearch 2.19 | 混合搜索引擎(BM25 + 向量) | ✅ 就绪 |
| Apache Airflow 3.0 | 工作流自动化 | ✅ 就绪 |
| Jina AI | 嵌入生成(第 4 周) | ✅ 就绪 |
| Ollama | 本地 LLM 服务(第 5 周) | ✅ 就绪 |
| Redis | 高性能缓存(第 6 周) | ✅ 就绪 |
| Langfuse | RAG 管道可观测性(第 6 周) | ✅ 就绪 |
开发工具: UV、Ruff、MyPy、Pytest、Docker Compose
🏗️ 项目结构
arxiv-paper-curator/
├── src/                    # 主应用代码
│   ├── routers/            # API 端点(search、ask、papers)
│   ├── services/           # 业务逻辑(opensearch、ollama、agents、cache)
│   ├── models/             # 数据库模型(SQLAlchemy)
│   ├── schemas/            # Pydantic 验证模式
│   └── config.py           # 环境配置
├── notebooks/              # 每周学习材料(第 1-7 周)
├── airflow/                # 工作流编排(DAGs)
├── tests/                  # 测试套件
└── compose.yml             # Docker 服务编排
📡 API 端点参考
| 端点 | 方法 | 描述 | 周次 |
|---|---|---|---|
/health |
GET | 服务健康检查 | 第 1 周 |
/api/v1/papers |
GET | 列出已存储论文 | 第 2 周 |
/api/v1/papers/{id} |
GET | 获取特定论文 | 第 2 周 |
/api/v1/search |
POST | BM25 关键词搜索 | 第 3 周 |
/api/v1/hybrid-search/ |
POST | 混合搜索(BM25 + 向量) | 第 4 周 |
API 文档: 访问 http://localhost:8000/docs 查看交互式 API 探索器
🔧 常用命令
使用 Makefile(推荐)
# 查看所有可用命令
make help

# 快速工作流
make start         # 启动所有服务
make health        # 检查所有服务健康状态
make test          # 运行测试
make stop          # 停止服务
所有可用命令
| 命令 | 描述 |
|---|---|
make start |
启动所有服务 |
make stop |
停止所有服务 |
make restart |
重启所有服务 |
make status |
显示服务状态 |
make logs |
显示服务日志 |
make health |
检查所有服务健康状态 |
make setup |
安装 Python 依赖 |
make format |
格式化代码 |
make lint |
代码检查与类型检查 |
make test |
运行测试 |
make test-cov |
运行测试并生成覆盖率 |
make clean |
清理所有内容 |
直接命令(备选)
# 如果您更喜欢直接使用命令
docker compose up --build -d    # 启动服务
docker compose ps               # 检查状态
docker compose logs            # 查看日志
uv run pytest                 # 运行测试
🎓 目标受众
| 人群 | 原因 |
|---|---|
| AI/ML 工程师 | 学习超越教程的生产级 RAG 架构 |
| 软件工程师 | 使用最佳实践构建端到端 AI 应用 |
| 数据科学家 | 使用现代工具实现生产级 AI 系统 |
🛠️ 故障排除
常见问题:
- 服务无法启动? 等待 2-3 分钟,检查
docker compose logs - 端口冲突? 停止使用端口 8000、8080、5432、9200 的其他服务
- 内存问题? 增加 Docker Desktop 内存分配
获取帮助:
- 查看第 1 周笔记本中的详细故障排除章节
- 查看服务日志:
docker compose logs [服务名称] - 完全重置:
docker compose down --volumes && docker compose up --build -d
💰 成本结构
本课程完全免费! 您只需要为可选服务支付极少量费用:
- 本地开发: 0 美元(所有内容在本地运行)
- 可选的云 API: ~2-5 美元用于外部 LLM 服务(如果选择使用)
🎉 准备好开始你的 AI 工程之旅了吗?
从第 1 周的搭建笔记本开始,构建你的第一个生产级 RAG 系统!
献给想要掌握现代 AI 工程的学习者
由 Shirin Khosravi Jam 和 Shantanu Ladhwe 倾情打造
Star 历史
[![Star History Chart](https://raw.githubusercontent.com/jamwithai/production-agentic-rag-course/main/