voicebox

本地优先的AI语音工作室,集成语音克隆、合成、听写等功能,支持7种TTS引擎、Whisper语音识别和MCP agent语音调用。亮点是完全本地运行保障隐私,同时覆盖语音输入输出全链路,提供REST API和MCP接口方便开发者集成。今日新增140星,热度持续上升。MIT开源许可。
README
Voicebox
开源 AI 语音工作室。
克隆任何声音。生成语音。在任何应用中听写。用属于你的声音与 AI 智能体对话。
完整的语音 I/O 栈,在你的机器上本地运行。


voicebox.sh • 文档 • 下载 • 功能 • API • 故障排除
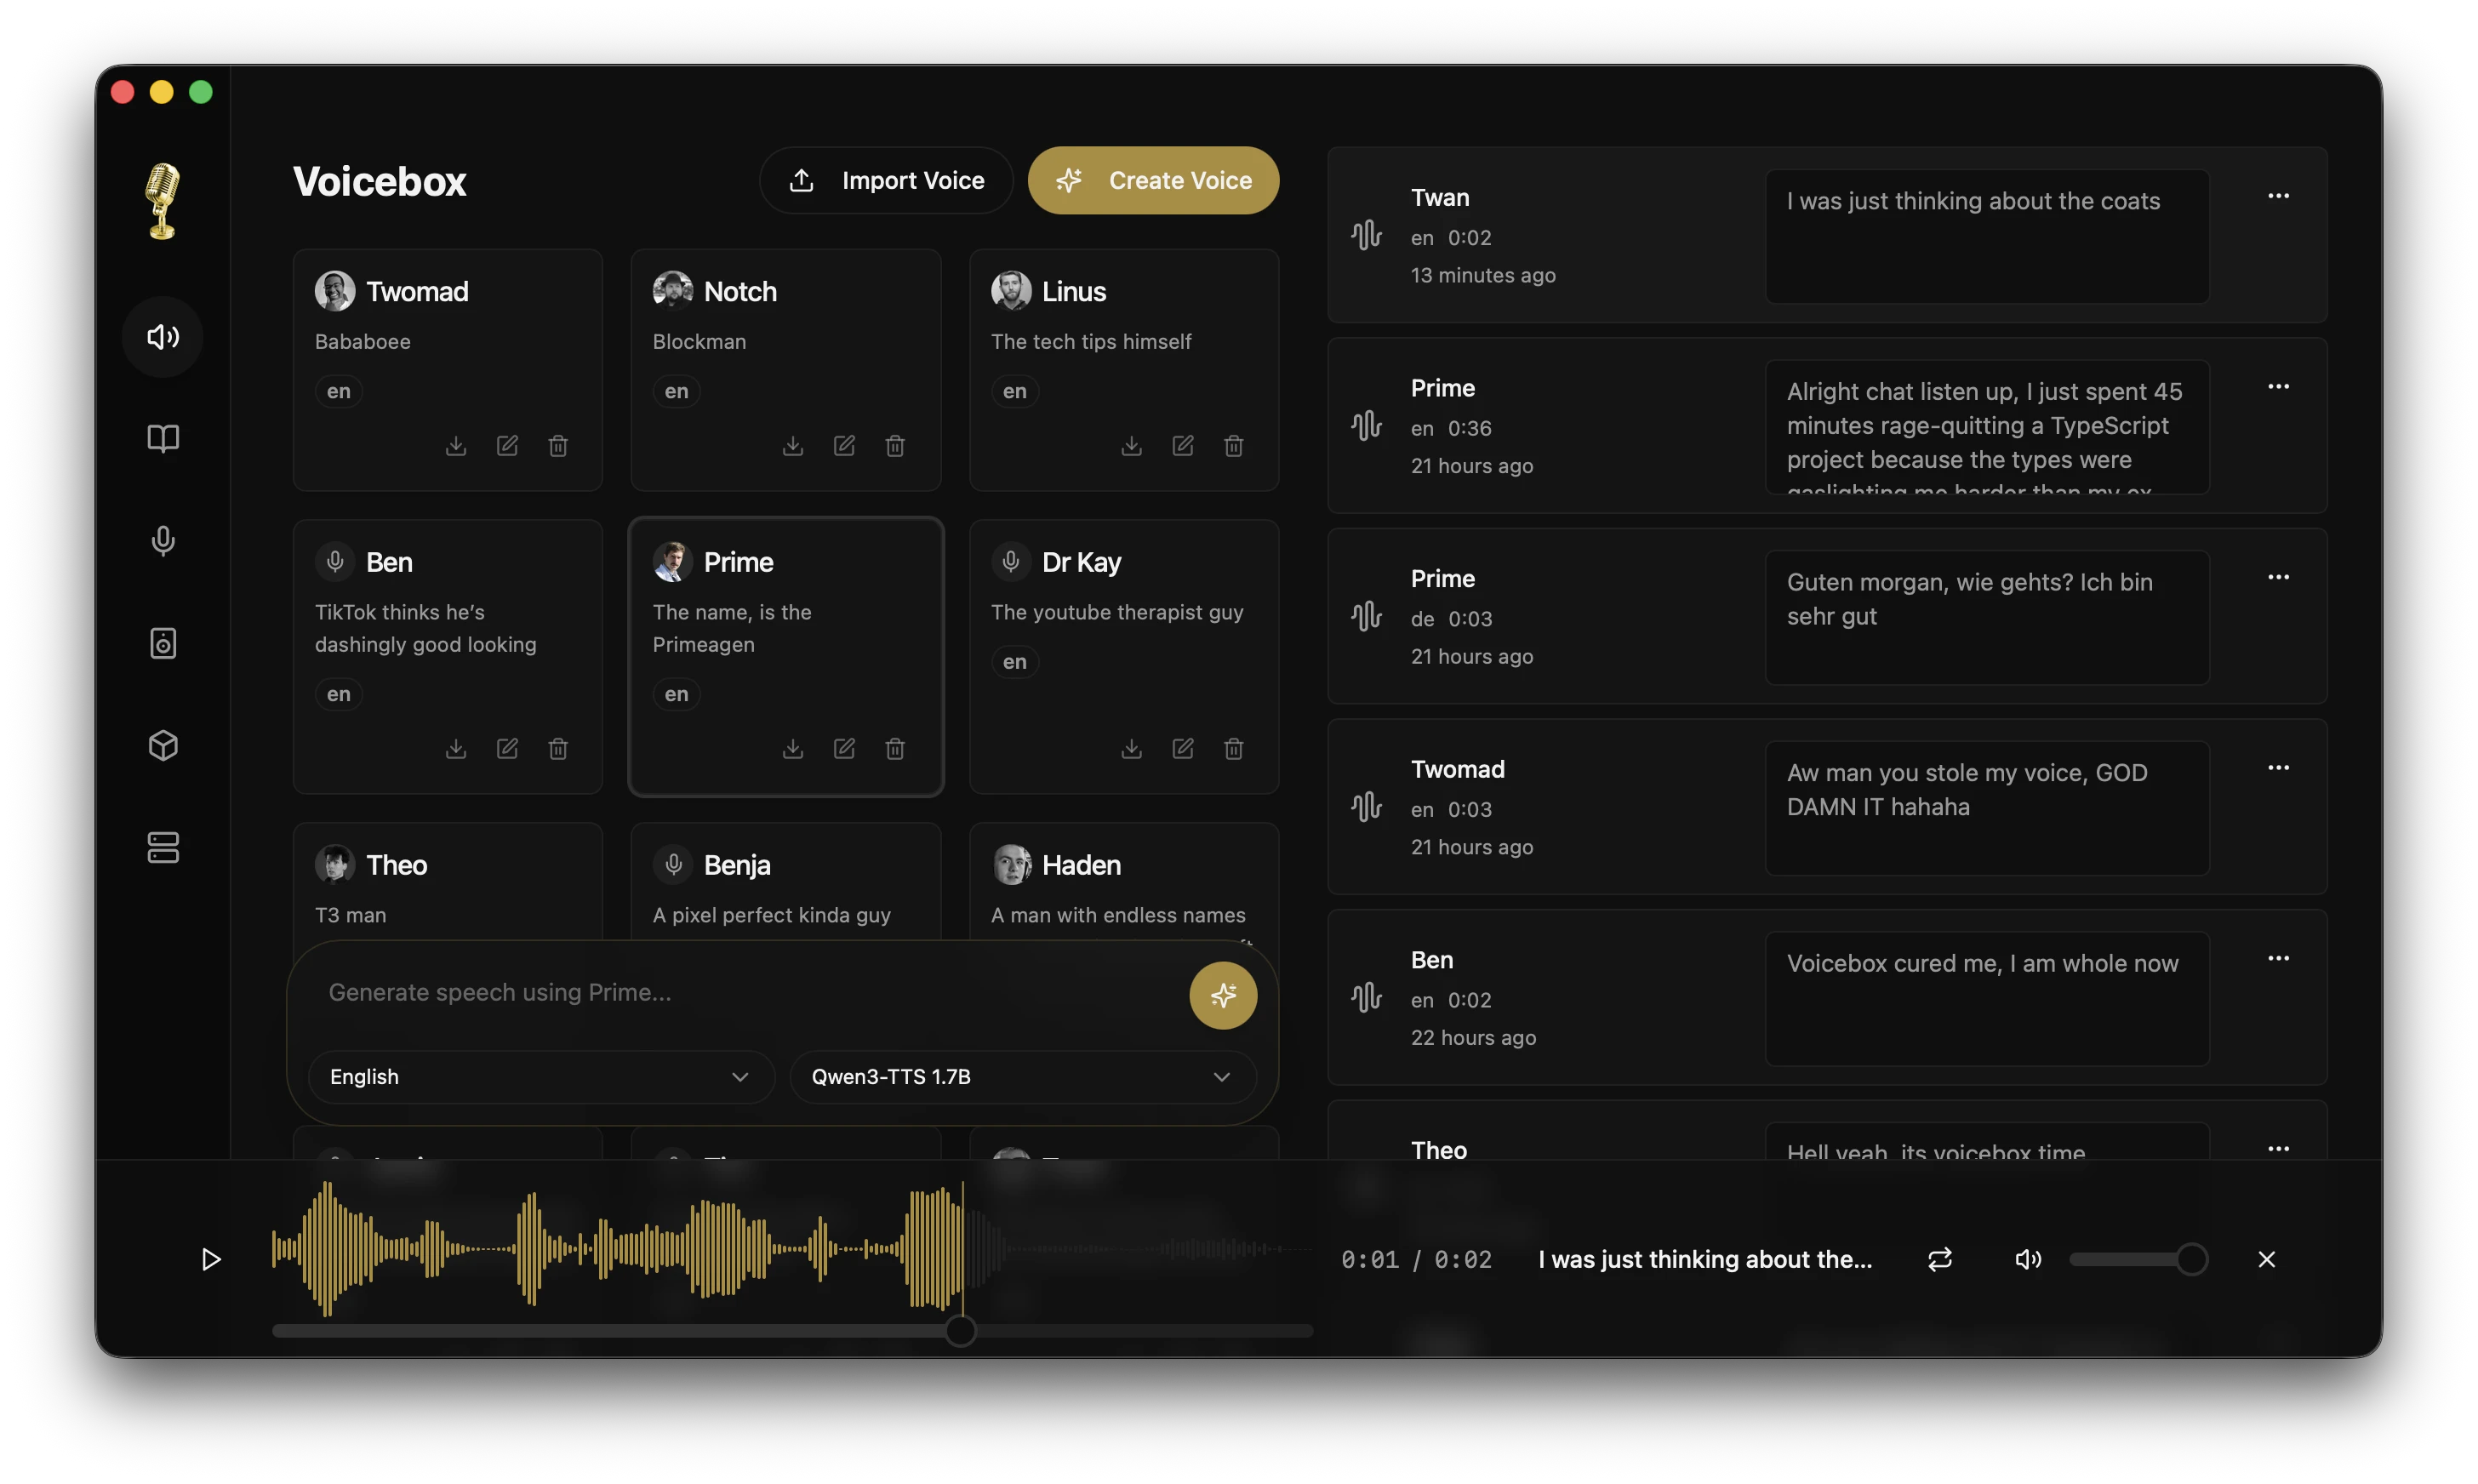
点击上方图片在 voicebox.sh 观看演示视频
什么是 Voicebox?
Voicebox 是一个 本地优先的 AI 语音工作室 —— 免费开源的 ElevenLabs 与 WisprFlow 合二为一的替代品。只需几秒钟的音频即可克隆声音,使用 7 个 TTS 引擎支持 23 种语言生成语音,通过全局热键在任何文本字段中听写,并为你喜欢的任何 MCP-aware AI 智能体赋予你选择的声音。
现有的两家云端服务分别占据了语音 I/O 循环的两个半环 —— ElevenLabs 负责输出,WisprFlow 负责输入。Voicebox 两者兼顾,通过内置的本地 LLM 将它们桥接起来,用于润色和按配置文件配置人格,并且整个流程都运行在你的机器上。
- 完全隐私 —— 模型、语音数据和捕捉内容绝不会离开你的机器
- 7 个 TTS 引擎 —— Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 和 Kokoro
- 声音克隆与预设声音 —— 从参考样本进行零样本克隆,或通过 Kokoro 和 Qwen CustomVoice 使用 50 多个精选预设声音
- 23 种语言 —— 从英语到阿拉伯语、日语、印地语、斯瓦希里语等等
- 后处理效果 —— 音高偏移、混响、延迟、合唱、压缩和滤波器
- 表现力语音 —— 通过 Chatterbox Turbo 支持
[laugh]、[sigh]、[gasp]等副语言标签;通过 Qwen CustomVoice 支持自然语言表达控制 - 无限长度 —— 自动分块并交叉淡入淡出,适用于脚本、文章和章节
- 故事编辑器 —— 用于对话、播客和叙述的多轨时间线
- 语音输入 —— 全局听写热键,支持按即说和切换模式,macOS 上经过辅助功能验证的自动粘贴,每个文本字段内的应用内麦克风,基于 Whisper 的 STT
- 智能体语音输出 —— 一次工具调用(
voicebox.speak),任何 MCP-aware 智能体(Claude Code、Cursor、Cline)就能以你克隆的声音与你对话 - 语音人格 —— 为任何语音配置文件附加自由形式的人格描述,然后通过内置的本地 LLM 进行 撰写、重写 或 回复 —— 智能体可以通过 MCP 调用相同的模式
- API 优先 —— REST API 加上内置的 MCP 服务器,用于将语音 I/O 集成到你自己的应用和智能体中
- 原生性能 —— 使用 Tauri(Rust)构建,而非 Electron
- 运行于所有平台 —— macOS(MLX/Metal)、Windows(CUDA)、Linux、AMD ROCm、Intel Arc、Docker
下载
| 平台 | 下载 |
|---|---|
| macOS(Apple Silicon) | 下载 DMG |
| macOS(Intel) | 下载 DMG |
| Windows | 下载 MSI |
| Docker | docker compose up |
Linux —— 暂未提供预编译二进制文件。请参阅 voicebox.sh/linux-install 了解从源码构建的说明。
遇到问题? 请参阅 故障排除指南 了解常见的安装、生成、模型下载和 GPU 问题。
功能
多引擎声音克隆
七个 TTS 引擎各具优势,可在每次生成时切换:
| 引擎 | 语言数 | 优势 |
|---|---|---|
| Qwen3-TTS(0.6B / 1.7B) | 10 | 高质量多语言克隆,支持表达指令(如“说慢点”、“耳语”) |
| Qwen CustomVoice | 10 | 9 个精选预设声音,支持自然语言表达控制 —— 无需参考音频 |
| LuxTTS | 英语 | 轻量级(~1GB 显存),48kHz 输出,在 CPU 上达到 150 倍实时速度 |
| Chatterbox Multilingual | 23 | 最广泛的语言覆盖 —— 阿拉伯语、丹麦语、芬兰语、希腊语、希伯来语、印地语、马来语、挪威语、波兰语、斯瓦希里语、瑞典语、土耳其语等 |
| Chatterbox Turbo | 英语 | 快速 350M 模型,支持副语言情感/声音标签 |
| TADA(1B / 3B) | 10 | HumeAI 语音语言模型 —— 700 秒以上连贯音频,文本-声学双对齐 |
| Kokoro | 8 | 50 个精选预设声音,小巧的 82M 模型,快速的 CPU 推理 |
情感与副语言标签
只有 Chatterbox Turbo 会解释 [laugh] 和 [sigh] 等副语言标签。Qwen3-TTS、LuxTTS、Chatterbox Multilingual 和 HumeAI TADA 会将其按字面文本读取。
当选择 Chatterbox Turbo 时,在文本输入框中输入 / 可打开标签插入器,并在语音中内联添加表情标签:
[laugh] [chuckle] [gasp] [cough] [sigh] [groan] [sniff] [shush] [clear throat]
后处理效果
由 Spotify 的 pedalboard 库驱动的 8 种音频效果。在生成后应用,实时预览,构建可复用的预设。
| 效果 | 描述 |
|---|---|
| 音高偏移 | 向上或向下最多 12 个半音 |
| 混响 | 可配置的房间大小、衰减、干/湿混合 |
| 延迟 | 回声,可调节时间、反馈和混合 |
| 合唱 / 镶边 | 调制延迟,产生金属感或丰富质感 |
| 压缩器 | 动态范围压缩 |
| 增益 | 音量调节(-40 至 +40 dB) |
| 高通滤波器 | 去除低频 |
| 低通滤波器 | 去除高频 |
内置 4 个预设(机器人声、电台声、回声室、低沉嗓音),并支持自定义预设。效果可按配置文件分配为默认值。
无限生成长度
文本会自动在句子边界处拆分,每个块独立生成,然后交叉淡入淡出合并。所有引擎均支持。
- 可配置的自动分块限制(100–5,000 字符)
- 交叉淡入淡出滑块(0–200ms)实现平滑过渡
- 最大文本长度:50,000 字符
- 智能拆分尊重缩写、CJK 标点以及
[标签]
生成版本
每次生成支持多个版本,并带有来源追踪:
- 原始版本 —— 干净的 TTS 输出,始终保留
- 效果版本 —— 从任何源版本应用不同的效果链
- 片段 —— 使用新种子重新生成以获得变化
- 来源追踪 —— 每个版本记录其衍化记录
- 收藏 —— 标记喜爱的生成以快速访问
异步生成队列
生成非阻塞。提交后立即开始输入下一个。
- 串行执行队列防止 GPU 竞争
- 实时 SSE 状态推送
- 失败的生成可重试
- 崩溃导致的过期生成在启动时自动恢复
语音配置文件管理
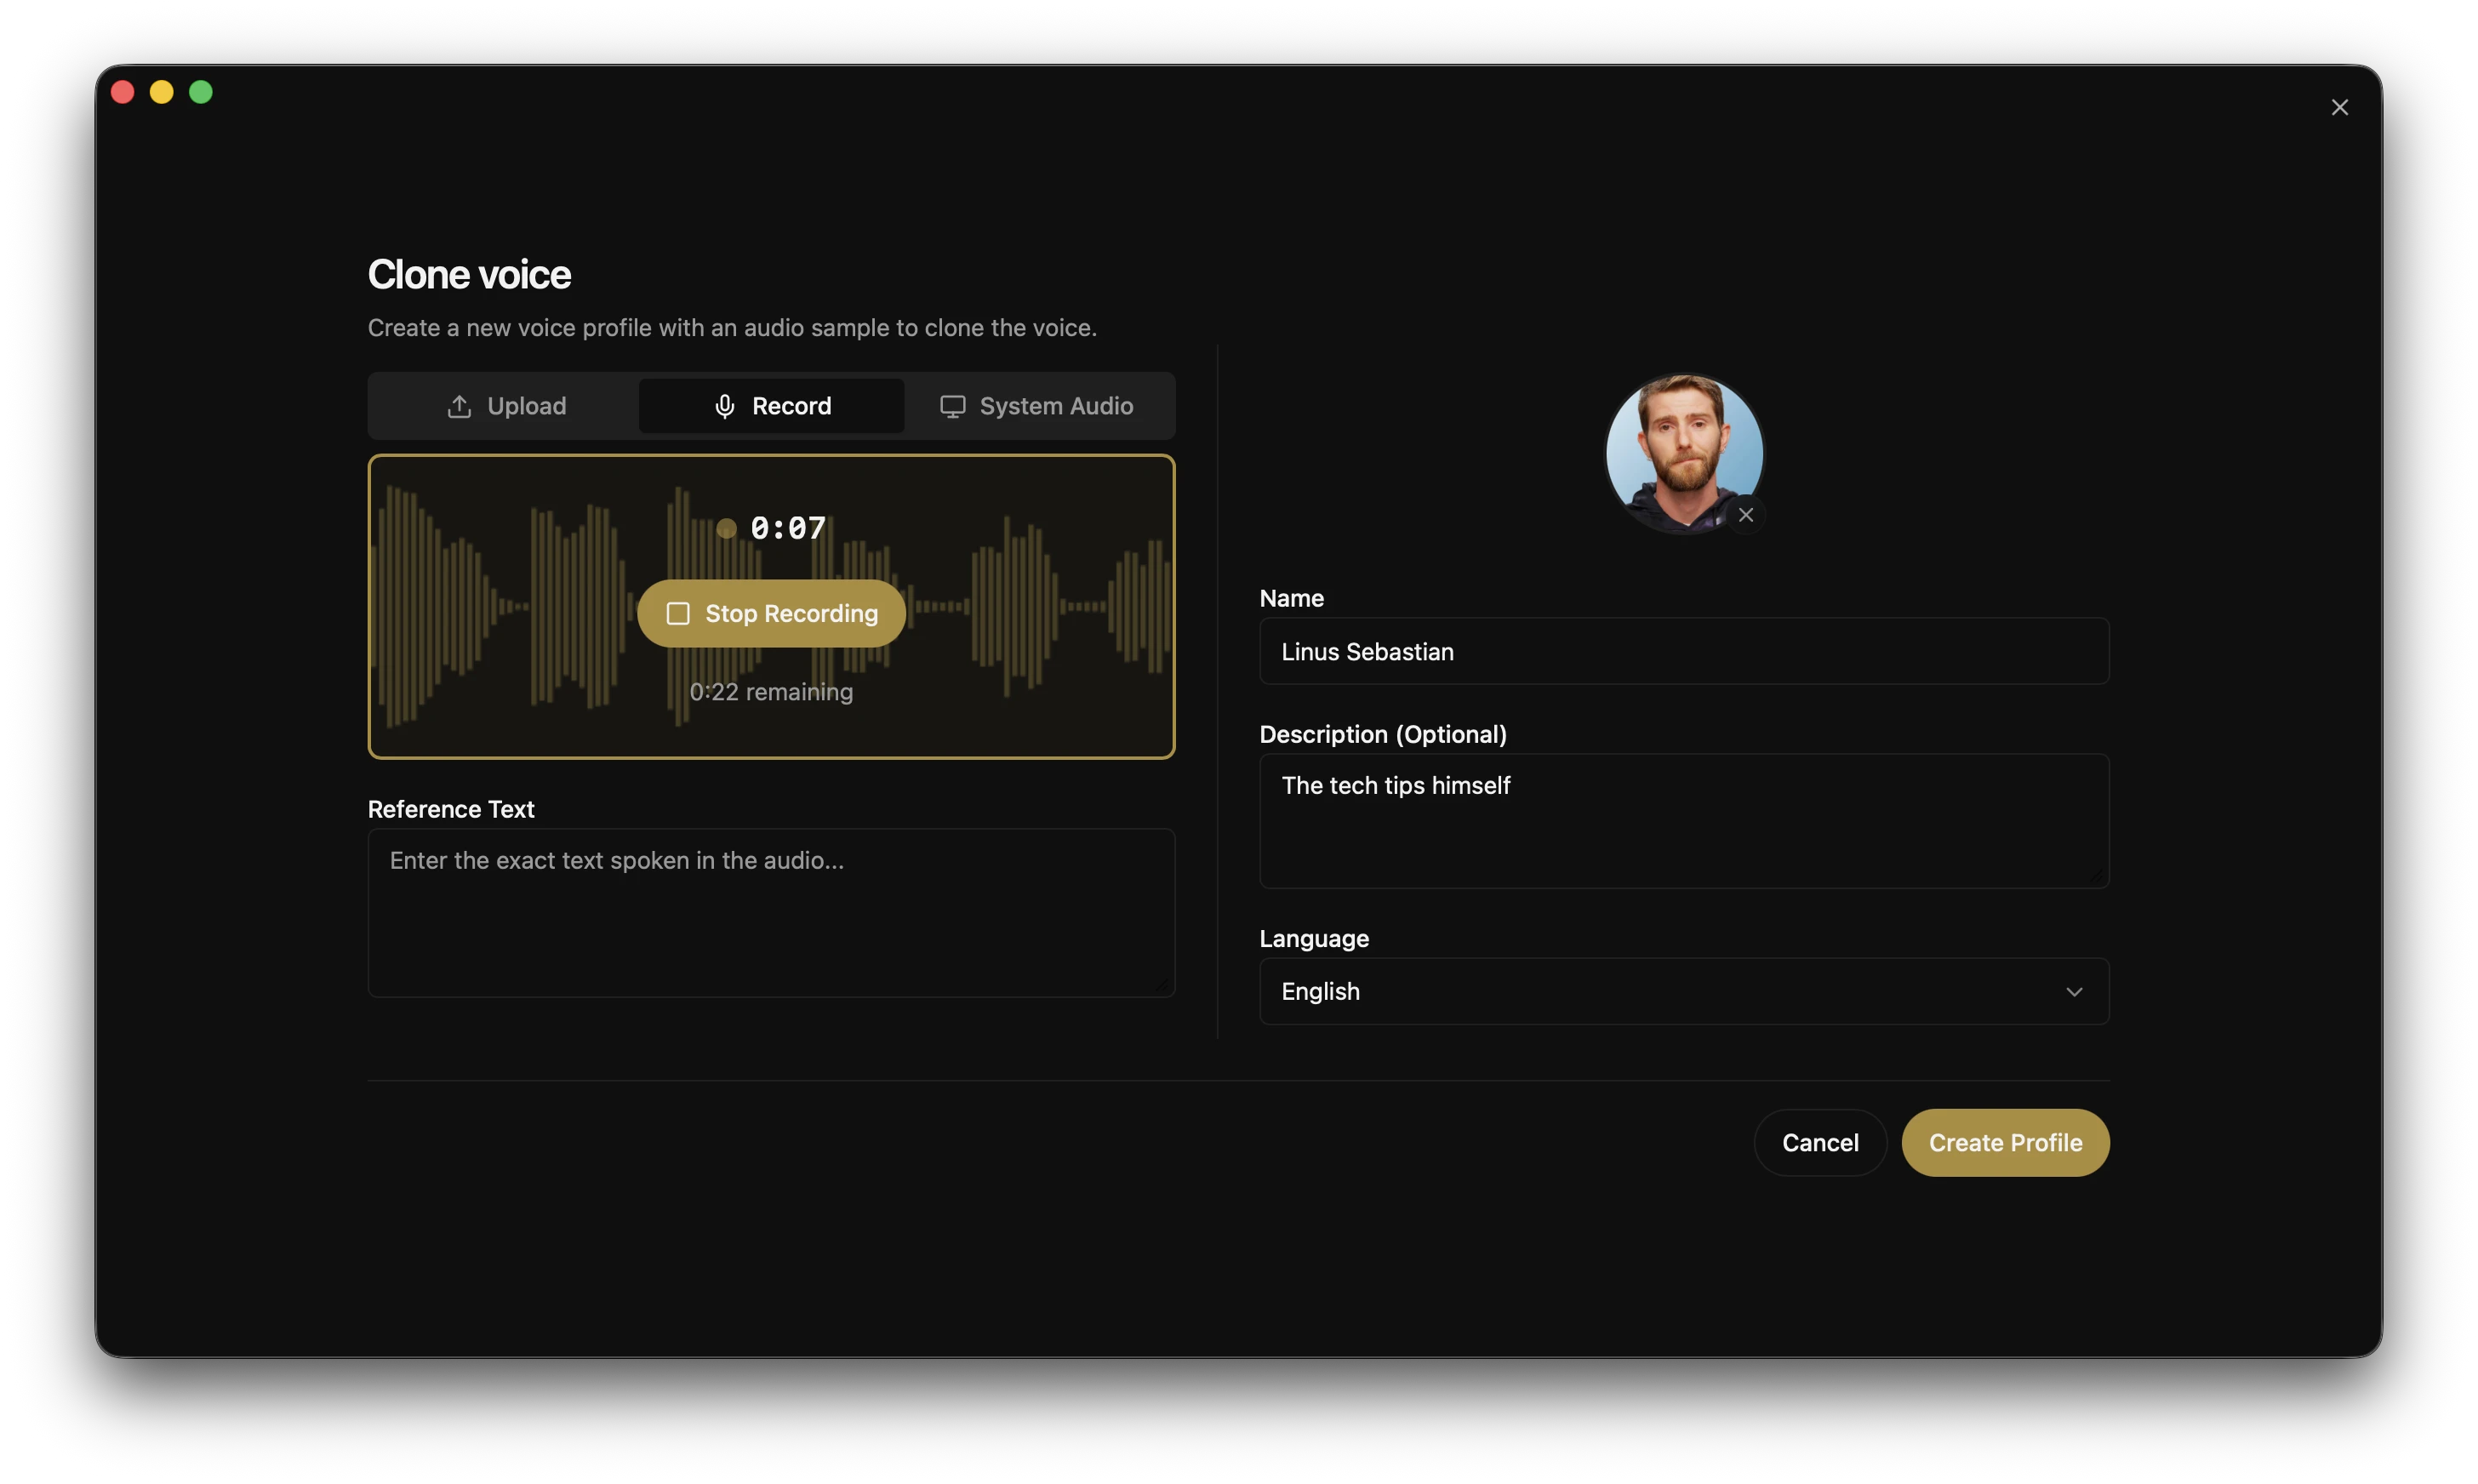
- 从音频文件创建配置文件,或在应用内直接录制
- 导入/导出配置文件以共享或备份
- 多样本支持实现更高质量的克隆
- 按配置文件分配默认效果链
- 使用描述和语言标签进行组织
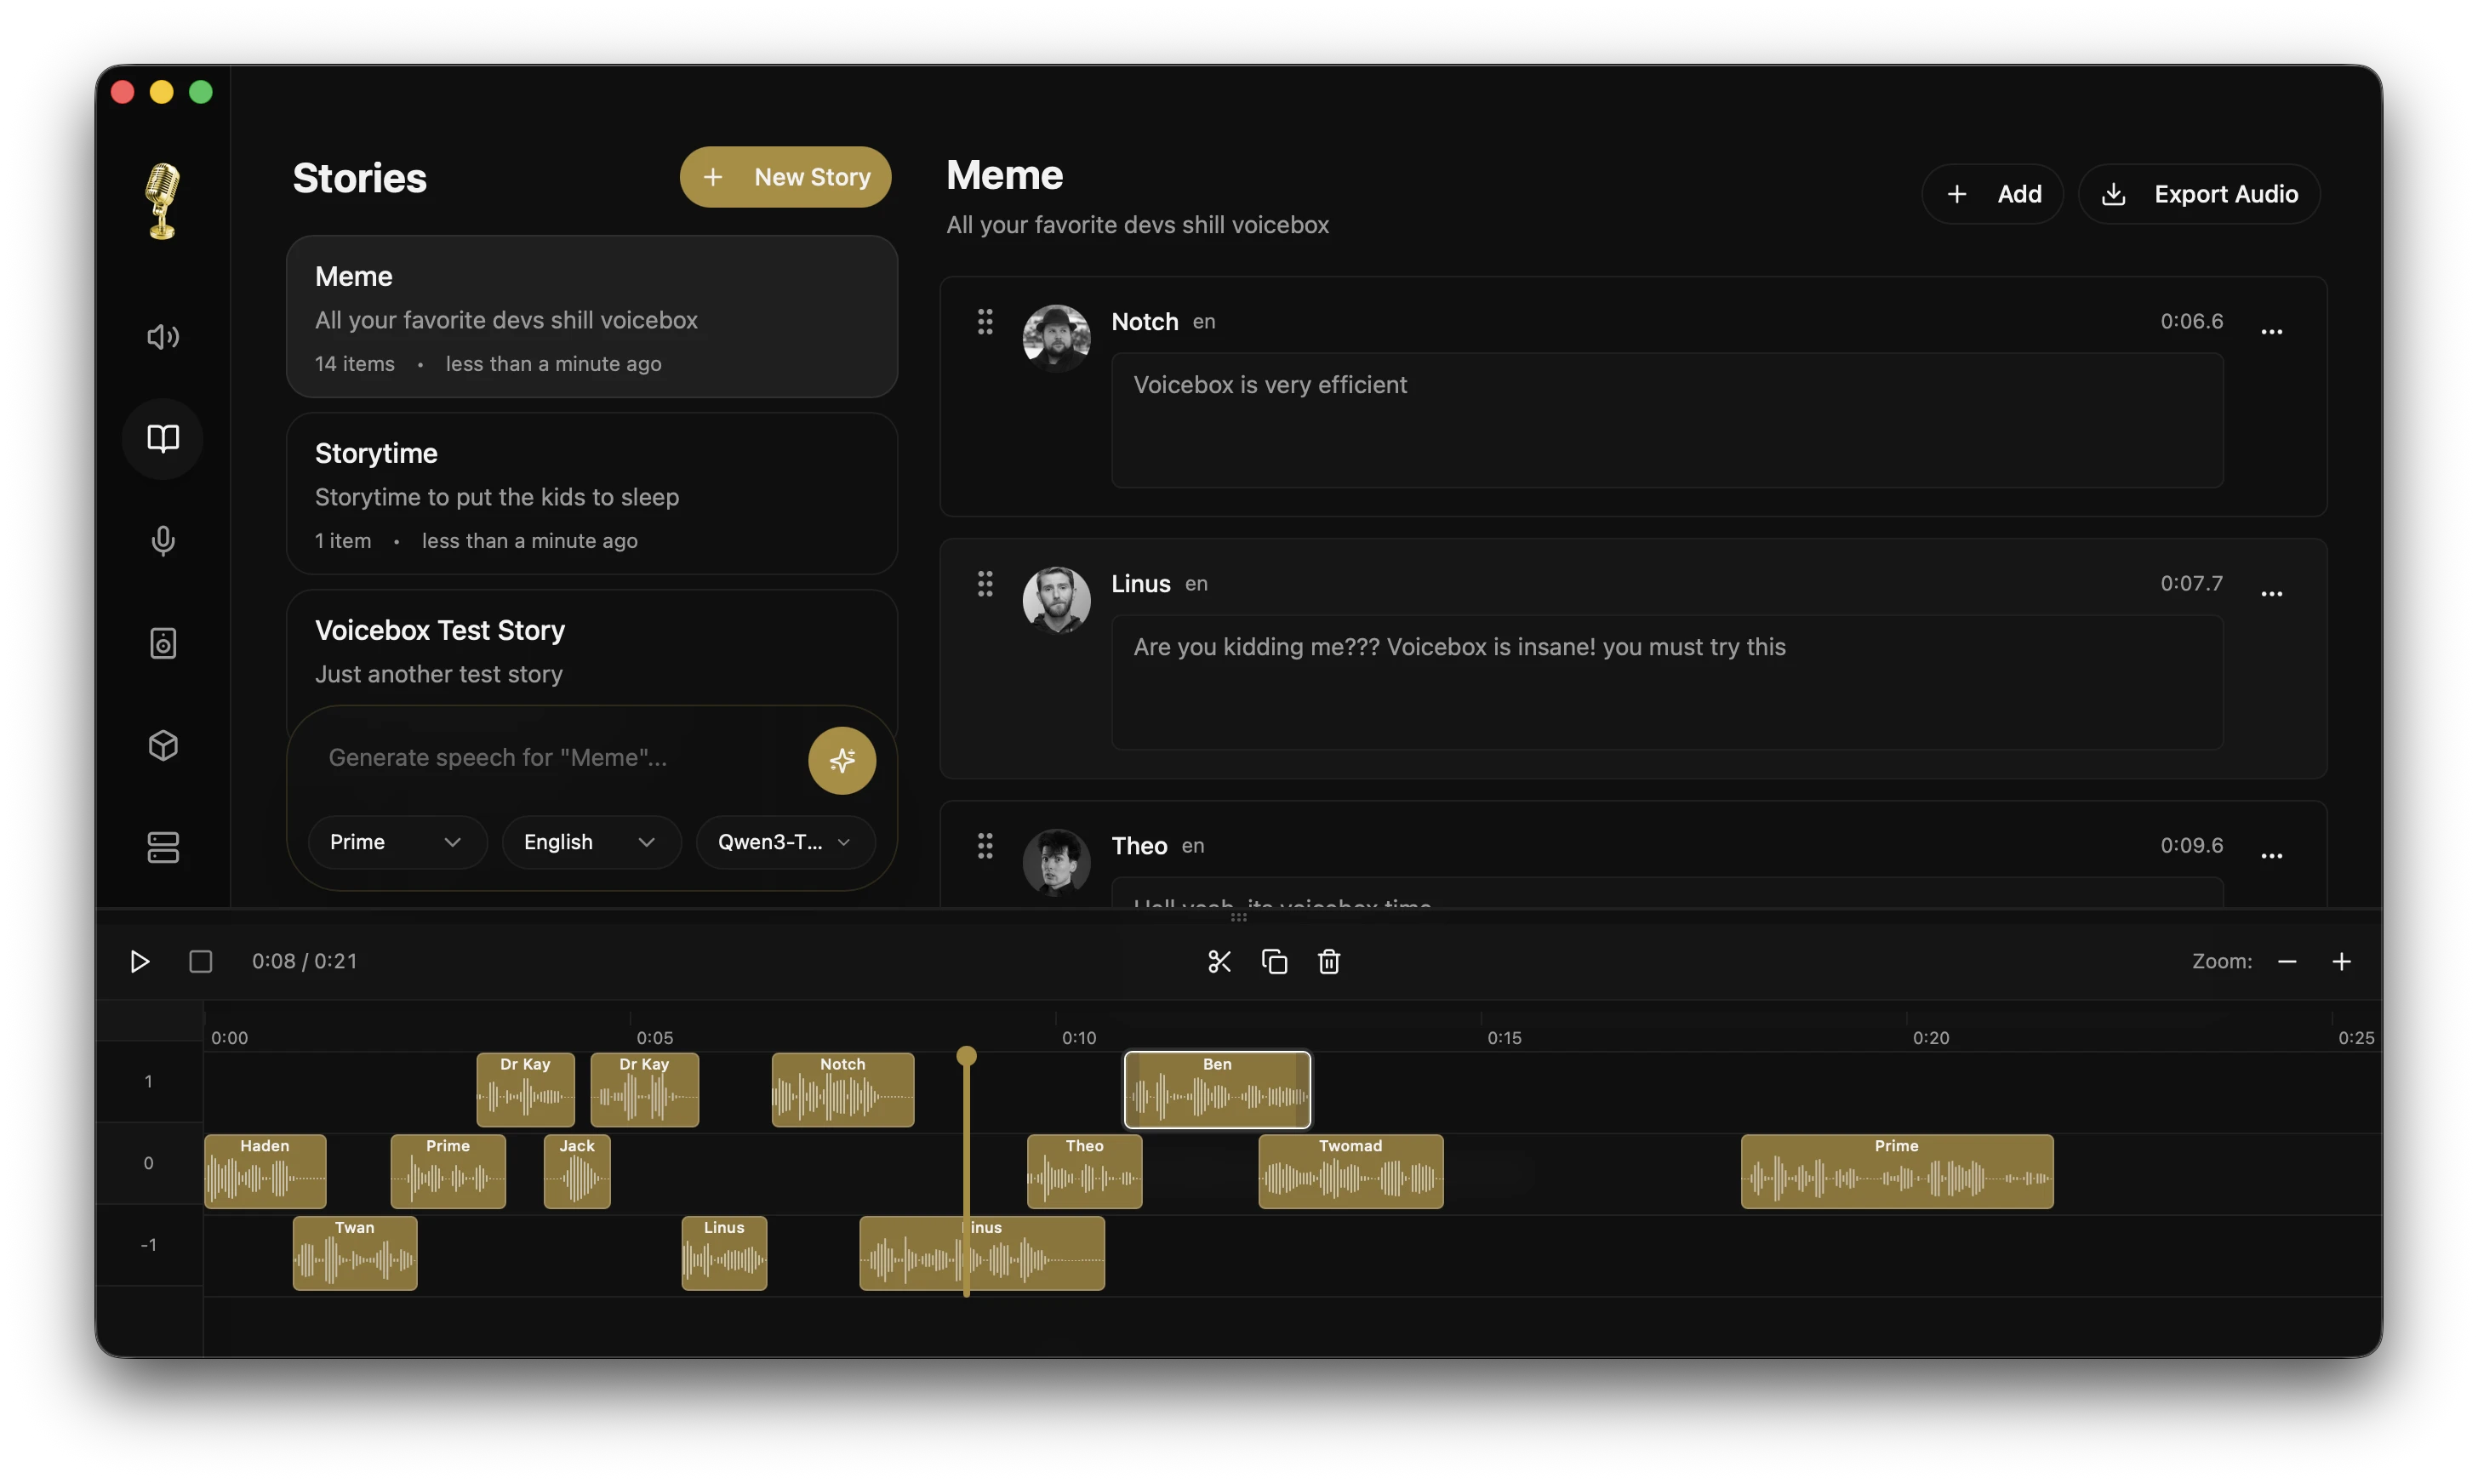
故事编辑器
多语音时间线编辑器,用于对话、播客和叙述。
- 多轨合成,支持拖放
- 内联音频修剪和分割
- 自动播放,同步播放头
- 每个轨道片段支持版本固定
全局听写与语音输入
语音 I/O 循环的另一半。在系统任何位置按住热键,说话,松开 —— 在 macOS 上,转录文本会直接粘贴到聚焦的文本字段中。或者点击任何 Voicebox 文本输入框中的麦克风,直接在应用内听写。
- 可配置按键绑定 —— 按住说话和轻点切换两种模式,每个绑定都可在应用内的按键选择器中重新配置。按住“按即说”时,轻点
Space可无缝升级为切换会话,音频不中断 - 目标感知粘贴(macOS) —— 通过辅助功能注入到聚焦的文本字段,原子化剪贴板保存/恢复,不会破坏你的剪贴板
- 首次运行权限界面 —— 应用内引导帮你完成 macOS 辅助功能和输入监控授权,并提供系统设置的深层链接
- 每个 Voicebox 文本字段中的应用内麦克风按钮 —— 生成表单、配置文件描述、故事标题等任何需要输入的地方
- LLM 润色 —— 可选清除“嗯”、口吃和语法错误后再粘贴
- 屏幕药丸 —— 浮动覆盖层,显示“录音中”、“转录中”、“润色中”、“说话中”等状态。智能体与你说话时也会显示同样的药丸,因此循环的两端共享一个心理模型
语音转文本
Voicebox 运行 OpenAI Whisper 进行转录 —— 与支持听写、捕捉标签和 /transcribe API 的模型相同。根据平台在 MLX(Apple Silicon)或 PyTorch(CUDA / ROCm / DirectML / CPU)上运行。
| 大小 | 备注 |
|---|---|
| Base / Small / Medium / Large | 标准 Whisper 质量阶梯 |
| Turbo | 比 Whisper Large 快约 8 倍,质量损失极小 |
更多引擎(Parakeet v3、Qwen3-ASR)正在规划中 —— 请参阅 路线图。
捕捉
每次听写、应用内录音和上传的音频文件都会存放到捕捉标签中 —— 原始音频与转录文本配对,始终保留。
- 重放、重新转录、润色 —— 使用任意 Whisper 大小重新运行 STT,或使用不同标志(填充词清理、自我修正移除、技术术语保留)将原始转录文本通过本地 LLM 重新处理
- 内联编辑 —— 调整转录文本,失焦时保存
- 作为语音配置文件播放 —— 一键将任何捕捉内容转化为带有克隆声音的语音
- 提升为语音样本 —— 将捕捉的音频 + 转录文本用作任何语音配置文件的参考样本
- 本地捕捉存储 —— 原始音频和转录文本保存在你的 Voicebox 数据目录中,设置中有文件夹快捷方式
智能体语音输出
每个智能体都有自己的声音。一次工具调用,任何 MCP-aware 智能体就能以你克隆的声音与你对话 —— 任务完成、提问、通知。听写时显示的药丸在智能体说话时也会显示,让你始终了解机器正在输出什么。
// 在任何 MCP-aware 智能体中:
await voicebox.speak({
  text: "部署完成。",
  profile: "Morgan",
});
同时以 POST /speak 形式暴露,供不支持 MCP 的工具使用 —— ACP、A2A、Shell 脚本、自定义套件。
- 双向药丸 —— “录音中”、“转录中”、“润色中”、“说话中” 都是同一 OS 层级覆盖层的状态,因此听写和智能体语音共享同一个界面
- 按智能体绑定声音 —— 在 设置 → MCP 中,将 Claude Code 绑定到 Morgan,将 Cursor 绑定到 Scarlett,这样不用看就能知道是哪个智能体在说话。每个客户端的
last_seen_at时间戳确认安装生效 - 始终可见 —— 无静默后台 TTS;每次智能体发起的说话都会在持续时间内显示带有语音配置文件名称的药丸
- HTTP + stdio 传输 —— 在 Claude Code / Cursor / Windsurf / VS Code MCP 中作为 URL 安装,或者将仅支持 stdio 的客户端指向内置的
voicebox-mcp二进制文件
语音人格
为任何语音配置文件附加自由形式的人格描述 —— 这个声音是谁,它如何说话,它在乎什么。当设置人格后,生成框上会出现两个操作,由完全本地运行的捆绑 Qwen3 LLM 驱动。
- 撰写 —— 一个随机按钮,会生成一句符合角色的文本并放入文本框中;可以编辑后朗读,或再次点击获得不同的表述
- 按角色说话 —— 一个开关,将输入文本通过人格 LLM 重写为角色语气,然后再进行 TTS
智能体可以通过 MCP 将 personality: true 参数传递给 voicebox.speak 来访问相同的重写路径,从而将工具变成 文本输入 → 人格 LLM → TTS 管线。同一个 LLM 也支持听写的润色步骤 —— 一个应用内 LLM,一个模型缓存,一份 GPU 内存占用。
本地 LLM 选项: Qwen3 0.6B / 1.7B / 4B,与 TTS 共享运行时(Apple Silicon 上为 MLX,其他平台为 PyTorch)。
使用场景:智能体开发循环(听写问题,听到用克隆声音给出的答案)、游戏和叙事工具中的交互式角色、为无法使用自己原声的人提供语音辅助。
模型管理
- 按模型卸载以释放 GPU 内存,无需删除下载内容
- 通过
VOICEBOX_MODELS_DIR自定义模型目录 - 模型文件夹迁移,带有进度追踪
- 下载取消/清除界面
GPU 支持
| 平台 | 后端 | 备注 |
|---|---|---|
| macOS(Apple Silicon) | MLX(Metal) | 通过神经网络引擎快 4-5 倍 |
| Windows / Linux(NVIDIA) | PyTorch(CUDA) | 从应用内自动下载 CUDA 二进制文件 |
| Linux(AMD) | PyTorch(ROCm) | 自动配置 HSA_OVERRIDE_GFX_VERSION |
| Windows(任意 GPU) | DirectML | 通用的 Windows GPU 支持 |
| Intel Arc | IPEX/XPU | Intel 独立 GPU 加速 |
| 任意 | CPU | 随处可运行,速度较慢 |
API
Voicebox 暴露 REST API,用于将语音 I/O 集成到你自己的应用和智能体中。
# 生成语音
curl -X POST http://127.0.0.1:17493/generate \
  -H "Content-Type: application/json" \
  -d '{"text": "Hello world", "profile_id": "abc123", "language": "en"}'

# 智能体语音输出 —— 任何应用或脚本都可以用克隆的声音说话
curl -X POST http://127.0.0.1:17493/speak \
  -H "Content-Type: application/json" \
  -H "X-Voicebox-Client-Id: my-script" \
  -d '{"text": "部署完成。", "profile": "Morgan"}'

# 转录音频文件
curl -X POST http://127.0.0.1:17493/transcribe \
  -F "audio=@recording.wav" \
  -F "model=whisper-turbo"

# 列出语音配置文件
curl http://127.0.0.1:17493/profiles
POST /speak 接受 profile 作为名称(不区分大小写)或 id,并按照与 MCP 工具相同的优先级解析:显式参数 → 按客户端绑定 → capture_settings.default_playback_voice_id。
MCP 服务器
Voicebox 内置了 Model Context Protocol 服务器,因此任何 MCP-aware 智能体(Claude Code、Cursor、Windsurf、Cline、VS Code MCP 扩展)都可以说话、转录,以及浏览捕捉和配置文件。
Claude Code 一行命令:
claude mcp add voicebox \
  --transport http \
  --url http://127.0.0.1:17493/mcp \
  --header "X-Voicebox-Client-Id: claude-code"
任何 HTTP MCP 客户端(Cursor、Windsurf、VS Code 等):
{
  "mcpServers": {
    "voicebox": {
      "url": "http://127.0.0.1:17493/mcp",
      "headers": { "X-Voicebox-Client-Id": "cursor" }
    }
  }
}
Stdio 回退方案 用于不支持 HTTP MCP 的客户端 —— 指向应用内捆绑的 voicebox-mcp 二进制文件:
{
  "mcpServers": {
    "voicebox": {
      "command": "/Applications/Voicebox.app/Contents/MacOS/voicebox-mcp",
      "env": { "VOICEBOX_CLIENT_ID": "claude-desktop" }
    }
  }
}
提供了四个工具:voicebox.speak、voicebox.transcribe、voicebox.list_captures、voicebox.list_profiles。按客户端的语音绑定在 Voicebox → 设置 → MCP 中管理。请参阅 完整 MCP 指南 了解工具签名、解析优先级、说话药丸约定和安全说明。
// 在任何 MCP-aware 智能体中:
await voicebox.speak({
  text: "测试通过。可以合并。",
  profile: "Morgan",      // 可选 —— 回退到按客户端绑定
  personality: true,      // 可选 —— 先通过配置文件的人格 LLM 重写文本
});
使用场景: 智能体开发循环(语音输入,语音输出)、游戏对话、播客制作、无障碍工具、语音助手、内容自动化。
完整 API 文档请访问 http://127.0.0.1:17493/docs。
技术栈
| 层级 | 技术 |
|---|---|
| 桌面应用 | Tauri(Rust) |
| 前端 | React、TypeScript、Tailwind CSS |
| 状态管理 | Zustand、React Query |
| 后端 | FastAPI(Python) |
| TTS 引擎 | Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox、Chatterbox Turbo、TADA、Kokoro |
| STT | Whisper / Whisper Turbo(PyTorch 或 MLX) |
| 本地 LLM | Qwen3(0.6B / 1.7B / 4B),与 TTS / STT 共享运行时 |
| MCP 服务器 | FastMCP 挂载于 /mcp(Streamable HTTP)+ 捆绑的 stdio shim 二进制文件 |
| 原生适配层 | Rust(位于 Tauri 内部),负责全局热键、粘贴注入、焦点检测 |
| 效果 | Pedalboard(Spotify) |
| 推理 | MLX(Apple Silicon)/ PyTorch(CUDA/ROCm/XPU/CPU) |
| 数据库 | SQLite |
| 音频 | WaveSurfer.js、librosa |
路线图
| 功能 | 描述 |
|---|---|
| Windows / Linux 自动粘贴 | 实现与 macOS 一致的听写粘贴 —— Windows 上使用 SendInput,Linux 上使用 uinput / AT-SPI |
| STT 引擎扩展 | Parakeet v3 和 Qwen3-ASR 加入 Whisper —— 50 多种语言,更好的非英语质量 |
| 管线路由 | 可配置的 源 → 转换 → 输出 链,支持 webhook + MCP 输出以及预设编辑器 |
| 流式转录 | WebSocket /transcribe/stream,说话时获得部分转录结果 |
| 端到端语音 LLM | Moshi、GLM-4-Voice、Qwen2.5 Omni —— 真正的语音到语音,无需中间文本 |
| 声音设计 | 根据文字描述创建新的声音 |
| 长时捕捉 | 双流录音器(麦克风 + 系统音频),带摘要 LLM 转换 |
| 平台输出 | Apple Notes、Obsidian 等可选集成 |
| 插件架构 | 使用自定义模型、转换和输出进行扩展 |
| 移动端伴侣 | 从手机控制 Voicebox |
有关 完整的工程状态、公开问题分类和优先级工作队列,请参见 docs/PROJECT_STATUS.md —— 这是一份活跃文档,追踪已发布内容、正在进行的工作、评估中的候选 TTS 引擎,以及我们接受或搁置特定集成的原因。
开发
请参阅 CONTRIBUTING.md 获取详细设置和贡献指南。
快速开始
git clone https://github.com/jamiepine/voicebox.git
cd voicebox

just setup   # 创建 Python 虚拟环境,安装所有依赖
just dev     # 启动后端 + 桌面应用
安装 just:brew install just 或 cargo install just。运行 just --list 查看所有命令。
前置要求: Bun、Rust、Python 3.11+、Tauri 前置条件 以及 macOS 上的 Xcode。
仓库根目录下已包含预配置的 .mcp.json —— 在此检出目录中运行 Claude Code,一旦开发应用运行起来,就会自动启用 Voicebox MCP 工具。
本地构建
just build          # 构建 CPU 服务器二进制文件 + Tauri 应用
just build-local    # (Windows)构建 CPU + CUDA 服务器二进制文件 + Tauri 应用
添加新的语音模型
多引擎架构使得添加新的 TTS 引擎变得简单。一份 分步指南 涵盖了完整过程:依赖研究、后端协议实现、前端接线以及 PyInstaller 打包。
该指南针对 AI 编码智能体进行了优化。一个 智能体技能 可以根据模型名称自动处理整个集成 —— 你只需在本地测试构建。
项目结构
voicebox/
├── app/              # 共享的 React 前端
├── tauri/            # 桌面应用(Tauri + Rust)
├── web/              # Web 部署
├── backend/          # Python FastAPI 服务器
├── landing/          # 营销网站
└── scripts/          # 构建与发布脚本
贡献
欢迎贡献!请参阅 CONTRIBUTING.md 了解指南。
- Fork 本仓库
- 创建功能分支
- 进行你的修改
- 提交 PR
安全
发现安全漏洞?请负责任地报告。详情请参阅 SECURITY.md。
许可证
MIT 许可证 —— 详情请参阅 LICENSE。