speech-to-speech
模块化的语音 agent 管道,将 VAD、STT、LLM、TTS 四个组件串联成低延迟的完全本地可部署系统,对外暴露 OpenAI Realtime 兼容的 WebSocket API。亮点是每个组件均可替换,LLM 槽支持 OpenAI 协议的任何 provider 或本地 vLLM/llama.cpp 服务器,已用于数千台 Reachy Mini 机器人生产环境,且工具链与 Hugging Face 生态无缝衔接。
README
Speech To Speech: Build voice agents with open-source models(用开源模型构建语音智能体)

一个低延迟、完全模块化的语音智能体流水线:VAD(语音活动检测) -> STT(语音转文字) -> LLM(大语言模型) -> TTS(文字转语音),通过兼容 OpenAI Realtime 的 WebSocket API 对外暴露。每个组件均可替换。LLM 槽位使用 OpenAI 兼容协议,因此你可以将其指向托管提供商、HF Inference Providers,或指向自己硬件上运行的 vLLM 或 llama.cpp 服务器,实现完全本地、完全开源的技术栈。
该流水线已在生产环境中作为数千台 Reachy Mini 机器人的对话后端运行。
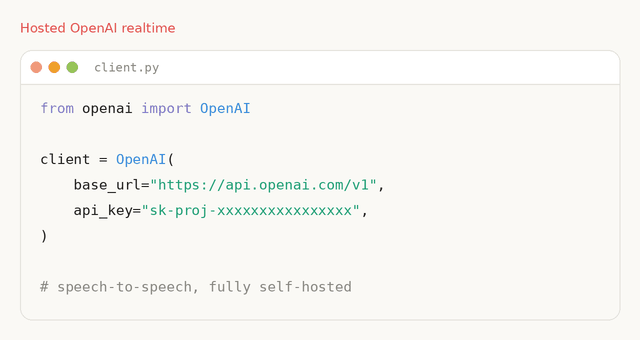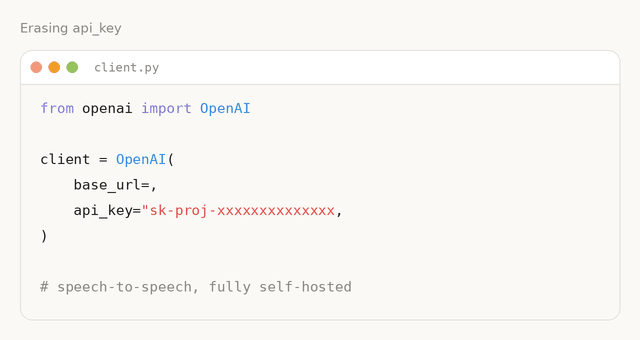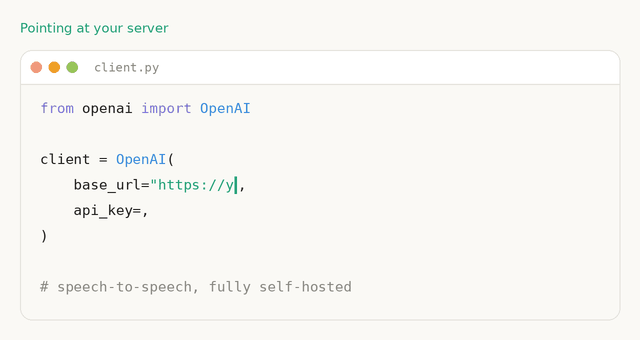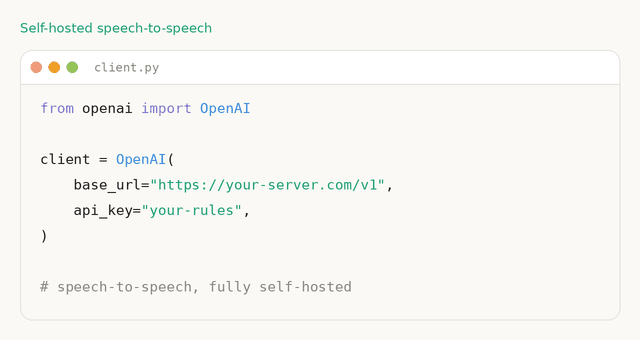
快速开始
pip install speech-to-speech
export OPENAI_API_KEY=...
speech-to-speech
这将启动一个 OpenAI Realtime 兼容服务器,位于 ws://localhost:8765/v1/realtime,使用 Parakeet TDT 进行本地 STT,使用 OpenAI 兼容的 LLM,以及 Qwen3-TTS 进行本地语音输出。
从源码签出后,可以在第二个终端与其对话:
python scripts/listen_and_play_realtime.py --host 127.0.0.1 --port 8765
更愿意将 LLM 保留在自己的机器上?使用 llama.cpp 提供 Gemma 4 服务:
llama-server -hf ggml-org/gemma-4-E4B-it-GGUF -np 2 -c 65536 -fa on --swa-full
然后将 OpenAI 兼容的 LLM 后端指向它:
speech-to-speech \
    --model_name "ggml-org/gemma-4-E4B-it-GGUF" \
    --responses_api_base_url "http://127.0.0.1:8080/v1" \
    --responses_api_api_key ""
任何兼容 OpenAI Realtime 的客户端均可连接。参见 Realtime API 了解协议,参见 LLM backends 了解提供商和本地服务器选项。
目录
工作原理
流水线由四个组件级联组成,每个组件在自己的线程中运行,并通过队列连接:
- 语音活动检测 (VAD):Silero VAD v5 检测语音边界和话轮转换。
- 语音转文字 (STT):转写用户的话轮,可选的实时部分转写。
- 语言模型 (LLM):生成响应,流式输出文本和工具调用。
- 文字转语音 (TTS):合成音频并流式传回客户端。
每个阶段都有多个可互换的后端,通过 CLI 标志选择。代码设计易于修改,重点支持通过 Transformers 和 Hugging Face Hub 提供的模型。
安装
需要 Python 3.10+。
pip install speech-to-speech
默认安装覆盖标准实时路径:
- STT 使用 Parakeet TDT
- 语言模型使用 OpenAI 兼容 API
- 语音输出使用 Qwen3-TTS,在非 macOS 平台上默认使用 GGML 后端,在 Apple Silicon 上使用
mlx-audio - 本地音频和实时服务器模式
macOS 和非 macOS 的依赖关系通过 pyproject.toml 中的平台标记自动解析。
Qwen3-TTS 的 CUDA 说明
在 Linux 上,Qwen3-TTS GGML 后端来自 faster-qwen3-tts[ggml]。其在 PyPI 上的默认 qwentts-cpp-python wheel 针对 CUDA 12.8。如果你的机器没有该 wheel 期望的 CUDA 12 运行时,请在安装 speech-to-speech 之前从 Hugging Face wheelhouse 安装匹配的 wheel:
# CUDA 13.x
pip install "qwentts-cpp-python==0.3.1+cu130" \
  -f https://huggingface.co/datasets/andito/qwentts-cpp-python-wheels/tree/main/whl/cu130

# CUDA 12.4
pip install "qwentts-cpp-python==0.3.1+cu124" \
  -f https://huggingface.co/datasets/andito/qwentts-cpp-python-wheels/tree/main/whl/cu124

# CPU-only fallback(仅 CPU 回退)
pip install "qwentts-cpp-python==0.3.1+cpu" \
  -f https://huggingface.co/datasets/andito/qwentts-cpp-python-wheels/tree/main/whl/cpu

pip install speech-to-speech
要使用之前的 CUDA-graphs 实现而不是 GGML,请传递 --qwen3_tts_backend torch。
可选后端
可选后端通过 pip extras 安装:
pip install "speech-to-speech[kokoro]"          # 非 macOS 上的 Kokoro-82M TTS
pip install "speech-to-speech[pocket]"          # Pocket TTS
pip install "speech-to-speech[chattts]"         # ChatTTS
pip install "speech-to-speech[facebook-mms]"    # MMS TTS
pip install "speech-to-speech[faster-whisper]"  # Faster Whisper STT
pip install "speech-to-speech[whisper-mlx]"     # macOS 上的 Lightning Whisper MLX STT
pip install "speech-to-speech[paraformer]"      # 通过 FunASR 的 Paraformer STT
pip install "speech-to-speech[mlx-lm]"          # macOS 上视觉模型的 mlx-vlm 支持
已弃用的实现(包括 MeloTTS)位于 archive/,不再连接到 CLI。
关于 DeepFilterNet: DeepFilterNet 用于 VAD 中的可选音频增强,需要 numpy<2,与需要 numpy>=2 的 Pocket TTS 冲突。请仅在未使用 Pocket TTS 的环境中手动安装。
从源码安装
git clone https://github.com/huggingface/speech-to-speech.git
cd speech-to-speech
uv sync
这会将包安装为可编辑模式,并使 speech-to-speech CLI 可用。
支持的组件
| 组件 | 后端 | 平台 | 安装方式 |
|---|---|---|---|
| VAD | Silero VAD v5 | 所有 | 内置 |
| STT | Parakeet TDT(默认) | 通过 nano-parakeet 支持 CUDA/CPU,通过 MLX 支持 Apple Silicon | 内置 |
| STT | 通过 Transformers 的 Whisper | CUDA/CPU | 内置 |
| STT | Faster Whisper | CUDA/CPU | faster-whisper |
| STT | Lightning Whisper MLX | Apple Silicon | whisper-mlx |
| STT | MLX Audio Whisper | Apple Silicon | macOS 上内置 |
| STT | Paraformer | CUDA/CPU | paraformer |
| LLM | OpenAI 兼容 API(responses-api、chat-completions) |
托管提供商或自托管服务器 | 内置 |
| LLM | Transformers | CUDA/CPU | 内置 |
| LLM | mlx-lm | Apple Silicon | macOS 上内置 |
| TTS | Qwen3-TTS(默认) | Linux 上 GGML/CUDA,macOS 上 mlx-audio | 内置 |
| TTS | Kokoro-82M | CUDA/CPU、Apple Silicon | 非 macOS 上 kokoro;macOS 上内置 |
| TTS | Pocket TTS | CPU/CUDA | pocket |
| TTS | ChatTTS | CUDA/CPU | chattts |
| TTS | MMS TTS | CUDA/CPU | facebook-mms |
使用 --stt、--llm_backend 和 --tts 选择实现。运行 speech-to-speech -h 查看具体数值和后端特定标志。
运行模式
| 模式 | 传输方式 | 使用场景 |
|---|---|---|
realtime(默认) |
WebSocket,OpenAI Realtime 协议,路径 /v1/realtime |
你正在针对标准语音 API 构建应用或设备。 |
local |
你机器的麦克风和扬声器 | 你想直接与该流水线对话,无需客户端。 |
websocket |
通过 WebSocket 传输原始 PCM | 你想要一个不使用 Realtime 协议的最小化自定义客户端。 |
socket |
通过 TCP 传输原始 PCM | 模型运行在远程服务器上,使用简单的麦克风/播放客户端。 |
Realtime 服务器
export OPENAI_API_KEY=...
speech-to-speech
等价于:
speech-to-speech \
    --thresh 0.6 \
    --stt parakeet-tdt \
    --llm_backend responses-api \
    --tts qwen3 \
    --qwen3_tts_model_name Qwen/Qwen3-TTS-12Hz-1.7B-CustomVoice \
    --qwen3_tts_speaker Aiden \
    --qwen3_tts_language auto \
    --qwen3_tts_backend ggml \
    --qwen3_tts_non_streaming_mode True \
    --qwen3_tts_mlx_quantization 6bit \
    --model_name gpt-5.4-mini \
    --chat_size 30 \
    --responses_api_stream \
    --enable_live_transcription \
    --mode realtime
默认模型是通过 OpenAI Responses API 的 gpt-5.4-mini。使用 --model_name 覆盖,并使用 --responses_api_base_url 指向另一个 OpenAI 兼容提供商或服务器。
本地 Mac
speech-to-speech --local_mac_optimal_settings
可选地指定 LLM:
speech-to-speech \
    --local_mac_optimal_settings \
    --model_name mlx-community/Qwen3-4B-Instruct-2507-bf16
该设置:
- 添加
--device mps以对所有模型使用 MPS。 - 为 STT 设置 Parakeet TDT。
- 将 MLX LM 设置为 LLM 后端。
- 为 TTS 设置 Qwen3-TTS,默认使用
mlx-audio及6bitMLX 变体。 - 设置
--mode local。
--tts pocket 和 --tts kokoro 在 macOS 上同样有效。
要在本地比较 MLX 量化变体:
python scripts/benchmark_tts.py \
    --handlers qwen3 \
    --iterations 3 \
    --qwen3_mlx_quantizations bf16 4bit 6bit 8bit
WebSocket
以 WebSocket 模式运行流水线:
speech-to-speech --mode websocket --ws_host 0.0.0.0 --ws_port 8765客户端连接到
ws://<server-ip>:8765。发送原始音频字节(16 kHz、int16、单声道 PCM),接收生成的音频字节。
TCP Socket
TCP socket 模式特意保持最小化。它流式传输原始 PCM 音频,但不提供完整的 Realtime API 功能集,包括中断处理、实时转录事件或工具调用事件。
在服务器上运行流水线:
speech-to-speech --mode socket --recv_host 0.0.0.0 --send_host 0.0.0.0在本地运行客户端以处理麦克风输入和播放:
python scripts/listen_and_play.py --host <IP address of your server>
Docker
安装 NVIDIA Container Toolkit,然后:
docker compose up
Compose 文件启动一个带有 Gemma 4 的 llama.cpp 服务器,启动 TCP socket 服务器,并暴露端口 8080、12345 和 12346。
Realtime API
Realtime 模式通过 WebSocket 使用 OpenAI Realtime 协议流式传输音频,支持实时转录和低延迟话轮转换。服务器暴露 /v1/realtime,任何兼容 OpenAI Realtime 的客户端均可连接:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8765/v1",
    websocket_base_url="ws://localhost:8765/v1",
    api_key="not-needed",
)

with client.realtime.connect(model="local") as conn:
    conn.send(
        {
            "type": "session.update",
            "session": {
                "type": "realtime",
                "instructions": "You are a helpful assistant.",
                "audio": {
                    "input": {
                        "turn_detection": {
                            "type": "server_vad",
                            "interrupt_response": True,
                        }
                    }
                },
            },
        }
    )

    for event in conn:
        print(event.type)
服务器实现了核心 Realtime 事件集:入站事件包括 input_audio_buffer.append、session.update、conversation.item.create、response.create 和 response.cancel;出站事件包括语音开始/停止、流式转录、音频增量、工具调用和 response.done。完整的事件参考、架构和设计细节位于 Realtime Engine README。
LLM 后端
LLM 是流水线中计算量最大、延迟最高的组件。对大模型进行一次前向传播可能会主导端到端的响应时间,因此根据你的硬件和延迟预算选择正确的后端非常重要。该流水线支持:
- 本地推理:CUDA/CPU 上的
transformers和 Apple Silicon 上的mlx-lm。 - 自托管服务器:
responses-api和chat-completions可以指向本地 vLLM 或 llama.cpp 服务器。 - 提供商 API:相同的后端适用于 OpenAI、HF Inference Providers、OpenRouter 和其他 OpenAI 兼容的提供商。
提供两个 API 后端,共享相同的 --responses_api_* 连接标志:
--llm_backend responses-api(默认)指向/v1/responses。--llm_backend chat-completions指向/v1/chat/completions。
下面的示例将本地 STT 的 Parakeet TDT 和本地 TTS 的 Qwen3-TTS 与不同的 LLM 后端配对。
Responses API 后端
适用于任何实现 OpenAI Responses API 的提供商或服务器。将 --responses_api_base_url 指向端点,并相应设置 --model_name:
| 提供商 / 服务器 | --responses_api_base_url |
--responses_api_api_key |
|---|---|---|
| OpenAI | 省略,使用 OpenAI 默认值 | $OPENAI_API_KEY |
| HF Inference Providers | https://router.huggingface.co/v1 |
$HF_TOKEN |
| OpenRouter | https://openrouter.ai/api/v1 |
$OPENROUTER_API_KEY |
| vLLM | http://localhost:8000/v1 |
省略或任意字符串 |
| llama.cpp | http://127.0.0.1:8080/v1 |
空字符串 |
# OpenAI
speech-to-speech \
    --mode local \
    --stt parakeet-tdt \
    --llm_backend responses-api \
    --tts qwen3 \
    --qwen3_tts_mlx_quantization 6bit \
    --model_name "gpt-4o-mini" \
    --responses_api_api_key "$OPENAI_API_KEY" \
    --responses_api_stream \
    --enable_live_transcription
# HF Inference Providers:通过 Together 的 Qwen3.5-9B
speech-to-speech \
    --mode local \
    --stt parakeet-tdt \
    --llm_backend responses-api \
    --tts qwen3 \
    --qwen3_tts_mlx_quantization 6bit \
    --model_name "Qwen/Qwen3.5-9B:together" \
    --responses_api_base_url "https://router.huggingface.co/v1" \
    --responses_api_api_key "$HF_TOKEN" \
    --responses_api_stream \
    --enable_live_transcription
# HF Inference Providers:通过 Groq 的 GPT-oss-20B
speech-to-speech \
    --stt parakeet-tdt \
    --llm_backend responses-api \
    --tts qwen3 \
    --qwen3_tts_mlx_quantization 6bit \
    --model_name "openai/gpt-oss-20b:groq" \
    --responses_api_base_url "https://router.huggingface.co/v1" \
    --responses_api_api_key "$HF_TOKEN" \
    --responses_api_stream \
    --enable_live_transcription
Chat Completions 后端
配置与 responses-api 相同,重用相同的 --responses_api_* 连接标志,但连接到 /v1/chat/completions 而非 /v1/responses。在以下情况下推荐使用:
- 提供商在 Responses 路径上忽略
chat_template_kwargs.enable_thinking,并且需要reasoning_effort旋钮来抑制推理链,或 - 服务器的 Responses 流式工具调用路径不可靠,而其 Chat Completions 流式工具调用健壮。这对于某些 vLLM 构建很有用;参见 #312。
添加 --responses_api_reasoning_effort none 以在聊天模板标志无效的提供商上禁用推理:
# 提供 Qwen 模型并支持工具调用的 vLLM
speech-to-speech \
    --mode realtime \
    --stt parakeet-tdt \
    --llm_backend chat-completions \
    --tts qwen3 \
    --model_name "Qwen/Qwen3-4B-Instruct-2507" \
    --responses_api_base_url "http://localhost:8000/v1" \
    --responses_api_stream
# 通过 HF router 在 Cerebras 上运行 Gemma 4 31B,禁用推理以实现低语音延迟
speech-to-speech \
    --mode realtime \
    --stt parakeet-tdt \
    --llm_backend chat-completions \
    --tts qwen3 \
    --model_name "google/gemma-4-31B-it:cerebras" \
    --responses_api_base_url "https://router.huggingface.co/v1" \
    --responses_api_api_key "$HF_TOKEN" \
    --responses_api_reasoning_effort none \
    --responses_api_stream
完全本地
在单独的 llama.cpp 进程中运行 LLM,以获得阻力最小的完全本地设置,如 Reachy Mini local conversation guide 所示:
# 终端 1:提供 Gemma 4 服务的 llama.cpp
llama-server -hf ggml-org/gemma-4-E4B-it-GGUF -np 2 -c 65536 -fa on --swa-full
# 终端 2:使用该本地 LLM 服务器的 speech-to-speech
speech-to-speech \
    --mode realtime \
    --stt parakeet-tdt \
    --llm_backend responses-api \
    --tts qwen3 \
    --model_name "ggml-org/gemma-4-E4B-it-GGUF" \
    --responses_api_base_url "http://127.0.0.1:8080/v1" \
    --responses_api_api_key "" \
    --responses_api_stream \
    --enable_live_transcription
当你希望直接通过运行服务器的机器进行对话时,可以使用 --mode local 代替 --mode realtime。进程内本地后端仍然可用:Apple Silicon 上使用 --llm_backend mlx-lm,或 CUDA/CPU 上使用 --llm_backend transformers。
多语言支持
语言覆盖范围取决于你选择的 STT 和 TTS 后端,而非流水线本身:
| 组件 | 后端 | 语言 |
|---|---|---|
| STT | Parakeet TDT(默认) | 25 种欧洲语言 |
| STT | Whisper / Whisper MLX / Faster Whisper | 广泛的多语言覆盖,取决于所选 Whisper 检查点 |
| STT | Paraformer | 取决于所选 FunASR 检查点;默认以中文为主 |
| TTS | Qwen3-TTS(默认) | 多语言,默认 --qwen3_tts_language auto |
| TTS | Kokoro | 多种语言/语音映射,取决于后端可用性 |
| TTS | ChatTTS | 英语和中文 |
| TTS | MMS TTS | 通过 MMS 检查点实现广泛的多语言覆盖 |
确保你配对的 STT、LLM 和 TTS 都覆盖你的目标语言。两种使用模式:
- 单一语言:将
--language设置为目标语言代码。默认为en。 - 语言切换:设置
--language auto。STT 检测每个语音提示的语言,并将其转发给 LLM。可选地添加--enable_lang_prompt,以附加一条“请用...回复我的消息”的指令。默认为False;大型 LLM 通常从上下文中推断语言,但显式指令可以帮助较小的模型。
自动语言检测:
speech-to-speech \
    --stt parakeet-tdt \
    --language auto \
    --llm_backend mlx-lm \
    --model_name "mlx-community/Qwen3-4B-Instruct-2507-bf16"
单一非英语语言(本例为中文):
speech-to-speech \
    --stt whisper-mlx \
    --stt_model_name large-v3 \
    --language zh \
    --llm_backend mlx-lm \
    --model_name mlx-community/Qwen3-4B-Instruct-2507-bf16
两个命令也可在 --local_mac_optimal_settings 基础上使用;显式的 --stt 标志会覆盖其设置的默认值。
Pocket TTS
Kyutai Labs 的 Pocket TTS 提供带有语音克隆的流式 TTS:
speech-to-speech \
    --tts pocket \
    --pocket_tts_voice jean \
    --pocket_tts_device cpu
可用的语音预设:alba、marius、javert、jean、fantine、cosette、eponine、azelma。自定义语音文件和 Hugging Face 路径也可用。
CLI 参考
所有 CLI 参数的参考信息位于 arguments classes 和 speech-to-speech -h 中。
模块级参数
参见 ModuleArguments。它可以设置:
- 公共的
--device,如果每个部分应在同一设备上运行 --mode:realtime(默认)、local、socket或websocket- STT 实现(
--stt) - LLM 后端(
--llm_backend:transformers、mlx-lm、responses-api或chat-completions) - TTS 实现(
--tts) - 日志级别
- 实时流水线池大小(
--num_pipelines)
VAD 参数
参见 VADHandlerArguments。值得注意的选项:
--thresh:触发语音活动检测的阈值。--min_speech_ms:被认定为语音的检测到语音活动的最小持续时间。--min_speech_continuation_ms:对于在重新打开窗口内继续一个可重新打开的软结束、未提交话轮的语音,维持磁滞阈值。默认且推荐的配对为--min_speech_ms 384 --min_speech_continuation_ms 192。--min_silence_ms:用于分割语音的静音间隔最小长度。默认值 64 ms。--short_segment_merge_ms:可选合并窗口,用于缝合每个都短于--min_speech_ms的相邻 VAD 片段。--unanswered_reopen_ms:一个限制上限,用于控制一个尚未收到任何助手输出的软结束推测性话轮保持可重新打开状态的最长时间。
STT、LLM 和 TTS 参数
每个 STT、LLM 和 TTS 实现都暴露了 model_name、torch_dtype 和 device。STT 和 TTS 参数使用处理程序前缀,例如 --stt_model_name 或 --qwen3_tts_device。LLM 模型选择和聊天设置通过不带前缀的标志在所有后端间共享,例如 --model_name 和 --chat_size;后端特定标志对于 responses-api 和 chat-completions 后端使用 responses_api_ 前缀,对于本地后端使用 llm_ 前缀。
例如:
# 本地 transformers/mlx-lm 后端
--model_name google/gemma-2b-it

# OpenAI 兼容后端
--llm_backend responses-api --model_name deepseek-chat --responses_api_base_url https://api.deepseek.com
生成参数
其他生成参数可以使用处理程序前缀加上 _gen_ 设置,例如 --stt_gen_max_new_tokens 128 或 --llm_gen_temperature 0.7。尚未暴露的参数可以添加到相关的参数类中。
贡献
欢迎提交 Issue 和 PR。一个很好的起点是 open issues。对于较大改动,请先开 issue 讨论方法。
本地开发:
uv sync
pytest
ruff check
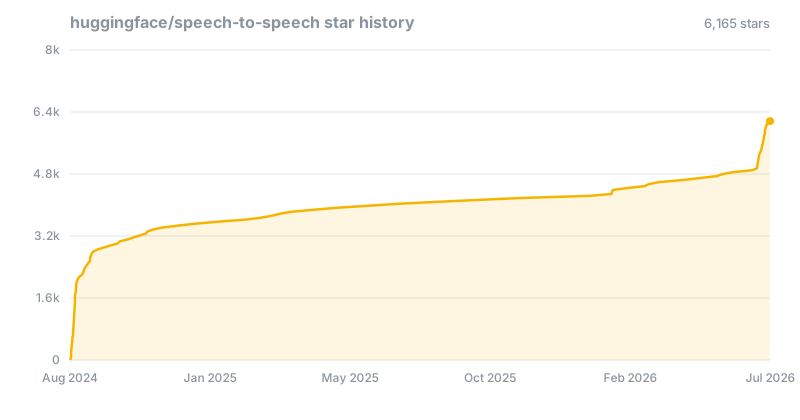
星标历史
引用
如果你使用了该流水线,请同时引用你运行的组件模型。默认组件如下:
Silero VAD
@misc{SileroVAD,
  author = {Silero Team},
  title = {Silero VAD: pre-trained enterprise-grade Voice Activity Detector (VAD), Number Detector and Language Classifier},
  year = {2021},
  publisher = {GitHub},
  journal = {GitHub repository},
  howpublished = {\url{https://github.com/snakers4/silero-vad}},
  email = {hello@silero.ai}
}
Parakeet TDT
@misc{parakeet-tdt,
  author = {NVIDIA},
  title = {Parakeet TDT 0.6B v3},
  publisher = {Hugging Face},
  howpublished = {\url{https://huggingface.co/nvidia/parakeet-tdt-0.6b-v3}}
}
Qwen3-TTS
@misc{qwen3-tts,
  author = {Qwen Team},
  title = {Qwen3-TTS},
  publisher = {Hugging Face},
  howpublished = {\url{https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-CustomVoice}}
}
可选后端(如 Kokoro、Pocket TTS、ChatTTS、Whisper 变体、Paraformer 和 MMS)的引用位于各自的 component READMEs 中。