cs249rbook

哈佛大学开放的机器学习系统教科书与配套课程资源,系统讲解从单机训练到分布式推理的ML工程原理。包含两卷教材、从零构建框架的TinyTorch、交互式实验、硬件部署套件和基础设施模拟器,形成完整的“读-探-建-模-部-练-教”学习闭环。亮点在于它填补了模型设计与系统工程之间的鸿沟,强调定量的物理约束(带宽、功耗、延迟)而非纯工具操作,适合ML infra工程师、学生和教育者系统提升工程判断力。
README
机器学习系统
工程人工智能系统的原则与实践


📘 教科书 • 📗 卷 I + 📘 卷 II • 🔥 TinyTorch • 🔬 实验 • 🔮 MLSys·im • 💼 StaffML
📚 纸质版将于 2026 年由 MIT Press 出版。
使命
世界正在急于构建 AI 系统,却没有在工程化它们。
这个差距正是我们所说的 AI 工程。
AI 工程是一门构建在现实世界中运行的高效、可靠、安全且鲁棒的智能系统的学科,而不仅仅是孤立的模型。 我们的使命是通过教授如何设计、构建和评估端到端的智能系统,将 AI 工程确立为与软件工程和计算机工程并列的基础学科。
我们的目标: 今年帮助 10 万学习者 掌握 ML Systems,并到 2030 年达到 100 万。
为什么是一个仓库
我将其设计为一个统一的课程体系,而不是独立项目的集合。教科书讲授理论。TinyTorch 让你构建内部机制。硬件套件迫使你面对真实的约束。模拟器让你能够推理你租不起的基础设施。每个组件存在的理由是我发现只阅读的学生无法内化,只编程的学生无法泛化。
这个仓库就是课程。
一个不断壮大的贡献者社区帮助改进其中的每个部分:修正错误、打磨解释、在新硬件上测试。他们的工作让这一切对每个人都更好,我感谢每一个 pull request。
课程体系
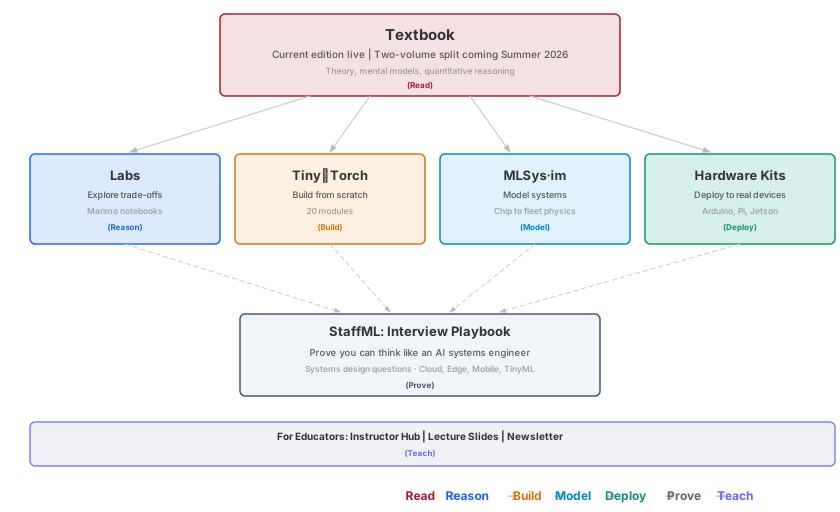
每个组件都相互连接。教科书为你提供思维模型。实验让你通过交互式推理来权衡取舍——由 MLSys·im 驱动,它是一个你无法物理访问的基础设施的建模引擎,同时也是独立工具。TinyTorch 让你自己构建机器。硬件套件让你直面真实部署约束。StaffML 测试你是否真正理解。Socratiq 在学习体验中增加了 AI 引导阅读、上下文测验和间隔重复。而讲师中心、幻灯片和新闻通讯则为教育工作者提供了将这一切带入课堂所需的一切。
面向学生
| 组件 | 在课程中的角色 | 链接 | |
|---|---|---|---|
| 📖 | 教科书 | MIT Press 两卷本教科书。理论、思维模型和定量推理——其他一切都建立于此。 | 卷 I · 卷 II |
| 🔬 | 实验 | 交互式 Marimo 笔记本,你可以探索教科书中的权衡:改变一个参数,看看什么会坏,建立直觉。底层由 MLSys·im 提供支持。 | 启动实验 · 仓库指南 |
| 🔥 | Tiny🔥Torch | 从零开始,通过 20 个逐步模块构建你自己的 ML 框架。只有亲手构建一个系统,你才能真正理解它。 | 开始 |
| 🛠️ | 硬件套件 | 将 ML 部署到 Arduino、Seeed、Grove 和 Raspberry Pi 设备上。真实的内存限制、真实的功耗预算、真实的延迟。 | 浏览实验 |
| 🔮 | MLSys·im | 在你无法物理访问的基础设施规模下,计算内存瓶颈、网络饱和和调度限制。 | 使用模拟器 · 仓库指南 |
| 💼 | StaffML | 基于物理的 ML 系统面试题。题库、练习、模拟面试和进度追踪。 | 练习 · 仓库指南 |
面向教育工作者
| 组件 | 提供的资源 | 链接 | |
|---|---|---|---|
| 🎓 | 讲师中心 | AI 工程蓝图:两份 16 周教学大纲、教学法指南、评估量表和助教手册。 | 查看中心 · 仓库指南 |
| 🎬 | 讲座幻灯片 | 每章的 Beamer 幻灯片,四种主题变体。直接放入你的课程即可教学。 | 浏览幻灯片 · 仓库指南 |
| 📬 | 新闻通讯 | 课程更新、新章节以及社区正在构建的内容。 | 订阅 |
选择你的路径
这些组件设计为协同工作,但你不需要一下子全部采纳。
| 如果你是... | 从这里开始 | 然后深入 |
|---|---|---|
| 学生或自学者 | 阅读卷 I 并尝试实验 00 | 构建 TinyTorch,使用 MLSys·im,并用 StaffML 练习 |
| 教育工作者 | 打开 AI 工程蓝图 | 使用课程地图、幻灯片、量表和助教指南 |
| 贡献者 | 选择你最常用的组件 | 改进章节、实验、测试、示例、硬件说明、模拟器模型或评估内容 |
学习循环是:阅读 → 探索 → 构建 → 建模 → 部署 → 练习 → 教学。
相邻及实验性工作
有些项目比主课程处于更早期的阶段:
- Socratiq 探索了 AI 引导阅读、上下文测验和静态学习网站的间隔重复。
- MLPerf EDU 是一个在建的教学基准套件,与 MLCommons MLPerf 对齐。
- ML Systems Design Grammar 是一个实验性框架,用于从稳定原语、约束和重写规则进行推理。
你将学到什么
这本教科书教会你在机器学习与系统工程交叉点上的思考方式。每一章都将算法概念与使它们在实践中工作的基础设施联系起来。
| 你已经知道... | 你将学到... | |
|---|---|---|
| 如何训练一个模型 | → | 训练如何在 GPU 集群上扩展 |
| 量化可以缩小模型 | → | INT8 数学如何映射到硅片上 |
| 什么是 Transformer(自注意力架构) | → | 为什么 KV-cache 在推理时主导内存 |
| 模型在 GPU 上运行 | → | 调度器如何平衡延迟与吞吐量 |
| 边缘设备有局限性 | → | 如何协同设计模型和硬件 |
书籍结构
教科书遵循 Hennessy & Patterson 的教学模式,分为两卷:
| 卷 | 主题 | 范围 | |
|---|---|---|---|
| 📗 | 卷 I | 构建、优化、部署 | 单机 ML 系统(1–8 GPU)。单节点上的基础、优化和部署。 |
| 📘 | 卷 II | 扩展、分发、治理 | 生产规模下的分布式系统。多机基础设施、容错和治理。 |
常见问题
这本书是为谁准备的,我需要先知道什么?这本书面向任何想要工程化智能系统的人,而不仅仅是训练模型:学生、转向 ML 基础设施的在职工程师,以及正在构建课程的教育工作者。我们假设你能够用 Python 编程,并了解基本的机器学习概念,但本书从零开始构建系统概念。你不需要有计算机架构、分布式系统或数据中心运营的背景。卷 I 从基础开始,课程的其他部分(TinyTorch、实验、硬件套件和模拟器)让你通过构建而不是仅仅阅读来学习。
我需要先读卷 I 再读卷 II 吗?它们有什么区别?两卷的区别在于范围,而不是深度。两者同样严谨。卷 I 是单机世界:一个 ML 系统如何在单节点上使用少量加速器工作——从数据和单个神经元的计算到训练、优化和部署。卷 II 是规模化世界:跨越网络的多台机器、分布式训练、容错、集群编排、规模化推理和治理。卷 II 不假定你已经阅读了卷 I,所以如果你已有基础,可以直接从那里开始。不过,自然的路径是先通过卷 I 建立思维模型,然后在卷 II 中应用这些模型到整个集群。我们遵循的类比是 Hennessy 和 Patterson:先读《计算机组成与设计》,再读《计算机架构:量化方法》。
我必须使用 TinyTorch、实验和套件吗,还是只读书就行?你可以只读书。每卷都是独立的。课程的其他部分(TinyTorch、实验、硬件套件、模拟器和面试练习)的存在是为了加深书中所教的内容,让你通过构建和测量来学习,但没有任何部分是理解正文所必需的。从书开始,当你想要将一个概念变成肌肉记忆时,再使用动手实践的部分。
这不就是一本深度学习书吗?深度学习书籍(Goodfellow 等人的《深度学习》、Bishop、d2l.ai、fast.ai)教你设计和训练模型:架构、优化和学习的数学。它们大多止步于模型。这本教材从它们停止的地方开始。它将模型视为系统内部的一个组件,这个系统需要摄取数据、在功耗和延迟预算下运行在真实的硅片上、可靠地提供预测,并在世界变化时持续工作。你可以完成一门深度学习课程,知道 Transformer 如何学习,但仍然不知道为什么它在 4000 个加速器的训练运行中停顿、KV cache 对你的服务内存做了什么,或者为什么你的加速器闲置着。这个差距就是我们教授的内容。从深度学习文本中学习模型,然后在这里学习系统。
这不就是 MLOps 吗,或者和《Designing Machine Learning Systems》一样?这是最常见的混淆,因为“ML 系统”和“MLOps”听起来可以互换,而且几本优秀的实战书籍也共享这些词汇。MLOps 书籍是操作指南:如何使用现有工具连接特征存储、流水线和部署。它们很有价值,并随着工具的发展而老化。这本教材教授的是底层原理:解释为什么这些工具存在以及它们代价的物理学和定量推理。我们问哪些问题重要,为什么设计是现在这个样子,以及它无法逃避什么(带宽、延迟、功耗、故障率)。
想想按照菜谱做饭和理解烹饪原理之间的区别。菜谱为你提供一道菜的确切步骤:这个温度、这个锅、这些分钟。它在烤箱、食材或厨房发生变化之前都能完美工作。理解为什么热量、盐、酸和时间能改变食物则不同。它让你能在任何厨房里做饭,挽救一个出问题的菜,并发明一个没有菜谱覆盖的新菜。
一本 MLOps 书籍为你提供了今天这个技术栈的菜谱。这本教材教授底层的科学,这样你就能推理任何技术栈,调试那个出问题的技术栈,并设计那个还不存在的技术栈。
这与经典的系统参考书如《The Datacenter as a Warehouse-Scale Computer》有什么不同?Barroso、Hölzle 和 Clidaras 的《数据中心即仓库规模计算机》这样的参考书非常优秀。它们提炼了一个组织如何工程化一个规范系统,由构建它的人编写。这个项目是一种不同的制品,两者是互补而非竞争的。
课程,而非参考书。 一次综合性的讲座为一个领域内从业者记录了一个完成的设计。这本教材从头开始教授这门学科,包含学习目标、定量工作示例、实验和 AI 导师,并将读者从单个神经元(卷 I)一直带到仓库规模集群(卷 II)。
厂商中立,而非单一技术栈。 一份厂商参考书可以说“这是我们怎么做的”并引用真实生产数据。我们跨加速器(GPU 和 TPU)、跨云端和边缘进行泛化,并教授为什么设计是现在这个样子,这样推理就能经受住下一代硬件的考验,并适用于任何地方。
活的,而非快照。 印刷版本在下一次修订之前是固定的。这是开源的、持续更新的,周围环绕着你亲手构建的代码(TinyTorch)、硬件套件、模拟器和面试练习。
简而言之,一份仓库规模参考书告诉你一个机器是如何建造的。这个课程教会你推理为什么,并培养设计下一个机器的判断力。
在大语言模型时代为什么还要读教科书?因为教科书提供了一些大语言模型没有的东西:视角。大语言模型擅长检索,我们不试图在检索上竞争。如果一个段落只提供一个你通过问模型就能更快得到的事实,那它就没有存在的价值。一本书构建的是一个结构化的思维模型,按正确顺序,判断哪些问题重要,以及设计为何如此及其代价背后的推理。这很大程度上来自于教科书选择省略什么,因为决定什么是核心、什么是外围本身就是百科式事实堆砌无法教授的一课。
Bruce Davie 在《Systems Approach》的"Textbooks in Tokenland"中很好地阐述了这一点:大语言模型生成的文本没有以交际意图为基础,而教科书是由试图向读者传达世界模型的人编写的。我们同意这一点,并且我们更进一步,在阅读体验中构建了一个 AI 导师(SocratiQ)。目标不是教科书 vs 大语言模型。一本好书给你提出问题所需的视角,大语言模型帮助你回答它们。各自发挥自己的优势。
它是免费的吗,我如何阅读?是的。两卷都可以在 mlsysbook.ai 免费在线阅读,教科书在 Creative Commons 许可(CC BY-NC-SA 4.0)下开源,因此你可以为了非商业目的共享和改编它,并注明出处。如果你喜欢印刷版,纸质版将于 2026 年由 MIT Press 出版。周围的工具也是开源的,每个都有自己的许可。
快速开始
① |
阅读教科书。从 卷 I 开始,或者继续到 卷 II。这是其他一切的基础。 |
② |
选择一条动手实践路径。构建一个框架(TinyTorch),探索权衡(实验),建模约束(MLSys·im),或部署到真实硬件(套件)。 |
③ |
自我测试。练习 StaffML:基于物理的系统设计问题,涵盖云端、边缘、移动和 TinyML。 |
④ |
教这门课。使用 AI 工程蓝图和讲座幻灯片采用该课程。 |
分支指南
[!NOTE] 你当前在
dev分支。 活跃开发在此进行。有关最后一个稳定版本,请参见main分支。
| 分支 | 包含内容 | 状态 | |
|---|---|---|---|
| 🟢 | mainmlsysbook.ai |
单卷教科书(当前版本) | 线上——这是读者今天看到的内容。 |
| 🟡 | dev← 你在这里 |
卷 I — 两卷拆分(内容已完成,编辑润色中) 卷 II — 规模化(活跃开发中) 课程 — TinyTorch、套件、MLSys·im、实验、StaffML |
TinyTorch 和硬件套件已上线。 MLSys·im、实验和 StaffML 处于早期发布阶段,正在积极迭代。 |
两卷拆分将在发布时取代单卷版。
支持这项工作
|
给仓库点星 星标向大学和基金会传达这项工作很重要。它们直接资助针对欠发达课堂的讲习班和硬件套件。 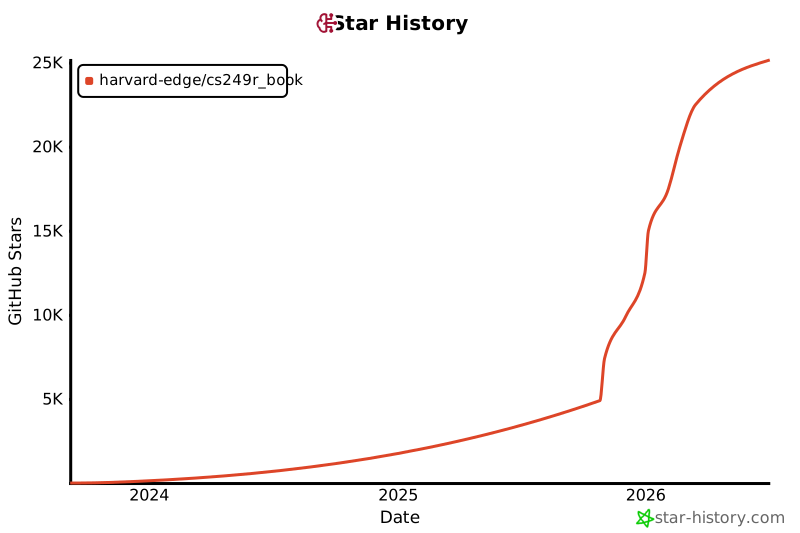 100 → 1,000 → 10,000 → 100,000 → 到 2030 年 100 万学习者 |
资助使命 所有捐款都进入 Open Collective,一个用于教育推广的透明基金。每一美元都用于接触更多学生。 
|
贡献
| 我想... | 前往这里 | |
|---|---|---|
| 📖 | 修正拼写错误或改进章节 | 教科书贡献指南 |
| 🔥 | 添加 TinyTorch 模块或修复 bug | TinyTorch 贡献指南 |
| 🛠️ | 改进硬件实验 | 硬件套件指南 |
| 🔬 | 改进交互式实验或模拟器模型 | 实验指南 · MLSys·im 指南 |
| 💼 | 改进评估或职业准备内容 | StaffML 指南 · 测验刷新指南 |
| 🧠 | 改进 AI 学习工具 | Socratiq 指南 |
| 🐛 | 报告问题 | GitHub Issues |
| 💬 | 提问 | GitHub Discussions |
许可证
这是多组件仓库,每个组件根据其目的使用自己的许可证发布。每个目录内的文件(例如 tinytorch/LICENSE、interviews/staffml/LICENSE)具有权威性。
| 组件 | 许可证 | 含义 |
|---|---|---|
教科书 (book/)、实验 (labs/)、套件 (kits/)、幻灯片 (slides/)、讲师 (instructors/) |
CC-BY-NC-SA 4.0 | 可以出于非商业目的共享和改编,需注明出处并以相同许可证共享。 |
| TinyTorch | MIT | 宽松许可——可以使用、修改、重新分发,包括商业用途。 |
| MLSys·im | Apache 2.0 | 宽松许可,包含明确的专利授权。 |
| StaffML | AGPL v3 | 强 Copyleft——对部署服务的修改必须公开。商业许可可用;请联系作者。 |
| StaffML 问题语料库 | CC BY-NC 4.0 | 研究和教育用途;商业使用需获得许可。 |
| [TinyDigits 数据集](tin |
[原 README 过长已截断]