VoiceStudio
本地优先的开源语音创作套件,覆盖声音克隆、视频配音、听写、转录和有声书生成,内置16个TTS和11个ASR引擎,支持646种语言。亮点是桌面应用加 OpenAI 兼容 API 与 MCP Server,所有处理默认留在本机,可作为 ElevenLabs 的本地替代方案,社区热度高(今日新增 745 stars)。注意应用本身是 AGPL-3.0,默认模型权重和 tokenizer 各有上游条款,商用前需确认。
README

VoiceStudio
前身为 OmniVoice-Studio
在自己的硬件上克隆声音、为视频配音、听写并制作长音频。
16 种 TTS 引擎 · 11 种 ASR 引擎 · 646 种语言目录 · macOS、Windows、Linux 和 Docker
本地工作流无需账户、API 密钥、订阅或用量计费。
安装 · 功能 · 对比 · 系统要求 · 引擎 · 架构 · API · 文档 · 简体中文



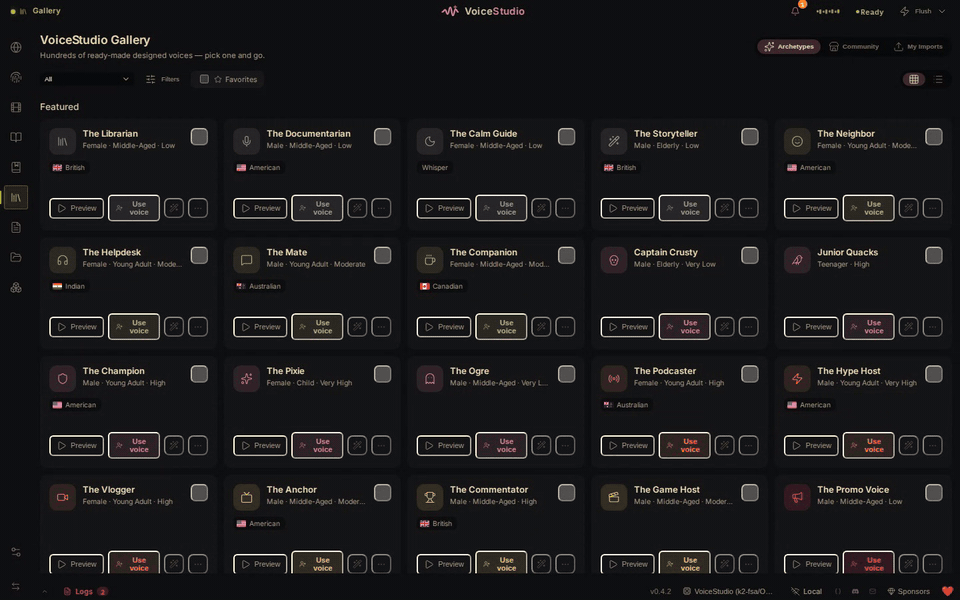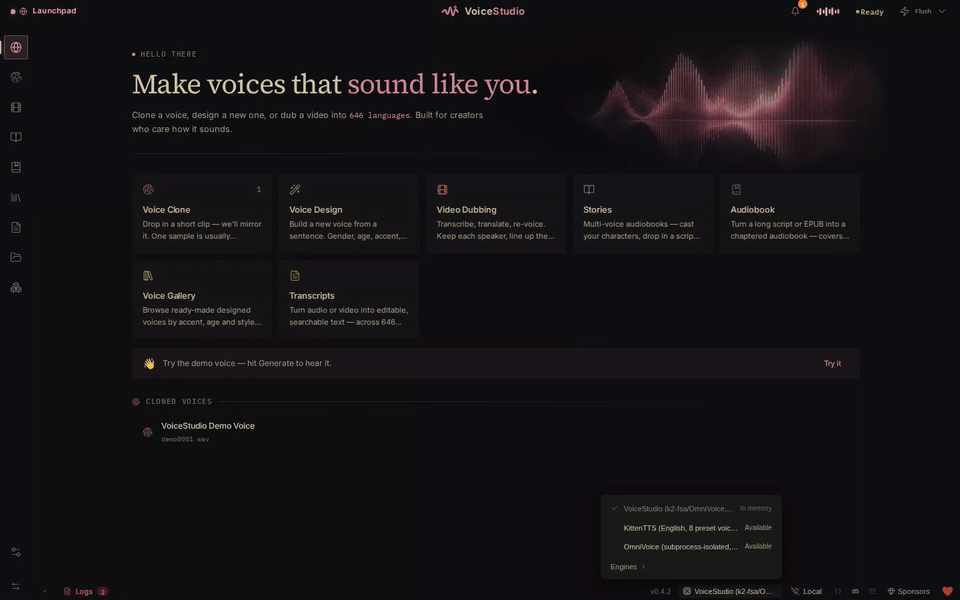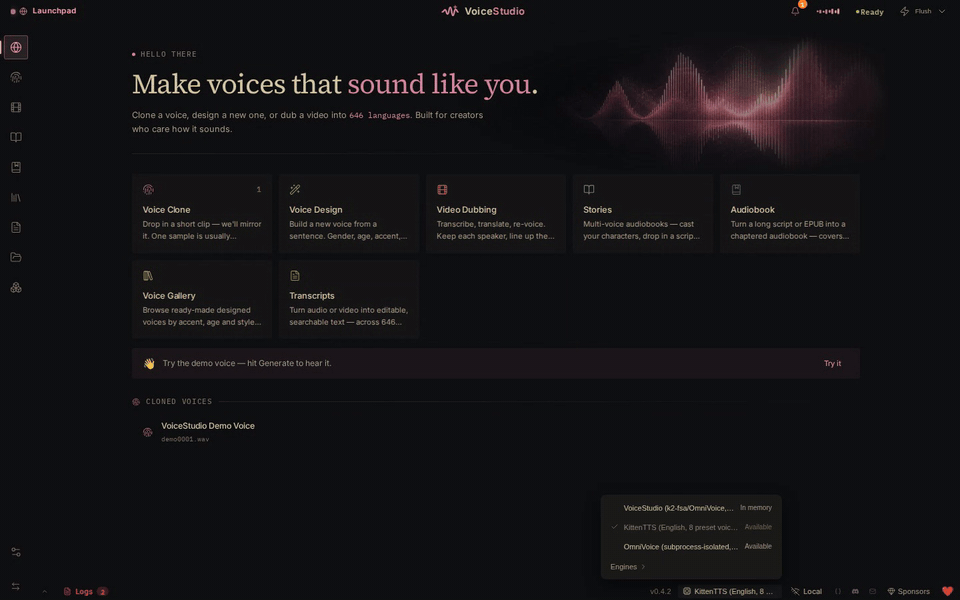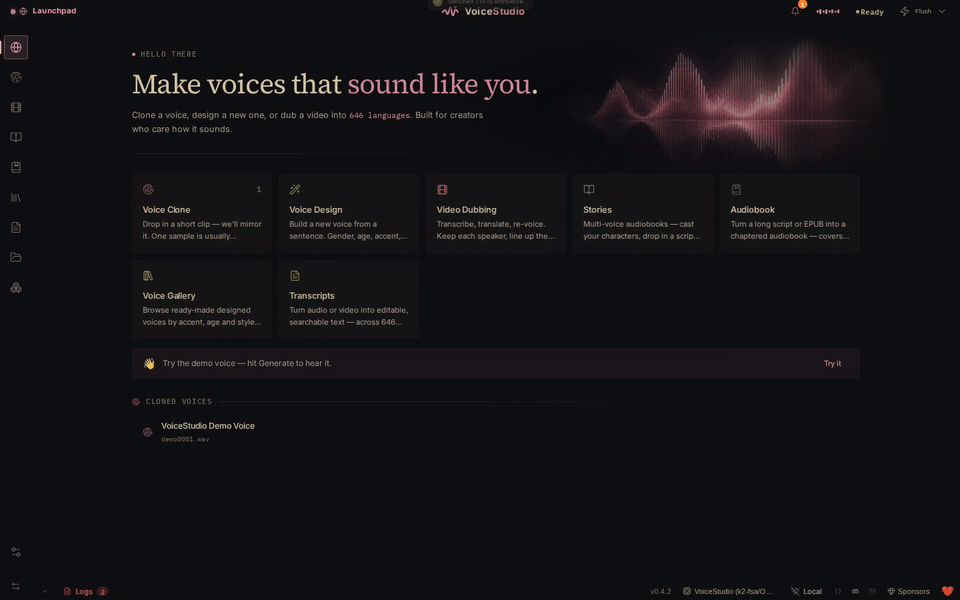
[!WARNING] 积极测试阶段。 请使用最新发布版进行稳定工作。
main分支包含最新修复,可能在版本之间发生变化。通过 GitHub Issues 报告问题。
概览
| VoiceStudio | |
|---|---|
| 工作流 | 声音克隆与设计、视频配音、听写、故事、有声书、批量生成 |
| 语言目录 | 646 种 TTS 语言;实际覆盖范围和质量取决于所选引擎 |
| 引擎 | 16 种 TTS · 11 种 ASR · 在模型目录中切换,或使用 Ctrl/Cmd+E |
| 平台 | Apple Silicon 上的 macOS 13.3+ · Windows 10/11 x64 · 带 glibc 2.39+ 的 Linux x86_64 |
| 算力 | CUDA · Apple Silicon MPS/MLX · Linux 上的 ROCm · CPU · 可选的远程工作节点 |
| 接口 | 桌面应用 · 本地 REST/SSE/WebSocket API · OpenAI 兼容音频 API · MCP 服务器 |
| 存储 | 语音、项目、设置和输出默认保留在本地机器上 |
| 许可证 | AGPL-3.0 应用;下载的模型保留其上游条款 |
安装
从最新发布版下载安装包,然后按照平台指南操作。
| 平台 | 安装包 | 指南 |
|---|---|---|
| macOS 13.3+ | Apple Silicon DMG | 在 macOS 上安装 |
| Windows 10/11 | x64 MSI;如列表中有当前用户构建版本,可选择该版本以无需管理员权限安装 | 在 Windows 上安装 |
| Linux | AppImage,x86_64,glibc 2.39+ | 在 Linux 上安装 |
| Docker | CUDA、ROCm、CPU 和仅工作节点 GPU 配置 | 使用 Docker 运行 |
首次启动会创建托管的 Python 环境并下载默认模型。后续启动会复用两者。
[!NOTE] 在 macOS 上,首次启动需要一次性右键单击,然后选择打开。Intel Mac 无法运行本地 Python 后端;请改用远程后端。
第一个声音
- 启动 VoiceStudio,打开声音克隆。
- 添加一段干净的语音样本。三秒即可;5 到 15 秒通常能提供更好的提示。
- 输入文本,选择语言,然后点击生成。
从源码运行
安装开发前置依赖,然后:
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio
bun install
bun run desktop
使用 bun run dev 运行浏览器界面。服务、测试和平台安装包请参阅贡献指南。
如果安装失败
- 运行设置 → 关于 → 运行自检或
uv run python backend/main.py --diagnose --deep。 - 查看安装故障排查。
- 提交 issue 时,请从应用中保存一份脱敏的诊断包。
- 生成速度慢时,请对比实测基准和性能设置。
功能
| 领域 | 包含内容 |
|---|---|
| 声音克隆 | 从短参考片段进行零样本合成 |
| 声音设计 | 根据年龄、口音、音高、风格和表达指令创建声音 |
| 视频配音 | 转写、翻译、保留说话人、合成并导出视频 |
| 故事与有声书 | 多角色脚本 · EPUB/PDF 导入 · 分章渲染 · .m4b 导出 |
| 听写小部件 | 系统级快捷键、实时转写、可选的本地 LLM 清洗 |
| 人声分离 | Demucs 语音/背景分离 |
| 说话人分离 | Pyannote 和 WhisperX 说话人分配 |
| 批量队列 | 排队处理大批量音频和视频任务,支持逐任务进度 |
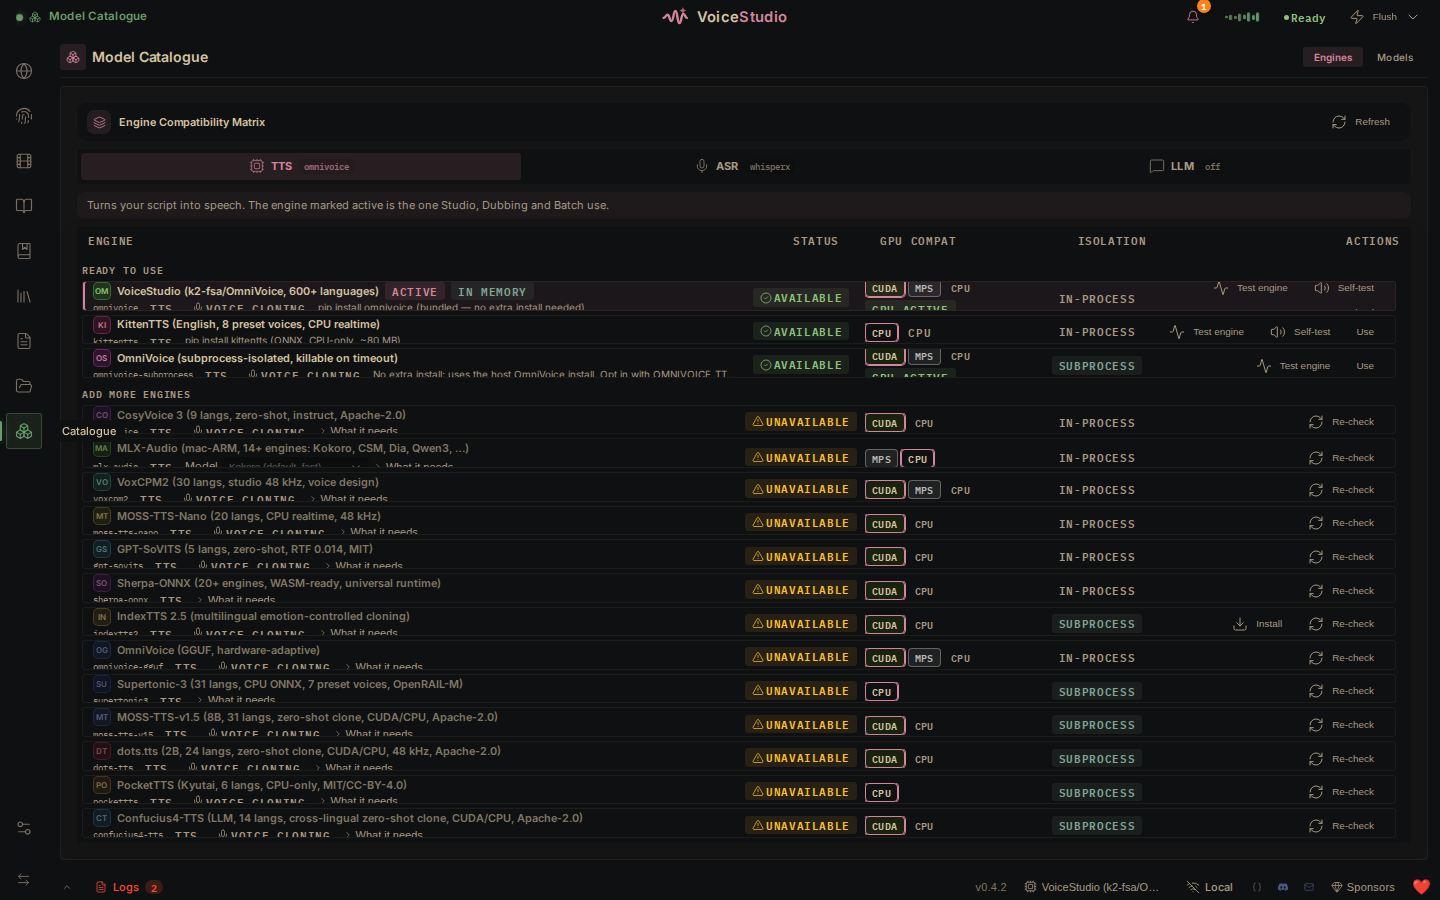
| 模型目录 | 安装、移除、选择 TTS、ASR 和 LLM 模型并设置路由 |
| 远程模型下载 | 在已注册的远程工作节点上安装模型,带实时进度 |
| GPU 自动检测 | CUDA、MPS、ROCm 和 CPU 路由,带逐引擎检查 |
| AI 水印 | AudioSeal 嵌入与检测 |
| MCP 服务器 | 面向 MCP 客户端的合成和转写工具 |
| 诊断 | 自检、错误日志、日志和脱敏支持包 |
| 本地优先 | 核心创作保持本地;网络相关功能为明确的选填项 |
| 可扩展 | 基于注册表的 TTS、ASR 和插件接口 |
 |
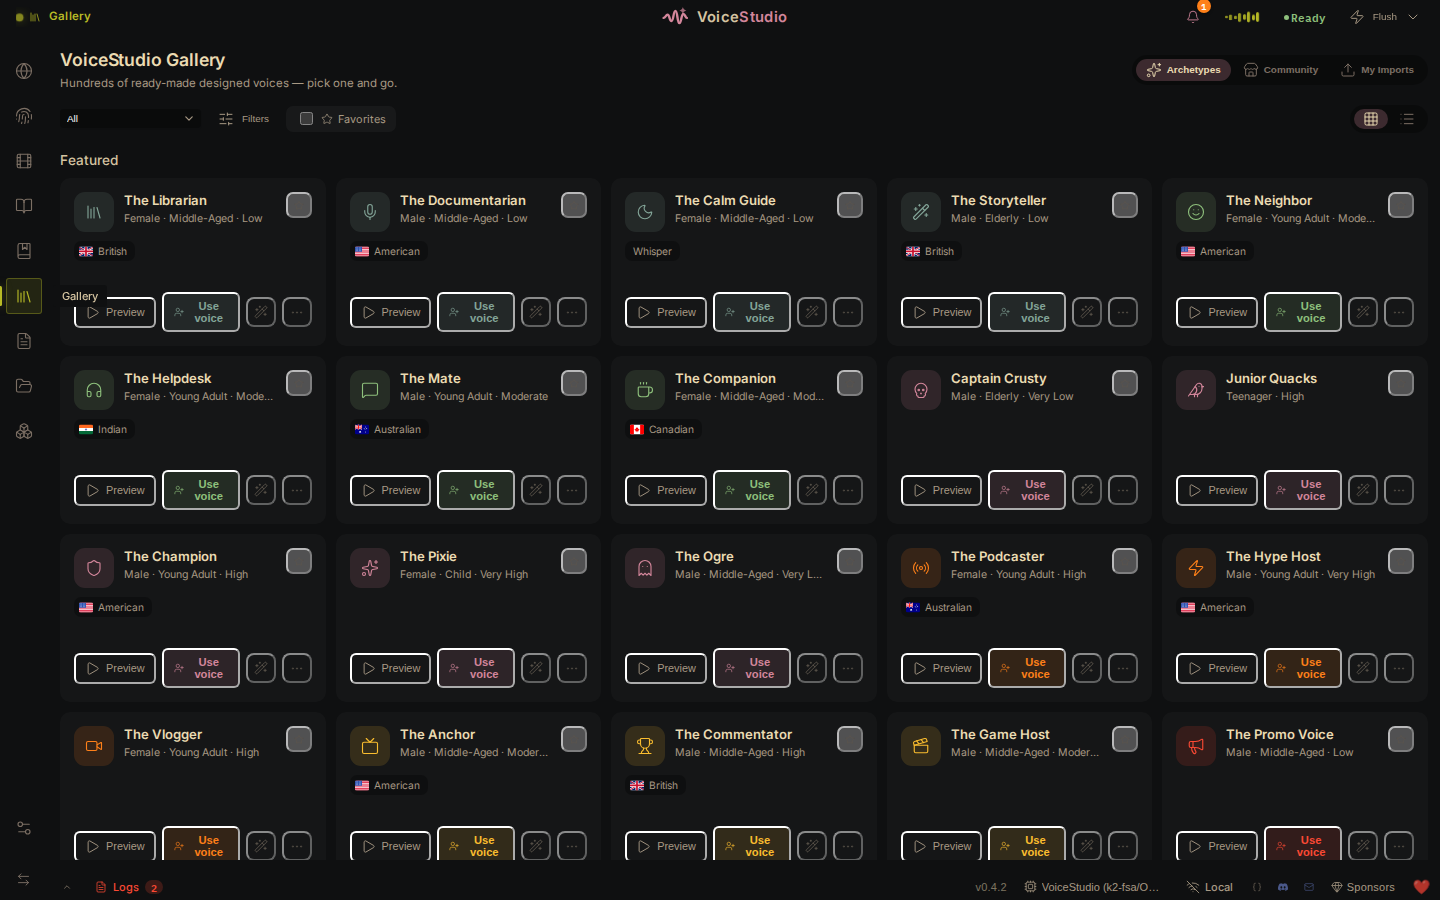 |
| 模型目录:引擎、设备和安装状态 | 语音库:将共享声音保存为本地音色配置 |
对比
VoiceStudio 以本地控制取代托管云算力。这是实际区别:
| VoiceStudio | 典型托管语音服务 | |
|---|---|---|
| 最佳场景 | 私有、离线、自托管或大批量工作 | 无需管理本地模型的快速搭建 |
| 数据路径 | 默认本地;远程功能为选填项 | 音频和文本由服务提供商处理 |
| 成本模式 | 免费软件;您自行提供硬件 | 订阅、积分或按量计费 API |
| 安装 | 安装应用和模型权重 | 创建账户并使用 Web 应用或 API |
| 性能 | 取决于您的引擎和硬件 | 提供商管理算力和扩展 |
| 离线使用 | 安装所需模型后即可 | 通常需要网络连接 |
| 可定制性 | 源码、引擎、模型、API 和路由全部开放 | 仅限于提供商提供的选项 |
| 维护 | 您自行管理更新、磁盘和算力 | 提供商管理基础设施 |
系统要求
要求因引擎而异。以下数值覆盖默认本地工作流。
| 最低配置 | 推荐配置 | |
|---|---|---|
| 操作系统 | Windows 10 x64 · macOS 13.3 Apple Silicon · 带 glibc 2.39+ 的 Linux x86_64 | 当前受支持的操作系统版本 |
| 内存 | 8 GB | 16 GB+ |
| 磁盘 | 10 GB 可用空间 | 20 GB+ SSD |
| GPU | 可选;支持 CPU 模式 | NVIDIA CUDA 或 Apple Silicon |
| 显存 | 使用 GPU 时 4 GB | 8 GB+;大型可选引擎需要更多 |
| 源码运行所需 Python | 3.11+ | 3.11 或 3.12 |
ROCm 仅限 Linux 且为选填项。Windows AMD/Ryzen AI 使用 CPU。显存有限的系统会在需要时将工作卸载到 CPU。参见性能、基准和引擎磁盘占用。
引擎
引擎支持因能力而异。选择前请检查克隆能力、语言、平台、内存和许可证。完整设置指南:docs/engines。
文本转语音
| 引擎 | 语言 | 克隆 | 指令控制 | Linux | macOS ARM | Windows | 许可证 |
|---|---|---|---|---|---|---|---|
| VoiceStudio(默认,由 k2-fsa/OmniVoice 驱动) | 600+ | 是 | 是 | CUDA/CPU | MPS | CUDA/CPU | AGPL-3.0 应用 · Apache-2.0 代码,CC-BY-NC 权重³ |
| CosyVoice 3 | 9 + 18 种方言 | 是 | 是 | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
| GPT-SoVITS | 5 | 是 | 否 | CUDA/CPU | 否 | CUDA/CPU | MIT |
| VoxCPM2 | 30 | 是 | 是 | CUDA/CPU | MPS | CUDA/CPU | Apache-2.0 |
| MOSS-TTS-Nano | 20 | 是 | 否 | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
| KittenTTS | 英语 | 否 | 否 | CPU | CPU | CPU | MIT |
| MLX-Audio | 取决于模型 | 因模型而异 | 因模型而异 | 否 | MLX | 否 | 因模型而异 |
| Sherpa-ONNX | 20+ | 否 | 否 | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
| IndexTTS 2.5 ⚡ | 中 · 英 · 日 · 西 · 阿 | 是 | 否 | CUDA/CPU | CPU | CUDA/CPU | Bilibili 模型许可证¹ |
| OmniVoice GGUF ⚡ | 600+ | 是 | 是 | CUDA/CPU | MPS/CPU | CUDA/CPU | AGPL-3.0 应用 · 请审阅衍生模型条款³ |
| OmniVoice(子进程) ⚡ | 600+ | 是 | 是 | CUDA/CPU | MPS | CUDA/CPU | AGPL-3.0 应用 · Apache-2.0 代码,CC-BY-NC 权重³ |
| PocketTTS ⚡ | 英 · 法 · 德 · 葡 · 意 · 西 | 是 | 否 | CPU | CPU | CPU | CC-BY-4.0,门控² |
| Supertonic 3 ⚡ | 31 | 否 | 否 | CPU | CPU | CPU | OpenRAIL-M |
| MOSS-TTS-v1.5 ⚡ | 31 | 是 | 否 | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
| dots.tts ⚡ | 24 | 是 | 否 | CUDA/CPU | CPU | 否 | Apache-2.0 |
| Confucius4-TTS ⚡ | 14 | 是 | 否 | CUDA/CPU | CPU | CUDA/CPU | Apache-2.0 |
⚡ 按需安装或注册。
¹ IndexTTS 2.5 要求月活跃用户超过 1 亿或年收入超过 10 亿元人民币时,需另行获得 Bilibili 书面许可。请审阅模型许可证。
² PocketTTS 在首次使用前会显示其门控访问和 CC-BY-4.0 条款。
³ OmniVoice 快照还包含一个音频分词器,受独立的 Boson Higgs Audio 2 和 Meta Llama 社区条款约束。VoiceStudio 的应用许可证不替代模型或分词器的条款。
不支持克隆的引擎无法在配音或固定声音批量任务中保留参考说话人。VoiceStudio 会拒绝这些任务,而不是静默更换引擎。大型引擎有单独的内存和平台限制;请先查阅其引擎指南。
语音转文本
| 引擎 | ID | 语言 | 最佳场景 |
|---|---|---|---|
| WhisperX(默认) | whisperx |
~100 | 配音、字幕、词级时间戳 |
| Faster-Whisper | faster-whisper |
~100 | 通用跨平台转写 |
| Faster-Whisper(隔离) | faster-whisper-isolated |
~100 | 崩溃隔离的批量转写 |
| MLX Whisper | mlx-whisper |
~100 | Apple Silicon |
| PyTorch Whisper | pytorch-whisper |
~100 | CUDA、MPS 和 CPU 回退 |
| Parakeet TDT | nemo-parakeet |
英语 + 25 种欧盟语言 | 快速 CPU/CUDA 转写 |
| Parakeet TDT v3(MLX) | parakeet-mlx |
25 种欧盟语言 | Apple Silicon 听写和词级时间戳 |
| Moonshine | moonshine |
英语 | 低功耗、低延迟 ONNX |
| FunASR | funasr |
50+ | VAD 和内联说话人分离 |
| sherpa-onnx(实时听写) | sherpa-onnx-asr |
取决于模型 | 流式 CPU 听写 |
| OpenAI 兼容 ⚠️ 已配置服务器 | openai-compat-asr |
取决于服务器 | 本地 gigastt/Qwen3-ASR 或远程端点;音频仅发送至该服务器 |
WhisperX 和 Faster-Whisper 在高效的 float16 不可用时,会使用 int8 重试。仅在自动选择仍失败时,才固定设置 ASR_COMPUTE_TYPE=int8 或 float32。
架构
Tauri v2 桌面外壳(Rust)
        │ IPC
React + Vite UI
        │ 通过 localhost:3900 的 HTTP · SSE · WebSocket
FastAPI 后端
        ├── TTS / ASR 引擎注册表
        ├── 配音 / 音频 / 长音频流水线
        ├── OpenAI 兼容 API 和 MCP 服务器
        └── SQLite + Alembic → omnivoice_data/
| 层 | 路径 | 职责 |
|---|---|---|
| 桌面外壳 | frontend/src-tauri/ |
窗口生命周期、系统托盘、快捷键、更新器、伴生进程引导 |
| 前端 | frontend/src/ |
React UI、Zustand 状态、API 和事件客户端、i18n |
| API | backend/api/ |
REST 路由、模式、认证边界、流式传输 |
| 核心服务 | backend/services/ |
生成、配音、音频处理、持久化 |
| 引擎 | backend/engines/ |
隔离且可选的引擎适配器 |
| 工作节点系统 | backend/worker/ |
经认证的远程算力和任务传输 |
| 数据 | omnivoice_data/ |
项目、声音、设置、日志和 SQLite 状态 |
| 交付 | scripts/、deploy/、.github/workflows/ |
开发、打包、容器、发布、CI |
网络边界
- 桌面端通过回环地址与
localhost:3900上的后端通信。 - 回环 API 调用无需服务器密钥。远程访问需要共享 PIN 或 API 密钥。
- 远程工作节点和 OpenAI 兼容 ASR 均为选填项。回环 ASR 可使用 HTTP,音频保留在本地机器上;非回环端点要求 HTTPS,且不跟随重定向。
- 分析功能在获得同意前保持关闭。启用后,仅发送白名单内的、不含内容的使用元数据。绝不发送文本、音频、文件名或项目。
本地语音平台和 OpenAI 兼容 API
将 OpenAI 兼容音频客户端指向本地后端:
- base_url="https://api.openai.com/v1"
+ base_url="http://localhost:3900/v1"
| 端点 | 用途 |
|---|---|
POST /v1/audio/speech |
TTS 输出 mp3、opus、aac、flac、wav 或 pcm;用 voice 选择音色配置,用 model 选择引擎 |
POST /v1/audio/transcriptions |
STT 输出 json、text、verbose_json、srt 或 vtt |
WS /v1/audio/transcriptions/stream |
实时 PCM/WebM 转写,支持分段、语句和会话结束事件 |
GET /.well-known/voicestudio-speech |
发现 HTTP、WebSocket、MCP 和原生听写控制传输方式 |
GET /v1/audio/voices |
列出本地音色配置和引擎 |
from openai import OpenAI

client = OpenAI(base_url="http://localhost:3900/v1", api_key="local")

with client.audio.speech.with_streaming_response.create(
    model="tts-1",
    voice="<profile-id>",
    input="Made on my own hardware.",
    response_format="wav",
) as response:
    response.stream_to_file("speech.wav")
内置的 Rust 控制伴生进程可让 Herdr、编码代理、VS Code、桌面应用和 TUI 触发系统级听写流程,或复用其原生文本插入功能。参见语音平台指南。完整 API 参考位于设置 → OpenAPI 参考。如需局域网、Tailscale 或代理访问,在暴露后端之前请阅读API 认证。
智能体技能
为 Claude Code、Codex、Cursor 及其他兼容 skills.sh 的智能体安装 VoiceStudio 技能:
npx skills add debpalash/VoiceStudio
omnivoice:通过本地 VoiceStudio 合成语音和转写音频。oss-maintainer:该仓库的开源维护工作流。
Google Colab
该笔记本可在 Colab GPU 上运行应用和 Web UI。Colab 是远程算力,因此上传的音频和项目数据不会保留在您的本地机器上。
文档
| 需求 | 阅读 |
|---|---|
| 安装 | macOS · Windows · Linux · Docker |
| 修复安装问题 | 故障排查 · 模型下载 · Hugging Face 令牌 |
| 选择引擎 | 引擎指南 · 基准 · 表现力语音 |
| 调优硬件 | 性能 · 远程工作节点 |
| 构建集成 | 语音平台 · 私有生产 API · API 认证 · MCP · 示例 |
| 构建 VoiceStudio | 贡献指南 · 引擎验收 |
| 跟踪变更 | 更新日志 · 路线图 · 最新发布版 |
| 彻底移除 | 卸载指南 |
常见问题
是否支持 Apple Silicon 和 Intel Mac?Apple Silicon 支持 MPS 和 MLX 选项。Intel Mac 无法运行本地后端,因为当前没有可用的 PyTorch wheel;它们可以连接远程后端。参见 macOS 安装。
我需要多少显存?GPU 是可选的。加速工作最低使用 4 GB 显存,默认多阶段工作流建议 8 GB+。大型可选引擎可能需要 12 到 16 GB 或更多。请查阅基准和引擎指南。
为什么更长的参考音频并不总能改善克隆效果?克隆是零样本的:音频片段是提示,而非训练数据。使用同一说话人、贴近麦克风、无音乐、噪音或混响的 5 到 15 秒音频。匹配您希望输出的语气和语速。如需训练,参见数据准备和训练。
生成的音频可以商用吗?VoiceStudio 的应用许可证不限制生成的音频,但也不授予模型独立条款下的权利。默认 OmniVoice 仓库将其预训练权重标注为 CC-BY-NC,并包含一个受独立社区条款约束的分词器。商用前请审阅所选模型的条款。
VoiceStudio 会收集数据吗?除非您主动选择,否则不会。分析功能默认关闭,跳过同意即保持关闭。启用后,应用仅发送白名单内的、不含内容的使用元数据。文本、音频、文件名、声音和项目均被排除。可在设置 → 隐私中更改。
如何卸载 VoiceStudio 及其数据?在 macOS/Linux 上使用 scripts/uninstall.sh,或在 Windows 上使用 scripts\uninstall.ps1。两者在删除前都会显示预演。每种路径参见卸载指南。
社区与贡献
- GitHub Issues:报告可复现的 bug 和功能请求。
- Discord:安装帮助和项目讨论。
- 适合新手的 issue:有明确范围的起点。
- 贡献指南:环境搭建、测试和拉取请求。
支持开发
VoiceStudio 免费且没有付费层级。捐赠用于支持开发和基础设施。
许可证
VoiceStudio 采用 AGPL-3.0 许可证。您可以运行、修改并在内部使用它。应用许可证本身不限制出售生成的音频,但下载的模型和分词器条款可能有此限制。如果您修改了 VoiceStudio 并将修改后的版本作为网络服务提供,AGPL 要求您以相同许可证提供相应的源码。VoiceStudio 自有代码的商业许可证可用于专有嵌入;它不会重新许可第三方模型。联系方式:VoiceStudio@palash.dev。有关通俗语言范围说明,参见 LICENSE-NOTICE.md。
可选引擎和下载的模型保留其自身许可证。内置 omnivoice/ Python 代码为上游 Apache-2.0;默认下载的权重和音频分词器使用独立条款。
致谢
VoiceStudio 基于 OmniVoice、WhisperX、Demucs、Pyannote、CTranslate2、AudioSeal、Tauri、Supertonic、Sherpa-ONNX、GPT-SoVITS 和 PocketTTS 构建。
下载 VoiceStudio · 给项目点星 · 加入 Discord