cocoindex
增量数据引擎,专为长时AI agent设计,自动保持上下文最新。核心思想类似React的数据流:声明目标状态,引擎只重算变化部分(Δ),支持源码、文档、会议记录等多数据源,输出到向量库或图数据库。亮点是亚秒级增量同步、可解释的数据血缘追踪、Rust内核保证生产可靠性。适合构建RAG pipeline、agent记忆系统或企业级实时索引。Apache 2.0开源。
README
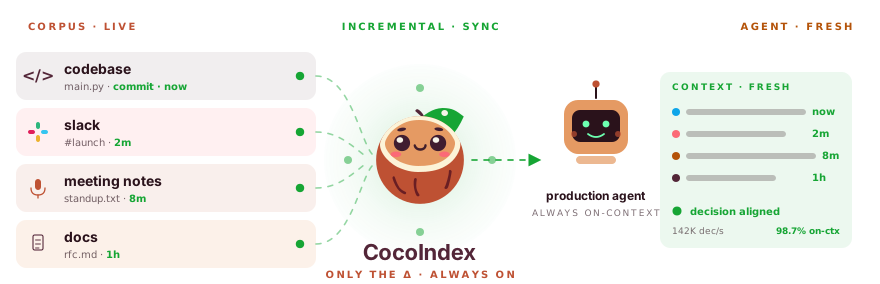
你的 agent 值得拥有 最新上下文。
Star 我们 ❤️ →  ·
 ·
 ·
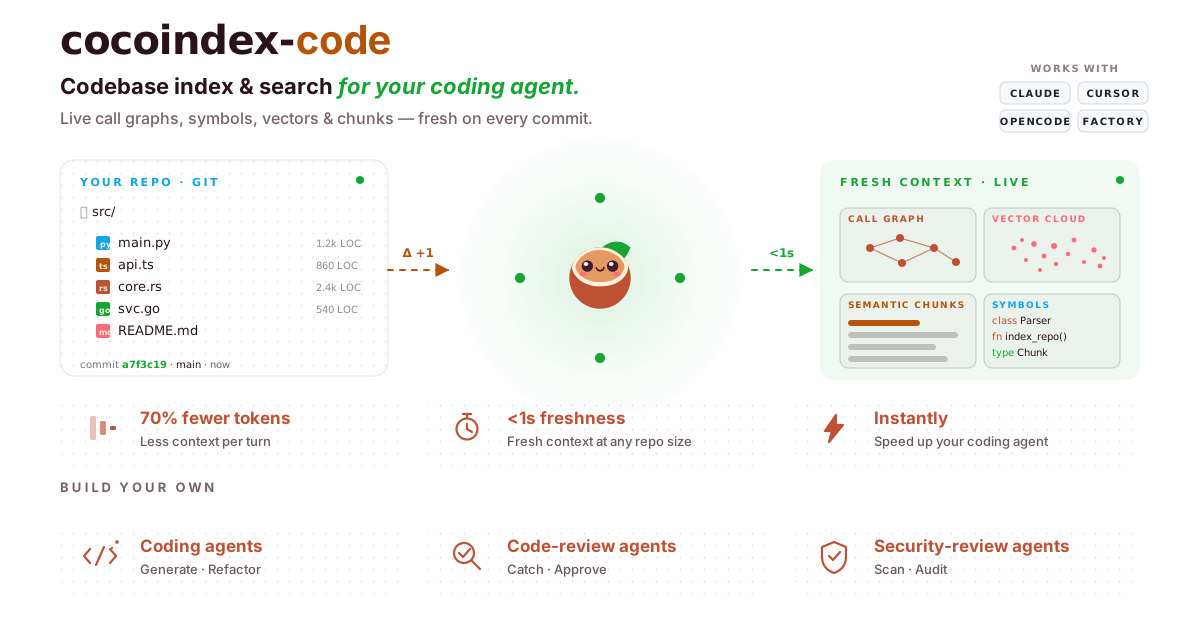
CocoIndex 将代码库、会议记录、收件箱、Slack、PDF 和视频转化为实时、持续更新的上下文,让你的 AI agent 和 LLM 应用能够高效推理——仅需极少的增量处理。在 10 分钟内准备好你的生产级 AI agent,数据可靠且持续新鲜——没有陈旧的批量,没有上下文鸿沟。
增量 · 仅处理变化 · 任意规模 · 默认并行 · 声明式 · Python,5 分钟





Deutsch | English | Español | Français | 日本語 | 한국어 | Português | Русский | 中文
用 CocoIndex 构建 ❤️
开始使用
pip install -U cocoindex
声明你期望的目标中应该包含什么——CocoIndex 会永久保持同步,仅重新计算 Δ。
import cocoindex as coco
from cocoindex.connectors import localfs, postgres
from cocoindex.ops.text import RecursiveSplitter

@coco.fn(memo=True)                          # ← 按 hash(input) + hash(code) 缓存
async def index_file(file, table):
    for chunk in RecursiveSplitter().split(await file.read_text()):
        table.declare_row(text=chunk.text, embedding=embed(chunk.text))

@coco.fn
async def main(src):
    table = await postgres.mount_table_target(PG, table_name="docs")
    table.declare_vector_index(column="embedding")
    await coco.mount_each(index_file, localfs.walk_dir(src).items(), table)

coco.App(coco.AppConfig(name="docs"), main, src="./docs").update_blocking()
运行一次完成回填。随时重新运行——仅重新嵌入已变更的文件。
正在使用AI编码agent构建项目?
引入我们的 CocoIndex skill,让你的 agent 写出正确的 v1 代码——概念、API、模式,全部在一个文件中。
安装步骤参见 与AI编码agent配合使用。
React —— 数据工程版


面向长时 horizon agent 的 增量引擎
为每位工程师打造的数据转换工具,专为 AI 工作负载设计——
借助智能增量引擎,实现始终新鲜、可解释的数据。

为什么选择 增量?
你的 agent 的质量取决于它所见的数据。
批量流水线会逐渐过时。CocoIndex 保持实时——且仅运行 Δ。

你可以构建什么?
来自 示例树 的即用启动模板——克隆,接入你的源,即可部署。


正在用 CocoIndex 构建项目?我们很想看看。
在 X 上标记 @cocoindex_io,或在 Discord 的 #showcase 频道中丢个链接。我们会帮你推广。 🥥
社区
<
相关内容warpsimsuperpowersskillsskills |