needle
开源 45M 参数的小型工具调用模型,整个模型打包成单个 14MB 二进制文件,约 28MB 内存即可跑完整会话,专为手机、可穿戴等小设备设计。采用 Simple Attention Network 架构并压缩到 CQ2-bit,在工具调用、结构化抽取上对标 FunctionGemma 270M 等模型,体积小 5-70 倍。Python 包支持 LoRA 微调、导出和本地推理,内置置信度门控与工具检索,适合做端侧 agent 的轻量 backbone。
README
Needle 2
Needle 2 是一个开源的 45M 参数模型,用于工具调用、设备使用和结构化提取。整个模型是一个 14MB 的二进制文件,在约 28MB 内存中即可运行完整会话。它基于我们的 Simple Attention Network(简单注意力网络)研究成果构建,使用 Cactus Quants 压缩到 CQ2 位,并集成到自己的引擎中。在下方基准测试中,Needle 2 与 FunctionGemma 270M、LFM2.5 230M 和 Apple FM 等其他小模型互有胜负,但体积小 5 倍到 70 倍,且仅 2 位精度,而它们为 f16 精度。
本仓库提供 Python 包:推理、LoRA 微调和导出。pip install cactus-needle,描述你的工具,然后从 Python 调用它们。推理引擎只会从 Hugging Face 获取一次并缓存,无需其他任何构建步骤。
- 自包含:权重烘焙进单个 14MB 引擎中;无需管理单独的模型文件,推理过程不联网。
- 简单契约:工具调用以结构化数据返回,文本输入,JSON 输出;根据你的 schema 编译的字节级语法约束每个 token。
- 置信度门控:每个响应都带有来自学习头(learned head)的校准置信度分数;设置一个阈值,高于阈值则采取行动,低于阈值则升级处理。
- 工具检索:声明一个大型工具目录,内置检索头每轮只输出最相关的五个工具,语法被限制在该子集内。
- 有界内存:256 token 的滑动窗口,工具作为 KV sinks(键值接收端)固定,因此无论对话多长,总内存都保持在 28MB 附近。
权重:huggingface.co/Cactus-Compute/needle2 · 源码:github.com/cactus-compute/needle。
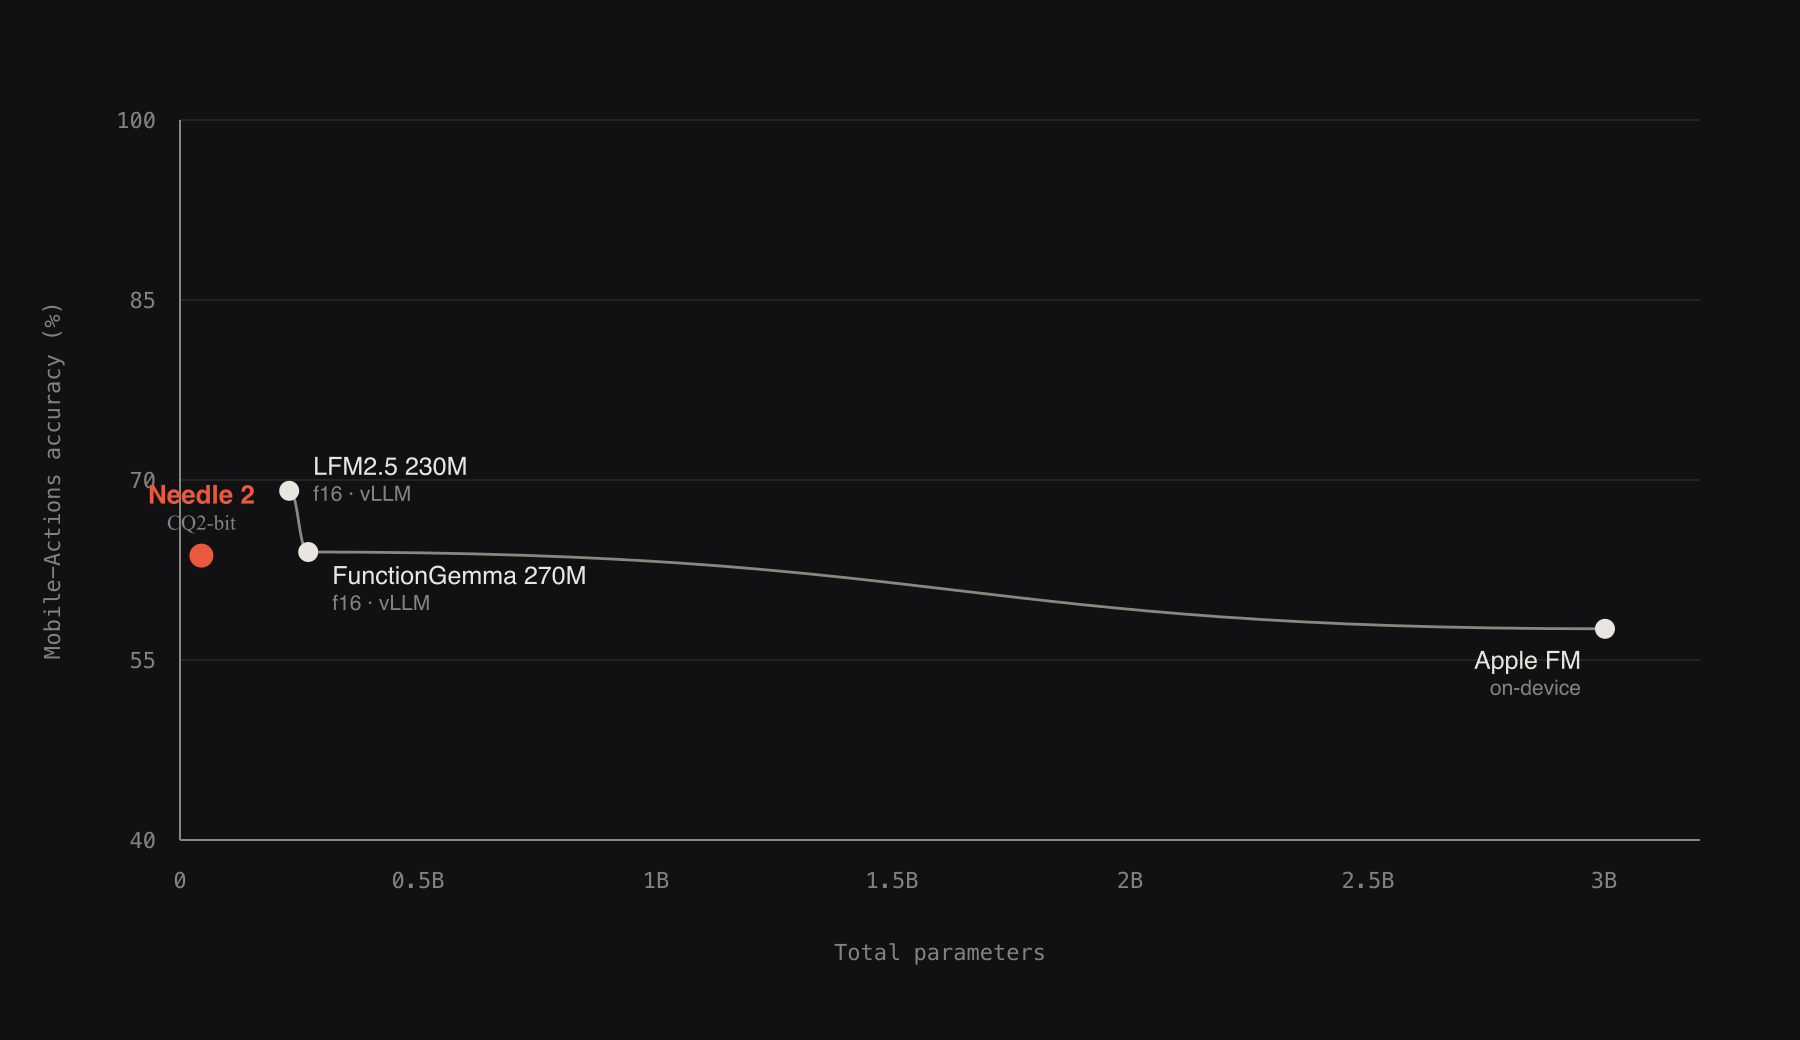
Simple Attention Network
Needle 2 是一个 Simple Attention Network,这是我们的稠密小模型配方:用 Hadamard MLP 替代 FFN,GQA 注意力,engram 键值记忆,以及多通道超连接(multi-lane hyper-connections)。设计和消融实验详见论文:arXiv:2607.18363。
![