ds4
面向 DeepSeek V4 Flash/PRO 和 GLM 5.2 的本地推理引擎,由 Redis 作者 antirez 用 C 编写,支持 Metal/CUDA/ROCm。针对 128GB 笔记本和 512GB 工作站做激进量化(2bit routed MoE),提供 SSD 流式、双 Mac tensor parallel、多机 pipeline parallel 以及兼容 OpenAI/Anthropic 的 server,让旧 CUDA 卡跑成多用户 LLM 服务。beta 质量,强调在特定模型上的垂直优化而非通用 GGUF runner。
README
DwarfStar 是一个小型原生推理引擎,首先针对 DeepSeek V4 Flash 进行了优化。它也支持 GLM 5.2,并且在内存非常大的机器上支持 DeepSeek V4 PRO。它是自包含的、刻意保持狭窄定位的引擎,并非通用的 GGUF 运行器。模型加载、prompt 渲染、工具调用、KV 状态、HTTP 服务器和编码 agent 都是整体构建并一起测试的。该仓库还包含了用于 GGUF、imatrix、质量和速度的工具与数据。
支持的推理后端:
- Metal,主要目标平台,适用于 96 GB 或更大内存的 Mac。内存较小的机器可以使用 SSD 流式加载。
- NVIDIA CUDA,包括多 GPU 系统和 DGX Spark。
- ROCm,适用于 Strix Halo 系统,例如 Framework Desktop。
如果没有 llama.cpp 和 GGML,这个项目就不可能存在,请务必阅读致谢部分,衷心感谢 Georgi Gerganov 以及所有其他贡献者。
模型支持是刻意"机会主义"的。该项目跟随最适合本地机器容量(尤其是 128 GB 笔记本和 512 GB 工作站)的优质开放权重。当更好的替代模型出现时,旧模型可能会被移除。
那么,我可以用这个软件做什么?
- 你可以在消费级硬件上运行非常强大的模型,例如 MacBook、DGX Spark 或 Strix Halo。即使 RAM 不够,借助 SSD 流式加载,你也能以不错的速度运行它。
- 借助 CUDA 多 GPU 支持以及 ds4-server 的 decoding 和 generation 微批处理,你可以把一台配备较老 CUDA 显卡(Ada Lovelace 架构,已被 vLLM 不再支持运行新模型)的服务器,变成公司内部的多用户 LLM 服务器。我们用 8 张 NVIDIA L40S 显卡和多个会话测试了这种配置,效果非常好。聚合生成速度 120 t/s,prefill 速度 2000 t/s。
- 使用两台 MacBook M5 Max / M3 Ultra 通过 RDMA 互联,你可以用 tensor parallelism(张量并行)运行 4 bit 的 DeepSeek Flash 或 GLM 5.2。
- 你还可以使用 pipeline parallelism(流水线并行)把多台系统组合在一起,汇总它们的 RAM 来运行更大的模型。
动机
- 强大的开放权重模型现在可以装进高端个人机器。
- DeepSeek V4 Flash 和 PRO、GLM 5.2 能够容忍激进的路由专家量化。
- 压缩 KV cache 和快速本地 SSD 使长上下文变得实用。
- 为少数几个模型专门优化的推理系统这一想法。
AI 全面披露
- 本软件是在 GPT 5.5、5.6、Claude Fable 的大力协助下开发的,人类负责主导想法、测试和调试。我们公开说明这一点,因为它塑造了这个项目的构建方式。如果你对 AI 开发的代码不满意,这个软件不适合你。下面的致谢同样重要:没有
llama.cpp和 GGML(大部分是手工编写的),这个项目就不会存在。
致谢 llama.cpp 和 GGML
ds4.c 并不链接 GGML,但它的存在要归功于 llama.cpp 项目开辟的道路,以及其中开发的 kernel、量化格式、GGUF 生态和来之不易的工程知识。
我们非常感谢并感激 llama.cpp
及其贡献者。他们的实现、kernel、测试和设计选择是构建这条 DeepSeek V4 专用推理路径时的重要参考。
这里保留或改编了一些源代码片段(在 MIT 许可下):GGUF 量化布局和表格、CPU 量化/点积逻辑,以及某些 kernel。出于这个原因,也因为我们真心感激,我们在 LICENSE 文件中保留了 GGML 作者的版权声明。
状态
该软件目前变化非常快。请将其视为 beta 质量。每次发布前都会执行一轮大型 QA 测试,但出现不稳定的情况是完全可能的。
更多文档
如果你在寻找非常具体的内容,我们还有其他子 README 文件。否则,常规使用请继续阅读接下来的章节。
- CONTRIBUTING.md:面向贡献者的正确性和速度回归测试指南。提交 pull request 之前请先阅读。
- QA_BEFORE_RELEASES.md:完整的发布测试矩阵,包括远程 Metal、CUDA 和 ROCm 机器。
- gguf-tools/README.md:离线 GGUF 生成、imatrix 采集、量化工具和质量检查。
- gguf-tools/imatrix/README.md:路由 MoE imatrix 的采集与使用方法。
- gguf-tools/imatrix/dataset/README.md:校准 prompt 语料库的生成方式。
- gguf-tools/quality-testing/README.md:本地 GGUF 如何与官方 DeepSeek V4 Flash/PRO 续写结果进行评分对比。
- dir-steering/README.md:方向性 steering 数据、向量生成与使用。
- speed-bench/README.md:基准测试命令、图表和 CSV 生成。
- tests/test-vectors/README.md:用于回归检查的官方续写向量。
模型权重
此实现只适用于下面列出的 DeepSeek V4 和 GLM 5.2 GGUF。它不是通用的 GGUF 加载器,任意的 GGUF 文件不会具备引擎所期望的张量布局、量化混合、元数据或可选的 MTP 状态。这里提供的 2 bit 量化经过验证确实具有高质量:它们表现良好,能在编码 agent 下工作,工具调用也可靠。
2 bit 量化使用了非常不对称的量化方案:只有路由 MoE experts 被量化,up/gate 使用 IQ2_XXS,down 使用 Q2_K。它们占据了模型空间的绝大部分:其他组件(共享 experts、projections、routing)保持原样以保证质量。
下载一个主模型。优先选择 imatrix 版本。
./download_model.sh q2-imatrix   # 96/128 GB RAM 机器,imatrix 调优的 q2
./download_model.sh q2-q4-imatrix  # 96/128 GB RAM 机器,q2 且最后 6 层为 q4
./download_model.sh q4-imatrix   # >= 256 GB RAM 机器,imatrix 调优的 q4
./download_model.sh pro-q2-imatrix  # 512 GB RAM 机器,PRO q2 imatrix 量化
要完整运行 PRO Q4 分布式推理,在每台机器上下载一半:
./download_model.sh pro-q4-layers00-30      # PRO Q4 拆分的前半部分
./download_model.sh pro-q4-layers31-output  # PRO Q4 拆分的后半部分
该脚本从 https://huggingface.co/antirez/deepseek-v4-gguf 下载,文件存放在 ./gguf/ 下,使用 curl -C - 断点续传,并更新 ./ds4flash.gguf 指向所选的主模型。
pro-q4-layers00-30、pro-q4-layers31-output 和 pro-q4-split 目标会下载分布式的 PRO Q4 分片,但不会更新 ./ds4flash.gguf。
公开下载时认证是可选的,但如果提供了 --token TOKEN、HF_TOKEN 或本地 Hugging Face token 缓存,则会使用。
如果你想重新生成 GGUF 文件或采集新的 imatrix,请参阅 gguf-tools/README.md。这些工具面向离线建模工作,在完整的 DeepSeek V4 Flash 权重上可能耗时很长。本地工具支持 Flash GGUF 生成。PRO GGUF 的生产目前仍依赖基于外部 llama.cpp 的工作流;后续可以添加原生工具。
./download_model.sh mtp 获取 Flash 的可选投机解码(speculative decoding)支持 GGUF。它可以与 q2-imatrix、q2-q4-imatrix 和 q4-imatrix 一起使用,但必须通过 --mtp 显式启用。当前的 MTP/投机解码路径仍是实验性的:它通过正确性门控,目前最多提供轻微加速,而不是显著的生成速度提升。
GLM 5.2 支持仅限于本分支测试过的 GGUF 文件:
./download_model.sh glm-unsloth-q4  # Unsloth UD-Q4_K_XL,11 个分片
./download_model.sh glm-antirez-iq2xxs  # antirez 路由 IQ2_XXS 单文件 GGUF
./download_model.sh glm-antirez-q2  # antirez 路由 Q2_K 单文件 GGUF
./download_model.sh glm-antirez-q4  # antirez 路由 Q4_K 单文件 GGUF
受支持的 GLM 布局将 dense/model-control 张量保留在现有的 Q8/F32 路径中,并支持路由 expert gate/up 张量使用 Q2_K、Q4_K 或 Q5_K;路由 expert down 张量支持 Q2_K、Q4_K、Q5_K 或 Q6_K。其他 GLM GGUF 量化布局应视为不受支持,直到它们被有意添加并对照官方 100 个用例的 fixture 进行评分。
这些格式并非都支持相同的执行模式。Q4 文件适用于常规 Metal 和 CUDA 推理。双 Mac tensor parallelism 目前需要所有权感知的 IQ2_XXS 或 Q2_K 路由布局;路由 Q4 GLM 必须在评估前被拒绝。
GLM 的 MTP 块是主 GGUF 的一部分;它不使用单独的 Flash MTP 文件。普通 decode 仍是默认模式。--glm-mtp 启用实验性的贪心投机。--glm-mtp-timing 也会启用它,并打印接受率和计时计数器:
./ds4 -m gguf/GLM-5.2-UD-IQ2_XXS_RoutedIQ2XXS_blk78Q2K.gguf \
  --glm-mtp-timing --temp 0
GLM 推理使用 Metal、CUDA 或 ROCm 图后端。GLM 尚不支持方向性 steering、低于 100 的 --power、显式的 --prefill-chunk 以及外部的 --mtp 文件。
然后构建:
make                  # macOS Metal
make cuda-spark       # Linux CUDA,DGX Spark / GB10
make cuda-generic     # Linux CUDA,其他本地 CUDA GPU
make strix-halo       # Linux ROCm,AMD Strix Halo
make cpu              # 仅 CPU 诊断构建
./ds4flash.gguf 是两个二进制文件的默认模型路径。传入 -m 可从 ./gguf/ 中选择另一个受支持的 GGUF。运行 ./ds4 --help 和 ./ds4-server --help 查看完整参数列表。
DSpark 投机解码
DSpark 是 DeepSeek 为 DeepSeek V4 Flash 发布的辅助草稿模型。它读取主模型的 hidden states,并提议最多五个未来 token。DwarfStar 用主 Flash 模型检查这些提议,只提交被接受的 prefix。主模型仍然具有权威性;被拒绝或低置信度的后缀会回退到普通的目标解码。
可能的收益是更快的生成:当多个提议 token 被接受时,一次目标验证 pass 会让流前进多个 token。它不会加速 prefill,而且草稿和验证工作并非免费。可预测的续写(尤其是代码)往往受益最大;收益低的 prompt 可能不会更快,甚至更慢。因此 DSpark 仍是实验性的,需要显式选择启用。
已发布的 DSpark checkpoint 在这里被打包为一个约 5.6 GiB 的独立支持 GGUF。它不是独立模型。下载一次:
./download_model.sh dspark-support
同一个支持文件可以用于上面列出的 Flash q2-imatrix、q2-q4-imatrix 和 q4-imatrix 模型。目前 DeepSeek V4 PRO 不受支持。在 Metal 上,主模型可以常驻内存或使用 --ssd-streaming;支持模型仍会将其自身的权重和运行时状态加入内存需求。DSpark 取代了该次运行的旧式单阶段 MTP 支持模型,而不是与之叠加。
使用贪心解码运行:
./ds4 -m ds4flash.gguf \
  --mtp gguf/DeepSeek-V4-Flash-DSpark-support.gguf \
  --dspark --temp 0
--mtp 提供支持 GGUF,而 --dspark 选择 DSpark 运行时。默认置信度阈值为 0.9;它会剪除不太可能回报其验证成本的后缀。--dspark-confidence 0 强制固定的五 token 块,用于诊断目的。采样解码不使用 DSpark 提议。--quality 和 --dspark-strict 也保持仅目标解码,这对比较和正确性检查很有用。
速度
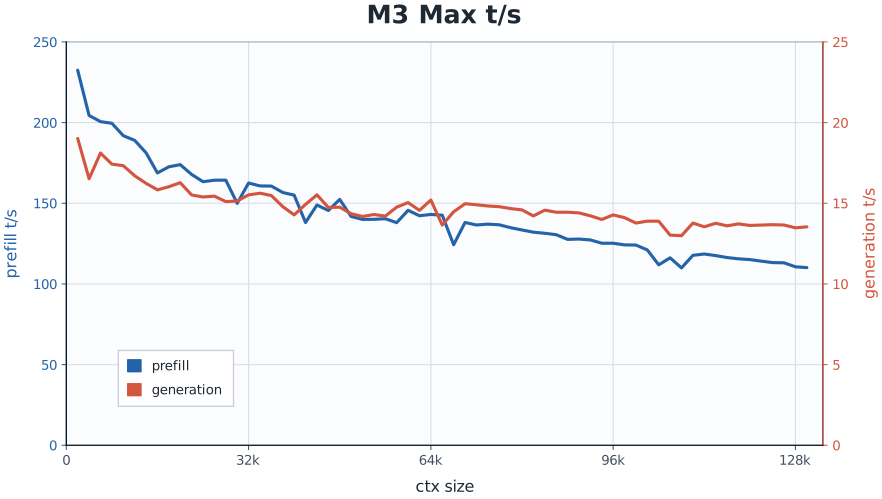
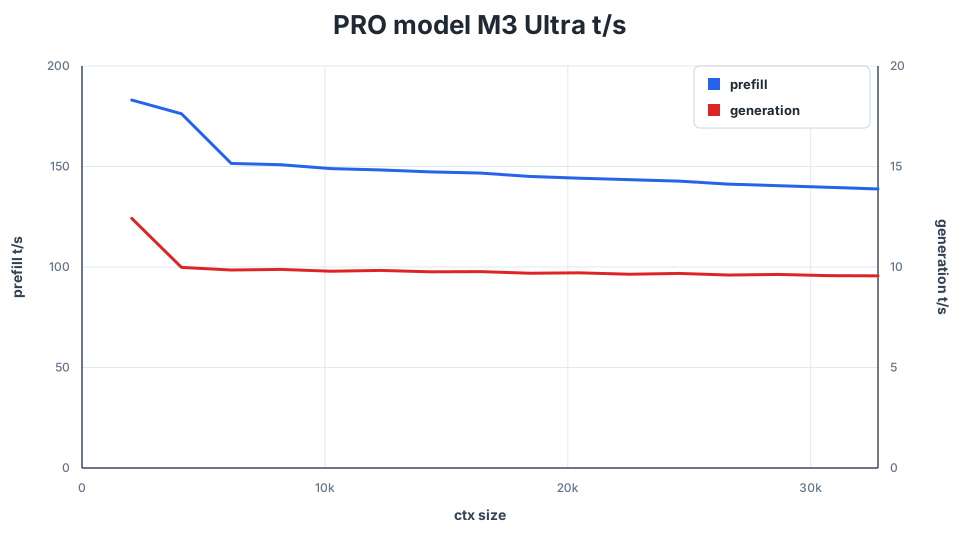
警告:其中一些数字可能不再更新,因为优化工作提升了运行时速度但没有同步更新基准测试结果。
以下是单次运行的 Metal CLI 数字,使用 --ctx 32768、--nothink、贪心解码和 -n 256。短 prompt 是一个普通的意大利语小故事 prompt。长 prompt 测试分块 prefill 加长上下文 decode。Q4 需要更大内存的机器类别,因此 M3 Max Q4 数字为 N/A。
| 机器 | 量化 | Prompt | Prefill | 生成 |
|---|---|---|---|---|
| MacBook Pro M3 Max, 128 GB | q2 | 短 | 58.52 t/s | 26.68 t/s |
| MacBook Pro M3 Max, 128 GB | q2 | 11709 tokens | 250.11 t/s | 21.47 t/s |
| MacBook Pro M3 Max, 128 GB | q4 | 短 | N/A | N/A |
| MacBook Pro M3 Max, 128 GB | q4 | 长 | N/A | N/A |
| MacBook Pro M5 Max, 128 GB | q2 | 短 | 87.25 t/s | 34.27 t/s |
| MacBook Pro M5 Max, 128 GB | q2 | 11707 tokens | 463.44 t/s | 25.90 t/s |
| Mac Studio M3 Ultra, 512 GB | q2 | 短 | 84.43 t/s | 36.86 t/s |
| Mac Studio M3 Ultra, 512 GB | q2 | 11709 tokens | 468.03 t/s | 27.39 t/s |
| Mac Studio M3 Ultra, 512 GB | q4 | 短 | 78.95 t/s | 35.50 t/s |
| Mac Studio M3 Ultra, 512 GB | q4 | 12018 tokens | 448.82 t/s | 26.62 t/s |
| Mac Studio M3 Ultra, 512 GB | PRO q2 | 32768 tokens | 138.82 t/s | 9.56 t/s |
| DGX Spark GB10, 128 GB | q2 | 7047 tokens | 343.81 t/s | 13.75 t/s |
运行大于 RAM 的模型
常规 Metal 路径会尝试让模型常驻在 GPU 可寻址内存中。这是最快的路径,当模型放得下时应保持为默认。DwarfStar 在 Metal 上以及 GLM 5.2 在 ROCm 上还有 SSD 流式容量模式。在这种模式下,非路由模型权重保持常驻,而路由 MoE experts 保存在内存缓存中,缓存未命中时从 GGUF 文件加载。
流式不如把完整模型装进 RAM 快。它仍然需要内存来存放非路由权重、KV cache、图计算临时空间、激活值和路由 expert 缓存。它之所以有用,是因为路由 experts 主导了模型大小,而现代 Mac SSD 足够快,可以让缓存未命中变得可容忍。长 prefill 仍然可以很快;生成对缓存未命中更敏感,因为每个新 token 都会再次经过 experts 路由。
从自动缓存预算开始:
./ds4 -m ./ds4flash.gguf --ssd-streaming
如果启动时报告 expert 缓存太大,或者你想为上下文预留更多内存,请显式设置路由 expert 缓存:
./ds4 -m ./ds4flash.gguf --ssd-streaming --ssd-streaming-cache-experts 32GB
32GB 这个值是路由 expert 的内存预算,不是通用的字节缓存。DwarfStar 首先为重叠流式 prefill 使用的两个完整路由层预留余量,然后把剩余字节转换为适合当前 GGUF 的动态缓存 expert 数量。显式的 NGB 预算也可能在上下文/KV 核算后被封顶,以确保后端工作集远离慢速压力区。纯数字形式的 --ssd-streaming-cache-experts 4000 则不同:它表示正好 4000 个动态 expert 槽位,不做额外核算。非路由权重、KV cache、图临时空间和激活值需要额外的内存。自动缓存预算取后端推荐工作集的 80%,减去非路由权重,然后在确定动态缓存大小之前应用同样的路由 prefill 余量。常规使用请保持热门 expert 预加载启用;仅在做测量时使用 --ssd-streaming-cold 和 --ssd-streaming-preload-experts N。
实际 SSD 流式示例
在 64GB MacBook 上,从 2 bit Flash GGUF 和适中的 expert 缓存开始:
./download_model.sh q2-imatrix

./ds4 \
  -m ./ds4flash.gguf \
  --ssd-streaming \
  --ssd-streaming-cache-experts 32GB \
  --ctx 32768 \
  --nothink
在 128GB MacBook 上,PRO q2 流式是实验性的,但当你接受较慢的生成速度时,可用于检查和偶尔的工作。从 --nothink 开始:
./download_model.sh pro-q2-imatrix

./ds4 \
  -m gguf/DeepSeek-V4-Pro-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-Instruct-imatrix.gguf \
  --ssd-streaming \
  --ctx 32768 \
  --nothink
在 128GB RAM 的 M5 Max 上,一次短暂的 PRO q2 流式解码基准测试发现自动预算最佳:它选择了约 59GB 的路由 expert 缓存。手动设置 64GB 到 75GB 缓存在那台机器上表现接近。推荐使用自动预算;如果在这类机器上手动设置缓存,从 48GB 到 64GB 左右开始,然后仅在机器保持响应且启动日志显示所请求的动态缓存时再增加。机器稳定后,用保守的生成数量限制重新启用思考模式:
./ds4 \
  -m gguf/DeepSeek-V4-Pro-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-Instruct-imatrix.gguf \
  --ssd-streaming \
  --ctx 32768 \
  --think \
  --tokens 1500
GLM 5.2 使用相同的选项。其流式路径保留能常驻的最大完整层前缀,然后用剩余预算做动态 expert 缓存。从自动预算开始:
./ds4 \
  -m gguf/GLM-5.2-UD-IQ2_XXS_RoutedIQ2XXS_blk78Q2K.gguf \
  --ssd-streaming \
  --ctx 32768
重要的启动行是缓存报告。先保守一点,然后如果机器有富余再增加缓存。
在 128GB Strix Halo 上,使用路由 Q2_K 模型和 4096-token 上下文作为起点。自动缓存预算为 GLM 图和 KV 状态留出空间:
./download_model.sh glm-antirez-q2
make strix-halo
./ds4 --rocm -m gguf/GLM-5.2-UD-Q2_K_RoutedQ2K.gguf \
  --ssd-streaming --ctx 4096
流水线并行分布式推理
流水线并行(pipeline parallelism)让 DwarfStar 可以运行单台机器装不下的模型,方法是将 transformer 层拆分到多台机器上。主要示例是跨两台 128 GB MacBook 运行完整的 4 bit Flash 量化:每个进程只映射自己的层切片,激活值通过 TCP 发送,协调者保持正常的 CLI/API 行为。
流水线并行也可以通过同时使用多个 GPU 在不同层处理不同微批次来加速 prefill,就像流水线一样。只有 prefill 能以这种方式加速。生成是纯粹自回归的:每个 token 必须走完整个路由后下一个 token 才能开始。模型工作量与单进程相同,再加上协调延迟,因此分布式生成会更慢。
为了建立初步的心智模型,以下是高层概念:
- 你在每台机器上放置 GGUF,但每台只加载其中一部分。
--layers控制映射哪些张量,因此带有--layers 20:output的工作节点不会加载更早的层。 - 层范围是包含式的:
10:20表示第 10、11、...、20 层。N:output表示从第N层到最后一层再加上输出头。 - 你把其中一台机器指定为
coordinator(协调者),其他机器为workers(工作节点)。工作节点会连接到协调者,告知它们的存在以及它们能处理哪些层。 - 每个工作节点保留自己的 KV cache 切片。
- 通信是工作节点对工作节点的,不需要用协调者作为中继,所以如果你的协调者是
A,你发起请求后,激活值会沿A -> B -> C -> 回到 A流动。
工作原理与配置方法
prefill 路径是流水线化的(这就是为什么它能比单机更快)。对于大 prompt,协调者可以在工作节点处理块 N 的同时运行自己那块的第 N+1 块。下面的分布式行是在两台通过 Thunderbolt 5 连接的 M5 Max 128 GB MacBook 上测量的,使用 Q4 Flash GGUF 和默认的 4096-token 分布式 prefill 块。单进程列是在单台机器上用 Q2 GGUF 运行的参考,因此实际上它稍快一些,因为路由 MoE 更小。
| Prompt | 单进程参考 | 两台 MacBook | 加速比 |
|---|---|---|---|
| 9421 tokens | 421.70 t/s | 582.22 t/s | 1.38x |
| 28684 tokens | 405.30 t/s | 674.16 t/s | 1.66x |
| 63819 tokens | 353.62 t/s | 654.79 t/s | 1.85x |
生成则不同。它严格自回归:token N+1 必须等到 token N 产出 logits 且采样选出下一个 token 之后才能开始。这意味着分布式生成无法利用长 prefill 流水线。每个生成的 token 至少要付出一次跨机器的激活值跳转,因此生成比单个本地进程慢。在同样的双 Mac Thunderbolt 设置下,使用 91 GB Flash 量化的 12k 上下文对照运行从单进程的 30.59 t/s 降到分布式的 24.67 t/s,损失 19.4%。因此分布式推理主要用于容纳更大的模型和加速长 prefill,而不是让 decode 更快。
在两台 Mac Studio 上运行完整 DeepSeek V4 PRO Q4
完整尺寸的 PRO Q4 GGUF 可以跨两台 512 GB Mac Studio M3 Ultra 机器运行,协调者使用层 0:30,工作节点使用 31:output。使用拆分后的 GGUF 文件,这样每一侧只映射自己需要的张量:
# 协调者机器。
./download_model.sh pro-q4-layers00-30

# 工作节点机器。
./download_model.sh pro-q4-layers31-output
两个文件是:
gguf/DeepSeek-V4-Pro-Q4K-Layers00-30.gguf
gguf/DeepSeek-V4-Pro-Q4K-Layers-31-output.gguf
这是一个容量用例:每个进程只映射自己那一半模型,而工作节点拥有输出头并返回 logits。
当前 PRO Q4 Metal 路径对大型路由 experts 使用队列驻留的精确 expert 表。这避免了早期分布式 PRO Q4 尝试中那种宽泛的多 GiB 路由张量绑定(它们要么运行极慢,要么触及 Metal 内存核算上限)。在一次通过直接 192.168.0.182 / 192.168.0.183 链路进行的短暂贪心冒烟测试中,模型生成了连贯文本,启动后测得生成速度 11.47 t/s。每个 token 的遥测是均衡的:本地层约 39-43 ms,远程层约 44-49 ms,总 token 时间约 84-92 ms。启动会比较慢,因为每一侧都要映射并让模型的一半常驻内存。长上下文 PRO Q4 prefill 和 decode 性能仍需单独基准测试。
上述测量使用 Thunderbolt 5 线缆。实现是纯 TCP,也适用于较慢的链路(包括 WiFi),但强烈推荐快速以太网或 Thunderbolt 网络。慢链路主要影响生成延迟和短 prefill;当层拆分均衡时,大 prefill 仍然可以受益。在正常性能路径中,最后一个工作节点拥有输出头并直接返回 logits。
最简单的双机配置:
# 机器 A:协调者,拥有分词、采样、prompt 和第 0..30 层。
./ds4 \
  -m gguf/DeepSeek-V4-Pro-Q4K-Layers00-30.gguf \
  --role coordinator \
  --layers 0:30 \
  --listen 169.254.43.68 1234

# 机器 B:工作节点,连接到 A 并拥有第 31..output 层。
./ds4 \
  -m gguf/DeepSeek-V4-Pro-Q4K-Layers-31-output.gguf \
  --role worker \
  --layers 31:output \
  --coordinator 169.254.43.68 1234
通常最后一个工作节点也应该拥有输出头,例如 --layers 20:output。这样可以避免在 prefill 后返回完整的最终 hidden-state 批次,并让最后一个工作节点直接产生 logits。在非常慢或计量的链路上,也支持 --layers 20:42:协调者会加载输出头并在本地计算 logits,用更多的协调者工作换取更小的每 token 回复。
网络链路对比
下表展示同一对 M5 Max 主机、同一个 91 GB Flash 量化、协调者 --layers 0:19、工作节点 --layers 20:output、来自 speed-bench/promessi_sposi.txt 的 8192-token prompt,以及 128 个生成 token。WiFi 和互联网数字会随本地条件变化,但趋势才是重点:高延迟直接损害生成,而低带宽也会拉低长 prefill 速度。
| 链路 | 地址 | 平均 ping | Prefill | 生成 |
|---|---|---|---|---|
| Thunderbolt 5 | 169.254.43.68 -> 169.254.12.245 |
0.45 ms | 582.99 t/s | 25.09 t/s |
| WiFi | 192.168.1.57 -> 192.168.1.95 |
77.20 ms | 250.70 t/s | 10.70 t/s |
| 互联网 / VPN | 10.77.0.4 -> 10.77.0.3 |
152.10 ms | 114.88 t/s | 3.63 t/s |
互联网/VPN 案例并不是为了良好的交互体验。它仍对集体测试有用:多人可以临时组合机器来运行任何单台主机都装不下的更大模型,接受较慢的 decode,以换取能够检视模型本身。
像使用普通 ./ds4 一样使用协调者:交互聊天、/read 和普通生成都走同一套高层会话 API。同样的分布式选项也接入 ds4-agent、ds4-eval 和 ds4-bench。对于基准测试,工作节点应该已经在运行;ds4-bench 会等待完整的路由可用。
有用的调优和诊断:
./ds4-bench \
  -m gguf/DeepSeek-V4-Flash-Q4KExperts-F16HC-F16Compressor-F16Indexer-Q8Attn-Q8Shared-Q8Out-chat-v2.gguf \
  --prompt-file speed-bench/promessi_sposi.txt \
  --ctx-start 32768 \
  --ctx-max 65536 \
  --step-incr 32768 \
  --gen-tokens 0 \
  --role coordinator \
  --layers 0:19 \
  --listen 169.254.43.68 1234 \
  --debug
协调者上的 --debug 会打印路由形成和每跳遥测:层范围、token 跨度、本地评估时间、下游等待时间、socket 发送时间,以及输入/输出字节数。这是当前用于判断拆分是否均衡的性能分析工具。--dist-prefill-window N 控制端到端可以有多少个 prefill 块在飞行中;默认值是保守且有界的。--dist-prefill-chunk N 用于实验,但默认的 4096-token 块是标准设置,除非你在显式验证不同的块大小,否则应使用默认值。
默认情况下 DwarfStar 以 32 位浮点数发送 hidden-state 激活值。要减少流量,请在协调者上传入 --dist-activation-bits 16 或 --dist-activation-bits 8。这只会改变机器之间的传输格式,不会改变模型权重或 KV cache。16 位传输将激活值流量减半,是在以太网或 WiFi 上首先尝试的选项。8 位传输更激进,应视为近似/实验模式,除非你已针对自己的用例验证过输出。不过实验表明减小激活值大小并未带来显著改善,因此这个选项将来可能会被移除。
如果某个工作节点断开连接,协调者会将该工作节点从活动路由中移除。已在飞行中的请求可能会失败,后续调用会报告路由不完整,直到兼容的工作节点重新连接并发送新的注册。对于实时会话,协调者保留 token 历史,可以在路由再次可用时通过重放 prefix 来重建工作节点的 KV 状态。工作节点还会在每个工作项上验证滚动 64 位 token-prefix 哈希,因此位于位置 0 的重启工作节点不能静默接受位置 N 的工作;它会报告不匹配,协调者会重放当前记录。CLI 和 agent 中的 Ctrl+C 是协作式的:DwarfStar 会等待当前分布式 token 或 prefill 块排空后才交还控制权,这避免了协调者引起的 KV 分裂。保存的 agent/server 会话使用与单机会话相同的 KV 文件格式:保存时协调者获取工作节点拥有的层张量并序列化为一个普通 payload;加载时它会将该 payload 拆分到当前注册的路由上。
分布式协议概览
在协议层面有两种连接。工作节点保持一条到协调者的控制 TCP 连接,并发送包含其模型 ID、模型家族、量化配置文件、层切片、上下文容量和数据端口的 HELLO。协调者利用这些注册信息构建一条覆盖所有层的路由。随后工作通过低延迟 TCP 数据连接流动:协调者计算第一个切片,发送包含会话 ID、token 位置、跨度前后滚动 token-prefix 哈希、路由信息和 hidden-state payload 的 WORK 帧,每个工作节点计算自己的切片。中间工作节点可以直接转发给下一个工作节点。最后一个工作节点向协调者返回 logits,或者对非最终 prefill 块返回 ACK,以便 prefill 流水线保持满载。RESULT 帧回显请求 ID 和跨后哈希。工作节点状态错误与 socket 故障的处理方式不同:KV/哈希不匹配可以通过在同一路由上重放 token 历史来恢复,而传输故障会丢弃路由并等待替换的工作节点。对于持久 KV,协调者打开工作节点数据连接,并为每个工作节点拥有的层范围发送快照保存/加载消息;磁盘 payload 仍然是单个 agent/server 缓存文件。该协议没有加密或认证,也还不是发布稳定的;协调
[原 README 过长已截断]