turbovec

基于 Google TurboQuant 算法的 Rust 向量索引库,Python 绑定,主打 16 倍压缩率、超低内存占用(10M 文档从 31GB 降到 4GB),搜索速度比 FAISS 快 12-20%(ARM)或持平(x86)。亮点:无需训练、支持在线增量添加、内置 ID 过滤搜索,且提供 LangChain / LlamaIndex 等框架的即插集成,适合构建隐私敏感、低延迟的纯本地 RAG 管道。
README



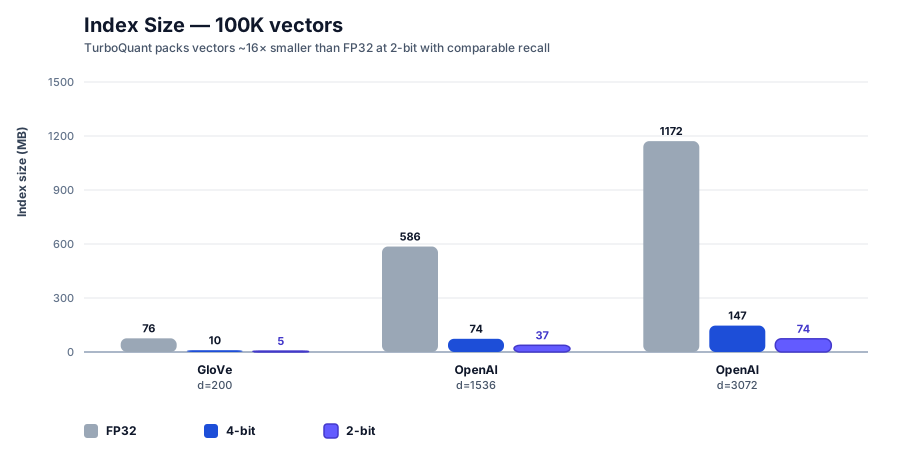
一个包含 1000 万文档的语料库,以 float32 格式存储时占用 31 GB RAM。turbovec 将其压缩至 4 GB,并且搜索速度比 FAISS 更快。
turbovec 是一个具有 Python 绑定的 Rust 向量索引,基于 Google Research 的 TurboQuant 算法构建 —— 这是一种与数据无关的量化器,其失真程度达到 Shannon 下界,无需码本训练和独立的训练阶段。
- 在线注入。 添加向量即完成索引 —— 无需训练步骤,无需参数调优,语料库增长时无需重建。
- 比 FAISS 更快。 手写 NEON(ARM)和 AVX-512BW(x86)内核,在 ARM 上比 FAISS IndexPQFastScan 快 12–20%,在 x86 上与 FAISS 持平或更快。
- 搜索时过滤。 向
search()传递 id 允许列表(或槽位 bitmask),内核会直接处理。您始终从允许集合中获得最多k个结果 —— 无需过度获取,选择性过滤时无召回率损失。 - 纯本地。 无需托管服务,数据不会离开您的机器或 VPC。可与任何开源 embedding 模型配合,构建完全隔离的 RAG 系统。
正在构建注重隐私、内存或延迟的 RAG 应用?您来对地方了。
Python
pip install turbovec
from turbovec import TurboQuantIndex

index = TurboQuantIndex(dim=1536, bit_width=4)
index.add(vectors)
index.add(more_vectors)

scores, indices = index.search(query, k=10)

index.write("my_index.tq")
loaded = TurboQuantIndex.load("my_index.tq")
需要支持删除的稳定 ID?使用 IdMapIndex:
import numpy as np
from turbovec import IdMapIndex

index = IdMapIndex(dim=1536, bit_width=4)
index.add_with_ids(vectors, np.array([1001, 1002, 1003], dtype=np.uint64))

scores, ids = index.search(query, k=10)   # ids 是您传入的 uint64 外部 id
index.remove(1002)                         # O(1) 按 id 删除

index.write("my_index.tvim")
loaded = IdMapIndex.load("my_index.tvim")
混合检索(带过滤的搜索)
将结果限制为其他系统(SQL、BM25、ACL、时间窗口等)产生的候选集:
import numpy as np
from turbovec import IdMapIndex

idx = IdMapIndex(dim=1536, bit_width=4)
idx.add_with_ids(vectors, ids)

# 阶段 1:外部系统缩小为候选 id。
allowed = np.array(db.execute("SELECT id FROM docs WHERE tenant=?", (t,)).fetchall(),
                   dtype=np.uint64)

# 阶段 2:在候选集内进行稠密重排序。
scores, ids = idx.search(query, k=10, allowlist=allowed)
过滤操作在 SIMD 内核内部以 32 向量块为粒度进行:任何包含不允许槽位的块,在 LUT 查找或评分工作之前就会被短路跳过;已评分块中个别不允许的槽位在堆插入时被丢弃。因此,选择性允许列表(仅允许索引中很小一部分)避免了大部分 SIMD 开销,而不是先执行计算再丢弃结果。
输出长度是 min(k, len(allowed)) —— 当允许列表小于 k 时,您会精确得到 len(allowed) 个结果,而不会填充回退结果。
完整 API 参考见 docs/api.md。
框架集成
可直接替换各框架内置的参考向量/文档存储库。相同的公开接口、相同的持久化语义、相同的检索器和流水线设置 —— 只需替换 import 即可保持流水线不变。
- LangChain —
pip install turbovec[langchain]· 替换langchain_core.vectorstores.InMemoryVectorStore - LlamaIndex —
pip install turbovec[llama-index]· 替换llama_index.core.vector_stores.SimpleVectorStore - Haystack —
pip install turbovec[haystack]· 替换haystack.document_stores.in_memory.InMemoryDocumentStore - Agno —
pip install turbovec[agno]· 替换agno.vectordb.lancedb.LanceDb
Rust
cargo add turbovec
use turbovec::TurboQuantIndex;

let mut index = TurboQuantIndex::new(1536, 4);
index.add(&vectors);
let results = index.search(&queries, 10);
index.write("index.tv").unwrap();
let loaded = TurboQuantIndex::load("index.tv").unwrap();
对于支持删除的稳定外部 ID:
use turbovec::IdMapIndex;

let mut index = IdMapIndex::new(1536, 4);
index.add_with_ids(&vectors, &[1001, 1002, 1003]);
let (scores, ids) = index.search(&queries, 10);
index.remove(1002);
index.write("index.tvim").unwrap();
let loaded = IdMapIndex::load("index.tvim").unwrap();
召回率
TurboQuant vs FAISS IndexPQ (LUT256, nbits=8) —— 论文第 4.4 节的基线。100K 向量,k=64。FAISS PQ 的子量化器数量与 TurboQuant 的比特率匹配(2-bit 时 m=d/4,4-bit 时 m=d/2)。
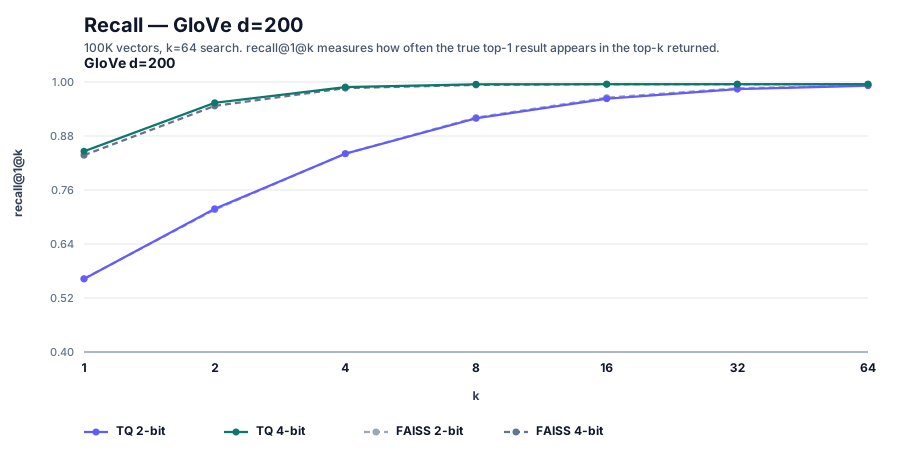
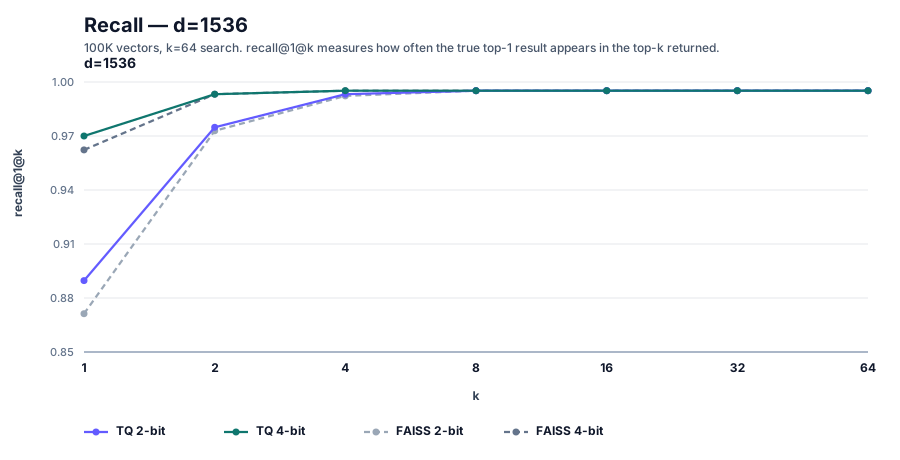
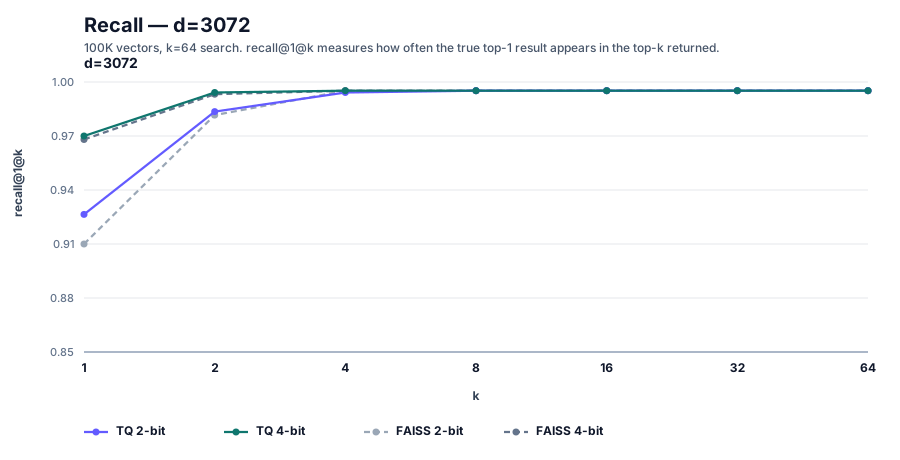
在 OpenAI d=1536 和 d=3072 上,TurboQuant 在 2-bit 和 4-bit 下的 R@1 比 FAISS 高出 0.4–3.4 个百分点,且两者在 k=4 时均收敛到 1.0。GloVe d=200 是更难的情况 —— 低维度下渐近 Beta 假设较弱。TurboQuant 在 4-bit 的 R@1 上比 FAISS 高出 0.3 个百分点,在 2-bit 时落后 1.2 个百分点,两者在 k≈16 时均与 FAISS 持平。
基线的说明。 我们与 FAISS IndexPQ(LUT256, nbits=8, float32 LUT)进行比较,因为它是大多数用户会首选的生产级 PQ 方案。这比 TurboQuant 论文 中使用的自定义 u8-LUT PQ 基线更强 —— FAISS 在评分时使用更高精度的 LUT,并采用 k-means++ 进行码本训练。我们在 OpenAI d=1536 / d=3072 上复现了论文中的 TurboQuant 数字,并在低维 embedding 上与其他社区参考实现达到相似数值(参见 turboquant-py 在 d=384 上的结果)。GloVe 上可见的差距反映了 FAISS 是一个强基线,而非 TurboQuant 实现的问题。
完整结果:d=1536 2-bit、d=1536 4-bit、d=3072 2-bit、d=3072 4-bit、GloVe 2-bit、GloVe 4-bit。
压缩
搜索速度
所有基准测试:100K 向量,1K 查询,k=64,取 5 次运行的中位数。
ARM (Apple M3 Max)
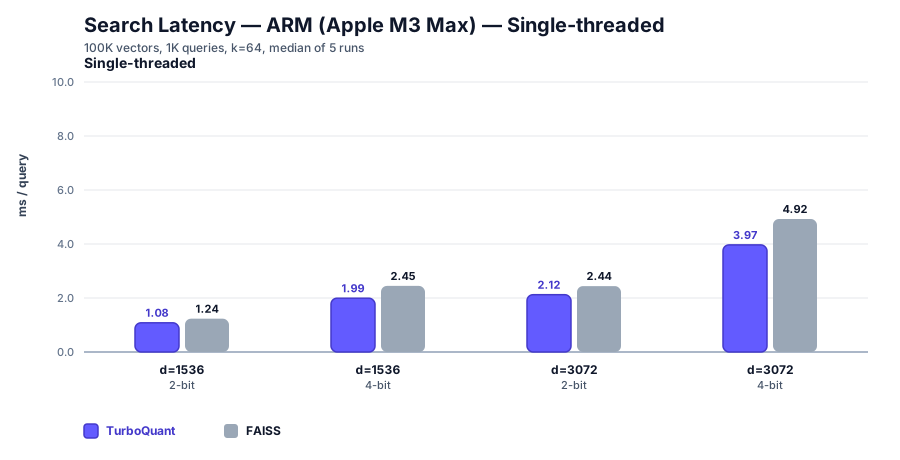
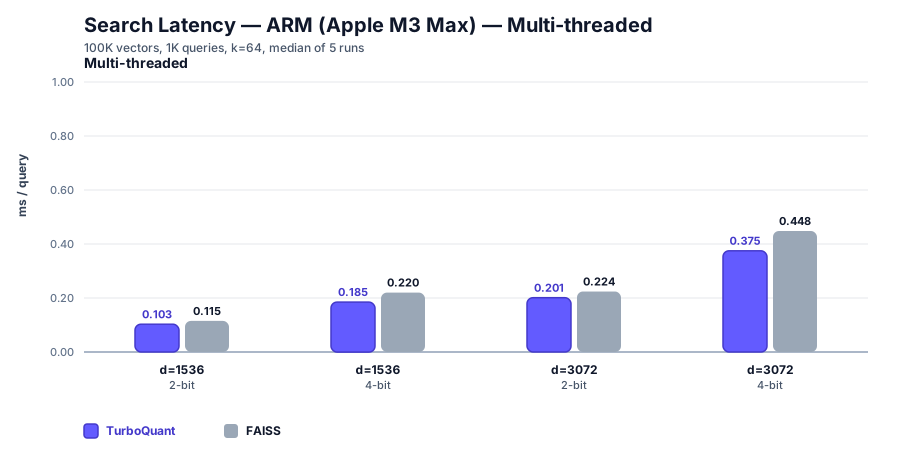
在 ARM 上,TurboQuant 在所有配置下都比 FAISS FastScan 快 12–20%。
x86 (Intel Xeon Platinum 8481C / Sapphire Rapids, 8 vCPUs)
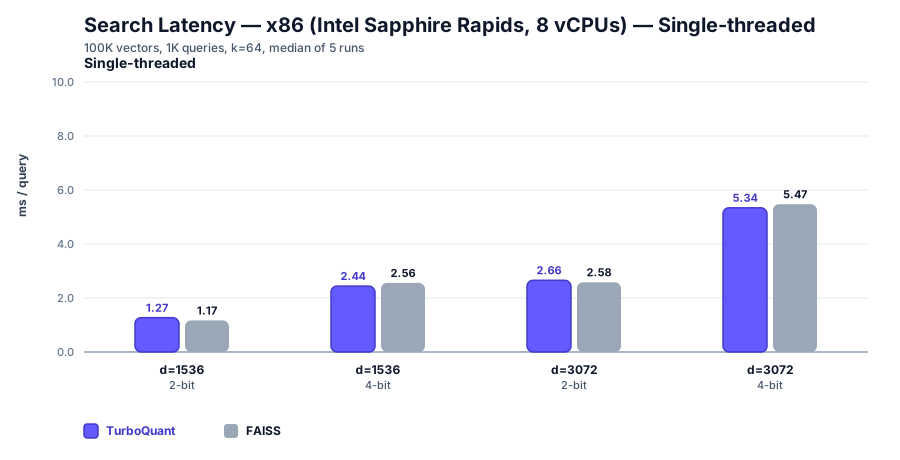
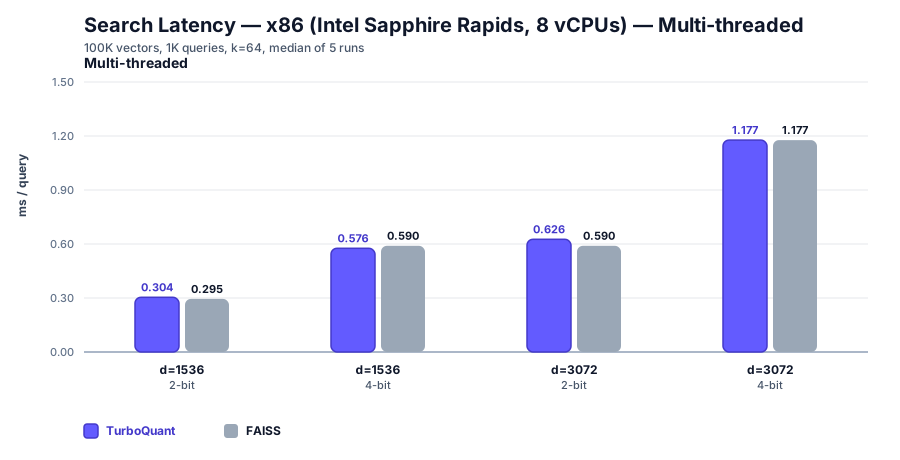
在 x86 上,TurboQuant 在所有 4-bit 配置中胜出 1–6%,在 2-bit 单线程下与 FAISS 相差约 1%。2-bit 多线程行(d=1536 和 d=3072)是仅有的略微落后于 FAISS(2–4%)的配置,该场景下内部累加循环太短,无法通过循环展开摊销来匹敌 FAISS 的 AVX-512 VBMI 路径。
工作原理
每个向量都是高维超球面上的一个方向。TurboQuant 利用一个简单的洞察压缩这些方向:在施加随机旋转后,每个坐标都服从已知分布 —— 无论输入数据如何。
1. 归一化。 从每个向量中剥离长度(范数),并将其存储为单个浮点数。现在每个向量都是超球面上的单位方向。
2. 随机旋转。 将所有向量乘以同一个随机正交矩阵。旋转后,每个坐标独立服从 Beta 分布,该分布在高维中收敛于高斯分布 N(0, 1/d)。这对任何输入数据都成立 —— 旋转使得坐标分布变得可预测。
3. 每坐标校准 (TQ+)。 步骤 2 中的 Beta 分布是渐近的 —— 在有限维度下,个别坐标会偏离规范形状(尤其是低比特和词向量风格 embedding)。TQ+ 在首次添加时为每个坐标拟合两个标量 —— 一个平移量和一个缩放量 —— 将每个坐标的经验 5/95% 分位数映射到规范 Beta 边缘分布。然后 Lloyd-Max 码本针对其设计的目标分布进行量化。校准在首次添加后冻结,并被后续添加重用 —— 无需重新训练、无需重建、无需独立训练阶段。召回率提升:在最容易偏离的单元(例如 2-bit 下的 GloVe)上,@1 提升高达 +1.4 个百分点。
4. Lloyd-Max 标量量化。 由于分布已知,我们可以预先计算每个坐标的最优桶划分方式。2-bit 有 4 个桶,4-bit 有 16 个桶。Lloyd-Max 算法 找到使均方误差最小的桶边界和质心。这些值根据数学计算得出,而非从数据学习。
5. 位打包。 每个坐标现在是一个小整数(2-bit 为 0-3,4-bit 为 0-15)。将它们紧密打包到字节中。一个 1536 维的向量从 6,144 字节(FP32)压缩到 384 字节(2-bit)。实现了 16 倍压缩。
6. 长度重归一化评分。 标量量化系统性地低估了内积 —— 重建的单位方向比原始方向略短。我们在编码时为每个向量计算一个标量 —— 旋转后单位向量与其自身质心重建的内积 —— 并将 ||v|| / ⟨u, x̂⟩ 与每个压缩向量一起存储。搜索内核在堆插入前将每个候选的得分乘以该标量,从而将内积估计从有偏低估转变为无偏,且不增加搜索时间或额外存储。召回率提升在低比特宽度时最为明显,因为此时量化收缩最大。
编码代价:每个向量额外计算一个 d 维点积以获取 ⟨u, x̂⟩。对于 d=1536 的 100 万向量,编码时间增加不到 1 秒 —— 这是一次性代价,在注入时支付,查询时无需承担。
搜索。 我们不解压缩每个数据库向量,而是将查询旋转到相同域,并直接与码本值进行评分。评分内核使用 SIMD 内联函数(ARM 上使用 NEON,现代 x86 上使用 AVX-512BW,并备有 AVX2 回退),配合半字节分割查找表以获得最大吞吐量。
Lloyd-Max 码本的失真程度在信息论下界(Shannon 失真率限)的 2.7 倍以内;长度重归一化步骤消除了 Lloyd-Max 码本在内积估计上引入的残余偏差。
构建
Python (通过 maturin)
pip install maturin
cd turbovec-python
maturin build --release
pip install target/wheels/*.whl
Rust
cargo build --release
所有 x86_64 构建通过 .cargo/config.toml 目标为 x86-64-v3(AVX2 基线,Haswell 2013+)。任何能运行 AVX2 回退内核的 CPU 都可以运行整个 crate —— AVX-512 内核通过 is_x86_feature_detected! 在运行时检测,仅在支持的硬件上启用。
运行基准测试
下载数据集:
python3 benchmarks/download_data.py all            # 所有数据集
python3 benchmarks/download_data.py glove          # GloVe d=200
python3 benchmarks/download_data.py openai-1536    # OpenAI DBpedia d=1536
python3 benchmarks/download_data.py openai-3072    # OpenAI DBpedia d=3072
每个基准测试都是 benchmarks/suite/ 中的一个独立脚本。单独运行其中一个:
python3 benchmarks/suite/speed_d1536_2bit_arm_mt.py
python3 benchmarks/suite/recall_d1536_2bit.py
python3 benchmarks/suite/compression.py
运行某个类别的所有基准测试:
for f in benchmarks/suite/speed_*arm*.py; do python3 "$f"; done    # 所有 ARM 速度
for f in benchmarks/suite/speed_*x86*.py; do python3 "$f"; done    # 所有 x86 速度
for f in benchmarks/suite/recall_*.py; do python3 "$f"; done       # 所有召回率
python3 benchmarks/suite/compression.py                            # 压缩
结果以 JSON 格式保存到 benchmarks/results/。重新生成图表:
python3 benchmarks/create_diagrams.py
参考文献
- TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate (ICLR 2026) —— 本实现所依据的论文
- RaBitQ: Quantizing High-Dimensional Vectors with a Theoretical Error Bound for Approximate Nearest Neighbor Search (SIGMOD 2024) —— 步骤 5 中采用的每个向量长度重归一化校正的来源
- FAISS Fast accumulation of PQ and AQ codes —— turbovec 的 x86 SIMD 内核改编自 FastScan 的打包布局、半字节 LUT 评分和 u16 累加器策略