lingbot-map

前馈3D基础模型,能从流式数据中实时重建场景,核心是几何上下文Transformer,通过锚点上下文、位姿参考窗口和轨迹记忆统一处理坐标定位、密集几何线索与长时间漂移校正。支持Paged KV Cache注意力,在518×378分辨率下以约20FPS稳定推理超万帧序列,在多个公开基准上达到SOTA。研究向,Apache-2.0许可。
README
LingBot-Map(语言机器人地图):用于流式3D重建的几何上下文Transformer
Robbyant 团队


https://github.com/user-attachments/assets/fe39e095-af2c-4ec9-b68d-a8ba97e505ab
🗺️ 认识 LingBot-Map!我们构建了一个前馈式 3D 基础模型,用于流式 3D 重建!🏗️🌍
LingBot-Map 专注于解决以下问题:
- 几何上下文 Transformer(Geometric Context Transformer):在架构上通过锚点上下文(anchor context)、姿态参考窗口(pose-reference window)和轨迹记忆(trajectory memory),将坐标定位、密集几何线索和长程漂移校正统一到单个流式框架中。
- 高效率流式推理:采用带分页 KV 缓存注意力(paged KV cache attention)的前馈架构,在 518×378 分辨率下、面对超过 10,000 帧的长序列,可实现约 20 FPS 的稳定推理。
- 最先进的重建质量:在多个 benchmark(基准测试)上,相比现有的流式方法和基于迭代优化的方法均取得了更优的性能。
📑 目录
点击展开- 📰 新闻
- 📋 待办清单
- ⚙️ 安装
- 📦 模型下载
- 🚀 快速开始
- 🎬 交互式演示(
demo.py) - 🎥 离线渲染管线(
demo_render/batch_demo.py) - 📜 许可证
- 📖 引用
- ✨ 致谢
📰 新闻
- 2026-05-25 — 📊 评估 benchmark 发布。我们发布了 KITTI 和 Oxford Spires 的评估脚本——详见 benchmark/ 目录下的流程,在评估前运行
preprocess/oxford.py准备 Oxford Spires 数据。 - 2026-04-29 — 📹 长视频演示发布。我们发布了一个超长视频示例(约 25,000 帧,13 分钟室内漫游),使用离线管线渲染——参见工作示例一节获取命令、参数说明和渲染输出。
- 2026-04-27 — 🚀 LingBot-Map 加速。拉取最新
main分支后运行python demo.py --compile ...或python gct_profile.py --backend flashinfer --dtype bf16 --compile,即可在您的硬件上验证加速效果。 - 2026-04-24 — 修复了 FlashInfer KV 缓存的一个 bug:当
--keyframe_interval > 1时,非关键帧会被错误地静默缓存。现在当序列超过 320 帧时,您应该会看到更好的姿态和重建质量。
📋 待办清单
- ✅ 发布评估 benchmark
- ✅ Oxford Spires 数据集
- ✅ KITTI 数据集
- ✅ VBR 数据集
- ✅ Droid-W 数据集
- ✅ TUM-D 数据集
- ✅ 7-scenes 数据集
- ✅ ETH3D 数据集
- ✅ Tanks and Temples 数据集
- ✅ NRGBD 数据集
- ✅ 发布演示脚本
- ✅ 室内长视频演示(特色室内漫游)
- ✅ 室外长视频演示
- ✅ LingBot-World 演示
- ✅ 航拍长视频演示
⚙️ 安装
1. 创建 conda 环境
conda create -n lingbot-map python=3.10 -y
conda activate lingbot-map
2. 安装 PyTorch(CUDA 12.8)
pip install torch==2.8.0 torchvision==0.23.0 --index-url https://download.pytorch.org/whl/cu128
推荐使用 PyTorch 2.8.0,因为 NVIDIA Kaolin(批渲染管线所需)提供了针对
torch-2.8.0_cu128的预编译 wheel。如果您仅需demo.py,可以使用更新的 PyTorch 版本,但此时批渲染器需要从源码编译 Kaolin。 对于其他 CUDA 版本,请参阅 PyTorch 入门页面。
3. 安装 lingbot-map
pip install -e .
4. 安装 FlashInfer(推荐)
FlashInfer 提供了分页 KV 缓存注意力(paged KV cache attention),以实现高效率流式推理。它是一个纯 Python 包,会在首次使用时通过 JIT 编译 CUDA 内核,因此同一个 wheel 可兼容多个 CUDA/PyTorch 版本:
pip install --index-url https://pypi.org/simple flashinfer-python
仅当您的默认 pip 索引是不包含
flashinfer-python的内部镜像时,才需要指定--index-url https://pypi.org/simple。 (可选)为加速首次使用,还可以安装特定 CUDA 版本的 JIT 缓存:pip install flashinfer-jit-cache -f https://flashinfer.ai/whl/cu128/flashinfer-jit-cache/。 详见 FlashInfer 安装文档。如果未安装 FlashInfer,模型会通过--use_sdpa回退到 SDPA(PyTorch 原生注意力)。
5. 可视化依赖(可选)
pip install -e ".[vis]"
📦 模型下载
| 模型名称 | Huggingface 仓库 | ModelScope 仓库 | 描述 |
|---|---|---|---|
| lingbot-map-long | robbyant/lingbot-map | Robbyant/lingbot-map | 更适合长序列和大尺度场景(推荐)。 |
| lingbot-map | robbyant/lingbot-map | Robbyant/lingbot-map | 平衡检查点——在短序列和长序列上提供全面性能折中。 |
| lingbot-map-stage1 | robbyant/lingbot-map | Robbyant/lingbot-map | lingbot-map 的第一阶段训练检查点——可加载到 VGGT 模型中进行双向推理(c2w)。 |
🚧 即将推出: 我们正在训练一个更强的模型,支持更长的序列——敬请期待。
🚀 快速开始
安装完成后,只需一条命令即可运行第一个场景:
python demo.py --model_path /path/to/lingbot-map-long.pt \
    --image_folder example/courthouse --mask_sky
这将启动一个基于浏览器的交互式 viser 查看器,默认地址为 http://localhost:8080。请参阅下方的交互式演示了解全部场景和参数,或跳转到离线渲染管线以进行长序列批渲染。
🎬 交互式演示(demo.py)
运行 demo.py 可通过基于浏览器的 viser 查看器(默认 http://localhost:8080)进行交互式 3D 可视化。
试玩示例场景
我们在 example/ 目录下提供了四个示例场景,可直接运行:
# courthouse 场景
python demo.py --model_path /path/to/lingbot-map-long.pt \
    --image_folder example/courthouse --mask_sky
https://github.com/user-attachments/assets/aa10f7ab-8024-43c7-92f8-d56159ec85c8
# University 场景
python demo.py --model_path /path/to/lingbot-map-long.pt \
    --image_folder example/university --mask_sky
https://github.com/user-attachments/assets/212a1744-6ff5-4ccf-9bd4-728608248b57
# Loop 场景(闭环轨迹)
python demo.py --model_path /path/to/lingbot-map-long.pt \
    --image_folder example/loop
https://github.com/user-attachments/assets/5ae0a292-b081-40c6-838c-b7c1a0538d75
# Oxford 场景(带天空遮罩,室外大尺度场景)
python demo.py --model_path /path/to/lingbot-map-long.pt \
    --image_folder example/oxford --mask_sky
https://github.com/user-attachments/assets/6b8daa95-9ed4-40b2-9902-7435779b886d
🎯 特色演示:室内漫游(约 25,000 帧,13 分钟)
序列太长,不适合交互式 viser 查看器——该片段使用离线渲染管线进行了渲染。完整命令请参见该章节。
我们将在后续提供更多示例。
使用关键帧间隔进行流式推理
使用 --keyframe_interval 可通过仅保留每 N 帧作为关键帧来减少 KV 缓存内存。非关键帧仍会生成预测,但不会存入缓存。这对于超过 320 帧的长序列非常有用(我们在 320 视图上使用 video RoPE 进行训练,因此当 KV 缓存存储超过 320 个视图时性能会下降。使用关键帧策略可以更长的序列进行推理)。
数据集: 从 Hugging Face 上的 robbyant/lingbot-map-demo 下载演示序列。
以下示例运行上述数据集中的 travel 序列(开启天空遮罩,4 次相机优化迭代,每 2 帧一个关键帧):
python demo.py \
    --image_folder /path/to/lingbot-map-demo/travel/ \
    --model_path /path/to/lingbot-map-long.pt \
    --mask_sky \
    --camera_num_iterations 4 \
    --keyframe_interval 2
https://github.com/user-attachments/assets/d350b590-d036-4363-af8c-7af3918338ef
关于推理范围的说明。 我们的方法默认不执行状态重置,因此最大推理范围受限于训练数据集中所见的最远距离。超出该距离后,需要执行状态重置。如果观察到姿态崩溃,请切换到窗口模式(
--mode windowed)——大多数情况下单独调整--keyframe_interval就足够了,其余窗口参数可保持默认。
窗口式推理(适用于长序列,>3000 帧)
python demo.py --model_path /path/to/lingbot-map-long.pt \
    --video_path video.mp4 --fps 10 \
    --mode windowed --window_size 128 --overlap_keyframes 16 --keyframe_interval 2
天空遮罩
天空遮罩使用一个 ONNX 天空分割模型,从重建的点云中过滤掉天空点,从而提升室外场景的可视化质量。
配置:
# 安装 onnxruntime(必需)
pip install onnxruntime        # CPU
# 或
pip install onnxruntime-gpu    # GPU(对于大图像集更快)
首次使用时,天空分割模型(skyseg.onnx)会自动从 HuggingFace 下载。
使用:
python demo.py --model_path /path/to/checkpoint.pt \
    --image_folder /path/to/images/ --mask_sky
天空遮罩会被缓存到 <image_folder>_sky_masks/ 目录中,后续运行会跳过重新生成。您也可以通过 --sky_mask_dir 指定自定义缓存目录,或通过 --sky_mask_visualization_dir 保存侧边对比遮罩可视化结果:
python demo.py --model_path /path/to/checkpoint.pt \
    --image_folder /path/to/images/ --mask_sky \
    --sky_mask_dir /path/to/cached_masks/ \
    --sky_mask_visualization_dir /path/to/mask_viz/
可视化选项
| 参数 | 默认值 | 描述 |
|---|---|---|
--port |
8080 |
Viser 查看器端口 |
--conf_threshold |
1.5 |
过滤低置信度点的可见性阈值 |
--point_size |
0.00001 |
点云点大小 |
--downsample_factor |
10 |
点云显示的空间降采样系数 |
性能与内存
未使用 FlashInfer(SDPA 回退)
python demo.py --model_path /path/to/checkpoint.pt \
    --image_folder /path/to/images/ --use_sdpa
在有限 GPU 内存上运行
如果遇到显存不足的问题,请尝试以下一种或两种方法:
--offload_to_cpu—— 推理期间将逐帧预测卸载到 CPU(默认启用;仅在内存充裕时使用--no-offload_to_cpu)。--num_scale_frames 2—— 将双向尺度帧数从默认的 8 减少到 2,从而缩小初始尺度阶段的激活峰值。
更快的推理
降低相机头部的迭代细化步数,以少量姿态精度换取更快的墙上时间:
python demo.py --model_path /path/to/checkpoint.pt \
    --image_folder /path/to/images/ --camera_num_iterations 1
--camera_num_iterations 默认为 4;设为 1 可跳过相机头部的三次细化步骤(同时将其 KV 缓存缩小 4 倍)。
🎥 离线渲染管线(demo_render/batch_demo.py)
当序列太长无法在交互式 viser 查看器中渲染时,请使用此管线——例如上方特色室内漫游。demo_render/batch_demo.py 是一站式离线入口:输入视频或图像文件夹,它将运行模型推理并直接生成一个无头点云飞越 MP4 视频。它与 demo.py 共用相同的 PyTorch / FlashInfer / 检查点栈。
对于受限于有限显存或 GPU 使用的用户,也可参考以下实现:https://github.com/ureeey/lingbot-map-rtx4060-8g/commit/eeee84a89cc97c1e39b736b46df4ee315275700b
安装(在主安装基础上扩展)
1. 渲染 Python 依赖
pip install -e ".[vis,render]"
render 会拉取 open3d>=0.19 和 pyyaml(核心的 numpy<2 约束来自基础的 lingbot-map 安装)。本管线中的天空遮罩使用 onnxruntime-gpu 进行批处理分割;如果您还没有安装 CPU 版 onnxruntime,请安装它:
pip install onnxruntime-gpu
2. Kaolin —— 必须与上述推荐的 PyTorch 2.8.0 + CUDA 12.8 匹配:
pip install --index-url https://pypi.org/simple \
    kaolin -f https://nvidia-kaolin.s3.us-east-2.amazonaws.com/torch-2.8.0_cu128.html
使用
--index-url https://pypi.org/simple可以绕过内部镜像,避免其提供 PyPI 占位 wheel(导入时会引发ImportError)。 NVIDIA Kaolin 没有为 PyTorch 2.9.x 发布预编译 wheel——如果您因其他原因使用 2.9,请从源码编译 Kaolin(pip install --no-build-isolation git+https://github.com/NVIDIAGameWorks/kaolin.git,需要本地 CUDA 工具包)。其他 torch/CUDA 组合请参阅 NVIDIA Kaolin 安装文档。
3. ffmpeg
sudo apt install ffmpeg # 或:brew install ffmpeg
4. CUDA 扩展(首次运行前必需)
cd demo_render/render_cuda_ext && python setup.py build_ext --inplace && cd ../..
这会就地编译 voxel_morton_ext 和 frustum_cull_ext——这两个扩展均被 rgbd_render 用于 GPU 体素化和视锥体裁剪。
工作示例——长室内漫游(约 25,000 帧,13 分钟)
数据集: 从 Hugging Face 上的 robbyant/lingbot-map-demo 下载示例视频。
    python demo_render/batch_demo.py \
    --video_path /data/demo_videos/indoor_travel.MP4 \
    --output_folder /data/outputs/indoor_travel/ \
    --model_path /path/to/lingbot-map.pt \
    --config demo_render/config/indoor.yaml \
    --mode windowed --window_size 128 \
    --keyframe_interval 13 --overlap_keyframes 8 \
    --sky_mask_dir /data/outputs/sky_masks \
    --sky_mask_visualization_dir /data/outputs/sky_mask_viz \
    --camera_vis default --keyframes_only_points \
    --frame_tag --frame_tag_position top_right \
    --save_predictions
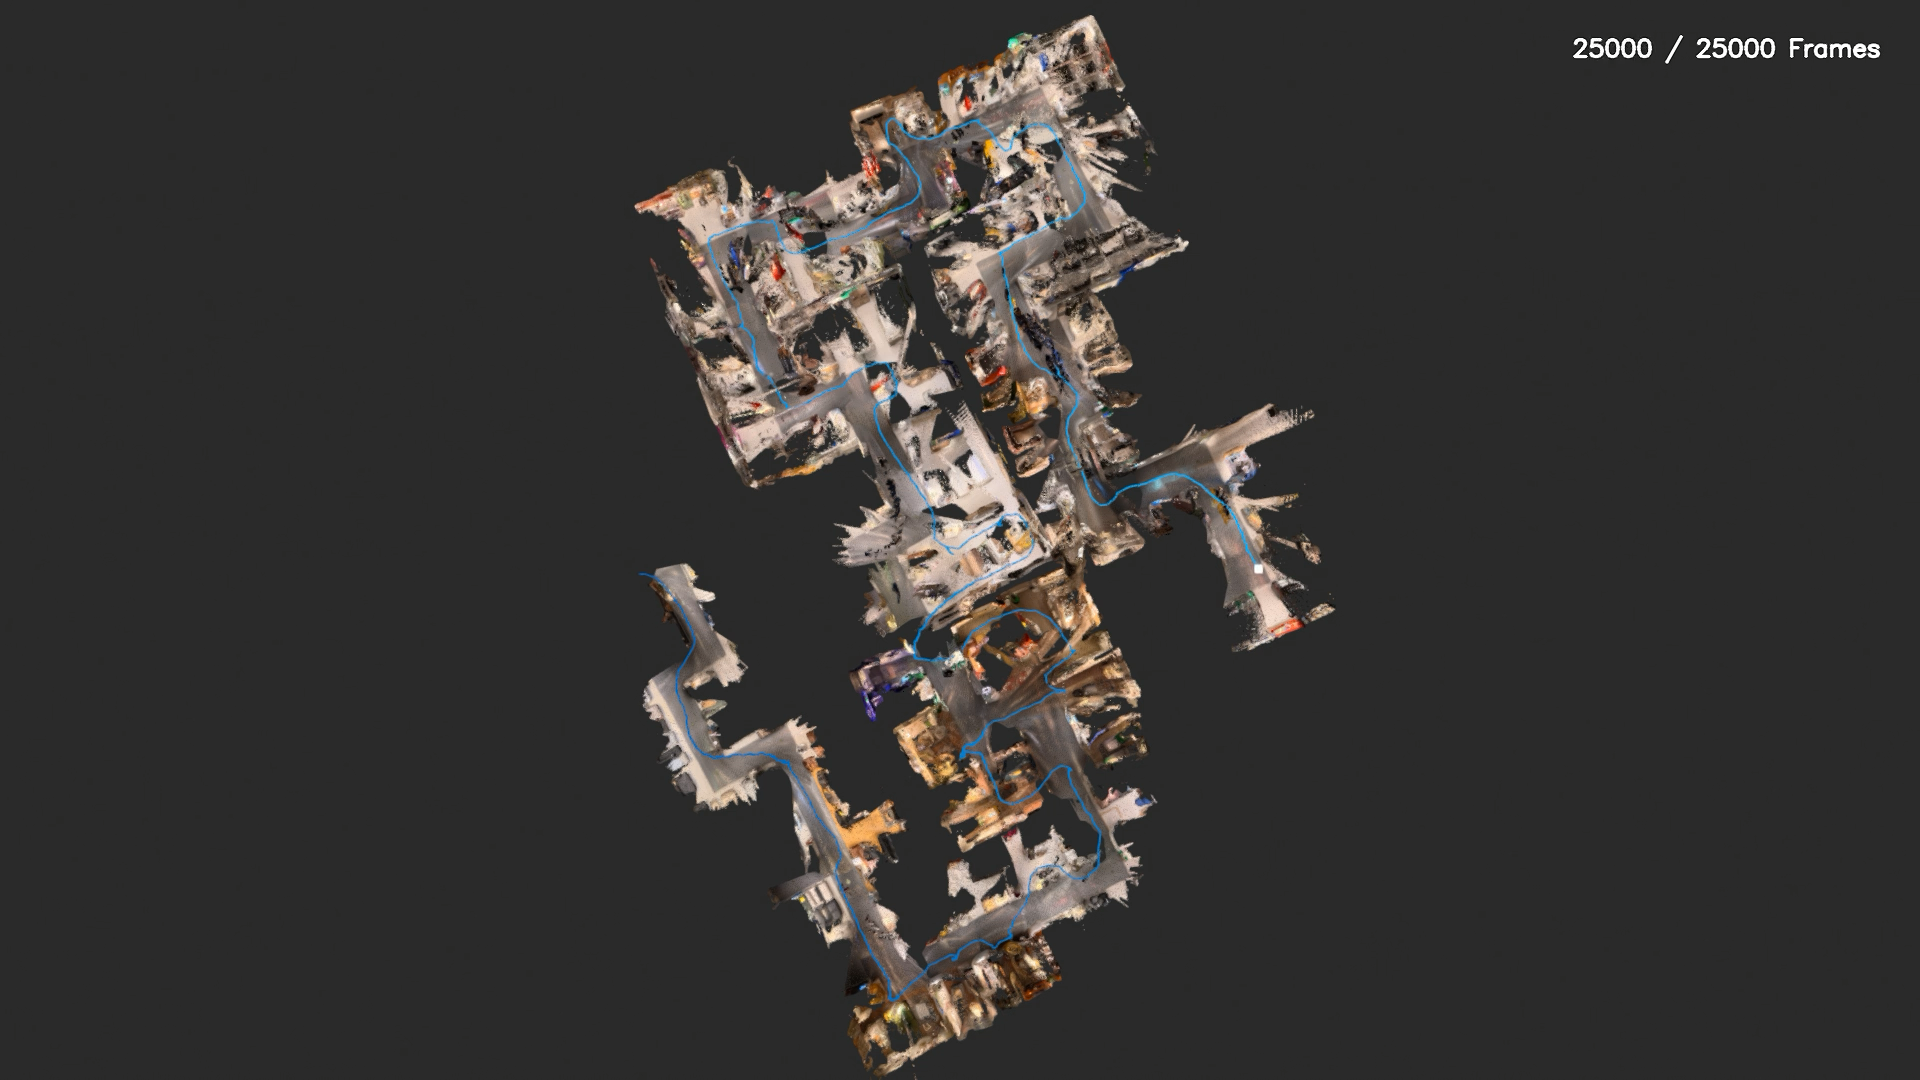
参数说明:
| 参数 | 为什么存在 |
|---|---|
--mode windowed --window_size 128 |
一旦序列超过约 320 帧的 RoPE 训练范围,就需要滑动窗口推理;每个窗口会重置 KV 缓存。window_size 统计的是 KV 缓存槽位,而非实际帧数——前 num_scale_frames(=8)个槽位存放尺度帧,剩余 128 − 8 = 120 个槽位存放关键帧。当 keyframe_interval = 13 时,一个窗口因此覆盖 8 + 120 × 13 = 1568 个实际帧。 |
--keyframe_interval 13 |
仅缓存每第 13 帧作为关键帧。非关键帧仍生成逐帧预测,但不增长 KV 缓存。 |
--overlap_keyframes 8 |
相邻窗口共享 8 个关键帧的上下文,内部解析为 max(num_scale_frames, 8 × keyframe_interval) = 8 × 13 = 104 个实际帧的重叠。当 keyframe_interval > 1 时推荐使用,以保持跨窗口姿态对齐的稳定性。 |
--config demo_render/config/indoor.yaml |
从室内预设中植入渲染/场景/相机/覆盖的默认值(短深度,更紧的跟随相机)。用户显式传入的任何 CLI 参数仍会覆盖 YAML 中的值。 |
--sky_mask_dir / --sky_mask_visualization_dir |
将天空遮罩及其侧边对比可视化结果持久化到磁盘,这样后续重新运行时可以直接复用,无需重新运行 ONNX 分割。(渲染管线仅在通过 YAML 预设或 --mask_sky 开启天空遮罩时才消费这些结果。) |
--camera_vis default |
在渲染视频上叠加轨迹痕迹 + 最近帧的点。 |
--keyframes_only_points |
仅将关键帧深度反投影到点云中;非关键帧仍会贡献其姿态到轨迹/视锥体叠加中。对于超长序列,可使点云保持稀疏。 |
--frame_tag --frame_tag_position top_right |
在 MP4 右上角添加 <i> / <N> Frames 计数器。 |
--save_predictions |
将逐帧 NPZ 与 MP4 一起持久化保存。便于后续检查或使用不同的相机/覆盖设置重新渲染。 |
相机路径(YAML)
虚拟相机路径由通过 --config 传入的 YAML 预设中的 camera.segments 列表描述。编辑 YAML 即可设计您自己的镜头——无需触碰 CLI 参数。
内置预设存放在 demo_render/config/:default.yaml、indoor.yaml、indoor_overview.yaml、outdoor_large.yaml、outdoor_large_overview.yaml、surrounding.yaml、lingbo_world.yaml。复制一份后编辑其中的 camera: 块即可。
YAML 结构
camera:
  fov: 60.0          # 相机视场角(度)
  transition: 30     # 相邻片段之间混合的帧数
  segments:
    - mode: follow            # 追逐相机,跟随输入轨迹
      frames: [0, 1500]       # 该片段覆盖的渲染帧范围(-1 表示结尾)
      back_offset: 0.3        # 输入相机后方偏移量(场景尺度的比例)
      up_offset: 0.08         # 输入相机上方抬升量
      look_offset: 0.4        # 注视目标点前方的偏移量
      smooth_window: 30       # 轨迹平滑窗口(帧)
    - mode: birdeye           # 升高到俯瞰视角,展示整个场景
      frames: [1500, 1800]
      reveal_height_mult: 2.5 # 鸟瞰高度 = 场景尺度 × 此因子
    - mode: follow            # 回落回追逐相机
      frames: [1800, -1]
      back_offset: 0.3
      up_offset: 0.08
      look_offset: 0.4
transition 控制相邻片段之间混合的帧数;frames: [0, -1] 表示“整个序列”。
可用模式
| 模式 | 行为 | 可调字段 |
|---|---|---|
follow |
追逐相机,通过平滑偏移跟踪输入轨迹。漫游中最具电影感的选择。 | back_offset, up_offset, look_offset, smooth_window, scale_frames |
birdeye |
俯瞰整个场景。适合英雄/概览镜头。 | reveal_height_mult |
static |
固定视点与注视点,从片段起始帧自动推导。 | — |
pivot |
固定视点,注视点沿轨迹扫描。 | — |
单片段 YAML 示例
纯跟随模式(最常见):
camera:
  fov: 60.0
  segments:
    - mode: follow
      frames: [0, -1]
      back_offset: 0.3
      up_offset: 0.08
      look_offset: 0.4
      smooth_window: 30
全鸟瞰模式(适合概览/英雄镜头):
camera:
  fov: 60.0
  segments:
    - mode: birdeye
      frames: [0, -1]
      reveal_height_mult: 2.5
跟随模式与鸟瞰插入:只需在 segments: 下按顺序列出多个片段,相邻片段会使用 transition 帧进行插值。
注意:当
--config加载 YAML 预设时,传递任何影响片段形状的 CLI 参数(--camera_mode、--back_offset、--up_offset、--look_offset、--smooth_window、--follow_scale_frames、--birdeye_start、--birdeye_duration、--reveal_height_mult)都会丢弃 YAML 中的segments,转而根据这些参数重建相机路径。要完全由 YAML 驱动,不要在命令行传递任何此类参数。
输出文件
对于给定的输出名称(例如 <scene> 或 <video_name>):
| 文件 | 描述 |
|---|---|
<name>_pointcloud.mp4 |
渲染的点云飞越视频 |
<name>_pointcloud_rgb.mp4 |
原始 RGB 帧压缩为视频 |
<name>_pointcloud_config.yaml |
本次运行的完整配置快照 |
batch_results.json |
每个场景的成功/耗时摘要 |
📜 许可证
本项目采用 Apache 许可证 2.0 发布。详见 LICENSE 文件。
📖 引用
@article{chen2026geometric,
  title={Geometric Context Transformer for Streaming 3D Reconstruction},
  author={Chen, Lin-Zhuo and Gao, Jian and Chen, Yihang and Cheng, Ka Leong and Sun, Yipengjing and Hu, Liangxiao and Xue, Nan and Zhu, Xing and Shen, Yujun and Yao, Yao and Xu, Yinghao},
  journal={arXiv preprint arXiv:2604.14141},
  year={2026}
}
✨ 致谢
我们感谢 Shangzhan Zhang、Jianyuan Wang、Yudong Jin、Christian Rupprecht 和 Xun Cao 的有益讨论与支持。
本项目基于多个优秀的开源项目构建: