PaddleOCR

轻量级多语言 OCR 工具包,将 PDF 和图像转为 LLM 可用的结构化数据(Markdown/JSON)。集成了 PaddleOCR-VL 视觉语言模型和 PP-StructureV3,在 OmniDocBench 上达到 96.3% 的准确率,支持 100+ 语言,并对表格、公式、古籍等复杂元素有专项优化。已被 Dify、RAGFlow 等 AI 项目广泛集成,适合 RAG 和 Agent 场景下的文档解析。
README
全球领先的 OCR 工具包与文档 AI 引擎
English | 简体中文 | 繁體中文 | 日本語 | 한국어 | Français | Русский | Español | العربية
PaddleOCR 将 PDF 文档和图像转换为结构化的、可直接用于 LLM 的数据(JSON/Markdown),精度行业领先。拥有 70k+ Star,被 Dify、RAGFlow 和 Cherry Studio 等顶级项目信赖,PaddleOCR 是构建智能 RAG 和 Agent 应用的基石。
🚀 核心特性
📄 智能文档解析(适用于 LLM)
将杂乱的视觉信息转化为结构化数据,迎接 LLM 时代。
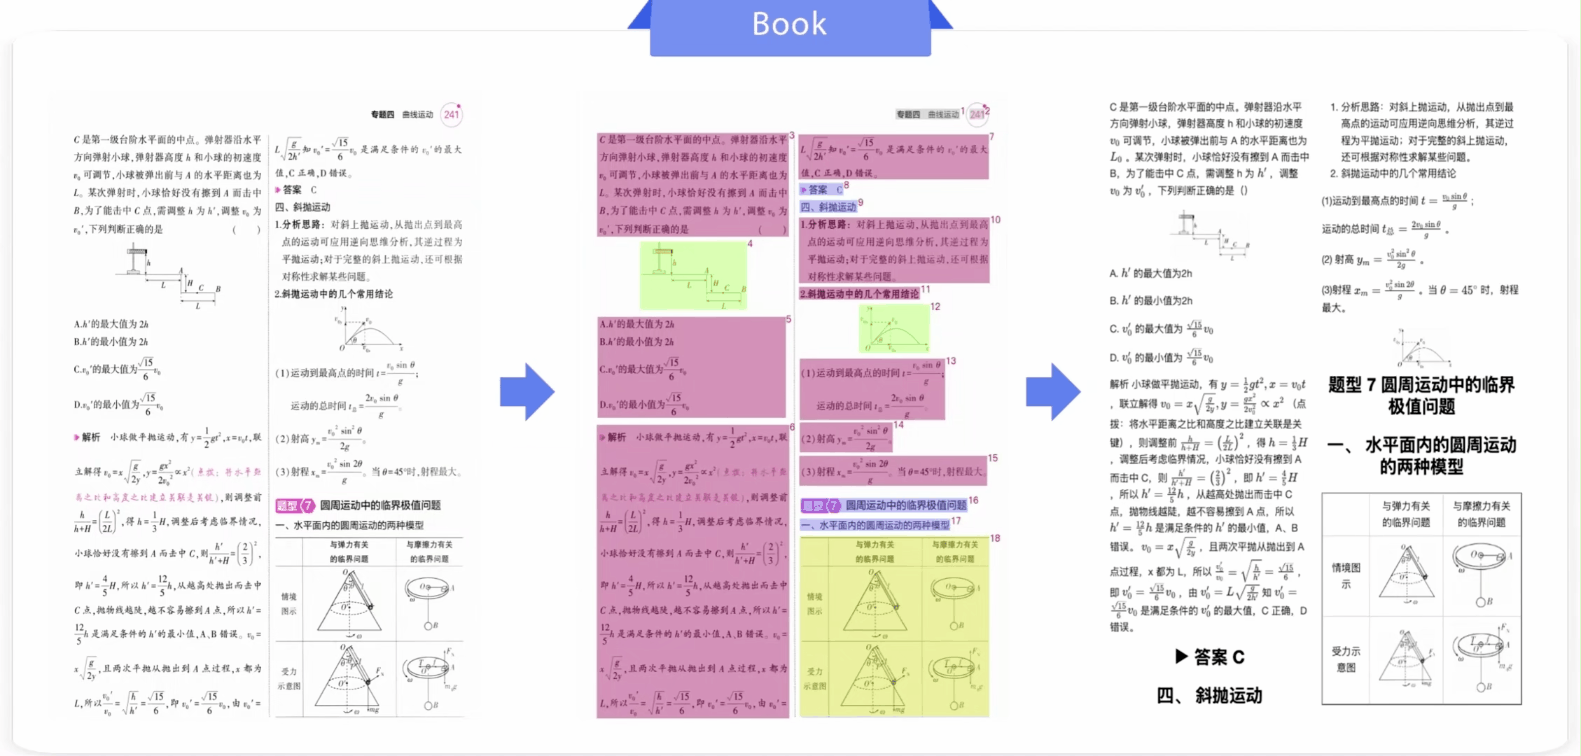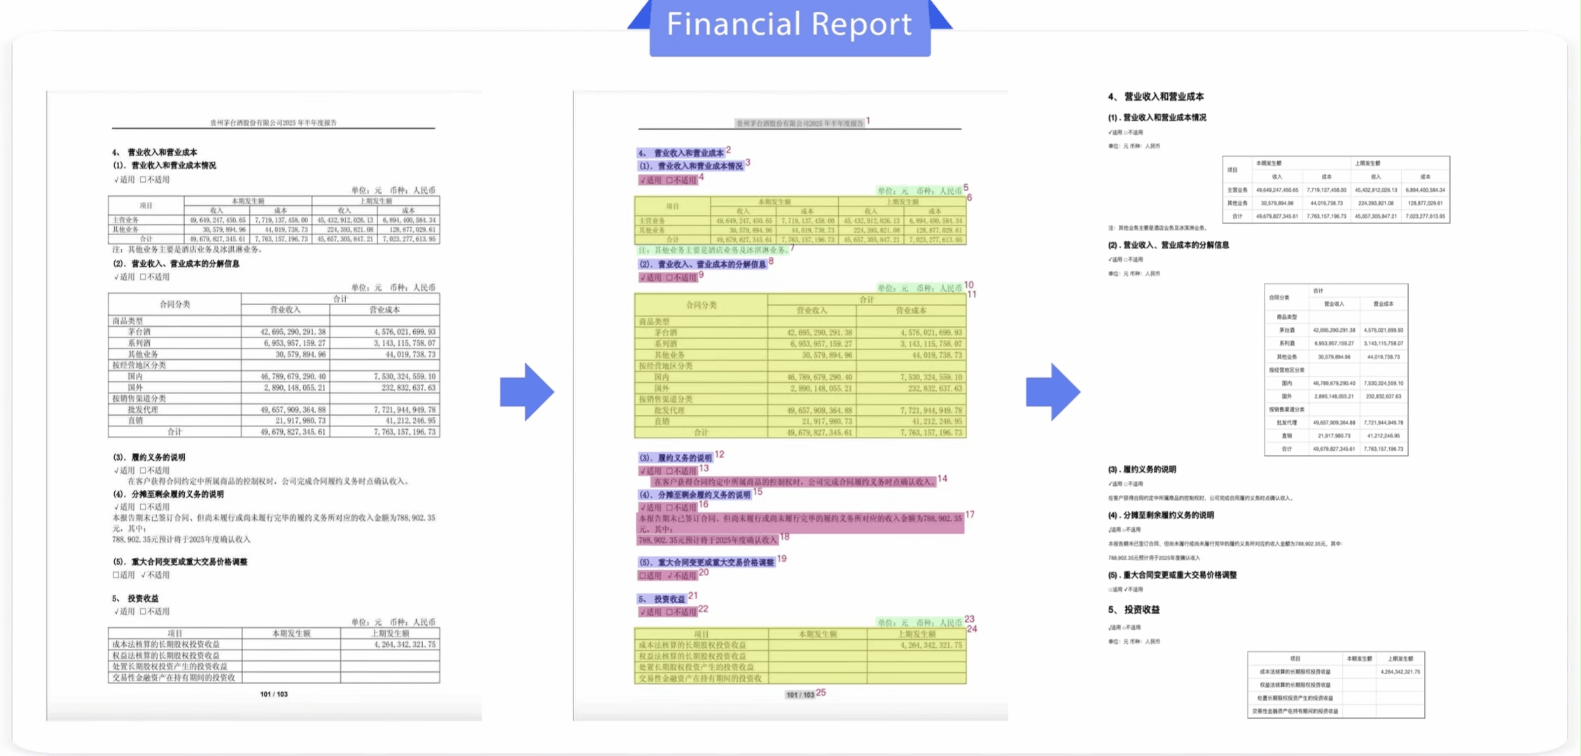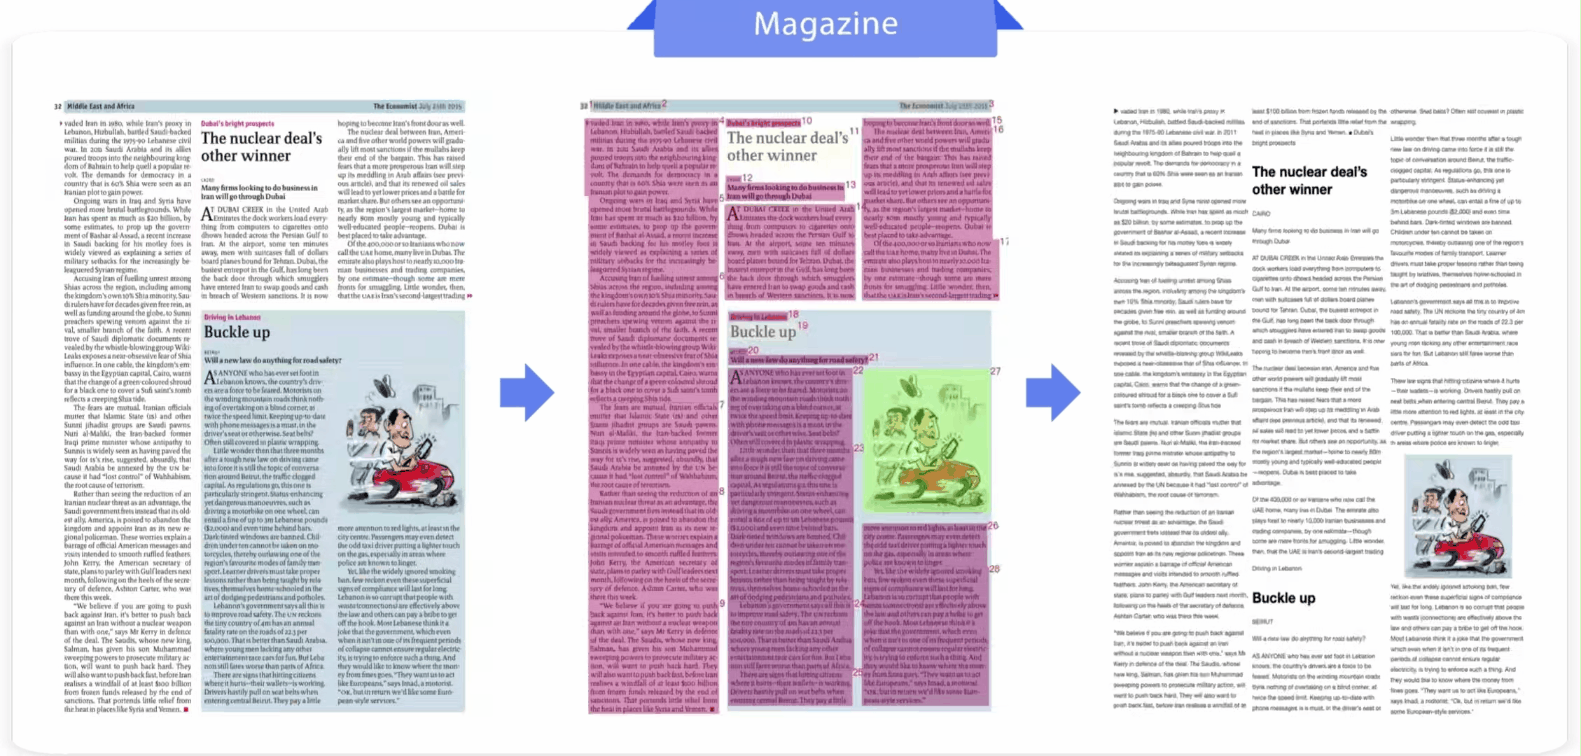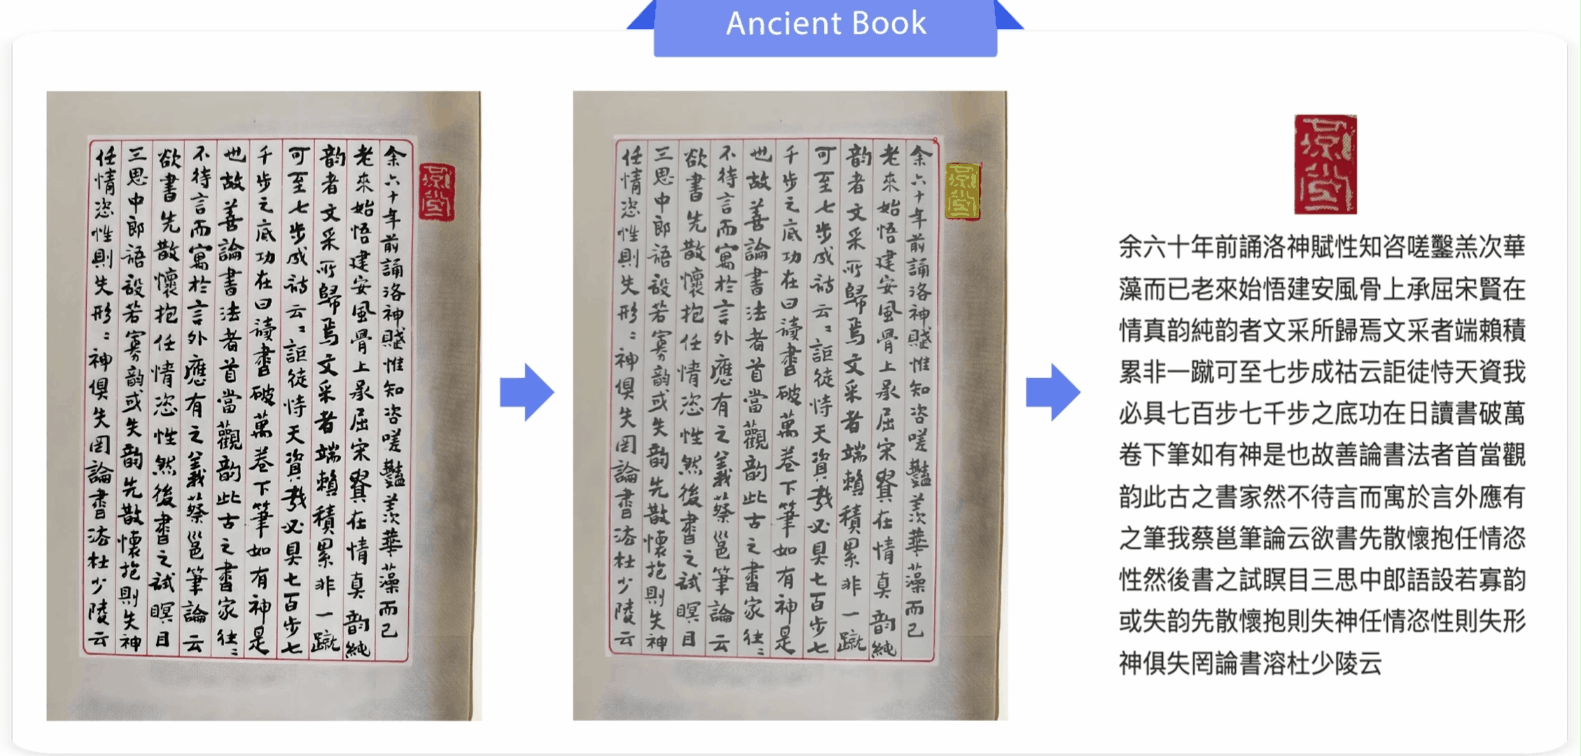
- SOTA 文档 VLM:搭载 PaddleOCR-VL-1.6 (0.9B),业界领先的轻量级文档解析视觉语言模型。在 OmniDocBench v1.6 上达到 96.3% 准确率,在文本、公式和表格识别方面均处于领先地位,并对古籍、生僻字、印章和图表展现出显著增强的能力,支持 Markdown 和 JSON 格式的结构化输出。
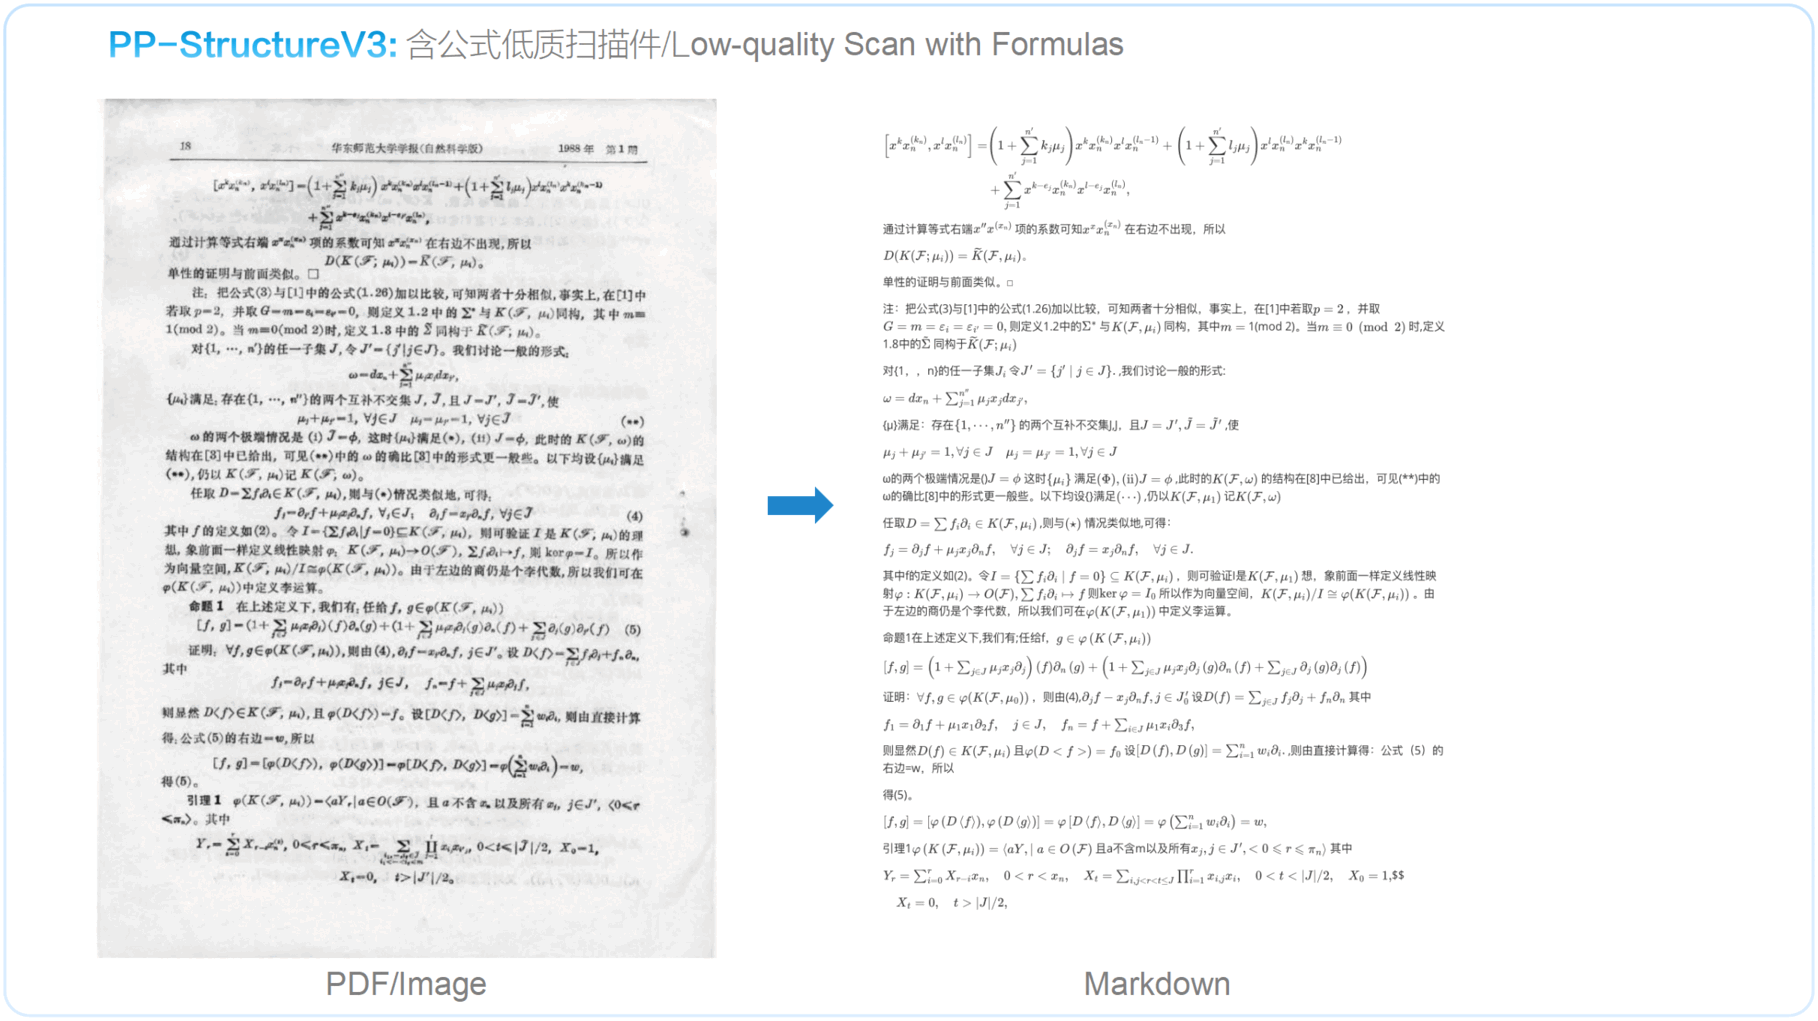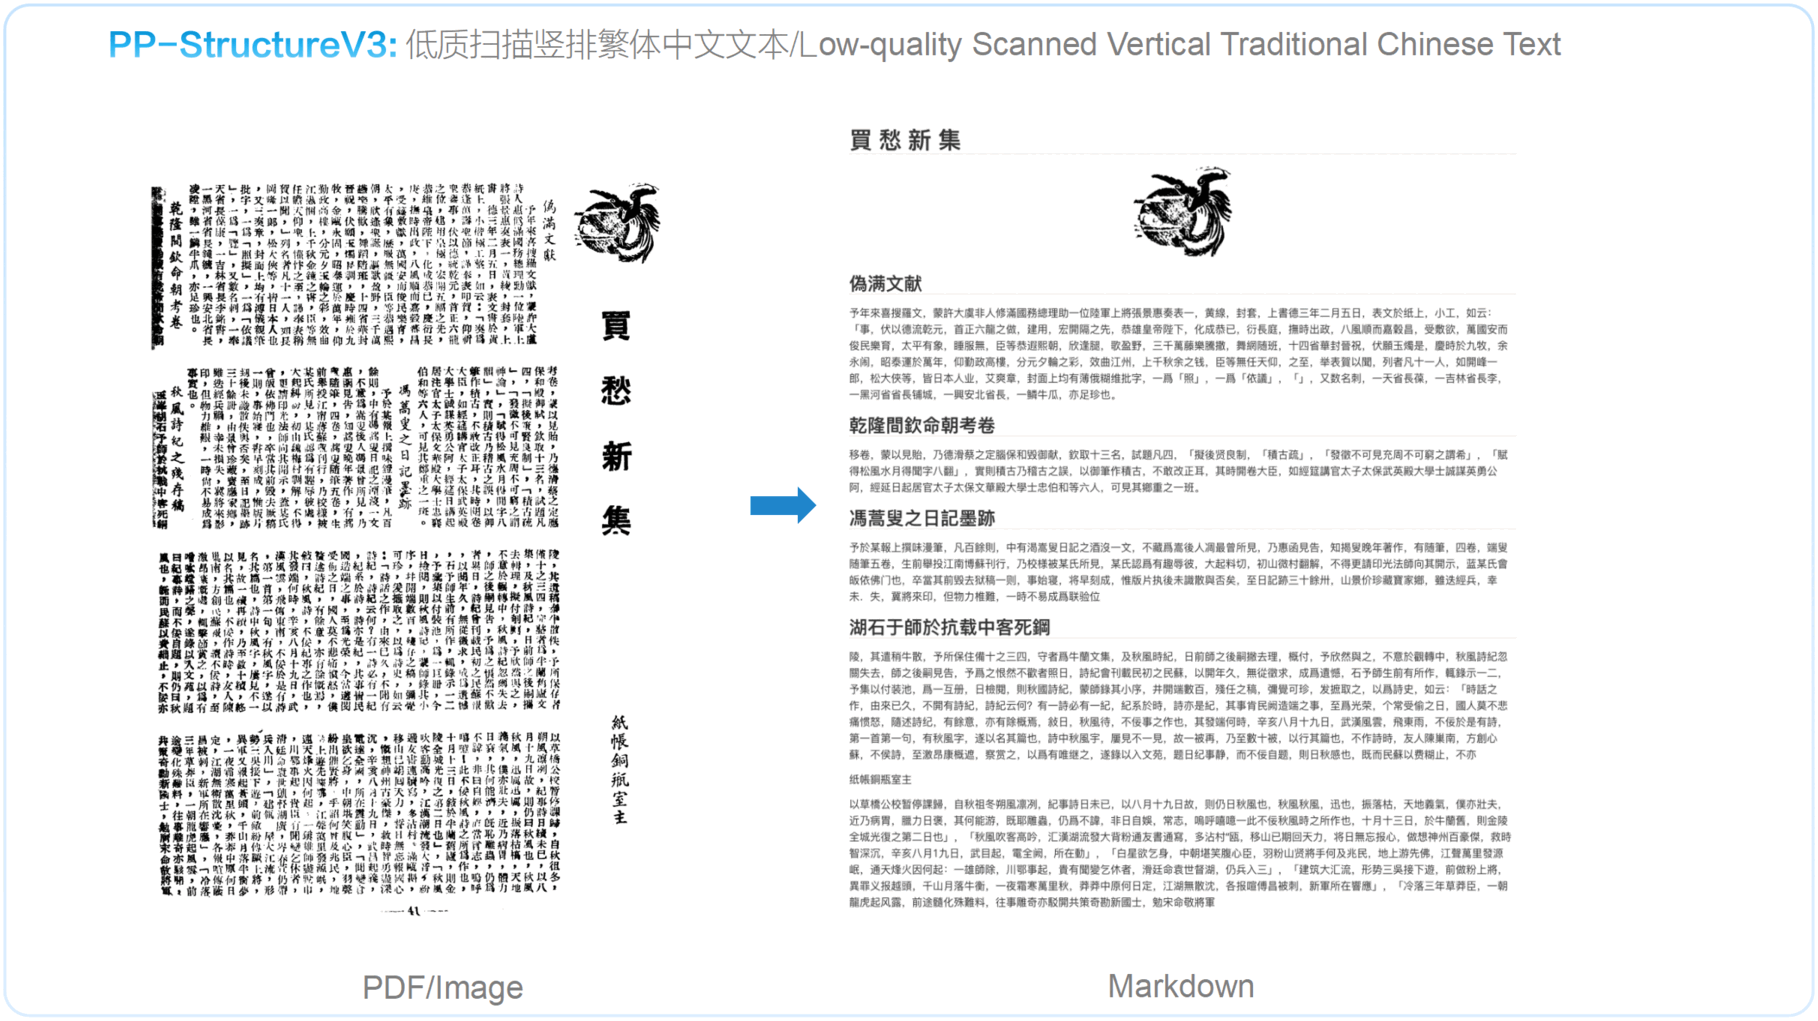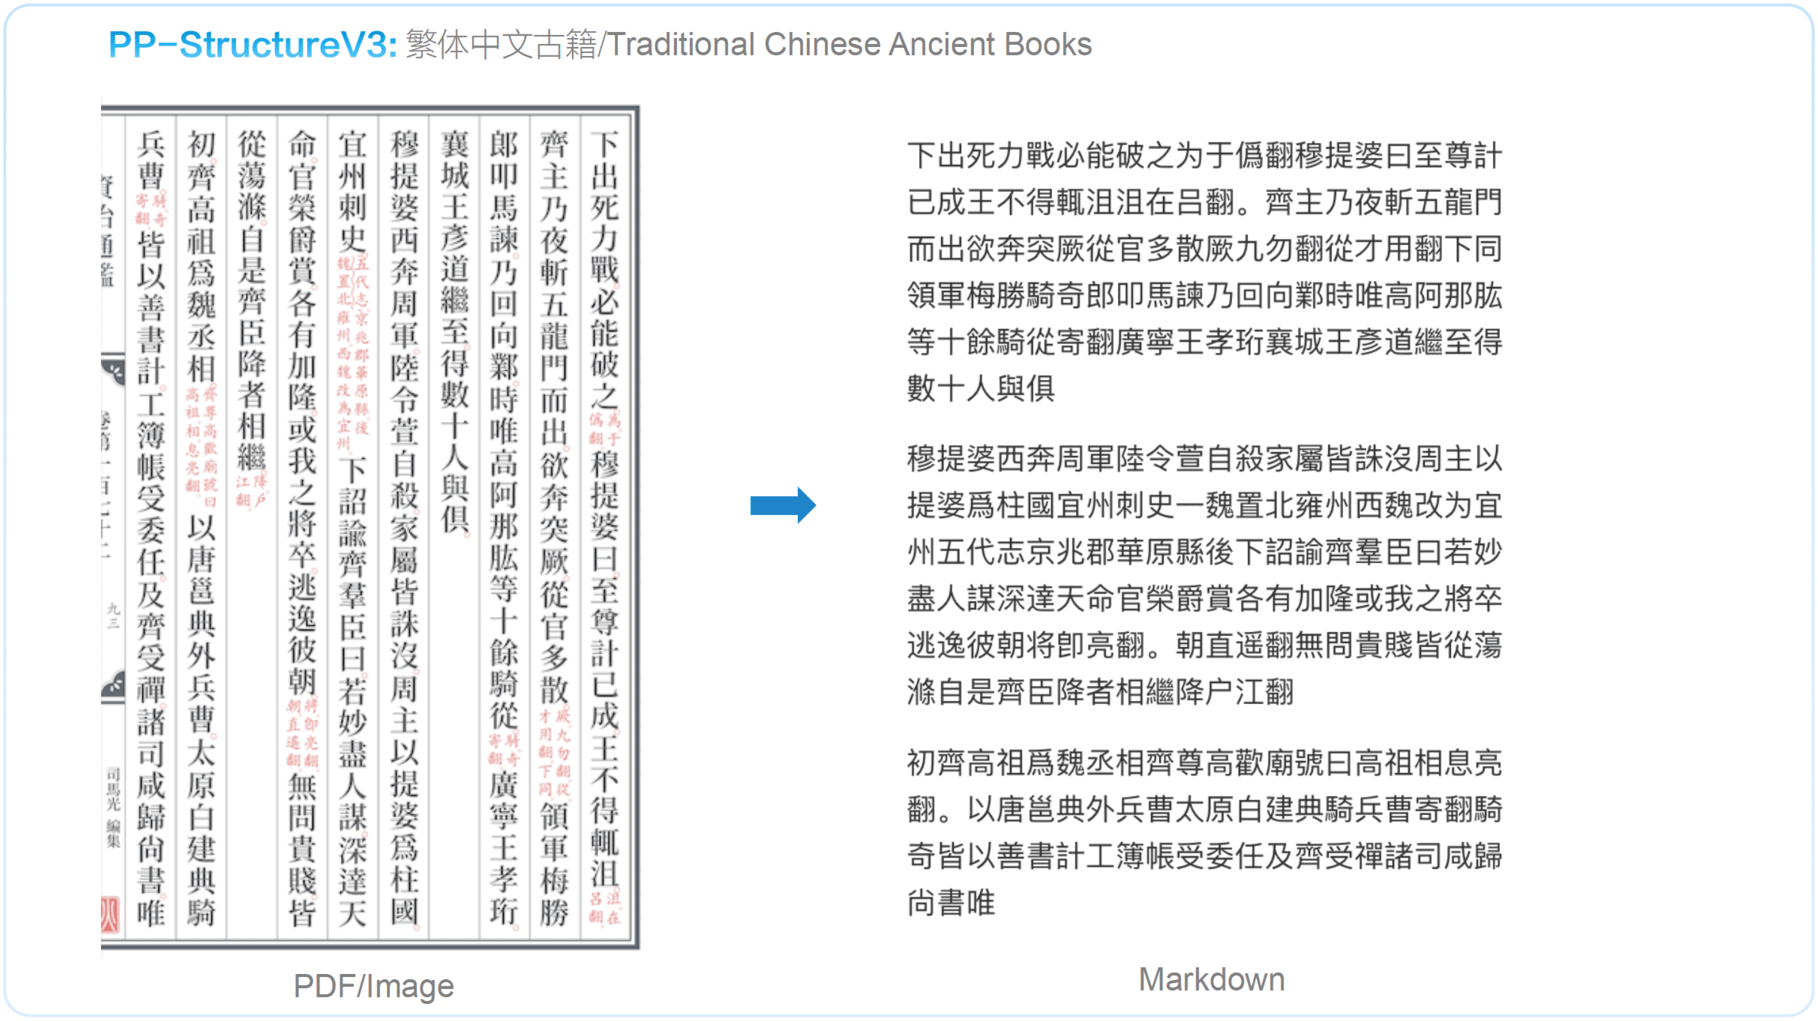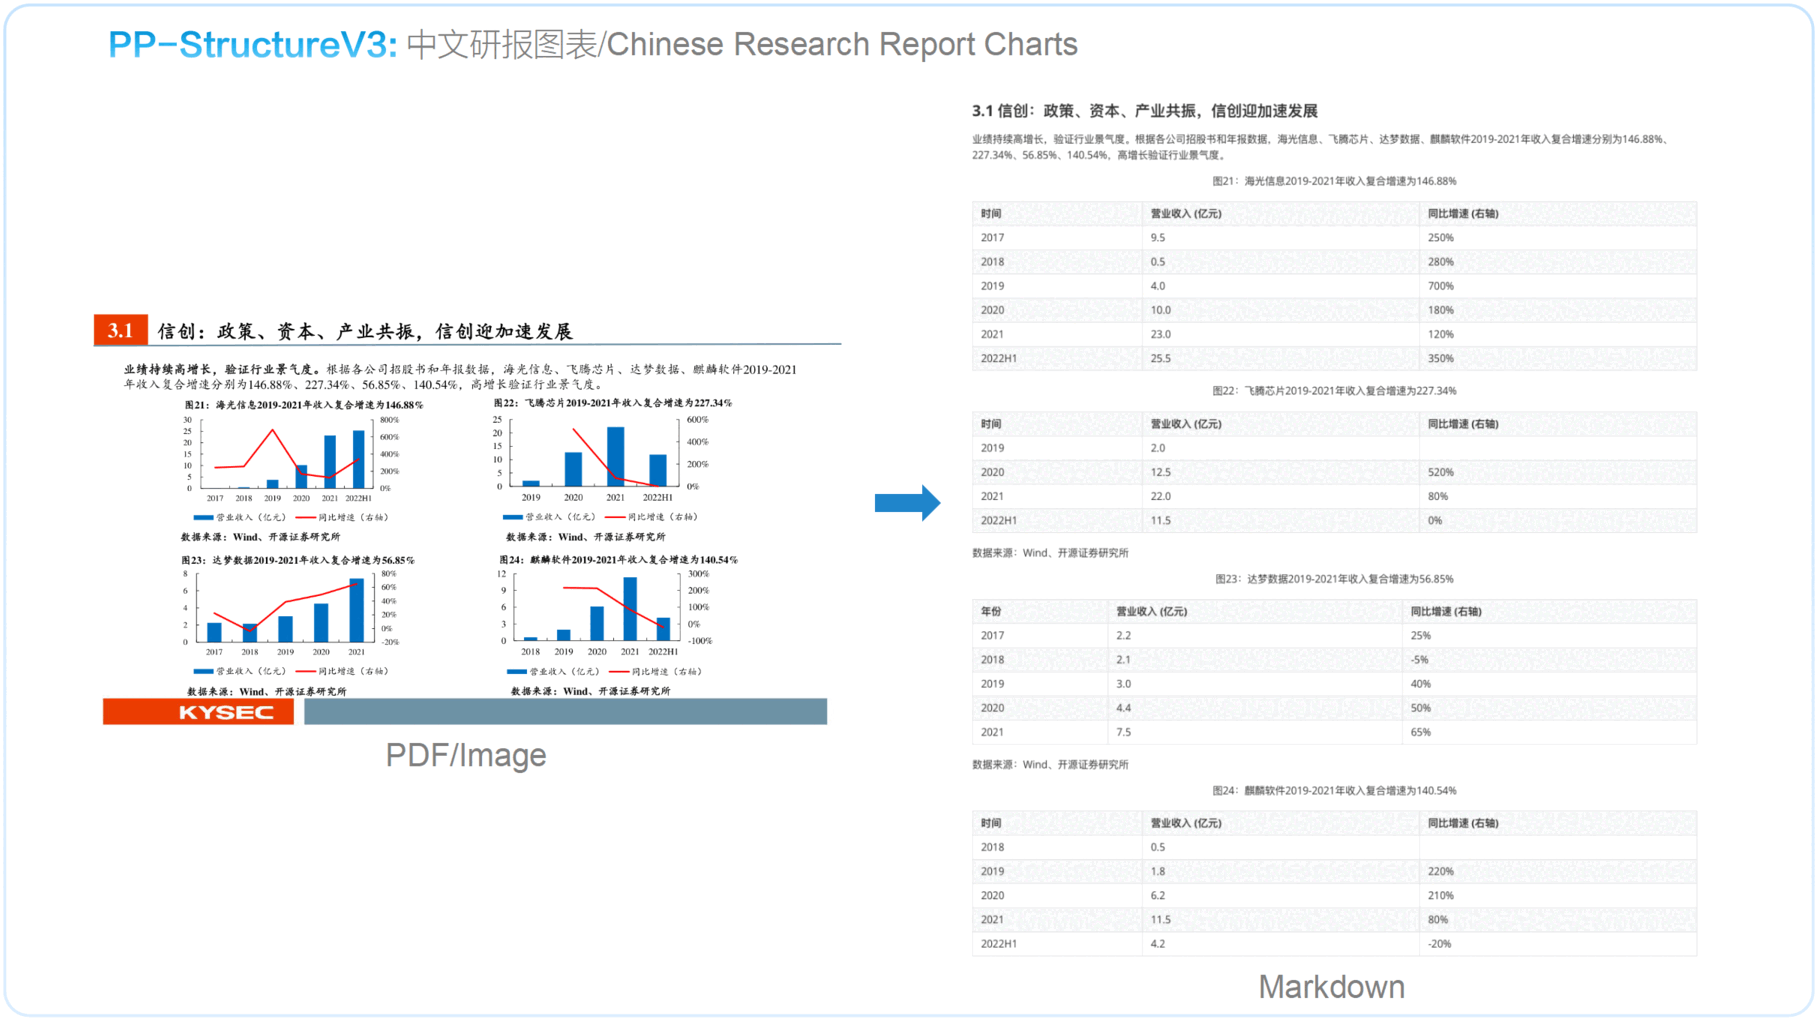
- 结构感知转换:由 PP-StructureV3 驱动,将复杂的 PDF 和图像无缝转换为 Markdown 或 JSON。与 PaddleOCR-VL 系列模型不同,它提供更细粒度的坐标信息,包括表格单元格坐标、文本坐标等。
- 生产就绪效率:以超小的模型尺寸实现商业级准确率。在公开基准测试中超越众多闭源方案,同时保持资源高效,适用于边缘/云端部署。
🔍 通用文字识别(场景 OCR)
全球高速、多语言文本检测的金标准。
- 支持 100+ 语言:原生支持庞大的全球语言库。我们的 PP-OCRv5 单模型方案优雅地处理多语言混合文档(中文、英文、日文、拼音等)。
- 复杂元素掌握:除了标准文本识别,我们还支持广泛环境下的自然场景文本检测,包括身份证、街景、书籍和工业零件。
- 性能飞跃:PP-OCRv5 相比前代准确率提升 13%,保持了 PaddleOCR 闻名的“极致高效”。
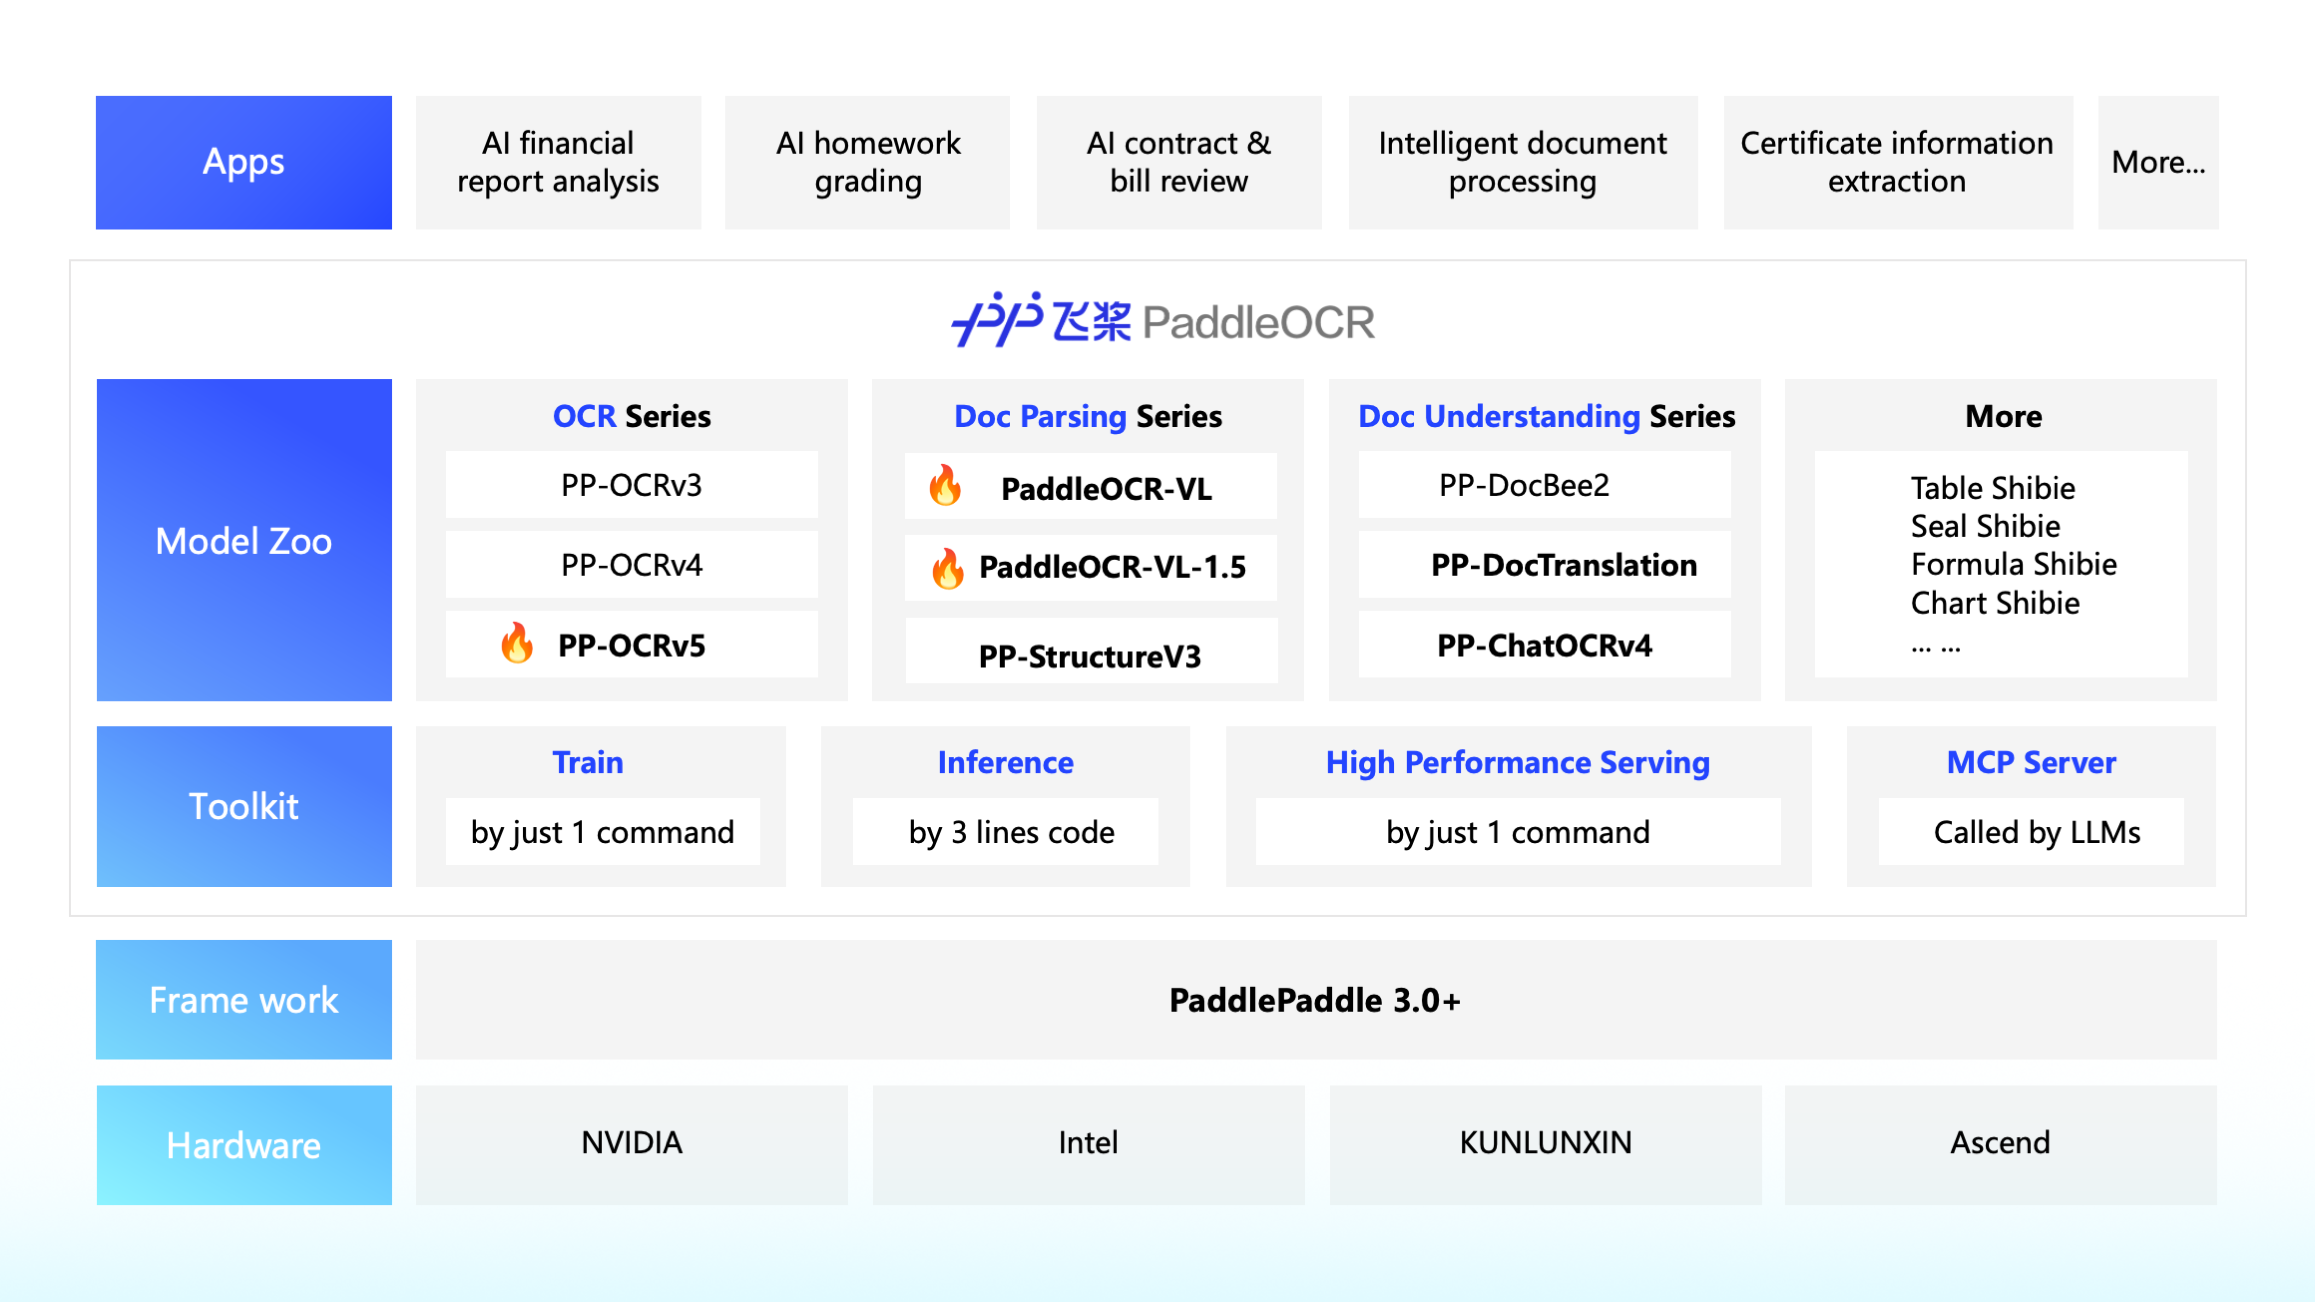
🛠️ 开发者生态体系
- 无缝集成:AI Agent 生态系统的首选——与 Dify、RAGFlow、Pathway 和 Cherry Studio 深度集成。
- LLM 数据飞轮:提供完整的流水线以构建高质量数据集,为大语言模型微调提供可持续的“数据引擎”。
- 一键部署:支持多种硬件后端(NVIDIA GPU、Intel CPU、昆仑 XPU 及多样 AI 加速器)。
📣 近期更新
🔥 2026.05.28:发布 PaddleOCR 3.6.0
PaddleOCR-VL-1.6 亮点:
- 全新 SOTA 准确率:在 OmniDocBench v1.6 上达到 96.3% 以上,同时在 OmniDocBench v1.5 和 Real5-OmniDocBench 上创下新 SOTA,在文本、公式和表格识别方面领先于开源和专有方案。
- 全面能力升级:在表格、古籍和生僻字识别方面显著改进,多个场景下的印章识别、文本检测和图表理解能力显著增强。
- 无缝迁移:模型架构与 PaddleOCR-VL-1.5 完全一致,实现零成本适配——替换模型即可运行。
- 立即体验:可在 HuggingFace 或我们的官方网站获取。
- 灵活的推理后端:在 Paddle 静态图、Paddle 动态图或 Transformers 之间无缝切换。PaddleOCR 现已深度集成 Hugging Face 生态系统,20 个主要模型支持使用 Transformers 作为推理后端。
- Office 文档转 Markdown:将 Word、Excel 和 PowerPoint 等常见文档格式转换为 Markdown。
- 解析结果导出为 DOCX:
PaddleOCR-VL系列、PP-StructureV3和PP-DocTranslation现在支持将解析结果导出为 DOCX 格式,方便在 Microsoft Word 中查看和编辑。 - 官方浏览器推理 SDK:发布了
PaddleOCR.js,这是官方浏览器推理 SDK,支持直接在浏览器中运行PP-OCRv5。
- PaddleOCR-VL-1.5 (SOTA 0.9B VLM):我们最新的旗舰文档解析模型现已上线!
- OmniDocBench 上 94.5% 准确率:超越顶级通用大模型和专用文档解析器。
- 真实世界鲁棒性:首创 PP-DocLayoutV3 算法用于不规则形状定位,掌握 5 种困难场景:倾斜、弯曲、扫描、光照和屏幕翻拍。
- 能力扩展:现在支持印章识别、文本检测,并扩展到 111 种语言(包括藏文和孟加拉文)。
- 长文档掌握:支持自动跨页表格合并和层级标题识别。
- 立即体验:可在 HuggingFace 或我们的官方网站获取。
发布 PaddleOCR-VL:
模型介绍:
- PaddleOCR-VL 是一个针对文档解析的 SOTA 且资源高效的模型。其核心组件是 PaddleOCR-VL-0.9B,一个紧凑但强大的视觉语言模型(VLM),集成了 NaViT 风格的动态分辨率视觉编码器和 ERNIE-4.5-0.3B 语言模型,以实现精准的元素识别。这个创新模型高效支持 109 种语言,擅长识别复杂元素(如文本、表格、公式和图表),同时保持极低的资源消耗。通过广泛使用的公开基准和内部基准的全面评估,PaddleOCR-VL 在页面级文档解析和元素级识别方面均达到 SOTA 性能。它显著优于现有方案,与顶级 VLM 相比竞争力强,推理速度快。这些优势使其非常适合在实际场景中部署。模型已在 HuggingFace 上发布。欢迎下载使用!更多介绍信息请参阅 PaddleOCR-VL。
核心特性:
- 紧凑而强大的 VLM 架构:我们提出了一种新颖的视觉语言模型,专门设计用于资源高效推理,在元素识别方面表现卓越。通过将 NaViT 风格的动态高分辨率视觉编码器与轻量级 ERNIE-4.5-0.3B 语言模型相结合,我们显著提升了模型的识别能力和解码效率。这种集成保持了高准确率,同时降低了计算需求,非常适合高效实用的文档处理应用。
- 文档解析的 SOTA 性能:PaddleOCR-VL 在页面级文档解析和元素级识别方面均达到 SOTA 性能。它显著优于现有的流水线方案,在文档解析方面与领先的视觉语言模型(VLM)相比具有强竞争力。此外,它擅长识别复杂的文档元素,如文本、表格、公式和图表,适用于广泛的内容类型,包括手写文本和历史文档。这使其高度通用,适用于多种文档类型和场景。
- 多语言支持:PaddleOCR-VL 支持 109 种语言,覆盖全球主要语言,包括但不限于中文、英文、日文、拉丁文和韩文,以及不同文字系统和结构的语言,如俄语(西里尔字母)、阿拉伯语、印地语(天城文)和泰语。这种广泛的语言覆盖极大地增强了我们的系统在多语言和全球化文档处理场景中的适用性。
发布 PP-OCRv5 多语言识别模型:
- 改进了拉丁文字识别的准确率和覆盖范围;新增了对西里尔字母、阿拉伯语、天城文、泰卢固语、泰米尔语等语言系统的支持,覆盖 109 种语言的识别。模型仅 2M 参数,部分模型的准确率相比上一代提升了 40% 以上。
重要模型新增:
- 引入了 PP-OCRv5 识别模型在英文、泰文和希腊文上的训练、推理和部署。与主模型 PP-OCRv5 相比,英文模型在英文场景中提升了 11%,泰文和希腊文识别模型分别达到了 82.68% 和 89.28% 的准确率。
部署能力升级:
- 全面支持 PaddlePaddle 框架 3.1.0 和 3.1.1 版本。
- PP-OCRv5 C++ 本地部署方案全面升级,现同时支持 Linux 和 Windows,功能与 Python 实现保持一致,准确率无差异。
- 高性能推理现已支持 CUDA 12,可使用 Paddle Inference 或 ONNX Runtime 后端进行推理。
- 高稳定性服务化部署方案已完全开源,用户可根据自定义 Docker 镜像和 SDK。
- 高稳定性服务化部署方案也支持通过手动构造 HTTP 请求调用,支持使用任何编程语言的客户端代码开发。
基准测试支持:
- 所有产线均支持细粒度基准测试,可测量端到端推理时间以及每层和每模块的延迟数据,辅助性能分析。此处提供基准测试功能的设置和使用方法。
- 文档已更新,包含主流硬件上常用配置的关键指标(如推理延迟和内存使用),为用户提供部署参考。
Bug 修复:
- 解决了模型训练过程中日志保存失败的问题。
- 升级了公式模型的数据增强组件,以兼容新版本的 albumentations 依赖,并修复了多进程场景下使用 tokenizers 包时的死锁警告。
- 修复了 PP-StructureV3 配置文件中某些开关行为(例如
use_chart_parsing)与其他流水线不一致的问题。
其他增强:
- 分离了核心依赖和可选依赖。基础文本识别仅需最小化的核心依赖;文档解析和信息提取的额外依赖可按需安装。
- 在 Windows 上启用对 NVIDIA RTX 50 系列显卡的支持;用户可参考安装指南获取对应的 PaddlePaddle 框架版本。
- PP-OCR 系列模型现在支持返回单字符坐标。
- 新增 AIStudio、ModelScope 等模型下载源,允许用户指定模型下载来源。
- 通过 PP-Chart2Table 模块增加了图表转表格的支持。
- 优化了文档描述,提高可用性。
🚀 快速开始
第一步:在线试用
PaddleOCR 官方网站提供交互式 体验中心 和 API——无需设置,一键体验。
👉 访问官方网站
第二步:本地部署
如需本地使用,请根据需求参考以下文档:
- PP-OCR 系列:参见 PP-OCR 文档
- PaddleOCR-VL 系列:参见 PaddleOCR-VL 文档
- PP-StructureV3:参见 PP-StructureV3 文档
- 更多功能:参见 更多功能文档
🧩 更多特性
- 将模型转换为 ONNX 格式:获取 ONNX 模型。
- 使用 OpenVINO、ONNX Runtime、TensorRT 等引擎加速推理,或使用 ONNX 格式模型进行推理:高性能推理。
- 使用多 GPU 和多进程加速推理:流水线并行推理。
- 将 PaddleOCR 集成到 C++、C#、Java 等编写的应用程序中:服务化部署。
🔄 执行结果快速概览
PP-OCRv5
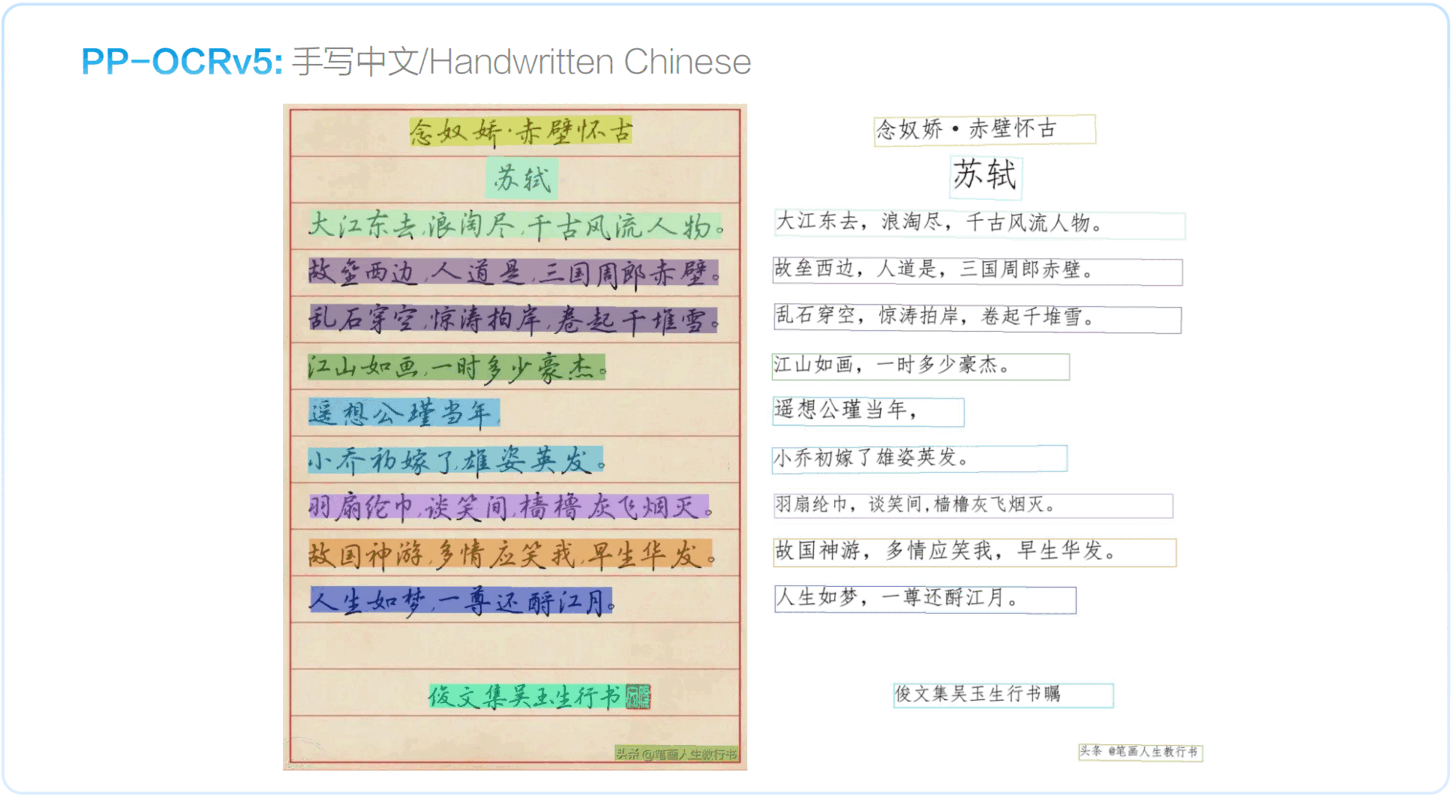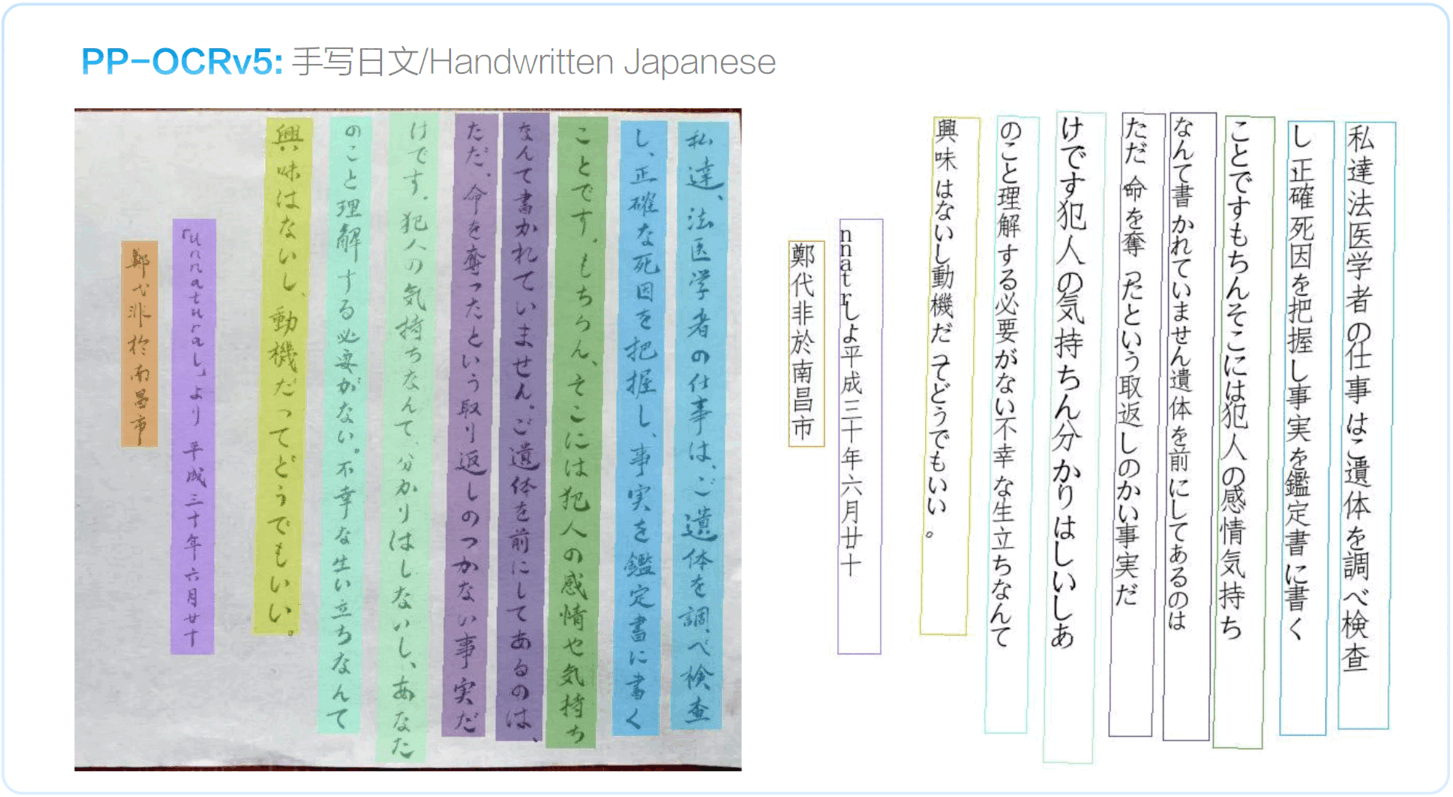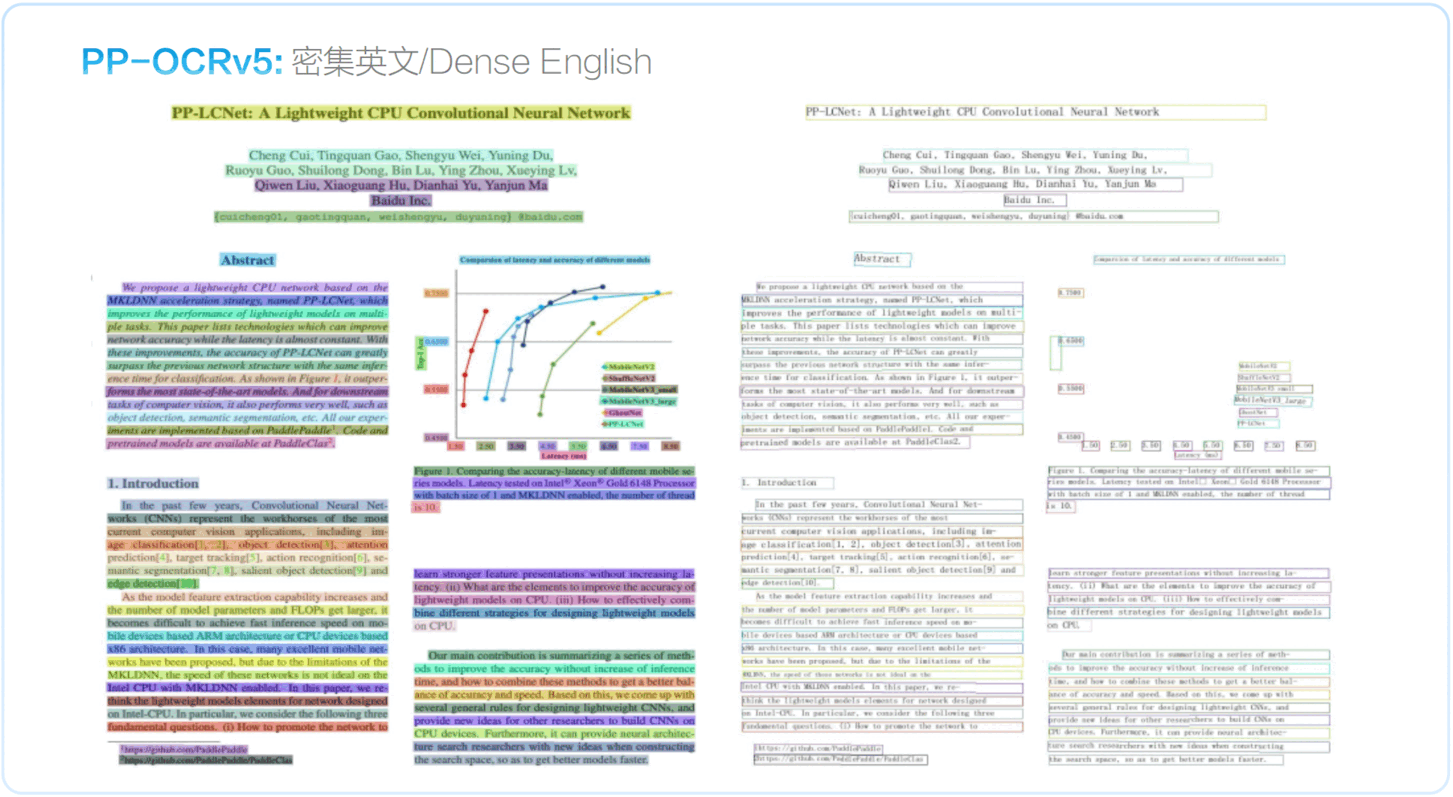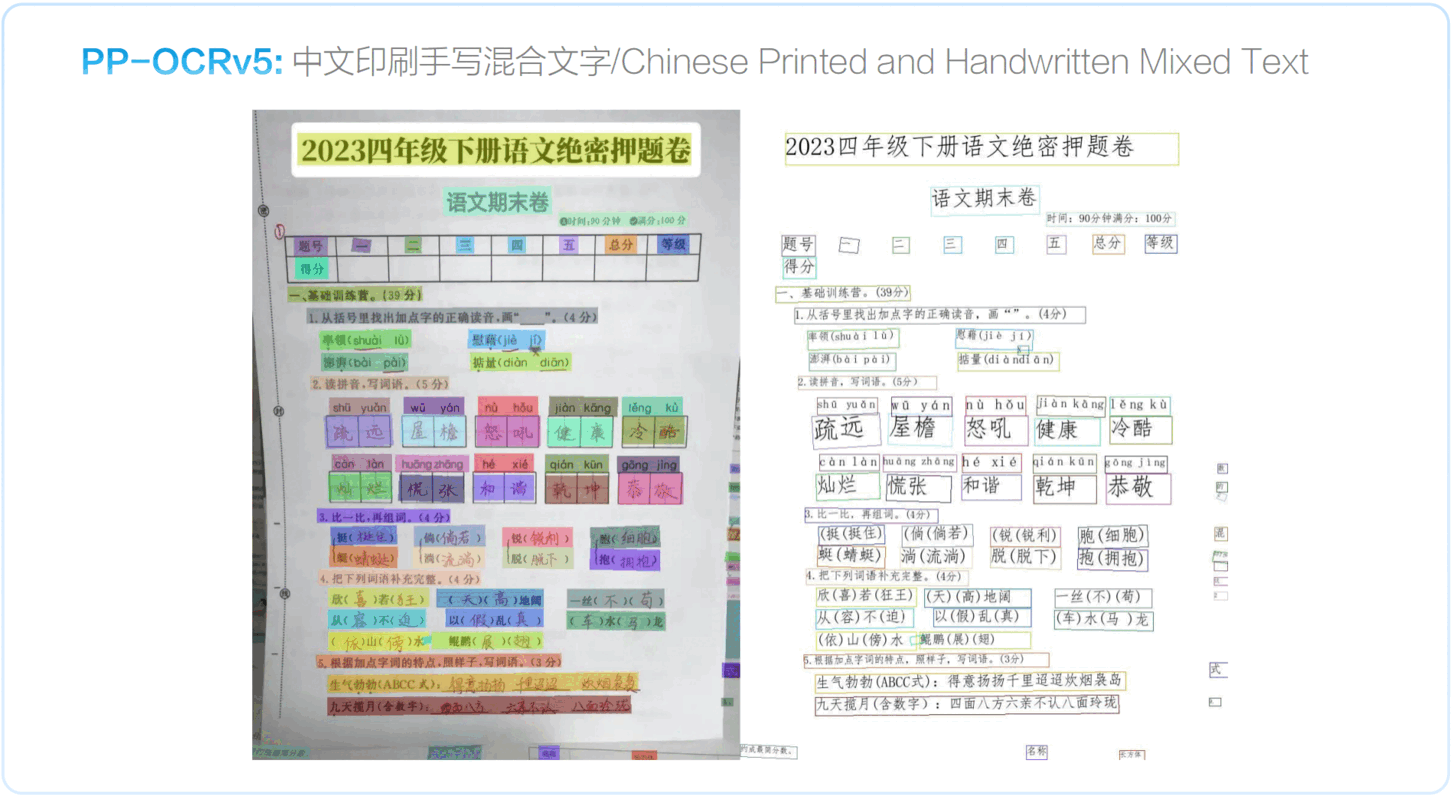
PP-StructureV3
PaddleOCR-VL
✨ 保持关注
⭐ 为这个仓库点星,以获取令人兴奋的更新和新版本,包括强大的 OCR 和文档解析功能! ⭐
👩👩👧👦 社区
| PaddlePaddle 微信公众号 | 加入技术讨论群 |
|---|---|
 |
 |
😃 基于 PaddleOCR 的优秀项目
PaddleOCR 能有今天的成就离不开其非凡的社区!💗 衷心感谢所有长期合作伙伴、新合作者以及每一位为 PaddleOCR 倾注热情的人——无论我们是否提到了您的名字。你们的支持是我们的动力!
| 项目名称 | 描述 |
|---|---|
Dify  |
可生产、支持 Agent 工作流开发的平台。 |
RAGFlow  |
基于深度文档理解的 RAG 引擎。 |
pathway  |
用于流处理、实时分析、LLM 流水线和 RAG 的 Python ETL 框架。 |
MinerU  |
多种类型文档转 Markdown 工具 |
Umi-OCR  |
免费、开源、批量的离线 OCR 软件。 |
cherry-studio  |
支持多种 LLM 提供商的桌面客户端。 |
haystack |
AI 编排框架,用于构建可定制、可生产的 LLM 应用。 |
OmniParser |
OmniParser:纯视觉 GUI Agent 的屏幕解析工具。 |
QAnything |
基于任何内容的问答系统。 |
| 了解更多项目 | 基于 PaddleOCR 的更多项目 |
👩👩👧👦 贡献者
🌟 Star
📄 许可证
本项目基于 Apache 2.0 许可证发布。
🎓 引用
@misc{cui2025paddleocr30technicalreport,
      title={PaddleOCR 3.0 Technical Report},
      author={Cheng Cui and Ting Sun and Manhui Lin and Tingquan Gao and Yubo Zhang and Jiaxuan Liu and Xueqing Wang and Zelun Zhang and Changda Zhou and Hongen Liu and Yue Zhang and Wenyu Lv and Kui Huang and Yichao Zhang and Jing Zhang and Jun Zhang and Yi Liu and Dianhai Yu and Yanjun Ma},
      year={2025},
      eprint={2507.05595},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2507.05595},
}

@misc{cui2025paddleocrvlboostingmultilingualdocument,
      title={PaddleOCR-VL: Boosting Multilingual Document Parsing via a 0.9B Ultra-Compact Vision-Language Model},
      author={Cheng Cui and Ting Sun and Suyin Liang and Tingquan Gao and Zelun Zhang and Jiaxuan Liu and Xueqing Wang and Changda Zhou and Hongen Liu and Manhui Lin and Yue Zhang and Yubo Zhang and Handong Zheng and Jing Zhang and Jun Zhang and Yi Liu and Dianhai Yu and Yanjun Ma},
      year={2025},
      eprint={2510.14528},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2510.14528},
}

@misc{cui2026paddleocrvl15multitask09bvlm,
      title={PaddleOCR-VL-1.5: Towards a Multi-Task 0.9B VLM for Robust In-the-Wild Document Parsing},
      author={Cheng Cui and Ting Sun and Suyin Liang and Tingquan Gao and Zelun Zhang and Jiaxuan Liu and Xueqing Wang and Changda Zhou and Hongen Liu and Manhui Lin and Yue Zhang and Yubo Zhang and Yi Liu and Dianhai Yu and Yanjun Ma},
      year={2026},
      eprint={2601.21957},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2601.21957},
}

@misc{zhang2026paddleocrvl16expandingfrontierdocument,
      title={PaddleOCR-VL-1.6: Expanding the Frontier of Document Parsing with Under-Optimized Region Refinement and Progressive Post-Training},
      author={Zelun Zhang and Hongen Liu and Suyin Liang and Yubo Zhang and Yiqing Xiang and Jiaxuan Liu and Ting Sun and Manhui Lin and Yue Zhang and Changda Zhou and Tingquan Gao and Cheng Cui and Yi Liu and Dianhai Yu and Yanjun Ma},
      year={2026},
      eprint={2606.03264},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2606.03264},
}